

Ova priča govori o tome kako koristimo kontejnere u produkcijskom okruženju, posebno pod Kubernetesom. Članak je posvećen prikupljanju metrika i logova s kontejnera, kao i izradi slika.
Mi smo iz fintech kompanije Exness, koja se bavi razvojem usluga za online trgovanje i fintech proizvode za B2B i B2C. U našem R&D-u postoji mnogo različitih timova, a u odjelu razvoja ima preko 100 zaposlenika.
Predstavljamo tim koji je zadužen za platformu za prikupljanje i pokretanje koda naših programera. Konkretno, odgovorni smo za prikupljanje, pohranu i pružanje metrika, logova i događanja iz aplikacija. Trenutno upravljamo s približno tri tisuće Docker kontejnera u produkcijskom okruženju, podržavamo naše big data skladište od 50 TB te pružamo arhitektonska rješenja koja se grade oko naše infrastrukture: Kubernetes, Rancher i različiti javni cloud pružatelji.
Naša motivacija
Što gori? Nitko ne može odgovoriti. Gdje je žarište? Teško je razumjeti. Kada se zapalilo? Moguće je otkriti, ali ne odmah.
Zašto neki kontejneri stoje, a drugi su pali? Koji je kontejner kriv za to? Iako su izvana kontejneri isti, unutra svaki ima svog Nea.
Naši programeri su sposobni ljudi. Prave dobre usluge koje donose profit kompaniji. No, ponekad se dogode problemi kada kontejneri s aplikacijama idu naopačke. Jedan kontejner troši previše CPU-a, drugi mrežu, treći ulazno-izlazne operacije, a četvrti čak nije jasno što radi s socketima. Sve to pada i brod tone.
Agenti
Kako bismo shvatili što se dešava unutra, odlučili smo instalirati agente direktno u kontejnere.
Ovi agenti su sredstva koja održavaju kontejnere u takvom stanju da se međusobno ne uništavaju. Agenti su standardizirani, što omogućava standardizirani pristup održavanju kontejnera.
U našem slučaju, agenti trebaju pružati logove u standardnom formatu, označene i s throttlingom. Također, trebaju nam pružiti standardizirane metrike, proširive s aspekta poslovnih aplikacija.
Pod agentima se također podrazumijevaju alati za upravljanje i održavanje, koji mogu raditi u različitim sustavima orkestracije i podržavaju različite slike (Debian, Alpine, Centos itd.).
Na kraju, agenti moraju održavati jednostavan CI/CD, koji uključuje Docker datoteke. Inače će se brod raspasti, jer će se kontejneri početi isporučivati po "krivim" tračnicama.
Proces izgradnje i struktura ciljnog image-a
Kako bi sve bilo standardizirano i upravljivo, potrebno je pridržavati se nekog standardnog procesa izgradnje. Zato smo odlučili izgraditi kontejnere koristeći kontejnere — takva je rekursija.
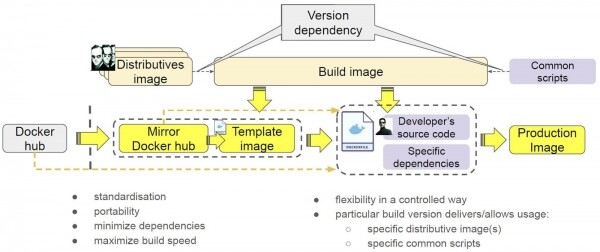
Ovdje su kontejneri prikazani kao čvrste konture. Uz to smo odlučili staviti u njih distribucije, kako "život ne bi bio samo bajka". Zašto je to napravljeno, reći ćemo u nastavku.
Kao rezultat, dobili smo alat za izgradnju — kontejner određene verzije, koji se odnosi na određene verzije distribucija i određene verzije skripti.
Kako ga primjenjujemo? Imamo Docker Hub, gdje se nalazi kontejner. Odražavamo ga unutar svog sustava, kako bismo se oslobodili vanjskih ovisnosti. Dobio se kontejner označen žutom bojom. Stvaramo predložak kako bismo instalirali sve potrebne distribucije i skripte u kontejner. Nakon toga, sastavljamo gotov image spreman za korištenje: programeri ubacuju svoj kod i neke svoje posebne ovisnosti.
Što je dobro u ovom pristupu?
- Prvo, potpuna kontrola verzija alata za izgradnju — kontejner za izgradnju, verzije skripti i distribucija.
- Drugo, postigli smo standardizaciju: na isti način stvaramo predloške, privremene i gotove za korištenje image-e.
- Treće, kontejneri nam osiguravaju prenosivost. Danas koristimo GitLab, a sutra možemo preći na TeamCity ili Jenkins i na isti način pokretati naše kontejnere.
- Četvrto, minimizacija ovisnosti. Nismo slučajno stavili distribucije u kontejner, jer to omogućava da ih ne preuzimamo svaki put s Interneta.
- Peto, povećana brzina izgradnje — vođenje lokalnih kopija image-a omogućava nam da ne trošimo vrijeme na preuzimanje, jer imamo lokalni image.
Drugim riječima, postigli smo kontrolirani i fleksibilni proces izgradnje. Koristimo iste alate za izgradnju svih kontejnera s punim vođenjem verzija.
Kako funkcionira naš postupak izgradnje?
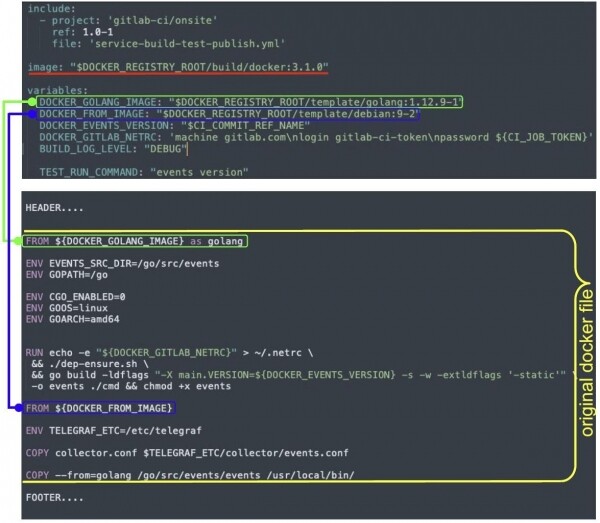
Pokretanje se vrši jednom naredbom, proces se izvršava unutar slike (označeno crvenom). Programer ima Docker datoteku (označeno žutom), koju renderiramo zamjenom varijabli s vrijednostima. Uz to dodajemo zaglavlja i podnožja — to su naši agenti.
Zaglavlje dodaje distribucije iz odgovarajućih slika. Podnožje postavlja naše usluge unutra, konfigurira pokretanje radnog opterećenja, logiranje i ostale agente, zamjenjuje entrypoint itd.
Dugo smo razmišljali o tome trebamo li supervizor. Na kraju smo odlučili da nam je potreban. Odabrali smo S6. Supervizor osigurava upravljanje kontejnerom: omogućuje povezivanje s njim u slučaju pada glavnog procesa i osigurava ručno upravljanje kontejnerom bez ponovnog kreiranja. Logovi i metrike su procesi koji se izvršavaju unutar kontejnera. Njih također treba nekako kontrolirati, a to radimo putem supervizora. Na kraju, S6 preuzima izvršavanje održavanja, obradu signala i druge zadatke.
Budući da koristimo različite orkestracijske sustave, nakon izgradnje i pokretanja, kontejner treba shvatiti u kojem se okruženju nalazi i djelovati prema situaciji. Na primjer:
To nam omogućuje da izgradimo jednu sliku i pokrenemo je u različitim orkestracijskim sustavima, pritom će se pokrenuti s obzirom na specifičnosti tog sustava orkestracije.
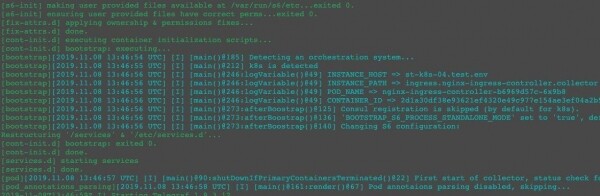
Za isti kontejner dobivamo različita procesna stabla u Dockeru i Kubernetesu:
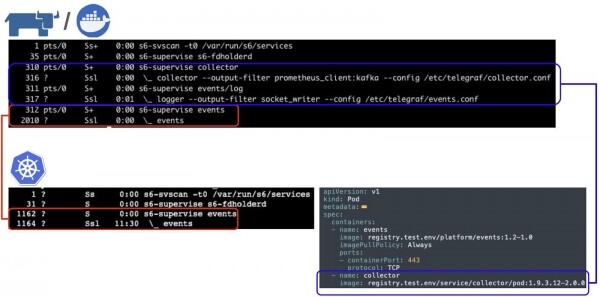
Koristan teret se izvršava pod supervizorom S6. Obavezno obratite pažnju na kolektor i događaje — to su naši agenti odgovorni za logove i metrike. U Kubernetesu ih nema, dok u Dockeru postoje. Zašto?
Ako pogledamo specifikaciju „poda” (ovdje i dalje – Kubernetes pod), vidjet ćemo da se kontejner događaja izvršava u podu, u kojem postoji odvojeni kontejner kolektora koji obavlja funkciju prikupljanja metrika i logova. Možemo iskoristiti mogućnosti Kubernetes-a: pokretanje kontejnera u istom podu, u jedinstvenim procesnim i/ili mrežnim prostorima. U stvari, implementirati svoje agente i izvršavati određene funkcije. I ako se taj isti kontejner pokrene u Dockeru, dobit će iste mogućnosti, tj. moći će dostaviti logove i metrike jer će agenti biti pokrenuti unutar njega.
Metrike i logovi
Dostavljanje metrika i logova je složen zadatak. Sa njegovim rješavanjem povezani su različiti aspekti.
Infrastruktura se stvara za izvršavanje korisnog opterećenja, a ne za masovnu isporuku dnevnika. To znači da ovaj proces treba izvoditi s minimalnim zahtjevima prema resursima kontejnera. Težimo pomoći našim programerima: "Uzmite Docker Hub kontejner, pokrenite ga, i mi ćemo moći dostaviti dnevnike".
Drugi aspekt je ograničenje volumena dnevnika. Ako dođe do situacije s povećanjem volumena dnevnika u nekoliko kontejnera (aplikacija u petlji ispisuje stack-trace), opterećenje CPU-a, komunikacijskih kanala i sustava obrade dnevnika raste, što utječe na rad domaćina u cjelini i na druge kontejnere na domaćinu, što katkad dovodi do "pada" domaćina.
Treći aspekt je potreba da se podrži što više metoda prikupljanja metrika iz kutije. Od čitanja datoteka i ispitivanja Prometheus-endpointa do korištenja specifičnih aplikacijskih protokola.
I posljednji aspekt je potreba da se minimizira potrošnja resursa.
Odabrali smo open-source rješenje na Go pod nazivom Telegraf. To je univerzalni konektor koji podržava više od 140 vrsta ulaznih kanala (input plugins) i 30 vrsta izlaznih (output plugins). Dorabili smo ga i sada ćemo objasniti kako se koristi u našem slučaju s Kubernetesom.
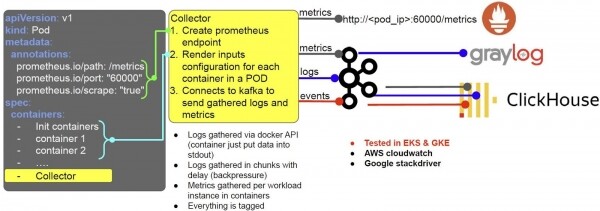
Pretpostavimo da programer implementira opterećenje, a Kubernetes dobiva zahtjev za stvaranje pod-a. U tom trenutku za svaki pod automatski se stvara kontejner pod nazivom Collector (koristimo mutation webhook). Collector je naš agent. Pri pokretanju, ovaj kontejner se postavlja za rad s Prometheusom i sustavom za prikupljanje dnevnika.
- Za to koristi anotacije poda, i ovisno o njenom sadržaju, stvara, recimo, krajnju točku end-point za Prometheus;
- Na temelju specifikacije poda i specifičnih postavki kontejnera odlučuje kako isporučivati dnevnike.
Dnevnik prikupljamo putem Docker API-ja: programerima je dovoljno staviti ih u stdout ili stderr, a zatim će Collector obaviti ostalo. Dnevnici se prikupljaju u chunkovima s određenim kašnjenjem, kako bi se spriječilo moguće preopterećenje domaćina.
Metrike se prikupljaju po instancama radnog opterećenja (procesima) u kontejnerima. Sve se označava oznakama: namespace, pod i tako dalje, a zatim se konvertira u Prometheus format – i postaje dostupno za prikupljanje (osim dnevnika). Također, dnevnici, metrike i događaji šalju se u Kafka i dalje:
- Dnevnici su dostupni u Graylogu (za vizualnu analizu);
- Logovi, metrike i događaji šalju se u Clickhouse za dugoročno skladištenje.
Isto tako sve radi u AWS-u, samo zamjenjujemo Graylog s Kafka za Cloudwatch. Šaljemo logove tamo i sve je vrlo praktično: odmah je jasno kojem klusteru i kontejneru pripadaju. Ista stvar vrijedi i za Google Stackdriver. Dakle, shema radi i on-premise s Kafkom, i u oblaku.
Ako nemamo Kubernetes s podovima, shema postaje malo složenija, ali radi prema istim principima.
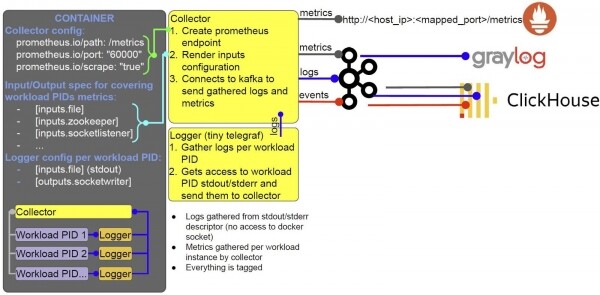
Unutar kontejnera izvršavaju se isti procesi, orkestrirani pomoću S6. Svi ti procesi pokrenuti su unutar jednog kontejnera.
U konačnici
Kreirali smo cjelovito rješenje za izgradnju i pokretanje slika u produkciji, s opcijama za prikupljanje i dostavu logova i metrike:
- Razvili smo standardizirani pristup za izgradnju slika, na temelju kojeg smo razvili CI predloške;
- Agenti za prikupljanje podataka su naši proširenja Telegraf. Dobro smo ih testirali u produkciji;
- Primjenjujemo mutation webhook za implementaciju kontejnera s agentima u podovima;
- Integrirali smo se u ekosustav Kubernetes/Rancher;
- Možemo izvršavati iste kontejnere u različitim sustavima orkestracije i dobiti očekivani rezultat;
- Kreirali smo potpuno dinamičku konfiguraciju za upravljanje kontejnerima.
Koautor: Ilja Prudnikov
Izvor: habr.com
