

Objavio sam na Githubu .
Ovo je jednostavna hash-tablica za GPU koja može obraditi stotine milijuna umetanja u sekundi. Na mom laptopu s NVIDIA GTX 1060, kod umetanja 64 milijuna nasumično generiranih parova ključ-vrijednost traje otprilike 210 ms, a uklanjanje 32 milijuna parova traje otprilike 64 ms.
Dakle, brzina na laptopu iznosi otprilike 300 milijuna umetanja/sek i 500 milijuna uklanjanja/sek.
Tablica je napisana u CUDA-i, iako se ista metoda može primijeniti u HLSL ili GLSL. Implementacija ima nekoliko ograničenja koja osiguravaju visoke performanse na grafičkoj kartici:
- Obrađuju se samo 32-bitni ključevi i iste takve vrijednosti.
- Hash-tablica ima fiksnu veličinu.
- I ta veličina mora biti jednaka dvojci na stepen.
Za ključeve i vrijednosti potrebno je rezervirati jednostavan razdjelni marker (u prikazanom kodu to je 0xffffffff).
Hash-tablica bez zaključavanja
U hash-tablici koristi se otvorena adresacija s , to jest to je jednostavno niz parova ključ-vrijednost koji se čuva u memoriji i ima izvrsnu performansu keširanja. Ovo se ne može reći za vezivanje u lanac (chaining), što podrazumijeva pretraživanje pokazivača u povezanom popisu. Hash-tablica je jednostavni niz koji pohranjuje elemente KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Veličina tablice je moć dvojke, a ne prosto broj, jer je za primjenu pow2/AND-maske dovoljna jedna brza instrukcija, dok operator modula radi znatno sporije. Ovo je važno u slučaju linearnih zondiranja, jer prilikom linearnog pretraživanja kroz tablicu indeks slota mora biti omotan u svaki slot. Kao rezultat, dodaje se cijena operacije modula u svakom slotu.
Tablica pohranjuje samo ključ i vrijednost za svaki element, a ne hash ključa. Budući da tablica pohranjuje samo 32-bitne ključeve, hash se izračunava vrlo brzo. U prikazanom kodu koristi se hash Murmur3, koji izvodi samo nekoliko pomaka, XOR-ova i množenja.
U heš-tablici primjenjuje se metoda zaštite od blokada koja ne ovisi o redoslijedu smještaja u memoriji. Čak i ako neke operacije zapisivanja narušavaju redoslijed drugih takvih operacija, heš-tablica će i dalje zadržati ispravno stanje. O tome ćemo govoriti u nastavku. Metoda se odlično uklapa u grafičke kartice, gdje se konkurentno izvršavaju tisuće tokova.
Ključevi i vrijednosti u heš-tablici inicijaliziraju se praznima.
Kod se može modificirati kako bi mogao obraditi i 64-bitne ključeve i vrijednosti. Za ključeve su potrebne atomske operacije čitanja, zapisivanja i usporedbe s zamjenom (compare-and-swap). A za vrijednosti su potrebne atomske operacije čitanja i zapisivanja. Na sreću, u CUDA-i su operacije čitanja-zapisivanja za 32- i 64-bitne vrijednosti atomske sve dok su pravilno poravnate (vidi ), a moderni grafički procesori podržavaju 64-bitne atomske operacije usporedbe s zamjenom. Naravno, prelaskom na 64 bita performanse će se malo smanjiti.
Stanje heš-tablice
Svaka par ključeva i vrijednosti u heš-tablici može imati jedno od četiri stanja:
- Ključ i vrijednost su prazni. U tom stanju heš-tablica se inicijalizira.
- Ključ je zapisan, a vrijednost još nije. Ako drugi tok izvršenja u tom trenutku čita podatke, tada se vraća prazna vrijednost. To je u redu, isto bi se dogodilo da je drugi tok izvršenja izvršio nešto malo ranije, a govorimo o konkurentnoj strukturi podataka.
- Zapisani su i ključ i vrijednost.
- Vrijednost je dostupna drugim tokovima izvršenja, dok ključ još nije. To se može dogoditi jer model programiranja u CUDA-i podrazumijeva slabo uređen model memorije. To je u redu; u svakom slučaju, ključ je još uvijek prazan, čak i ako vrijednost već nije.
Važna nijansa je da nakon što je ključ zapisan u slot, on se više ne pomiče — čak i ako je ključ izbrisan, o tome ćemo govoriti u nastavku.
Kod heš-tablice funkcionira čak i sa slabo uređenim modelima memorije gdje redoslijed čitanja i zapisivanja u memoriju nije poznat. Kada budemo raspravljali o umetanjima, pretraživanju i brisanju u heš-tablici, zapamtite da svaka par ključeva i vrijednosti pripada jednom od četiri prethodno opisana stanja.
Umetanje u heš-tablicu
CUDA funkcija za umetanje parova ključ-vrijednost u hash tablicu izgleda ovako:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Za umetanje ključa, kod iterira kroz niz hash tablice počinjući od hash-a umetnutog ključa. U svakoj poziciji niza izvodi se atomska operacija usporedbe i zamjene, pri čemu se ključ u toj poziciji uspoređuje s praznim. Ako se otkrije neslaganje, ključ u poziciji ažurira se na umetnuti ključ, a zatim se vraća originalni ključ pozicije. Ako je taj originalni ključ bio prazan ili odgovarao umetnutom ključu, to znači da je kod pronašao pogodnu poziciju za umetanje i unosi umetnutu vrijednost u tu poziciju.
Ako u jednom pozivu jezgre gpu_hashtable_insert() ima više elemenata s istim ključem, tada može biti zapisano bilo koja od njihovih vrijednosti u poziciju ključa. To se smatra normalnim: jedna od operacija zapisivanja ključ-vrijednost tijekom poziva bit će uspješna, ali budući da se sve to odvija paralelno u okviru više izvršnih niti, ne možemo predvidjeti koja će operacija zapisivanja u memoriju biti posljednja.
Pretraživanje u hash tablici
Kod za pretraživanje ključeva:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Da bismo pronašli vrijednost ključa pohranjenog u tablici, iteriramo kroz niz počinjući od hash-a traženog ključa. U svakoj poziciji provjeravamo je li ključ onaj koji tražimo, i ako jest, vraćamo njegovu vrijednost. Također provjeravamo je li ključ prazan, a ako jest, prekidamo pretraživanje.
Ako ne uspijemo pronaći ključ, kod vraća praznu vrijednost.
Sve ove operacije pretraživanja mogu se izvoditi konkurentno tijekom umetanja i brisanja. Svaki par u tablici imat će jedno od četiri gore opisane state za nit.
Brisanje u hash tablici
Kod za brisanje ključeva:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Brisanje ključa se vrši na neobičan način: ostavljamo ključ u tablici i označavamo njegovu vrijednost (ne sam ključ) kao praznu. Ovaj kod je vrlo sličan lookup(), osim što prilikom otkrivanja podudaranja po ključu postavlja njegovu vrijednost na prazno.
Kao što je ranije spomenuto, nakon što se ključ upiše u slot, više se ne pomiče. Čak i kada se element ukloni iz tablice, ključ ostaje na mjestu, samo njegova vrijednost postaje prazna. To znači da ne trebamo koristiti atomsku operaciju zapisivanja vrijednosti slota, jer nije važno je li trenutna vrijednost prazna ili ne — ionako će postati prazna.
Promjena veličine heš tablice
Promjena veličine heš tablice može se obaviti stvaranjem veće tablice i umetnuti u nju neprazne elemente iz stare tablice. Ovu funkcionalnost nisam implementirao jer sam želio održati uzorak koda jednostavnim. Štoviše, u CUDA programima alokacija memorije često se obavlja u host kodu, a ne u CUDA jezgri.
U članku opisuje kako mijenjati takvu strukturu podataka zaštićenu od blokada.
Konkurentnost
U gornjim fragmentima koda funkcije gpu_hashtable_insert(), _lookup() i _delete() obrađuju jedan par ključ-vrijednost po jedan. A dolje gpu_hashtable_insert(), _lookup() i _delete() obrađuju niz parova paralelno, svaki par u zasebnom GPU thread-u:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Heš tablica sa zaštitom od blokada podržava konkurentne umetke, pretrage i brisanja. Budući da su parovi ključ-vrijednost uvijek u jednom od četiri stanja, a ključevi se ne sele, tablica osigurava ispravnost čak i pri simultanom korištenju operacija različitih vrsta.
Međutim, ako istodobno obrađujemo paket umetaka i brisanja, i ako ulazni niz parova sadrži duplicirane ključeve, nećemo moći predvidjeti koje će parove "pobediti" — koje će biti zapisane u heš tablicu posljednje. Pretpostavimo da smo pozvali kod umetanja s ulaznim nizom parova A/0 B/1 A/2 C/3 A/4. Kada kod završi, parovi B/1 i C/3 garantirano će biti prisutni u tablici, ali će u njoj biti bilo koji od parova A/0, A/2 ili A/4To može biti problem ili ne — sve ovisi o primjeni. Možete unaprijed znati da u ulaznom nizu nema dupliciranih ključeva, ili vam možda nije važno koje je vrijednosti posljednje zapisano.
Ako vam je to problem, onda trebate razdvojiti duplicirane parove po različitim sistemskim CUDA pozivima. U CUDA, svaka operacija s pozivom jezgre uvijek se završava prije sljedećeg poziva jezgre (barem unutar jednog toka. U različitim tokovima jezgre se izvršavaju paralelno). Ako bi se u gornjem primjeru jednog jezgra pozvalo s A/0 B/1 A/2 C/3, a drugo s A/4, tada bi ključ A dobio vrijednost 4.
Sada ćemo razgovarati o tome trebaju li funkcije lookup() i delete() koristiti obični (plain) ili varijabilni (volatile) pokazivač na niz parova u hash tablici. navodi da:
Kompajler može po svojoj volji optimizirati operacije čitanja i pisanja u globalnu ili zajedničku memoriju… Ove optimizacije se mogu onemogućiti pomoću ključne riječi
volatile: … svaka referenca na ovu varijablu se kompajlira u stvarnu instrukciju čitanja ili pisanja u memoriju.
Pitanja ispravnosti ne zahtijevaju primjenu volatile. Ako izvršni tok koristi keširanu vrijednost iz ranije operacije čitanja, to znači da će koristiti pomalo zastarjeli informacija. Ipak, to je informacija iz ispravnog stanja hash tablice u određenom trenutku poziva jezgre. Ako trebate koristiti najnovije informacije, možete primijeniti pokazivač volatile, ali tada će nešto opasti performanse: prema mojim testovima — pri brisanju 32 milijuna elemenata brzina je pala s 500 milijuna brisanja/sec na 450 milijuna brisanja/sec.
Performanse
U testu umetanja 64 milijuna elemenata i brisanja 32 milijuna od njih konkurencija između std::unordered_map i hash tablice za GPU zapravo ne postoji:
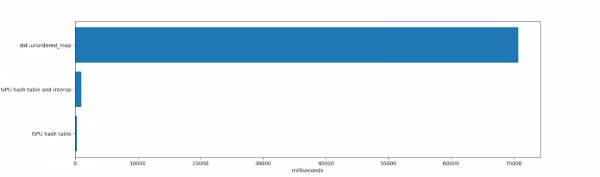
std::unordered_map potrošila je 70 691 ms na umetanje i brisanje elemenata s kasnijim oslobađanjem unordered_map (oslobađanje od milijuna elemenata zahtijeva dosta vremena, jer unutar unordered_map izvode se brojne alokacije memorije). Iskreno, kod std:unordered_map potpuno drugačija ograničenja. Ovo je jedini CPU-izvršni tok, podržava ključ-vrednosti neograničenih dimenzija, dobro funkcioniše pri visokim faktorima korišćenja i pokazuje stabilne performanse nakon brojnih brisanja.
Trajanje rada hesh tabele za GPU i međuprogramsku interakciju iznosilo je 984 ms. Ovo uključuje vreme potrebno za smeštanje tabele u memoriju i njeno brisanje (jedno alveđenje 1 GB memorije, što u CUDA-u zahteva vreme), umetanje i brisanje elemenata, kao i njihovo iteriranje. Takođe su uračunata sva kopiranja u memoriju i iz memorije grafičke kartice.
Rad same hesh tabele trajao je 271 ms. Ovo uključuje vreme koje je grafička kartica provela na umetanju i brisanju elemenata, i ne uključuje vreme za kopiranje u memoriju i iteriranje po dobijenoj tabeli. Ako GPU-tabela živi dugo, ili ako je hesh tabela u potpunosti u memoriji grafičke kartice (na primer, za stvaranje hesh tabele koja će koristiti drugi GPU kod, a ne centralni procesor), tada su rezultati testiranja relevantni.
Hesh tabela za grafičku karticu pokazuje visoke performanse zahvaljujući velikoj propusnosti i aktivnom paralelizmu.
Nedostaci
Arhitektura hesh tabele ima nekoliko problema o kojima treba brinuti:
- Linearno ispitivanje ometa klasterizacija, zbog koje ključevi u tabeli nisu raspoređeni idealno.
- Ključevi se ne brišu funkcijom
izbrišii s vremenom zagušuju tabelu.
Kao rezultat, performanse hesh tabele mogu postepeno opadati, posebno ako postoji dugo i u njoj se vrši mnogo umetanja i brisanja. Jedan od načina ublažavanja ovih nedostataka je prehashiranje u novu tabelu sa dovoljno niskim faktorom korišćenja i filtriranjem obrisanih ključeva prilikom prehashiranja.
Da ilustrujem opisane probleme, koristim gornji kod za kreiranje tabele od 128 miliona elemenata, ciklički ću umetati 4 miliona elemenata dok ne popunim 124 miliona slotova (faktor korišćenja oko 0,96). Ovo su rezultati, svaki red je poziv CUDA jezgra sa umetanjem 4 miliona novih elemenata u jednu hesh tabelu:
Faktor korišćenja
Trajanje umetanja 4 194 304 elemenata
0,00
11,608448 ms (361,314798 milijuna ključeva/sec.)
0,03
11,751424 ms (356,918799 milijuna ključeva/sec.)
0,06
11,942592 ms (351,205515 milijuna ključeva/sec.)
0,09
12,081120 ms (347,178429 milijuna ključeva/sec.)
0,12
12,242560 ms (342,600233 milijuna ključeva/sec.)
0,16
12,396448 ms (338,347235 milijuna ključeva/sec.)
0,19
12,533024 ms (334,660176 milijuna ključeva/sec.)
0,22
12,703328 ms (330,173626 milijuna ključeva/sec.)
0,25
12,884512 ms (325,530693 milijuna ključeva/sec.)
0,28
13,033472 ms (321,810182 milijuna ključeva/sec.)
0,31
13,239296 ms (316,807174 milijuna ključeva/sec.)
0,34
13,392448 ms (313,184256 milijuna ključeva/sec.)
0,37
13,624000 ms (307,861434 milijuna ključeva/sec.)
0,41
13,875520 ms (302,280855 milijuna ključeva/sec.)
0,44
14,126528 ms (296,909756 milijuna ključeva/sec.)
0,47
14,399328 ms (291,284699 milijuna ključeva/sec.)
0,50
14,690304 ms (285,515123 milijuna ključeva/sec.)
0,53
15,039136 ms (278,892623 milijuna ključeva/sec.)
0,56
15,478656 ms (270,973402 milijuna ključeva/sec.)
0,59
15,985664 ms (262,379092 milijuna ključeva/sec.)
0,62
16,668673 ms (251,627968 milijuna ključeva/sec.)
0,66
17,587200 ms (238,486174 milijuna ključeva/sec.)
0,69
18,690048 ms (224,413765 milijuna ključeva/sec.)
0,72
20,278816 ms (206,831789 milijuna ključeva/sec.)
0,75
22,545408 ms (186,038058 milijuna ključeva/sec.)
0,78
26,053312 ms (160,989275 milijuna ključeva/sec.)
0,81
31,895008 ms (131,503463 milijuna ključeva/sec.)
0,84
42,103294 ms (99,619378 milijuna ključeva/sec.)
0,87
61,849056 ms (67,815164 milijuna ključeva/sec.)
0,90
105,695999 ms (39,682713 milijuna ključeva/sec.)
0,94
240,204636 ms (17,461378 milijuna ključeva/sec.)
Kako se koeficijent iskorištenosti povećava, performanse opadaju. To je nepoželjno u većini slučajeva. Ako aplikacija umetne elemente u tablicu, a zatim ih odbaci (na primjer, prilikom brojanja riječi u knjizi), to nije problem. No, ako aplikacija koristi dugotrajnu hash tablicu (na primjer, u grafičkom uređivaču za pohranu neispunjenih dijelova slika, kada korisnik često umetne i ukloni informacije), tada takvo ponašanje može biti neugodnost.
I izmjerio sam dubinu zarezivanja hash tablice nakon 64 milijuna umetanja (koeficijent iskorištenosti 0,5). Prosječna dubina bila je 0,4774, tako da su se većina ključeva nalazila ili u najboljoj mogućoj utičnici ili u jednoj utičnici od najbolje pozicije. Maksimalna dubina zarezivanja iznosila je 60.
Zatim sam izmjerio dubinu zarezivanja u tablici s 124 milijuna umetanja (koeficijent iskorištenosti 0,97). Prosječna dubina iznosila je već 10,1757, a maksimalna — 6474 (!!). Performanse linearne zarezivanja značajno padaju pri visokim koeficijentima iskorištenosti.
Najbolje je održavati nizak koeficijent upotrebe za ovu heš tablicu. No tada povećavamo performanse na račun potrošnje memorije. Na sreću, u slučaju 32-bitnih ključeva i vrijednosti, to može biti opravdano. Ako u prikazanom primjeru unutar tablice s 128 milijuna elemenata održimo koeficijent upotrebe od 0,25, moći ćemo smjestiti najviše 32 milijuna elemenata, dok će ostalih 96 milijuna slotova biti izgubljeno – po 8 bajtova po svakoj pari, 768 MB izgubljene memorije.
Imajte na umu da se radi o gubitku memorije grafičke kartice, koja je vrijedniji resurs od sistemske memorije. Iako većina modernih desktop grafičkih kartica koje podržavaju CUDA ima najmanje 4 GB memorije (u trenutku pisanja, NVIDIA 2080 Ti ima 11 GB), gubiti takve količine ne bi bila najsigurnija odluka.
Kasnije ću detaljnije pisati o stvaranju heš tablica za grafičke kartice koje nemaju problema s dubinom čitanja te o načinima ponovnog korištenja izbrisanih slotova.
Mjerenje dubine čitanja
Da bismo odredili dubinu čitanja ključa, možemo izvući heš ključa (njegov idealni indeks u tablici) iz njegovog stvarnog indeksa u tablici:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Zbog magije dvaju binarnih brojeva u komplementu i činjenice da je kapacitet heš tablice jednak dvojci u stepeni, ovaj pristup će uspjeti čak i kada se indeks ključa premjesti na početak tablice. Uzmimo ključ koji se hešira u 1, ali je umetnut u slot 3. Za tablicu s kapacitetom 4 dobit ćemo (3 — 1) & 3, što je ekvivalentno 2.
Zaključak
Ako imate pitanja ili komentare, pišite mi na ili otvorite novu temu u.
Ovaj kod je napisan pod inspiracijom divnih članaka:
U budućnosti ću nastaviti pisati o implementacijama heš tablica za grafičke kartice i analizirati njihovu performansu. Planiram vezivanje u lanac, Robin Hood heširanje i heširanje kukavice koristeći atomske operacije u strukturama podataka koje su pogodne za grafičke kartice.
Izvor: habr.com
