

to je standard (ISO, ITU-T, GOST) jezika koji opisuje strukturirane informacije, kao i pravila za kodiranje tih informacija. Za mene kao programera to je samo još jedan format serijalizacije i predstavljanja podataka, uz JSON, XML, XDR i druge. Izuzetno je raširen u našem svakodnevnom životu, i mnogi se s njim susreću: u mobilnim, telefonskim, VoIP komunikacijama (UMTS, LTE, WiMAX, SS7, H.323), u mrežnim protokolima (LDAP, SNMP, Kerberos), u svemu što se tiče kriptografije (X.509, CMS, PKCS standardi), na bankovnim karticama i biometrijskim putovnicama, i na mnogim drugim mjestima.
U ovom članku razmatra se : Python ASN.1 biblioteka koja se aktivno koristi u projektima vezanim uz kriptografiju u .
Uopće, ne preporučuje se koristit ASN.1 za kriptografske zadatke: ASN.1 i njegovi kodeci su složeni. To znači da će kod biti kompliciran, a to uvijek predstavlja dodatni vektor napada. Dovoljno je pogledati ranjivosti u ASN.1 bibliotekama. Bruce Schneier u svojoj također ne preporučuje korištenje ovog standarda zbog njegove složenosti: „Najpoznatija TLV kodiranja je ASN.1, ali je nevjerojatno složen i izbjegavamo ga“. Međutim, nažalost, danas imamo u kojima se aktivno koriste , CRL, OCSP, TSP, CMP protokoli, , poruke , i mnoštvo standarda . Stoga se mora znati raditi s ASN.1, ako se bavite nečim vezanim uz kriptografiju.
ASN.1 može biti kodiran na mnogo načina/kodeka:
- (Osnovna pravila kodiranja)
- (Kanonska pravila kodiranja)
- (Istaknuta pravila kodiranja)
- (Generička pravila kodiranja stringova)
- (JSON pravila kodiranja)
- LWER (Pravila lakog kodiranja)
- (Pravila kodiranja okteta)
- (Pakovana pravila kodiranja)
- SER (Pravila specifična za signalizaciju)
- (XML pravila kodiranja)
i niz drugih. No, u kriptografskim zadacima u praksi se koriste dva: BER i DER. Čak i u potpisanim XML dokumentima (, ) i dalje će biti Base64 kodirani ASN.1 DER objekti, kao i u JSON-orijentiranom protokolu s Let’s Encrypt. Najbolje je razumjeti sve te kodeke i principe kodiranja BER/CER/DER u člancima i knjigama: , , .
BER je binarni bajt-orijentirani (npr. PER, popularan u mobilnoj komunikaciji — bit-orijentiran) TLV format. Svaki element se kodira u obliku: oznake (Tag), koja identificira tip kodiranog elementa (cjelobrojni, string, datum, itd.), dužine (Ldužine) sadržaja i samog sadržaja (Vvrijednost). BER opcionalno omogućava ne navođenje dužine tako da se zada posebna vrijednost neodređene dužine i završava porukom End-Of-Octets oznakom. Osim kodiranja dužine, u BER-u ima mnogo varijacija u načinu kodiranja tipova podataka, kao što su:
- INTEGER, OBJECT IDENTIFIER, BIT STRING i dužina elementa može biti nenormalizirana (nije kodirana u minimalnom obliku);
- BOOLEAN je istinit za bilo koji nenulti sadržaj;
- BIT STRING može sadržavati 'suvišne' nulu bitove;
- BIT STRING, OCTET STRING i svi njihovi izvedeni tipovi stringova, uključujući datum/vrijeme, mogu se razbiti na dijelove (chunk) varijabilne dužine, čija dužina nije unaprijed poznata za vrijeme (de)kodiranja;
- UTCTime/GeneralizedTime mogu imati različite načine zadavanja pomaka vremenske zone i 'suvišne' nule u dijelovima sekundi;
- DEFAULT vrijednosti SEQUENCE se mogu kodirati ili ne;
- Imenske vrijednosti posljednjih bitova u BIT STRING mogu se po želji ne kodirati;
- SEQUENCE (OF)/SET (OF) mogu imati proizvoljan redoslijed elemenata.
Zbog svega navedenog, kodirati podatke tako da budu identični izvornom obliku — nije uvijek moguće. Stoga je zamišljen podskup pravila: DER — strogo propisuje samo jedan dopušteni način kodiranja, što je ključno za kriptografske zadatke, gdje bi, na primjer, promjena jednog bita učinila potpis ili kontrolnu sumu nevaljanom. DER ima značajan nedostatak: dužine svih elemenata moraju biti unaprijed poznate tijekom kodiranja, što ne omogućava tokovno serijaliziranje podataka. CER kodeks je lišen ovog nedostatka, isto tako jamčeći jednoznačno predstavljanje podataka. Nažalost (ili na sreću što nemamo još složenije dekodere?), nije postao popularan. Stoga se u praksi susrećemo sa 'mješovitim' korištenjem BER i DER kodiranih podataka. Kako su i CER i DER podskupovi BER-a, svaki BER dekoder može ih obraditi.
Problemi s pyasn1
Na poslu pišemo mnogo programa na Pythonu povezanih s kriptografijom. Prije nekoliko godina gotovo da nije bilo izbora slobodnih biblioteka: ili su to vrlo nisko razine biblioteke, koje samo omogućuju kodiranje/dekodiranje, na primjer, cijelog broja i zaglavlja strukture, ili je to biblioteka Na njoj smo živjeli nekoliko godina i isprva smo bili vrlo zadovoljni, jer nam omogućava rad s ASN.1 strukturama kao s visokorazinskim objektima: na primjer, dekodirani objekt X.509 certifikata omogućava pristup njegovim poljima putem rječničkog sučelja: cert[„tbsCertificate“][„serialNumber“] prikazat će serijski broj ovog certifikata. Slično, možemo ‘sastavljati’ složene objekte radeći s njima kao sa списковima, rječnicima, a potom jednostavno pozvati funkciju pyasn1.codec.der.encoder.encode i dobiti serijalizirano predstavljanje dokumenta.
Međutim, otkriveni su nedostaci, problemi i ograničenja. U pyasn1 su postojale i, nažalost, još uvijek postoje pogreške: u trenutku pisanja ovog članka, jedan od osnovnih tipova — GeneralizedTime, dekodirani i kodirani.
U našim projektima, radi uštede prostora, često čuvamo samo putanju do datoteke, pomak i duljinu u bajtovima objekta na koji se želimo pozvati. Na primjer, proizvoljna potpisana datoteka sigurno će biti smještena u CMS SignedData ASN.1 strukturi:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 OVDJE SE NALAZI SADRŽAJ POTPISANE DATOTEKE VELIČINE 751 bajt

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
i možemo dobiti originalnu potpisanu datoteku pomakom od 65 bajta, dužine 751 bajt. pyasn1 ne pohranjuje te informacije u svojim dekodiranim objektima. Napisana je takozvana TLVSeeker – mala biblioteka koja omogućava dekodiranje oznaka i dužina objekata, u čijem su sučelju zapovjedali "idi na sljedeću oznaku", "uđi unutar oznake" (idemo unutar SEQUENCE objekta), "idi na sljedeću oznaku", "prijavi svoj offset i dužinu objekta na kojem se nalazimo". To je bilo "ručno" hodanje kroz ASN.1 DER-serializirane podatke. No nije se moglo tako raditi s BER-serializiranim podacima, budući da bi, na primjer, bajtni niz OCTET STRING mogao biti kodiran u nekoliko chunk-ova.
Drugi nedostatak za naše zadatke pyasn1 – nemogućnost da se iz dekodiranih objekata sazna je li određeno polje bilo prisutno u SEQUENCE-u ili ne. Na primjer, ako struktura sadrži polje Field SEQUENCE OF Smth OPTIONAL, tada može potpuno nedostajati u primljenim podacima (OPTIONAL), ali može biti prisutna, ali s nultom dužinom (prazan popis). U općem slučaju to se nije moglo utvrditi. A to je potrebno za strogo provjeravanje valjanosti primljenih podataka. Zamislite da bi neki certifikacijski centar izdao certifikat s "ne sasvim" valjanim podacima prema ASN.1 shemama! Na primjer, certifikacijski centar "TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı" u svom korijenskom certifikatu prešao je granice dopuštenog. granice dužine komponente subject – nije ga moguće pošteno dekodirati prema shemi. DER kodirnik zahtijeva da se polje čija je vrijednost jednaka DEFAULT-u ne kodira prilikom prijenosa – u stvarnosti se takvi dokumenti susreću, a prva verzija PyDERASN je čak svjesno dopuštala takvo nevaljano (s gledišta DER) ponašanje radi unatradne kompatibilnosti.
Još jedno ograničenje je nemogućnost lakog prepoznavanja u kojem je obliku (BER/DER) kodiran određeni objekt u strukturi. Na primjer, CMS standard kaže da se poruka kodira u BER-u, ali polje signedAttrs, nad kojim se formira kriptografski potpis, mora biti u DER-u. Ako dekodiramo u DER-u, naići ćemo na probleme s obradom same CMS-a; ako dekodiramo u BER-u, nećemo znati u kojem je obliku bio signedAttrs. Na kraju ćemo morati koristiti TLVSeeker (analoga kojeg nema u pyasn1) da bismo pronašli lokaciju svakog polja signedAttrs i njegovo posebno, te ga iz serijaliziranog prikaza dekodirali u DER-u.
Veoma poželjna bila je za nas mogućnost automatske obrade DEFINED BY polja, koja se često susreću. Nakon dekodiranja ASN.1 strukture može nam ostati mnogo ANY polja koja se moraju dalje obraditi prema shemi, biranoj na osnovi OBJECT IDENTIFIER zadanog u polju strukture. U Python kodu to znači pisanje if izraza i daljnji poziv dekodera za ANY polje.
Pojava PyDERASN
U Atlasu redovito, kada naiđemo na probleme ili unaprijeđujemo korištene slobodne programe, šaljemo ispravke gore. U pyasn1 smo nekoliko puta slali unapređenja, ali kod pyasn1 nije najjednostavniji za razumijevanje i ponekad su se dešavale nekompatibilne promjene API-ja koje su nas povrijedile. Osim toga, navikli smo na pisanje testova s generativnim testiranjem, čega nije bilo u pyasn1.
Jednog lijepog dana odlučio sam da je vrijeme da prestanem trpjeti i pokušam napisati vlastitu biblioteku sa __slot__-ovima, offset-ima i savršeno prikladnim blob-ovima! Samo stvaranje ASN.1 kodeka ne bi bilo dovoljno — potrebno je prevesti sve naše međusobno ovisne projekte na nju, a to su stotine tisuća linija koda s puno rada s ASN.1 strukturama. To znači da je jedan od zahtjeva za nju: lakoća prevođenja trenutnog pyasn1 koda. Potrošivši cijeli svoj godišnji odmor, napisao sam ovu biblioteku i preveo sve projekte na nju. Budući da imaju gotovo 100%-nu pokrivenost testovima, to je značilo i potpunu funkcionalnost biblioteke.
PyDERASN, slično, ima gotovo 100%-no pokriće testovima. Koristi se generativno testiranje s odličnom bibliotekom . Također je provedeno i - na strojevima sa 32 jezgara. Iako praktički nemamo Python2 koda, PyDERASN i dalje održava kompatibilnost s njim, zbog čega ima jedinstvenu ovisnost. Osim toga, testiran je nasuprot .
Način rada s njim sličan je pyasn1 — rad s visokorazrednim Python objektima. Opis ASN.1 shema je sličan.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Međutim, PyDERASN ima sličnost s strogo tipiziranjem. U pyasn1, ako je polje imalo tip CMSVersion(INTEGER), mogli ste mu dodijeliti int ili INTEGER. PyDERASN strogo zahtijeva da dodijeljeni objekt bude upravo CMSVersion. Osim toga, što pišemo Python3 kod, koristimo i , tako da će u našim funkcijama biti jasni argumenti poput def func(serial, contents), a ne def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), i PyDERASN pomaže očuvanju takvog koda.
Pritom, PyDERASN nudi iznimno korisne olakšice ove tipizacije. Pyasn1 nije dopuštao u SubjectKeyIdentifier().subtype(implicitTag=Tag(…)) polje dodijeliti SubjectKeyIdentifier() objekt (bez potrebnog IMPLICIT TAG-a) tako da se često moralo kopirati i ponovo stvarati objekte samo zbog promijenjenih IMPLICIT/EXPLICIT oznaka. PyDERASN strogo nadzire samo osnovni tip — oznake automatski dodaje iz već postojeće ASN.1 sheme. To značajno pojednostavljuje kod aplikacija.
Ako dođe do pogreške tijekom dekodiranja, u pyasn1 nije moguće lako razumjeti gdje se točno dogodila. Na primjer, u već spomenutom turskom certifikatu dobit ćemo ovakvu pogrešku: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (at 138) unsatisfied bounds: 1 ⇐ 77 ⇐ 64 Tokom pisanja ASN.1 struktura ljudi mogu pogriješiti, a to pomaže lakšem otklanjanju pogrešaka u aplikacijama ili razjašnjavanju problema kodiranih dokumenata suprotne strane.
U prvoj verziji PyDERASN nije bilo podrške za BER kodiranje. Pojavila se mnogo kasnije i do danas još nije podržana obrada UTCTime/GeneralizedTime s vremenskim zonama. To će doći u budućnosti, jer se projekt uglavnom piše u slobodno vrijeme.
Također, u prvoj verziji nije bilo rada s DEFINED BY poljima. Nakon nekoliko mjeseci ova i počela se aktivno koristiti, značajno smanjujući kod aplikacija - tijekom jedne operacije dekodiranja mogla se dobiti cijela struktura razrađena do najsitnijih detalja. Za to se u shemi određuju koja polja što „definiraju“. Na primjer, opis sheme CMS:
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
govori o tome da ako contentType sadrži OID s vrijednošću id_signedData, tada se polje content (koje se nalazi u istom SEQUENCE-u) treba dekodirati prema shemi SignedData. Zašto ima toliko zagrada? Polje može „definirati“ više polja u isto vrijeme, kao što je to slučaj u EnvelopedData strukturama. Definirana polja identificiraju se prema takozvanom decode path - on određuje točnu lokaciju bilo kojeg elementa u svim strukturama.
Nije uvijek poželjno ili nije uvijek moguće odmah unijeti te defines u shemu. Mogu biti slučajevi specifični za aplikaciju kada su OID-ovi i strukture poznati samo u vanjskom projektu. PyDERASN omogućava određivanje ovih defines u trenutku dekodiranja strukture:
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Ovdje govorimo da u CMS SignedData za sve priložene certifikate, dekodiramo sve njihove ekstenzije (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool itd.). Navodimo putem decode path-u kojem elementu treba „podmetnuti“ defines, kao da je bio zadan u shemi.
Konačno, PyDERASN ima mogućnost rada iz za dekodiranje ASN.1 datoteka i ima bogat . Može se dekodirati proizvoljan ASN.1, ili se može odrediti strogo definirana shema i vidjeti nešto poput:
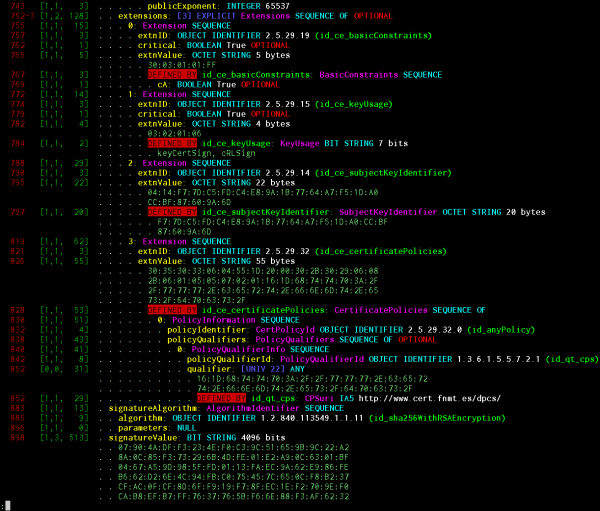
Prikazane informacije: pomak objekta, duljina taga, duljina sadržaja, prisutnost EOC (end-of-octets), oznaka BER kodiranja, oznaka indefinite-length kodiranja, duljina i pomak EXPLICIT taga (ako postoji), dubina ugniježđenja objekta u strukturama, IMPLICIT/EXPLICIT vrijednost taga, naziv objekta prema shemi, njegova osnovna ASN.1 vrsta, redni broj unutar SEQUENCE/SET OF, vrijednost CHOICE (ako postoji), čitljiv naziv INTEGER/ENUMERATED/BIT STRING prema shemi, vrijednost bilo koje osnovne vrste, DEFAULT/OPTIONAL oznaka iz sheme, oznaka da je objekt automatski dekriptiran kao DEFINED BY i uz koji OID se to dogodilo, čitljiv OID.
Sustav pretty printing-a posebno je dizajniran da generira niz PP-objekata koji se vizualiziraju posebnom opremom. Na screenshotu je prikazan renderer u jednostavnom obojenom tekstu. Postoje i rendereri u JSON/HTML formatu, kako bi se to moglo s istaknutim prikazom vidjeti u pregledniku ASN.1 kao u projektu.
Ostale biblioteke
To nije bila svrha, ali PyDERASN je postao značajno od pyasn1. Na primjer, dekriptiranje CRL datoteka veličine megabajta može trajati dovoljno dugo da se razmišlja o brzim srednjim formatima za pohranu podataka i promjeni arhitekture aplikacija. pyasn1 dekriptira CRL na mom laptopu više od 20 minuta, dok PyDERASN to radi za samo 28 sekundi! Postoji projekt , koji je usmjeren na brzi rad s kriptografskim strukturama: dekriptira (potpuno, ne lijeno) istu tu CRL za 29 sekundi, no troši gotovo dvostruko više RAM-a pri pokretanju pod Python3 (983 MiB naspram 498 MiB), i 3.5 puta više pod Python2 (1677 naspram 488), dok pyasn1 troši nevjerojatnih 4.3 puta više (2093 naspram 488).
asn1crypto, koji sam spomenuo, nismo razmatrali jer je projekt tek počinjao, i nismo čuli za njega. Sada također ne bismo gledali u njegovu stranu, jer sam odmah otkrio da isti GeneralizedTime ne prihvaća proizvoljne format, a pri serijalizaciji tiho uklanja djeliće sekundi. To je prihvatljivo za rad s X.509 certifikatima, ali u općem slučaju nije zadovoljavajuće.
Trenutno, PyDERASN je najstroži od slobodnih Python/Go DER-dekriptora koje poznajem. U encoding/asn1 biblioteci mog omiljenog Go IDENTIFIKATOR OBJEKTA i UTCTime/GeneralizedTime string. Ponekad strogoća može ometati (prvenstveno zbog unazadne kompatibilnosti sa starim aplikacijama koje nitko ne želi ispraviti), pa se tijekom dekodiranja u PyDERASN mogu prenositi popustljive provjere.
Projektni kod nastoji biti što jednostavniji. Cijela biblioteka je jedan datoteka. Kod je napisan s naglaskom na jednostavno razumijevanje, bez pretjeranih optimizacija performansi i DRY koda. Nema potpune podrške za BER dekodiranje UTCTime/GeneralizedTime stringova, kao ni za REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING tipove podataka. U svim ostalim slučajevima osobno ne vidim smisao u korištenju drugih biblioteka u Pythonu.
Kao i svi moji projekti, tip , , , , PyDERASN je potpuno , raspoloživ pod uvjetima , i dostupan je za besplatno preuzimanje. Primjeri korištenja su i u .
, , član , Python/Go programer, glavni stručnjak .
Izvor: habr.com
