

U Istražujemo klasterizaciju RabbitMQ za osiguranje otpornosti na greške i visoke dostupnosti. Sada ćemo se dublje zagledati u Apache Kafka.
Ovdje je jedinica replikacije particija. Svaka tema ima jednu ili više particija. U svakoj particiji postoji vođa s pratiocima ili bez njih. Prilikom kreiranja teme navodi se broj particija i faktor replikacije. Uobičajena vrijednost je 3, što znači tri replikacije: jedan vođa i dva pratioca.
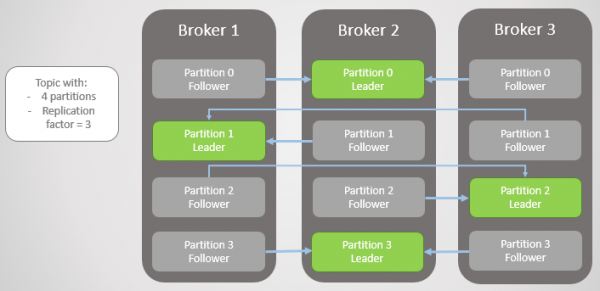
Sl. 1. Četiri particije raspoređene su među tri brokera.
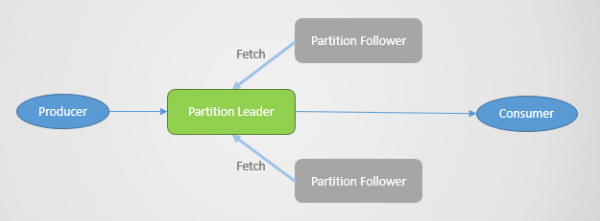
Svi zahtjevi za čitanje i pisanje idu vođi. Pratioci povremeno šalju vođi zahtjeve za primanje najnovijih poruka. Potrošači nikada ne kontaktiraju pratioce, koji postoje samo za redundanciju i otpornost na greške.
Kvar particije.
Kada broker otpadne, često se gube vođe nekoliko particija. U svakom od njih vođu postaje pratilac sa drugog čvora. U stvarnosti to nije uvijek tako, jer na to utječe i faktor sinhronizacije: imaju li sinhronizovani pratioci, a ako nemaju, da li je dopušten prijelaz na nesinhronizovanu replikaciju. No, nećemo to komplicirati.
Iz mreže izlazi broker 3 — i za particiju 2 izabire se novi vođa na brokeru 2.
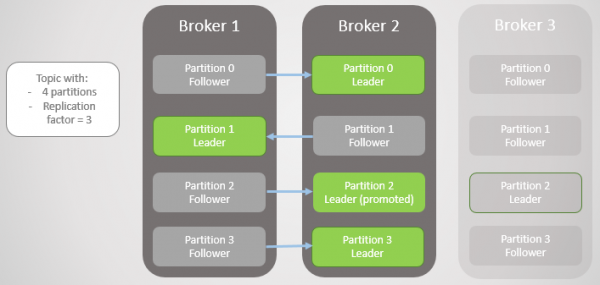
Sl. 2. Broker 3 umire, a njegov pratilac na brokeru 2 postaje novi vođa particije 2.
Zatim izlazi broker 1 i particija 1 takođe gubi svog vođu, čija uloga prelazi na broker 2.
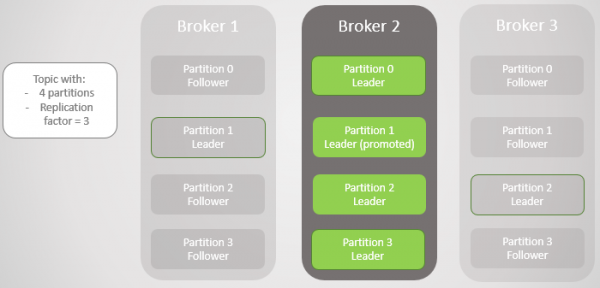
Sl. 3. Ostaće samo jedan broker. Svi vođe su na jednom brokeru bez ikakve redundancije.
Kada se broker 1 vrati u mrežu, dodaje četiri pratioca, osiguravajući određenu redundanciju svakoj particiji. No, svi vođe su i dalje ostali na brokeru 2.
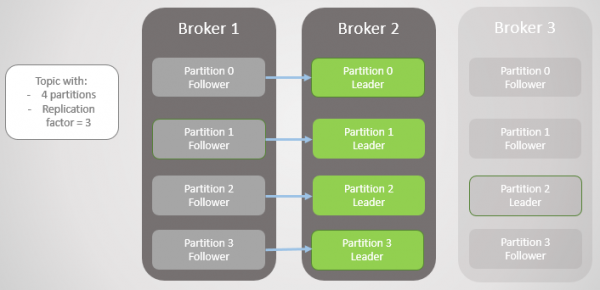
Sl. 4. Vođe ostaju na brokeru 2.
Kada se broker 3 podigne, vraćamo se na tri replikacije po particiji. No, svi vođe i dalje ostaju na brokeru 2.
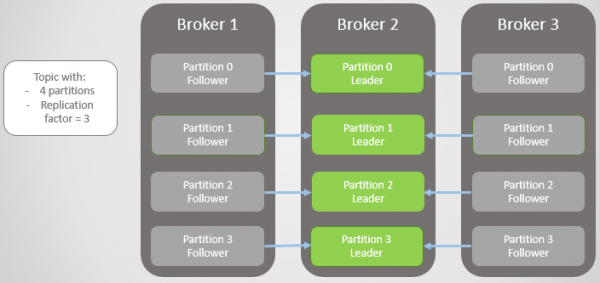
Sl. 5. Neuravnoteženo raspoređivanje vođa nakon vraćanja brokera 1 i 3.
Kafka ima alat za kvalitetniju ponovnu ravnotežu vođa nego RabbitMQ. Tamo je trebalo koristiti dodatni modul ili skriptu koja je mijenjala politike za migraciju glavnog čvora smanjenjem redundancije tokom migracije. Osim toga, kod velikih redova trebalo je pomiriti se s nedostupnošću tokom sinhronizacije.
U Kafki postoji koncept „preporučenih replikacija“ za ulogu lidera. Kada se stvaraju delovi teme, Kafka pokušava ravnomerno raspodeliti lidere po čvorovima i označava te prve lidere kao preporučene. Tokom vremena, zbog ponovnog pokretanja servera, kvarova i prekida povezanosti, lideri se mogu naći na drugim čvorovima, kao u gore opisanom ekstremnom slučaju.
Kako bi to ispravila, Kafka nudi dve opcije:
- Opcija auto.leader.rebalance.enable=true omogućava kontroleru čvora da automatski ponovo odredi lidere na preporučene replikacije, čime se vraća ravnomerna raspodela.
- Administrator može pokrenuti skriptu kafka-preferred-replica-election.sh za ručno ponovo određivanje.
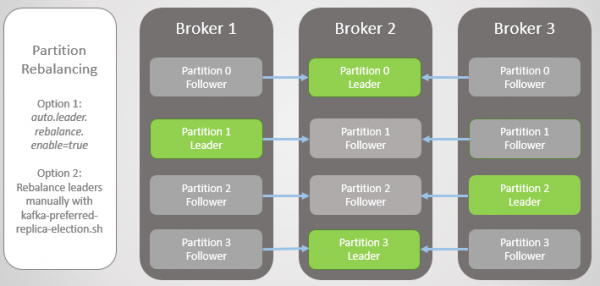
Slika 6. Replikacije nakon ponovne raspodele
Ovo je bila pojednostavljena verzija kvara, ali je stvarnost složenija, iako nije ništa previše komplikovano. Sve se svodi na sinhronizovane replikacije (In-Sync Replicas, ISR).
Sinhronizovane replikacije (ISR)
ISR je skup replikacija dela koji se smatra „sinhronizovanim“ (in-sync). Tu je lider, a sledbenika možda i nema. Sledbenik se smatra sinhronizovanim ako je napravio tačne kopije svih poruka lidera pre isteka intervala replica.lag.time.max.ms.
Sledbenik se uklanja iz skupa ISR ako:
- nije zatražio preuzimanje tokom intervala replica.lag.time.max.ms (smatra se mrtvim)
- nije uspeo da se ažurira tokom intervala replica.lag.time.max.ms (smatra se sporim)
Sledbenici vrše zahteve za preuzimanje tokom intervala replica.fetch.wait.max.ms, koji po defaultu iznosi 500 ms.
Da bi se jasno objasnila svrha ISR, potrebno je pogledati potvrde od proizvođača i neke scenarije kvara. Proizvođači mogu odabrati kada broker šalje potvrdu:
- acks=0, potvrda se ne šalje
- acks=1, potvrda se šalje nakon što je lider zabeležio poruku u svom lokalnom dnevniku
- acks=all, potvrda se šalje nakon što su sve replikacije u ISR zabeležile poruku u lokalnim dnevnicima
U terminologiji Kafke, ako je ISR sačuvao poruku, dolazi do njenog „komitovanja“. Acks=all je najbezbednija opcija, ali i dodatna kašnjenja. Razmotrićemo dva primera kvara i kako različite opcije ‘acks’ interaguju s konceptom ISR.
Acks=1 i ISR
U ovom primjeru vidimo da ako lider ne čeka potvrde za svaku poruku od svih pratilaca, do gubitka podataka može doći u slučaju pada lidera. Prebacivanje na nesinkroniziranog pratioca može biti dopušteno ili zabranjeno postavkom. unclean.leader.election.enable.
U ovom primjeru, proizvođač ima postavku acks=1. Podjela je raspoređena među tri brokera. Broker 3 zaostaje, sinkronizirao se s liderom osam sekundi ranije i sada zaostaje 7456 poruka. Broker 1 zaostaje samo jednu sekundu. Naš proizvođač šalje poruku i brzo dobija ack, bez dodatne latencije uz spore ili neaktivne pratioce koje lider ne čeka.
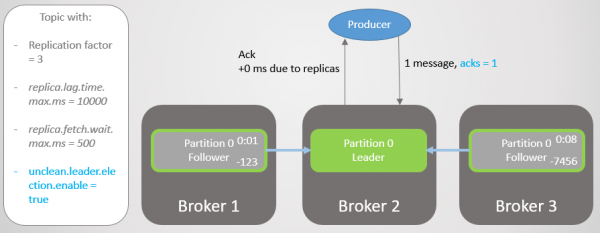
Slika 7. ISR s tri replike
Broker 2 je neaktivan, a proizvođač dobiva grešku veze. Nakon prijenosa liderstva na brokera 1, gubimo 123 poruke. Pratilac na brokeru 1 bio je u ISR-u, ali nije se potpuno sinkronizirao s liderom kada je on pao.
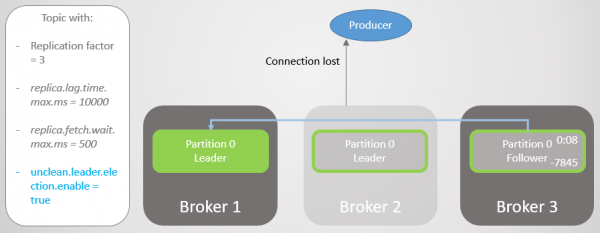
Slika 8. Gubitak poruka tijekom pada
U konfiguraciji bootstrap.servers proizvođač navodi nekoliko brokera i može pitati drugog brokera tko je novi lider podjele. Zatim uspostavlja vezu s brokerom 1 i nastavlja slati poruke.
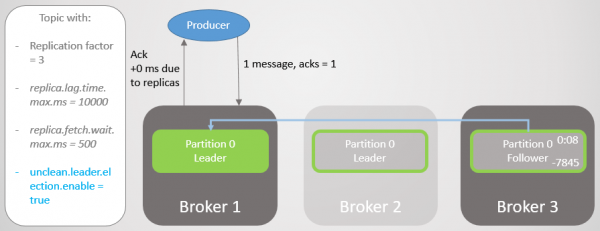
Slika 9. Slanje poruka se nastavlja nakon kratke pauze
Broker 3 još više zaostaje. Izvršava zahtjeve za povlačenje, ali se ne može sinkronizirati. To može biti uzrokovano sporom mrežnom povezanošću između brokera, problemima s pohranom itd. On se uklanja iz ISR-a. Sada ISR se sastoji od jedne replike - lidera! Proizvođač nastavlja slati poruke i dobiva potvrde.
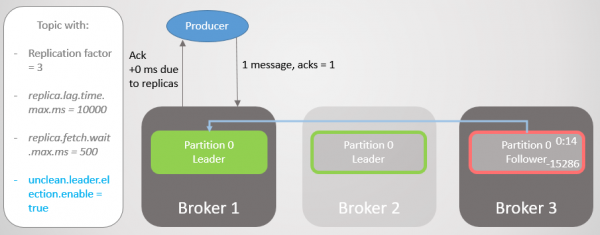
Slika 10. Pratilac na brokeru 3 uklanja se iz ISR-a
Broker 1 pada, a uloga lidera prelazi na brokera 3 uz gubitak od 15286 poruka! Proizvođač prima grešku veze. Prijelaz na lidera izvan ISR-a bio je moguć samo zbog postavke unclean.leader.election.enable=true. Ako je postavljen na false, prijelaz se ne bi dogodio, a svi zahtjevi za čitanje i pisanje bi bili odbijeni. U tom slučaju čekamo povratak brokera 1 sa svojim nepromijenjenim podacima u replici koja će ponovo preuzeti vođstvo.
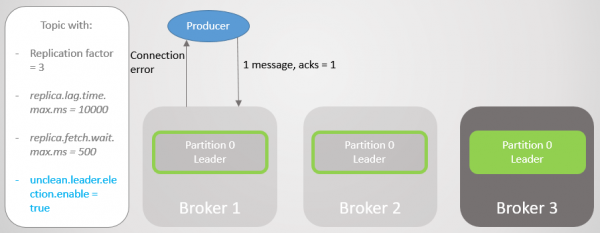
Slika 11. Broker 1 pada. Tijekom pada gubi se veliki broj poruka.
Proizvođač se povezuje s posljednjim brokerom i vidi da je sada on lider odjela. Počinje slati poruke brokeru 3.
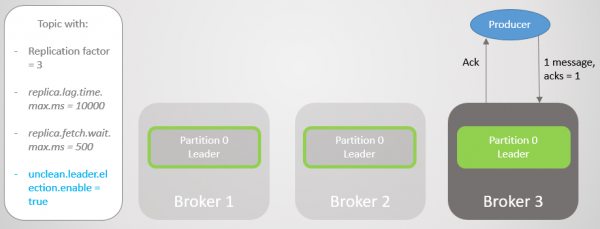
Slika 12. Nakon kratke pauze, poruke se ponovno šalju u dio 0
Vidjeli smo da je, osim kratkih prekida za uspostavljanje novih veza i pronalaženje novog lidera, proizvođač neprekidno slao poruke. Ova konfiguracija osigurava dostupnost uz održavanje dosljednosti (sigurnosti podataka). Kafka je izgubila tisuće poruka, ali je nastavila primati nove unose.
Acks=all i ISR
Ponovimo ovaj scenarij još jednom, ali s acks=all. Kašnjenje brokera 3 u prosjeku iznosi četiri sekunde. Proizvođač šalje poruku s acks=all, i sada ne dobiva brzi odgovor. Lider čeka da sve replikacije pohrane poruku u ISR.
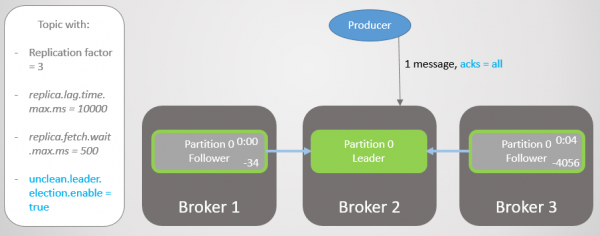
Slika 13. ISR s tri replike. Jedna radi sporo, što uzrokuje kašnjenje u pisanju
Nakon četiri sekunde dodatnog kašnjenja, broker 2 šalje ack. Sve replike su sada potpuno ažurirane.
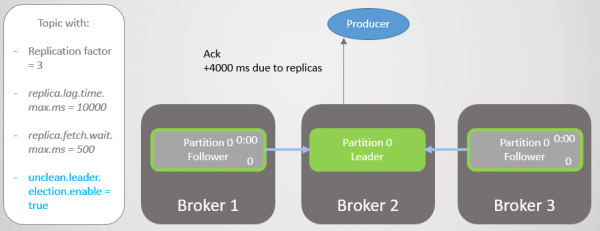
Slika 14. Sve replike pohranjuju poruke i šalju ack
Broker 3 sada zaostaje još više i uklanja se iz ISR. Kašnjenje se znatno smanjuje jer u ISR više nema sporih replika. Broker 2 sada čeka samo na brokera 1, a njegov prosječni zaostatak iznosi 500 ms.
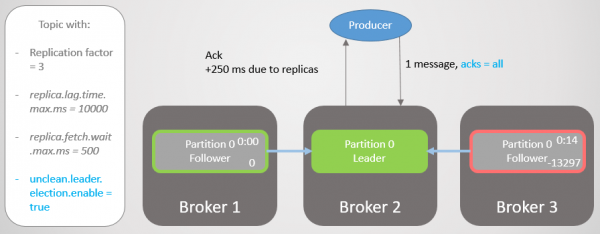
Slika 15. Replika na brokeru 3 uklanja se iz ISR
Zatim pada broker 2, a liderstvo prelazi na brokera 1 bez gubitka poruka.
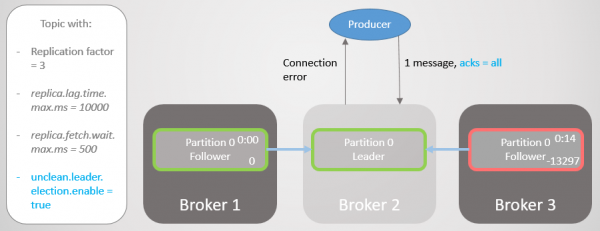
Slika 16. Broker 2 pada
Proizvođač pronalazi novog lidera i počinje mu slati poruke. Kašnjenje se dodatno smanjuje, jer sada ISR sastoji od samo jedne replike! Stoga opcija acks=all ne dodaje redundantnost.
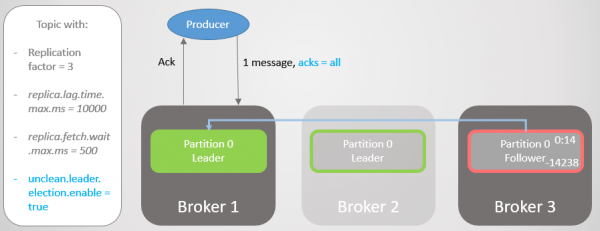
Slika 17. Replika na brokeru 1 preuzima liderstvo bez gubitka poruka
Zatim pada broker 1, a liderstvo prelazi na brokera 3 s gubitkom od 14238 poruka!
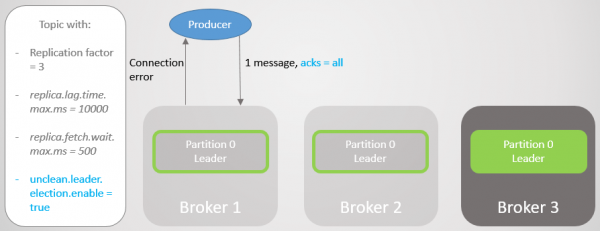
Slika 18. Broker 1 umire, a prijenos liderstva s postavkom unclean dovodi do opsežnog gubitka podataka
Nismo morali postaviti opciju unclean.leader.election.enable na true. Po defaultu je jednaka false. Postavka acks=all s unclean.leader.election.enable=true osigurava dostupnost uz neku dodatnu sigurnost podataka. Ali, kao što vidite, još uvijek možemo izgubiti poruke.
Ali što ako želimo povećati sigurnost podataka? Možemo postaviti unclean.leader.election.enable = false, ali to ne jamči zaštitu od gubitka podataka. Ako lider padne naglo i povuče sa sobom podatke, poruke će i dalje biti izgubljene, plus gubimo dostupnost dok administrator ne obnovi stanje.
Bolje je osigurati redundantnost svih poruka, a inače odustati od snimanja. Tada, barem sa stanovišta brokera, gubitak podataka moguć je samo u slučaju dva ili više istodobnih kvarova.
Acks=all, min.insync.replicas i ISR
S konfiguracijom teme min.insync.replicas povećavamo razinu sigurnosti podataka. Ajmo još jednom proći kroz posljednji dio prošlog scenarija, ali ovog puta s min.insync.replicas=2.
Dakle, broker 2 ima lider repliku, dok je follower na brokeru 3 uklonjen iz ISR.
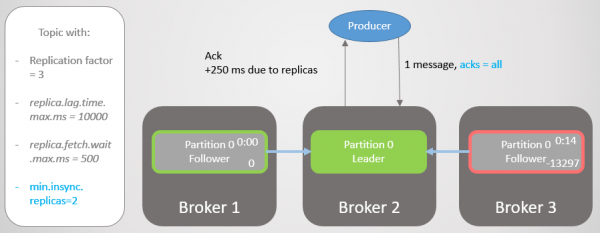
Sl. 19. ISR od dvije replike
Broker 2 pada, a liderstvo prelazi na broker 1 bez gubitka poruka. Ali sada je ISR sastavljen samo od jedne replike. To ne zadovoljava minimalni broj za prihvaćanje zapisa, i stoga broker odgovara na pokušaj snimanja greškom. NotEnoughReplicas.
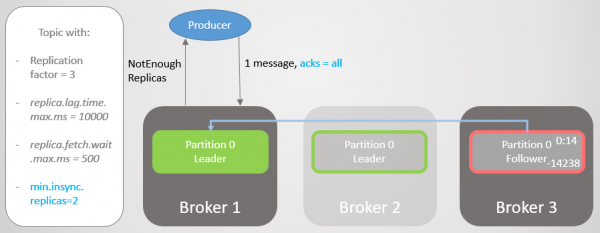
Sl. 20. Broj ISR-a je jedan manji od onog navedenog u min.insync.replicas
Ova konfiguracija žrtvuje dostupnost radi dosljednosti. Prije nego što potvrdimo poruku, osiguravamo da se ona snima na najmanje dvije replike. To daje proizvođaču mnogo veću sigurnost. Ovdje je gubitak poruka moguć samo u slučaju istodobnog kvara dviju replika u kratkom intervalu dok poruka nije replicirana dodatnom followeru, što je malo vjerojatno. Ali ako ste zaista paranoični, možete postaviti faktor replikacije na 5, a min.insync.replicas na 3. Ovdje tri brokera moraju pasti istovremeno da bi se izgubio zapis! Naravno, za tu pouzdanost platit ćete dodatnom kašnjenju.
Kada je dostupnost važna za sigurnost podataka
Kao i u , katkad je dostupnost potrebna za sigurnost podataka. Trebali biste razmisliti o ovome:
- Može li publisher jednostavno vratiti grešku, a nadležna služba ili korisnik pokušati ponovno kasnije?
- Može li publiser lokalno ili u bazi podataka sačuvati poruku da bi kasnije pokušao ponovo?
Ako je odgovor negativan, optimizacija dostupnosti povećava sigurnost podataka. Izgubit ćete manje podataka ako odaberete dostupnost umjesto odustajanja od snimanja. Tako se sve svodi na pronalaženje ravnoteže, a rješenje ovisi o konkretnoj situaciji.
Smisao ISR
ISR omogućuje odabir optimalne ravnoteže između sigurnosti podataka i kašnjenja. Na primjer, osigurava dostupnost u uvjetima kvara većine replika, minimizirajući utjecaj mrtvih ili sporih replika s obzirom na kašnjenje.
Mi sami biramo vrijednost replica.lag.time.max.ms sukladno našim potrebama. U suštini, ova opcija označava koliko kašnjenja smo spremni prihvatiti prilikom acks=all. Zadana vrijednost iznosi deset sekundi. Ako vam se čini da je to predugo, možete je smanjiti. Tada će se učestalost promjena u ISR-u povećati, jer će se sljedbenici češće uklanjati i dodavati.
U RabbitMQ je to jednostavno skup zrcala koja treba replicirati. Spora zrcala donose dodatno kašnjenje, a na odgovore mrtvih zrcala može se čekati sve do isteka vremena trajanja paketa koji provjeravaju dostupnost svakog čvora (net tick). ISR je zanimljiv način da se izbjegnu ti problemi s povećanjem kašnjenja. No, riskiramo gubitak redundancije, jer se ISR može smanjiti samo na lidera. Da bismo izbjegli ovaj rizik, koristite postavku min.insync.replicas.
Jamstvo povezivanja klijenata
U postavkama bootstrap.servers proizvođača i potrošača možete navesti nekoliko brokera za povezivanje klijenata. Ideja je da, u slučaju isključenja jednog čvora, ostane nekoliko rezervnih, s kojima klijent može otvoriti vezu. To nisu nužno lideri particija, već jednostavno platforma za inicijalno učitavanje. Klijent može pitati na kojem čvoru se nalazi lider particije za čitanje/pisanje.
U RabbitMQ klijenti se mogu povezati s bilo kojim čvorom, a interna usmjeravanja šalje zahtjev gdje je potrebno. To znači da možete postaviti balansator opterećenja ispred RabbitMQ-a. Kafka zahtijeva da se klijenti povežu s čvorom na kojem se nalazi lider odgovarajuće particije. U toj situaciji ne možete postaviti balansator opterećenja. Popis bootstrap.servers je kritično važan kako bi klijenti mogli pristupiti potrebnim čvorovima i pronaći ih nakon kvara.
Arhitektura konsenzusa u Kafki
Do sada nismo razmotrili kako klaster saznaje za pad brokera i kako se bira novi lider. Da bismo razumjeli kako Kafka radi s mrežnim podjelama, prvo trebamo razumjeti arhitekturu konsenzusa.
Svaki Kafka klaster se postavlja zajedno s Zookeeper klasterom — to je usluga distribuiranog konsenzusa koja omogućava sustavu da postigne konsenzus o nekom zadanom stanju s prioritetom na dosljednosti umjesto na dostupnosti. Za odobrenje operacija čitanja i pisanja potrebna je suglasnost većine Zookeeper čvorova.
Zookeeper pohranjuje stanje klastera:
- Popis tema, particija, konfiguraciju, trenutne vođe replika, preferirane replike.
- Članovi klastera. Svaki broker pinguje Zookeeper klaster. Ako ne primi ping unutar zadanog vremenskog perioda, Zookeeper bilježi brokera kao nedostupnog.
- Izbor glavnih i rezervnih čvorova za kontroler.
Kontroler čvor — jedan od Kafka brokera koji je odgovoran za izbor vođa replika. Zookeeper šalje kontroleru obavijesti o članstvu u klasteru i promjenama tema, a kontroler mora djelovati prema tim promjenama.
Na primjer, uzmimo novu temu s deset particija i koeficijentom replike 3. Kontroler mora izabrati vođu svake particije, pokušavajući optimizirati raspodjelu vođa između brokera.
Za svaku particiju kontroler:
- ažurira informacije u Zookeeper o ISR i vođi;
- šalje naredbu LeaderAndISRCommand svakom brokeru koji ima replikaciju te particije, obavještavajući brokere o ISR-u i vođi.
Kada broker s vođom padne, Zookeeper šalje obavijest kontroleru, a on bira novog vođu. Opet, kontroler prvo ažurira Zookeeper, a zatim šalje naredbu svakom brokeru, obavještavajući ih o promjeni vođe.
Svaki vođa je odgovoran za skup ISR. Konfiguracija replica.lag.time.max.ms određuje tko će biti uključen. Kada se ISR promijeni, vođa prosljeđuje Zookeeper nove informacije.
Zookeeper je uvijek informiran o bilo kojim promjenama, kako bi u slučaju kvara prijelaz vođstva bio nesmetan.
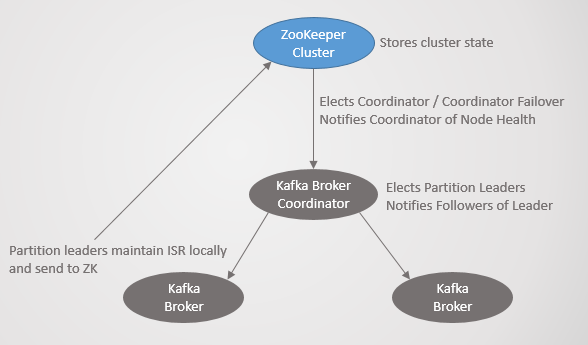
Sl. 21. Konsenzus Kafka
Protokol replikacije
Razumijevanje detalja replikacije pomaže bolje razumjeti potencijalne scenarije gubitka podataka.
Zahtjevi za preuzimanje, Log End Offset (LEO) i Highwater Mark (HW)
Istražili smo da followeri periodično šalju vođi zahtjeve za dohvat (fetch). Zadani interval iznosi 500 ms. To se razlikuje od RabbitMQ-a, gdje replikaciju inicira ne ogledalo reda, već master. Master šalje promjene na ogledala.
Vođa i svi followeri čuvaju pomak kraja dnevnika (Log End Offset, LEO) i oznaku Highwater (HW). Oznaka LEO čuva pomak posljednje poruke u lokalnoj replici, dok HW čuva pomak posljednjeg commit-a. Zapamtite da za status 'commit' poruka mora biti sačuvana u svim replikama ISR. To znači da LEO obično malo prethodi HW-u.
Kada vođa primi poruku, lokalno je pohranjuje. Follower šalje zahtjev za dohvat, predajući svoj LEO. Zatim vođa šalje paket poruka počevši od tog LEO-a, kao i prijenosi trenutni HW. Kada vođa primi informaciju da su sve replike pohranile poruku s zadanom označom, pomiče oznaku HW. Samo vođa može pomaknuti HW, a tako svi followeri saznaju trenutnu vrijednost iz odgovora na svoj zahtjev. To znači da followeri mogu kasniti za vođom, kako u porukama, tako i u poznavanju HW-a. Potrošači primaju poruke samo do trenutnog HW-a.
Obratite pažnju da 'pohranjeno' (persisted) znači zapisano u memoriju, a ne na disk. Za performanse, Kafka sinkronizira na disk s određenim intervalom. RabbitMQ također ima takav interval, ali će potvrditi publisheru tek nakon što master i sve replike zapišu poruku na disk. Razvojni tim Kafka je iz razloga performansi odlučio slati ack čim je poruka zapisana u memoriju. Kafka se oslanja na to da će redundancija nadoknaditi rizik kratkoročnog čuvanja potvrđenih poruka samo u memoriji.
Kvar vođe
Kada vođa padne, Zookeeper obavještava kontroler koji bira novu repliku vođe. Novi vođa postavlja novu oznaku HW u skladu s vlastitim LEO-om. Zatim followeri primaju informacije o novom vođi. Ovisno o verziji Kafke, follower može izabrati jedan od dva scenarija:
- Štitit će lokalni dnevnik do poznatog HW-a i poslati novom vođi zahtjev za poruke nakon te oznake.
- Šalje upit vođi da sazna HW u trenutku kada je izabran za vođu, a zatim skraćuje log do te pomake. Zatim počinje slati povremene upite za uzorkovanje, počinjući s tom pomakom.
Pratiocu može biti potrebno skratiti log iz sljedećih razloga:
- Kada dođe do kvara vođe, prvi pratilac iz skupa ISR, registriran u Zookeeperu, pobjeđuje na izborima i postaje vođa. Svi pratioci u ISR, iako se smatraju 'sinhroniziranim', možda nisu primili od prethodnog vođe kopije svih poruka. Moguće je da izabrani pratilac nema najnoviju kopiju. Kafka garantira da između replikacija nema razlika. Stoga, da bi se izbjegla nesukladnost, svaki pratilac mora skratiti svoj log do vrijednosti HW novog vođe u trenutku njegovog izbora. Ovo je još jedan razlog zašto je konfiguracija acks=all tako važna za dosljednost.
- Poruke se povremeno zapisuju na disk. Ako svi čvorovi klastera istovremeno otkaže, tada će na diskovima postojati replike s različitim pomacima. Moguće je da kada se brokeri ponovo vrate u mrežu, novi vođa koji bude izabran bude iza svojih pratilaca, jer je ranije sačuvao na disku.
Ponovno povezivanje s klasterom
Prilikom ponovnog povezivanja s klasterom replike postupaju na isti način kao i pri kvaru vođe: provjeravaju repliku vođe i skraćuju svoj log do njegovog HW (u trenutku izbora). Za usporedbu, RabbitMQ jednako tretira ponovno povezane čvorove kao potpuno nove. U oba slučaja broker odbacuje bilo koje postojeće stanje. Ako se koristi automatska sinhronizacija, tada glavni mora replicirati apsolutno sav trenutni sadržaj u novu ogledalo na način 'neka sav svijet čeka'. Tijekom ove operacije glavni ne prihvaća nikakve operacije čitanja ili pisanja. Ovaj pristup stvara probleme u velikim redovima.
Kafka je distribuirani log, koji u cjelini pohranjuje više poruka nego RabbitMQ red, gdje se podaci brišu iz reda nakon čitanja. Aktivni redovi trebaju ostati relativno mali. No, Kafka je log s svojom politikom pohrane, koja može postaviti rok od dana ili tjedana. Pristup blokiranju reda i punoj sinkronizaciji je potpuno neprihvatljiv za distribuirani log. Umjesto toga, Kafka followeri jednostavno skraćuju svoj log do HW lidera (u trenutku njegovog izbora) ako njihova kopija pređe lidera. U vjerojatnijem slučaju, kada je follower iza, jednostavno započinje s upitima za dohvat, počinjući od svog trenutnog LEO.
Novi ili ponovno pridruženi followeri započinju izvan ISR-a i ne sudjeluju u commitima. Oni jednostavno rade uz grupu, primajući poruke što brže mogu, dok ne sustignu lidera i uđu u ISR. Ovdje nema blokade i nije potrebno odbacivati sve svoje podatke.
Prekid povezanosti
Kafka ima više komponenti nego RabbitMQ, stoga je ovdje kompleksniji skup ponašanja kada se u klasteru naruši povezanost. No, Kafka je prvotno projektirana za klastere, tako da su rješenja vrlo dobro osmišljena.
U nastavku su prikazani neki scenariji narušavanja povezanosti:
- Scenarij 1. Follower ne vidi lidera, ali i dalje vidi Zookeeper.
- Scenarij 2. Lider ne vidi nijednog followera, ali i dalje vidi Zookeeper.
- Scenarij 3. Follower vidi lidera, ali ne vidi Zookeeper.
- Scenarij 4. Lider vidi followere, ali ne vidi Zookeeper.
- Scenarij 5. Follower je potpuno odvojen i od drugih Kafka čvorova i od Zookeepera.
- Scenarij 6. Lider je potpuno odvojen i od drugih Kafka čvorova i od Zookeepera.
- Scenarij 7. Kafka kontroler ne vidi drugi Kafka čvor.
- Scenarij 8. Kontroler Kafka ne vidi Zookeeper.
Za svaki scenarij predviđeno je svoje ponašanje.
Scenarij 1. Follower ne vidi lidera, ali i dalje vidi Zookeeper
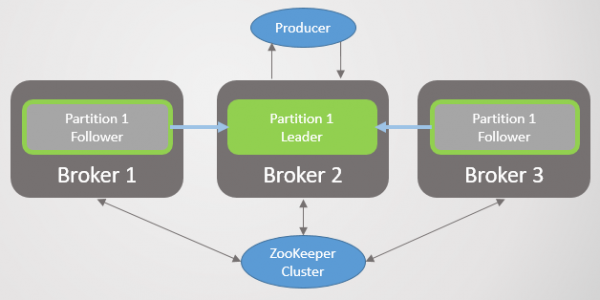
Sl. 22. Scenarij 1. ISR od tri replike
Narušavanje povezanosti odvaja poslužitelj 3 od poslužitelja 1 i 2, ali ne i od Zookeepera. Poslužitelj 3 više ne može slati upite za dohvat. Nakon isteka vremena replica.lag.time.max.ms on se uklanja iz ISR-a i ne sudjeluje u porukama koje se potvrđuju. Kada se povezanost vrati, nastavit će s preuzimanjem zahtjeva i pridružit će se ISR-u kada sustigne vođu. Zookeeper će i dalje primati ping signale i smatrati da je poslužitelj živ i zdrav.
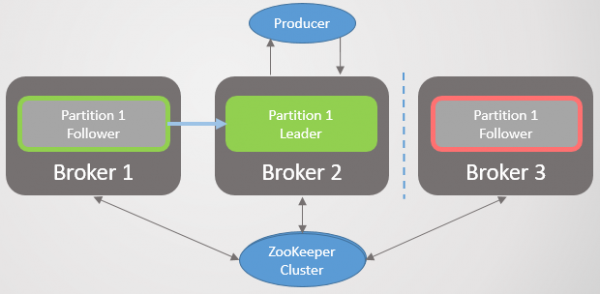
Slika 23. Scenarij 1. Poslužitelj se uklanja iz ISR-a ako ne primi zahtjev za preuzimanje unutar intervala replica.lag.time.max.ms.
Nema logičke podijeljenosti (split-brain) niti prekida čvora, kao kod RabbitMQ. Umjesto toga, smanjuje se redundancija.
Scenarij 2. Vođa ne vidi nijednog sljedbenika, ali još uvijek vidi Zookeeper.
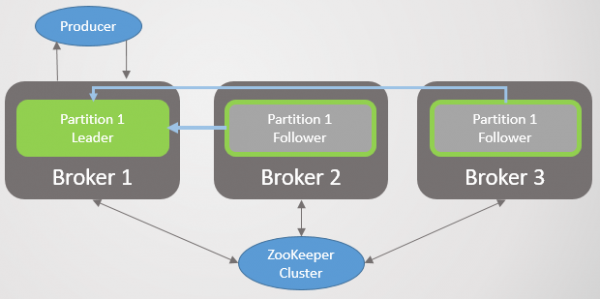
Slika 24. Scenarij 2. Vođa i dva sljedbenika.
Odstupanje mrežne povezanosti odvaja vođu od sljedbenika, ali poslužitelj još uvijek vidi Zookeeper. Kao i u prvom scenariju, ISR se smanjuje, ali ovaj put samo do vođe, budući da svi sljedbenici prestaju slati zahtjeve za preuzimanje. Ponovno, nema logičke podijeljenosti. Umjesto toga, dolazi do gubitka redundancije za nove poruke, dok se povezanost ne vrati. Zookeeper i dalje prima ping signale i smatra da je poslužitelj živ i zdrav.
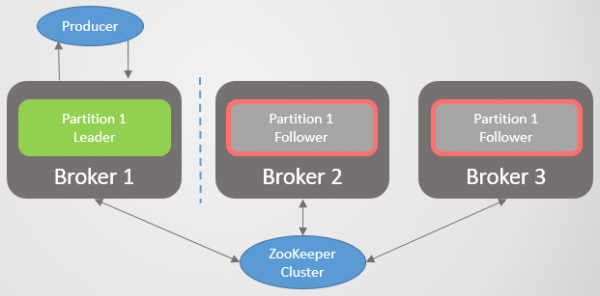
Slika 25. Scenarij 2. ISR se smanjio samo na vođu.
Scenarij 3. Sljedbenik vidi vođu, ali ne vidi Zookeeper.
Sljedbenik se odvaja od Zookeeper-a, ali ne od poslužitelja s vođom. Kao rezultat, sljedbenik nastavlja slati zahtjeve za preuzimanjem i biti član ISR-a. Zookeeper više ne prima ping signale i bilježi pad poslužitelja, ali budući da je to samo sljedbenik, nema nikakvih posljedica nakon oporavka.
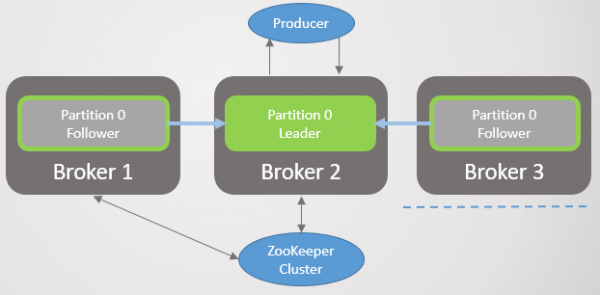
Slika 26. Scenarij 3. Sljedbenik nastavlja slati zahtjeve za preuzimanje vođi.
Scenarij 4. Vođa vidi sljedbenike, ali ne vidi Zookeeper.
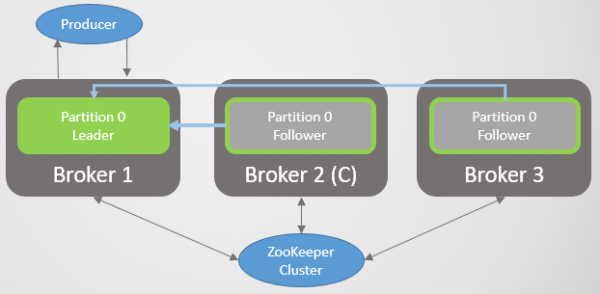
Slika 27. Scenarij 4. Vođa i dva sljedbenika.
Vođa je odvojen od Zookeeper-a, ali ne i od poslužitelja sa sljedbenicima.
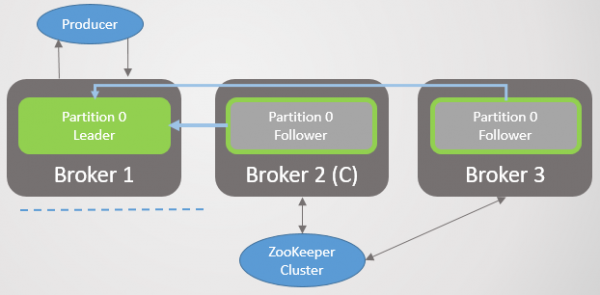
Slika 28. Scenarij 4. Vođa je izoliran od Zookeeper.
Nakon nekog vremena Zookeeper će registrirati pad poslužitelja i obavijestiti kontroler. On će izabrati novog vođu među sljedbenicima. Međutim, izvorni vođa će nastaviti misliti da je on vođa i nastaviti primati zapise s acks=1. Sljedbenici mu više ne šalju zahtjeve za preuzimanje, pa će ih smatrati mrtvima i pokušati smanjiti ISR do samog sebe. No, budući da nema povezivanja sa Zookeeper-om, neće moći to učiniti, a u tom trenutku odbacit će daljnje primanje zapisa.
Poruke acks=all neće primiti potvrde jer ISR prvo uključuje sve replike, a do njih poruke ne stižu. Kada se prvotni lider pokuša iz njih izuzeti iz ISR-a, neće to moći učiniti i potpuno će prestati primati bilo kakve poruke.
Klijenti ubrzo primijete promjenu lidera i počinju slati zapise na novi poslužitelj. Čim se mreža oporavi, izvorni lider vidi da više nije lider i sužava svoj log na HW vrijednost koju je novi lider imao u trenutku kvara kako bi izbjegao nesigurnost logova. Zatim će početi slati zahtjeve za izbor novom lideru. Sve zgube izvorni lider, ne repliciraju se novom lideru. To znači da će poruke koje nisu bile potvrđene od strane prvotnog lidera u onih nekoliko sekundi dok su radila dva lidera biti izgubljene.
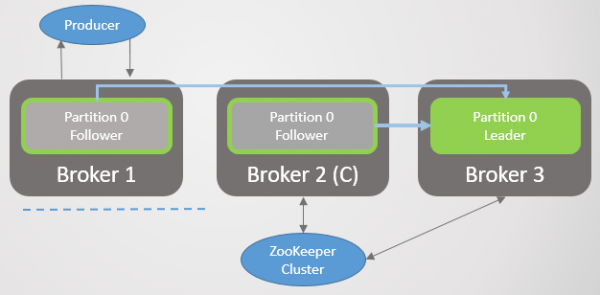
Sl. 29. Scenarij 4. Lider na brokeru 1 postaje follower nakon oporavka mreže
Scenarij 5. Follower je potpuno odvojen i od drugih Kafka čvorova i od Zookeeper-a
Follower je potpuno izoliran i od drugih Kafka čvorova i od Zookeeper-a. Jednostavno se uklanja iz ISR-a dok se mreža ne oporavi, a zatim sustiže ostale.

Sl. 30. Scenarij 5. Izolirani follower se uklanja iz ISR-a
Scenarij 6. Lider je potpuno odvojen i od drugih Kafka čvorova i od Zookeeper-a
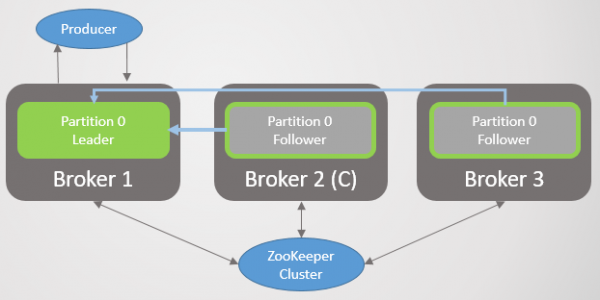
Sl. 31. Scenarij 6. Lider i dva followera
Lider je potpuno izoliran od svojih followera, kontrolera i Zookeeper-a. Tijekom kratkog razdoblja nastavit će primati zapise s acks=1.
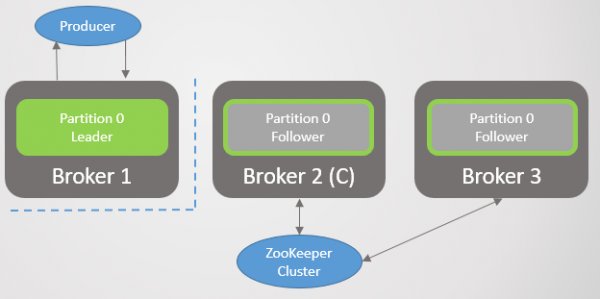
Sl. 32. Scenarij 6. Izolacija lidera od drugih Kafka čvorova i Zookeeper-a
Ne primivši zahtjeve nakon replica.lag.time.max.ms, pokušat će suziti ISR na sebe, ali to neće moći učiniti jer nema veze sa Zookeeper-om, tada će prestati primati zapise.
U međuvremenu, Zookeeper će označiti izoliranog brokera kao mrtvog, a kontroler će izabrati novog lidera.
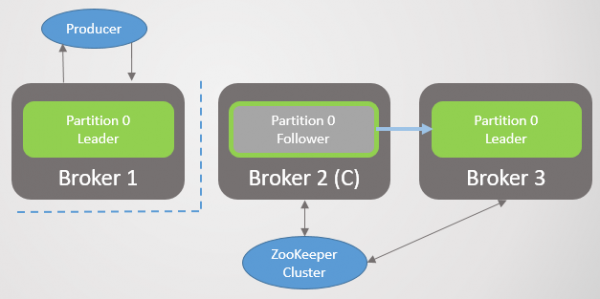
Sl. 33. Scenarij 6. Dva lidera
Izvorni lider može primati zapise nekoliko sekundi, ali zatim prestaje primati bilo kakve poruke. Klijenti se ažuriraju svake 60 sekundi s najnovijim metapodacima. Bit će obaviješteni o promjeni lidera i početi slati zapise novom lideru.
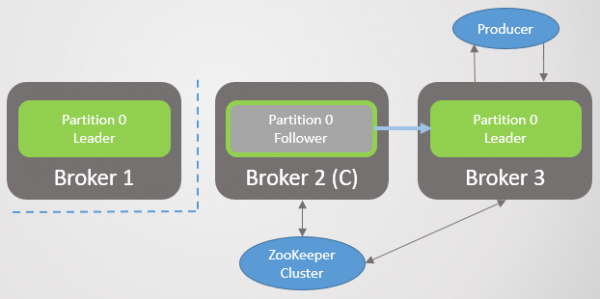
Sl. 34. Scenarij 6. Proizvođači se prebacuju na novog lidera
Bit će izgubljeni svi potvrđeni unosi koje je izvršio izvorni vođa od trenutka gubitka povezanosti. Kada se mreža vrati, izvorni vođa će putem Zookeepera otkriti da više nije vođa. Zatim će skratiti svoj dnevnik do HW novog vođe u trenutku izbora i početi slati zahtjeve kao sljedbenik.
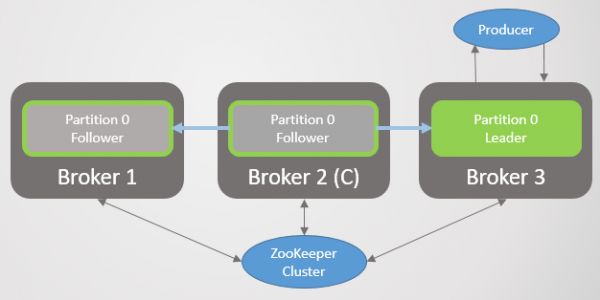
Sl. 35. Scenarij 6. Izvorni vođa postaje sljedbenik nakon vraćanja povezanosti mreže
U ovoj situaciji može doći do logičkog razdvajanja u vrlo kratkom vremenskom razdoblju, ali samo ako acks=1 i min.insync.replicas isto 1. Logičko razdvajanje automatski završava ili nakon vraćanja mreže, kada izvorni vođa shvati da više nije vođa, ili kada svi klijenti shvate da se vođa promijenio i počnu pisati novom vođi — ovisno o tome što se dogodi prvo. U svakom slučaju doći će do gubitka nekih poruka, ali samo s acks=1.
Postoji druga mogućnost ovog scenarija, kada su neposredno prije razdvajanja mreže sljedbenici zaostali, a vođa je suzio ISR na jednog sebe. Zatim se izolira zbog gubitka povezanosti. Izabire se novi vođa, ali izvorni vođa nastavlja primati unose, čak acks=all, jer u ISR osim njega nema nikoga. Ti unosi bit će izgubljeni nakon vraćanja mreže. Jedini način da se izbjegne ovakva situacija — min.insync.replicas = 2.
Scenarij 7. Kafka kontroler ne vidi drugi Kafka čvor
Općenito, nakon gubitka veze s Kafka čvorom, kontroler neće moći prenijeti nikakve informacije o promjeni vođe. U najgorem slučaju to će dovesti do kratkotrajnog logičkog razdvajanja, kao u scenariju 6. Najčešće broker jednostavno neće postati kandidat za vođstvo u slučaju kvara posljednjeg.
Scenarij 8. Kafka kontroler ne vidi Zookeeper
Od odvojenog kontrolera Zookeeper neće primiti ping i izabrat će novi Kafka čvor za kontrolera. Izvorni kontroler može i dalje predstavljati sebe kao takvog, ali ne prima obavijesti od Zookeepera, stoga neće imati nikakve zadatke za izvršenje. Kada se mreža povrne, shvatit će da više nije kontroler, nego običan Kafka čvor.
Zaključci iz scenarija
Vidimo da gubitak povezanosti pratitelja ne dovodi do gubitka poruka, već jednostavno privremeno smanjuje redundanciju dok se mreža ne obnovi. To naravno može dovesti do gubitka podataka ako su izgubljene jedna ili više čvorova.
Ako se zbog gubitka povezanosti vođa odvoji od Zookeepera, to može dovesti do gubitka poruka s acks=1. Nedostatak veze sa Zookeeperom uzrokuje kratkotrajno logičko podijeljeno vođstvo s dva vođe. Ovaj problem rješava parametar acks=all.
Parametar min.insync.replicas u dvije ili više replika daje dodatne garancije da takvi kratkoročni scenariji neće dovesti do gubitka poruka, kao u scenariju 6.
Sažetak o gubitku poruka
Nabrojimo sve načine na koje se podaci mogu izgubiti u Kafki:
- Bilo kakav kvar vođe, ako su poruke potvrđene pomoću acks=1
- Bilo kakvo neuredno (unclean) prijelaz vođstva, tj. na pratitelja izvan ISR-a, čak i s acks=all
- Izolacija vođe od Zookeepera, ako su poruke potvrđene pomoću acks=1
- Potpuna izolacija vođe koji je već smanjio ISR grupu na sebe. Sve poruke će biti izgubljene, čak i acks=all. Ovo vrijedi samo ako min.insync.replicas=1.
- Istodobni kvarovi svih čvorova particije. Budući da se poruke potvrđuju iz memorije, neke možda još nisu zapisane na disk. Nakon ponovnog pokretanja poslužitelja, možda će nedostajati nekih poruka.
Neuredne prijelaze vođstva moguće je izbjeći ili zabranom ili osiguravanjem redundancije od barem dva. Najčišća konfiguracija je kombinacija acks=all i min.insync.replicas više od 1.
Direktno usporedba pouzdanosti RabbitMQ i Kafke
Kako bi se osigurala pouzdanost i visoka dostupnost, obje platforme implementiraju sustav primarne i sekundarne replikacije. Međutim, RabbitMQ ima ahilovu petu. Prilikom ponovnog povezivanja nakon kvara, čvorovi odbacuju svoje podatke, a sinkronizacija se blokira. Ovaj dvostruki udar dovodi u pitanje dugovječnost velikih redova u RabbitMQ-u. Morat ćete se pomiriti ili s smanjenjem redundancije ili s dugim blokadama. Smanjenje redundancije povećava rizik od masovnog gubitka podataka. No, ako su redovi mali, vi možete nositi se s osiguranjem redundancije uz kratke periode nedostupnosti (nekoliko sekundi) pomoću ponovljenih pokušaja povezivanja.
U Kafki ne postoji takav problem. Ona odbacuje podatke samo s točke razilaženja vođe i sljedbenika. Svi zajednički podaci se čuvaju. Osim toga, replikacija ne blokira sustav. Vođa nastavlja primati zapise dok se novi sljedbenik ne uhvati u korak, tako da za DevOps timove pridruživanje ili ponovno povezivanje klastera postaje trivijalni zadatak. Naravno, još uvijek postoje problemi, kao što je propusnost mreže tijekom replikacije. Ako se istovremeno dodaje nekoliko sljedbenika, može doći do ograničenja propusnosti.
RabbitMQ nadmašuje Kafku u pouzdanosti tijekom istovremenog kvara više poslužitelja u klasteru. Kao što smo već spomenuli, RabbitMQ šalje potvrdu izdavaču tek nakon što je poruka zapisana na disk kod vođe i svih zrcala. No, to dodaje dodatno kašnjenje iz dva razloga:
- fsync svakih nekoliko stotina milisekundi
- Kvar zrcala može se primijetiti tek nakon isteka vremena života paketa, koji provjeravaju dostupnost svakog čvora (net tick). Ako zrcalo zapne ili padne, to stvara kašnjenje.
Kafka se oslanja na to da ako se poruka čuva na nekoliko čvorova, poruke se mogu potvrditi čim stignu u memoriju. Zbog toga postoji rizik od gubitka poruka bilo koje vrste (čak i acks=all, min.insync.replici=2) u slučaju istovremenog kvara.
Općenito, Kafka pokazuje veću učinkovitost i prvotno je dizajnirana za klastere. Broj sljedbenika može se povećati na 11 ako je to potrebno za pouzdanost. Omjer replikacije 5 i minimalan broj replik u sinkroniziranom stanju min.insync.replicas=3 učinit će gubitak poruke vrlo rijetkim događajem. Ako vaša infrastruktura može osigurati takav omjer replikacije i razinu redundantnosti, možete odabrati ovu opciju.
Klasteriranje RabbitMQ je dobro za male redove. No, čak i mali redovi mogu brzo rasti pri velikom prometu. Kada redovi postanu veliki, morat ćete donijeti tešku odluku između dostupnosti i pouzdanosti. Klasteriranje RabbitMQ najbolje je prilagođeno za manje tipične situacije, gdje prednosti fleksibilnosti RabbitMQ nadmašuju bilo kakve nedostatke njegovog klasteriranja.
Jedan od načina za rješavanje ranjivosti RabbitMQ vezano uz velike redove je njihovo razdvajanje na mnogo manjih. Ako ne zahtijevate potpuno uređenje cijelog reda, već samo odgovarajućih poruka (na primjer, poruka određenog klijenta), ili čak ne uređujete ništa, ova opcija je prihvatljiva: pogledajte moj projekt za razdvajanje reda (projekt je još u ranoj fazi).
Na kraju, ne zaboravite na niz grešaka u mehanizmima klasterizacije i replikacije kako RabbitMQ, tako i Kafka. S vremenom su sustavi postali zreliji i stabilniji, ali nijedna poruka nikada neće biti 100% zaštićena od gubitka! Osim toga, u data centrima se događaju masovne nesreće!
Ako sam nešto propustio, napravio grešku ili se ne slažete s bilo kojim od tvrdnji, slobodno ostavite komentar ili me kontaktirajte.
Često me pitaju: „Što izabrati, Kafka ili RabbitMQ?“, „Koja platforma je bolja?“. Istina je da to stvarno ovisi o vašoj situaciji, trenutnom iskustvu itd. Ne usudim se izraziti svoje mišljenje, jer bi bilo preveliko pojednostavljivanje preporučiti jednu platformu za sve mogućnosti korištenja i potencijalna ograničenja. Napisao sam ovaj ciklus članaka kako biste mogli formirati svoje vlastito mišljenje.
Želim reći da su oba sustava lideri u ovom području. Možda sam malo pristran, jer u iskustvu svojih projekata više cijenim stvari kao što su zajamčeno uređenje poruka i pouzdanost.
Vidim druge tehnologije kojima nedostaje ta pouzdanost i zajamčeno uređenje, a zatim gledam na RabbitMQ i Kafka — i shvaćam nevjerojatnu vrijednost obaju sustava.
Izvor: habr.com
