

Otpornost na greške i visoka dostupnost su velike teme, pa ćemo RabbitMQ i Kafki posvetiti odvojene članke. Ovaj članak se bavi RabbitMQ-om, dok će sljedeći biti o Kafki, u usporedbi s RabbitMQ-om. Članak je dugačak, pa se udobno smjestite.
Pogledajmo strategije otpornosti na greške, dosljednosti i visoke dostupnosti (HA), kao i kompromise koji se moraju praviti u svakoj strategiji. RabbitMQ može raditi na klasteru čvorova — i tada se klasificira kao distribuirani sustav. Kada govorimo o distribuiranim sustavima, često raspravljamo o dosljednosti i dostupnosti.
Ovi pojmovi opisuju kako sustav reagira na kvar. Kvar mrežne veze, kvar servera, kvar tvrdog diska, privremena nedostupnost servera zbog sakupljanja smeća, gubitak paketa ili usporenje mrežne veze. Sve to može dovesti do gubitka podataka ili sukoba. Naime, gotovo je nemoguće podići sustav koji je istovremeno potpuno dosljedan (bez gubitka podataka, bez konflikta podataka) i dostupan (koji će prihvatiti operacije čitanja i pisanja) za sve slučajeve kvara.
Vidjet ćemo da se dosljednost i dostupnost nalaze na suprotnim krajevima spektra, pa morate odabrati prema kojoj strani želite optimizirati. Dobra vijest je da je s RabbitMQ-om takav izbor moguć. Imate gotovo "nerdovske" poluge za pomicanje ravnoteže prema većoj dosljednosti ili većoj dostupnosti.
Posebnu pažnju posvetit ćemo onome što konfiguracije dovode do gubitka podataka zbog potvrđenih zapisa. Postoji lanac odgovornosti između izdavača, posrednika i potrošača. Nakon što je poruka predana posredniku, njegova je dužnost — ne izgubiti poruku. Kada posrednik potvrdi izdajatelju da je primio poruku, ne očekujemo da će biti izgubljena. No, vidjet ćemo da se to zaista može dogoditi ovisno o konfiguraciji vašeg posrednika i izdavača.
Primitivi otpornosti jednog čvora
Otpornim redovima/maršrutiranjem
U RabbitMQ postoje dvije vrste redova: trajni (durable) i nestabilni (non-durable). Svi redovi se pohranjuju u Mnesia bazi podataka. Trajni redovi se ponovno deklariraju prilikom pokretanja čvora i na taj način preživljavaju ponovno pokretanje, pad sistema ili pad poslužitelja (sve dok se podaci pohranjuju). To znači da dok deklarirate usmjeravanje (exchange) i redove kao trajne, infrastruktura redova/usmjeravanja će se vratiti u operativni režim.
Nestabilni redovi i usmjeravanje se brišu prilikom ponovnog pokretanja čvora.
Trajne poruke
Samo to što je red dugotrajan ne znači da će sve njegove poruke preživjeti ponovno pokretanje čvora. Obnovit će se samo poruke koje je publisher označio kao trajni (persistent). Trajne poruke zaista stvaraju dodatni teret za brokera, ali ako je gubitak poruke neprihvatljiv, onda nema druge solucije.
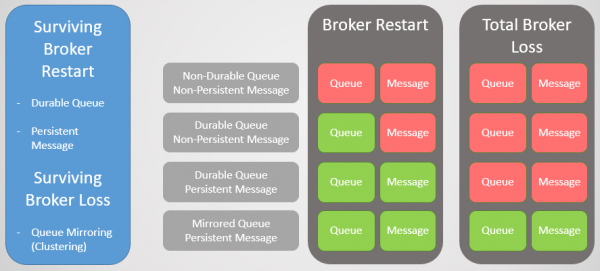
Sl. 1. Matrica trajnosti
Klastriranje s replikacijom redova
Da bismo preživjeli gubitak brokera, potrebna nam je redundancija. Možemo spojiti nekoliko RabbitMQ čvorova u klaster, a zatim dodati dodatnu redundanciju replikacijom redova između više čvorova. Na taj način, ako jedan čvor padne, ne gubimo podatke i ostajemo dostupni.
Replikacija reda:
- jedan glavni red (master) koji prima sve upute za pisanje i čitanje
- jedna ili više replika koje primaju sve poruke i metapodatke iz glavnog reda. Ove replikacije ne postoje za skaliranje, već isključivo za redundanciju.
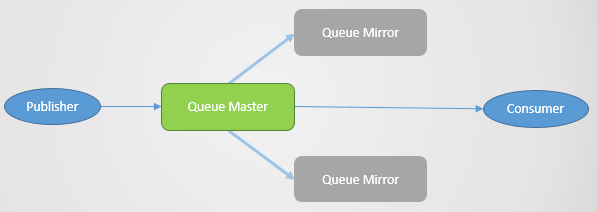
Sl. 2. Replikacija reda
Replikacija se postavlja odgovarajućom politikom. U njoj se može odabrati koeficijent replikacije i čak čvorovi na kojima bi se red trebao nalaziti. Primjeri:
ha-mode: allha-mode: exactly, ha-params: 2(jedan master i jedna replika)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Potvrda publisheru
Za dosljedno pohranu potrebna su potvrđenja od izdavača (Publisher Confirms). Bez njih postoji rizik od gubitka poruka. Potvrda se šalje izdavaču nakon što je poruka snimljena na disk. RabbitMQ snima poruke na disk ne prilikom primitka, već periodično, svakih nekoliko stotina milisekundi. Kada se red zrcali, potvrda se šalje samo nakon što su sve kopije također snimile svoju verziju poruke na disk. To znači da korištenje potvrda dodaje kašnjenje, no ako je sigurnost podataka važna, one su neophodne.
Red s visokom dostupnošću
Kada broker prestane s radom ili doživi kvar, svi primarni redovi (majstori) na tom čvoru padaju zajedno s njim. Tada klaster odabire najstarije zrcalo svakog majstora i unapređuje ga u novi majstor.
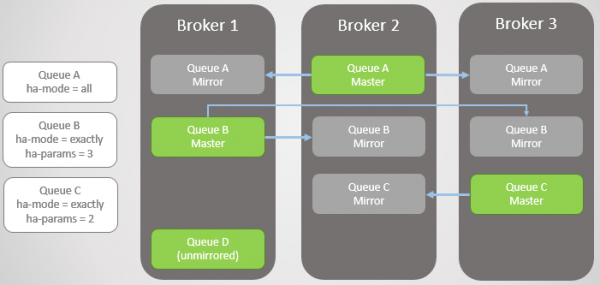
Slika 3. Više zrcaljenih redova i njihove politike
Broker 3 pada. Primijetite da se zrcalo Reda C na Brokeru 2 unapređuje u majstora. Također, primijetite da je novo zrcalo za Red C stvoreno na Brokeru 1. RabbitMQ uvijek nastoji održavati omjer replikacije naveden u vašim politikama.
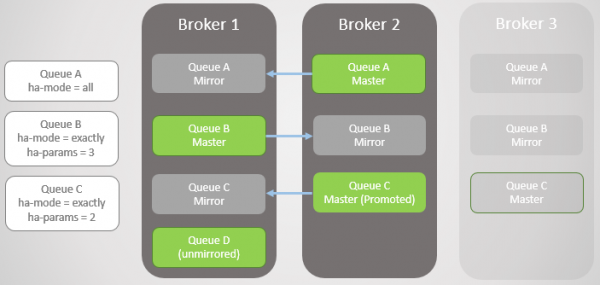
Slika 4. Broker 3 pada, što uzrokuje kvar reda C
Pada sljedeći Broker 1! Ostaće nam samo jedan broker. Zrcalo Reda B se unapređuje u majstora.
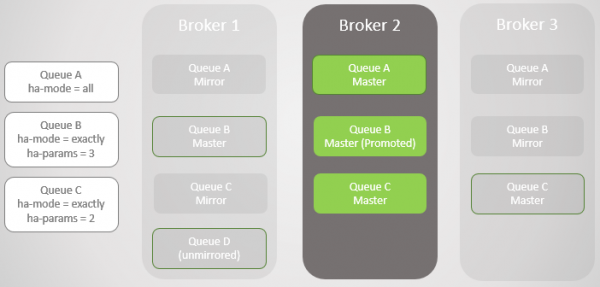
Slika 5
Vratili smo Broker 1. Bez obzira na to koliko su uspješno podaci preživjeli gubitak i oporavak brokera, sve zrcaljene poruke reda se odbacuju prilikom ponovnog pokretanja. Ovo je važno napomenuti jer će biti posljedica. Ubrzo ćemo razmotriti te posljedice. Tako da je Broker 1 sada ponovno član klastera, a klaster pokušava poštovati politike i stoga stvara zrcala na Brokeru 1.
U ovom slučaju, gubitak Brokera 1 bio je potpun, kao i podataka, stoga je nezrcaljeni Red B potpuno izgubljen.
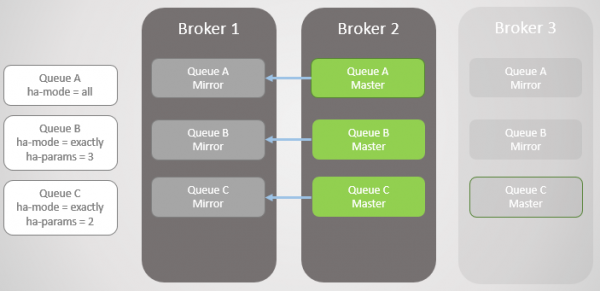
Slika 6. Broker 1 se vraća u rad
Broker 3 se vratio u rad, tako da redovi A i B ponovno dobivaju kreirane na njemu zrcalne redove kako bi zadovoljili svoje HA politike. No sada su svi glavni redovi na jednom čvoru! To nije idealno, bolje je ravnomjerno raspoređivanje između čvorova. Nažalost, ovdje nema posebnih opcija za prebalansiranje majstora. Vratit ćemo se ovom problemu kasnije, jer prvo trebamo razmotriti sinhronizaciju reda.
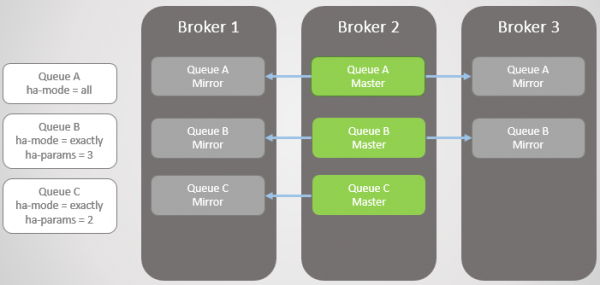
Sl. 7. Broker 3 se vraća u rad. Svi glavni redovi na jednom čvoru!
Dakle, sada biste trebali imati dojam o tome kako zrcala osiguravaju redundanciju i otpornost na kvarove. To jamči dostupnost u slučaju kvara jednog čvora i štiti od gubitka podataka. No, još nismo završili, jer je sve zapravo mnogo složenije.
Sinhronizacija
Kada se kreira novo zrcalo, sve nove poruke uvijek će se replicirati u to zrcalo i svako drugo. Što se tiče postojećih podataka u glavnom redu, možemo ih replicirati u novo zrcalo, koje postaje potpuna kopija majstora. Također možemo ne replicirati postojeće poruke i dopustiti glavnom redu i novom zrcalu da se sretnu tijekom vremena kada nove poruke dolaze na kraj, a postojeće poruke odlaze iz glave glavnog reda.
Takva sinhronizacija se provodi automatski ili ručno i upravlja se politikom redova. Razmotrite primjer.
Imamo dva zrcaljena reda. Red A se sinhronizira automatski, dok se Red B sinhronizira ručno. U oba reda ima po deset poruka.
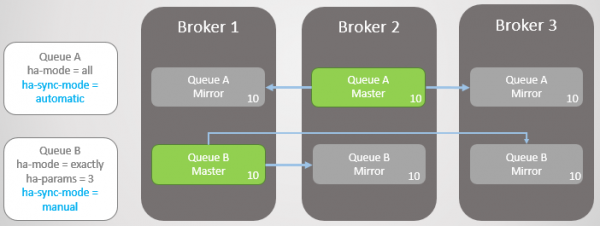
Sl. 8. Dva reda s različitim načinima sinhronizacije
Sada gubimo Brokera 3.
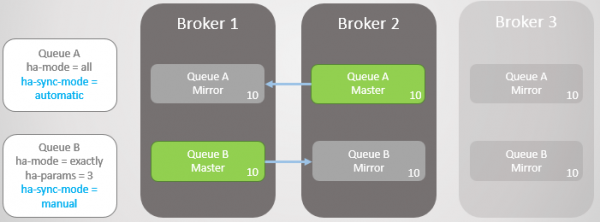
Sl. 9. Broker 3 je pao
Broker 3 se vraća u rad. Klaster stvara zrcalo za svaki red na novom čvoru i automatski sinhronizira novi Red A s majstorom. Međutim, zrcalo novog Reda B ostaje prazno. Tako imamo punu redundanciju Reda A i samo jedno zrcalo za postojeće poruke Reda B.
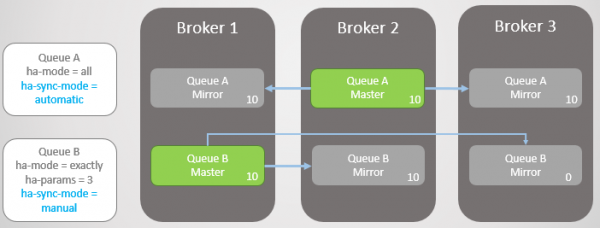
Sl. 10. Novo zrcalo Reda A dobiva sve postojeće poruke, dok novo zrcalo Reda B ne dobiva nijednu
U oba reda dolazi još po deset poruka. Zatim Broker 2 pada, a Red A se vraća na najstarije zrcalo koje se nalazi na Brokeru 1. Tijekom kvara ne dolazi do gubitka podataka. U Redu B ima dvadeset poruka u masteru i samo deset u zrcalu, budući da ovaj red nikada nije replicirao izvornih deset poruka.
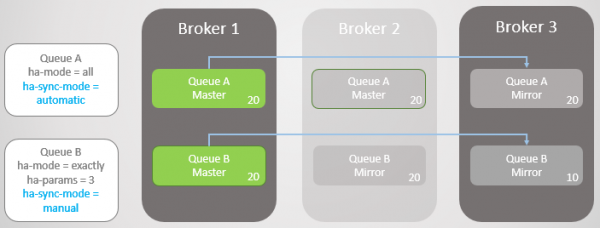
Sl. 11. Red A se vraća na Brokera 1 bez gubitka poruka
U oba reda dolazi još po deset poruka. Sada pada Broker 1. Red A se bez problema prebacuje na zrcalo bez gubitka poruka. Međutim, Red B ima problema. U ovoj fazi možemo optimizirati ili dostupnost ili dosljednost.
Ako želimo optimizirati dostupnost, tada politiku ha-promote-on-failure treba postaviti na always. Ova vrijednost je zadana, tako da se politika može jednostavno ne navesti. U tom slučaju, zapravo dopuštamo kvarove na nesinkroniziranim zrcalima. To će dovesti do gubitka poruka, ali red ostaje dostupan za čitanje i pisanje.
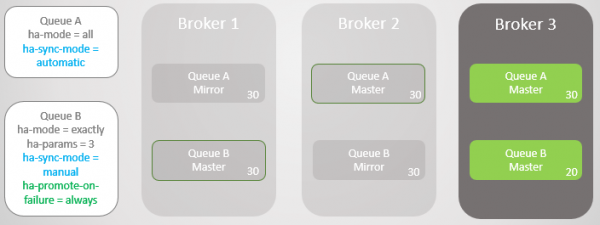
Sl. 12. Red A se vraća na Brokera 3 bez gubitka poruka. Red B se vraća na Brokera 3 s gubitkom od deset poruka
Također možemo postaviti ha-promote-on-failure na when-synced. U tom slučaju, umjesto vraćanja na zrcalo, red će čekati da se Broker 1 sa svojim podacima vrati u operativni način rada. Nakon njegovog povratka, glavni red se ponovno nalazi na Brokeru 1 bez gubitka podataka. Dostupnost se žrtvuje zbog sigurnosti podataka. No, to je rizičan način rada koji može dovesti čak i do potpunog gubitka podataka, što ćemo razmotriti uskoro.
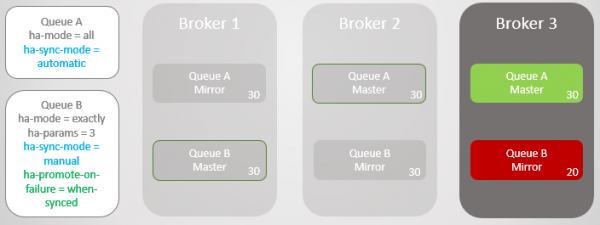
Sl. 13. Red B ostaje nedostupan nakon gubitka Brokera 1
Možete postaviti pitanje: "Možda je bolje nikad ne koristiti automatsku sinkronizaciju?". Odgovor je da je sinkronizacija blokirajuća operacija. Tijekom sinkronizacije, glavni red ne može izvršavati nikakve operacije čitanja ili pisanja!
Razmotrimo primjer. Sada imamo vrlo velike redove. Kako su mogli narasti do te veličine? Iz nekoliko razloga:
- Redovi se ne koriste aktivno
- To su brzi redovi, a trenutno potrošači rade sporo
- To su brzi redovi, došlo je do kvara, a potrošači sustižu
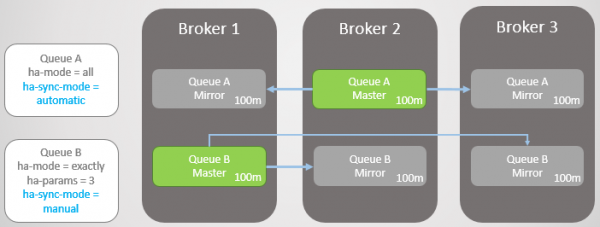
Slika 14. Dva velika reda s različitim načinima sinkronizacije
Sada pada Broker 3.
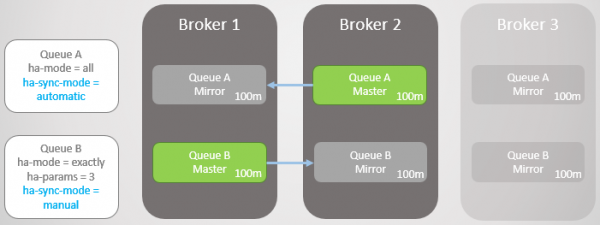
Slika 15. Broker 3 pada, ostavljajući po jedan master i ogledalo u svakom redu
Broker 3 se vraća u pogon i stvaraju se nova ogledala. Glavni Red A počinje replicirati postojeće poruke na novo ogledalo, a za to vrijeme Red nije dostupan. Za replikaciju podataka potrebno je dva sata, što dovodi do dva sata zastoja za ovaj Red!
Međutim, Red B ostaje dostupan tokom celog razdoblja. On je žrtvovao deo redundancije radi dostupnosti.
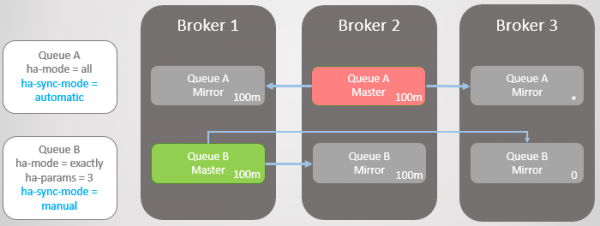
Slika 16. Red ostaje nedostupan tokom sinkronizacije
Nakon dva sata, Red A takođe postaje dostupan i može ponovo početi primati operacije čitanja i pisanja.
Ažuriranja
Ovo blokirajuće ponašanje tokom sinkronizacije otežava ažuriranje klastera sa veoma velikim redovima. U nekom trenutku, čvor s masterom treba ponovo pokrenuti, što znači ili prelazak na ogledalo, ili isključenje reda tokom ažuriranja servera. Ako odaberemo prelazak, izgubićemo poruke, ako ogledala nisu sinkronizovana. Po defaultu, tokom isključivanja brokera, prelazak na nesinkronizovano ogledalo se ne vrši. To znači da, kada se broker vrati, ne gubimo nikakve poruke, jedina šteta su samo zastoji reda. Pravila ponašanja pri isključivanju brokera određena su politikom ha-promote-on-shutdown. Može se postaviti jedna od dve vrednosti:
always= uključena promjena na nesinkronizovane ogledalewhen-synced= prelazak samo na sinkronizovano ogledalo, inače red postaje nedostupan za čitanje i pisanje. Red se vraća u pogon čim se broker vrati
Tako ili onako, sa velikim redovima se mora birati između gubitka podataka i nedostupnosti.
Kada dostupnost povećava sigurnost podataka
Pre nego što donesete odluku, treba uzeti u obzir još jednu komplikaciju. Iako je automatska sinkronizacija bolja za redundanciju, kakav je njen učinak na sigurnost podataka? Naravno, zahvaljujući boljoj redundanciji, RabbitMQ će sa manjom verovatnoćom izgubiti postojeće poruke, ali šta je sa novim porukama od izdavača?
Ovde treba uzeti u obzir sledeće:
- Može li publiser jednostavno vratiti grešku, a viša služba ili korisnik kasnije pokušati ponovo?
- Može li publiser lokalno ili u bazi podataka sačuvati poruku da bi kasnije pokušao ponovo?
Ako publiser može samo odbaciti poruku, tada poboljšanje dostupnosti također povećava sigurnost podataka.
Tako se mora tražiti ravnoteža, a rješenje ovisi o konkretnoj situaciji.
Problemi s ha-promote-on-failure=when-synced
Ideja ha-promote-on-failure= when-synced sastoje se u tome da sprečavamo prebacivanje na nesinkronizirano ogledalo i tako izbjegavamo gubitak podataka. Red čekanja ostaje nedostupan za čitanje ili pisanje. Umjesto toga, pokušavamo ponovno pokrenuti pali broker s netaknutim podacima kako bi nastavio raditi kao glavni bez gubitka podataka.
Ali (i to je velika ali) ako je broker izgubio svoje podatke, tada imamo veliki problem: red čekanja je izgubljen! Svi podaci su nestali! Čak i ako imate ogledala koja većinom sustižu glavni red, ta ogledala također se odbacuju.
Kako bismo ponovo dodali čvor s istim imenom, kažemo klasteru da zaboravi izgubljeni čvor (komandom rabbitmqctl forget_cluster_node) i pokrenemo novi broker s istim imenom hosta. Dok klaster pamti izgubljeni čvor, on pamti stari red čekanja i nesinkronizirana ogledala. Kada se klasteru kaže da zaboravi izgubljeni čvor, taj se red također zaboravlja. Sada ga treba ponovo objaviti. Izgubili smo sve podatke, iako smo imali ogledala s djelomičnim skupom podataka. Bilo bi bolje preći na nesinkronizirano ogledalo!
Stoga je ručna sinkronizacija (i neizvršenje sinkronizacije) zajedno s ha-promote-on-failure=when-synced, po mom mišljenju, prilično rizična. Dokumenti kažu da takva opcija postoji za sigurnost podataka, ali to je dvostruka oštrica.
Ponovno ravnoteženje glavnih čvorova
Kao što je obećano, vraćamo se na problem nagomilavanja svih glavnih čvorova na jednom ili više čvorova. To se može dogoditi čak i kao rezultat „kliznog“ (rolling) ažuriranja klastera. U klasteru s tri čvora svi glavni redovi nagomilat će se na jednom ili dva čvora.
Ponovno ravnoteženje glavnih čvorova može biti problematično iz dva razloga:
- Nema dobrih alata za izvođenje ponovnog ravnoteženja
- Sinkronizacija redova
Za rebalance postoji vanjski , koji nije službeno podržan. O vanjskim pluginima se u uputama RabbitMQ : «Plugin pruža neke dodatne alate za konfiguraciju i izvještavanje, ali nije podržan niti provjeren od strane tima RabbitMQ. Koristite na vlastiti rizik».
Postoji još jedan trik za premještanje glavne queue putem HA politika. U uputama se spominje za to. Funkcioniše na sljedeći način:
- Briše sve zrcale pomoću privremene politike s višim prioritetom od postojeće HA politike.
- Mijenja privremenu HA politiku za korištenje 'nodova' načina s navedenim nodom na koji se treba premjestiti glavna queue.
- Sinhronizira queue radi prisilne migracije.
- Nakon što se migracija završi, briše privremenu politiku. Aktivira se izvorna HA politika i stvara potrebni broj zrcala.
Nedostatak je u tome što ovakav pristup možda neće funkcionirati ako imate velike queue ili stroge zahtjeve za redundancijom.
Sada pogledajmo kako RabbitMQ klasteri funkcionišu s mrežnim razdvajanjem.
Prekid povezanosti
Čvorovi distribuiranog sistema su povezani mrežnim vezama, a mrežne veze mogu i hoće prestati raditi. Učestalost prekida zavisi od lokalne infrastrukture ili pouzdanosti izabranog oblaka. U svakom slučaju, distribuirani sistemi trebaju biti u stanju nositi se s njima. Ponovo imamo izbor između dostupnosti i dosljednosti, i ponovo je dobra vijest da RabbitMQ omogućava obje opcije (samo ne simultano).
S RabbitMQ imamo dvije osnovne opcije:
- Dozvoliti logičko razdvajanje (split-brain). Ovo osigurava dostupnost, ali može izazvati gubitak podataka.
- Zabraniti logičko razdvajanje. Može dovesti do kratkotrajnog gubitka dostupnosti ovisno o načinu povezivanja klijenata s klasterom. Također može dovesti do potpune nedostupnosti u klasteru od dva čvora.
Ali što je logičko razdvajanje? To je kada se klaster dijeli na dva dijela zbog gubitka mrežnih veza. Na svakoj strani, zrcala postaju glavni, tako da na svaku queue ispada više glavnih.
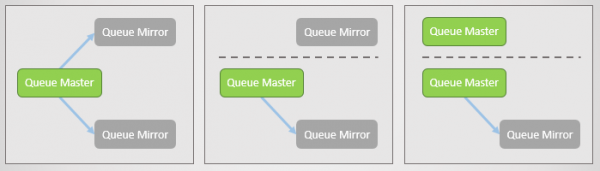
Slika 17. Glavna kola i dva zrcala, svako na zasebnom čvoru. Onda se javlja mrežni kvar, i jedno zrcalo se odvoji. Odvojeni čvor vidi da su se dva druga čvora isključila, i unapređuje svoja zrcala do glavnog. Sada imamo dva glavna reda, a oba dopuštaju pisanje i čitanje.
Ako izdavači šalju podatke u oba glavna, dobit ćemo dvije razdvojene kopije reda.
Različiti režimi RabbitMQ osiguravaju ili dostupnost ili konzistentnost.
Režim Ignoriraj (zadano)
Ovaj režim osigurava dostupnost. Nakon gubitka povezanosti dolazi do logičkog razdvajanja. Nakon ponovnog uspostavljanja povezanosti, administrator mora odlučiti kojoj strani dati prednost. Gubi strana će se ponovo pokrenuti, a svi pohranjeni podaci na toj strani se gube.
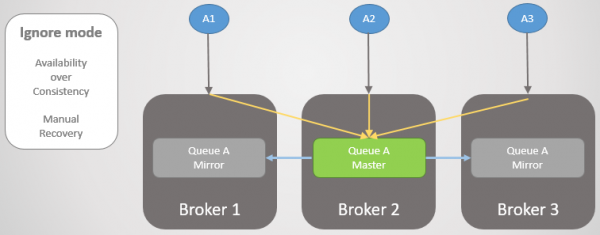
Slika 18. Tri izdavača povezana s tri brokera. Interno, klaster usmjerava sve zahtjeve u glavni red na Brokeru 2.
Sada gubimo Brokera 3. On vidi da su se drugi brokeri isključili, i unapređuje svoje zrcalo do glavnog. Tako dolazi do logičkog razdvajanja.
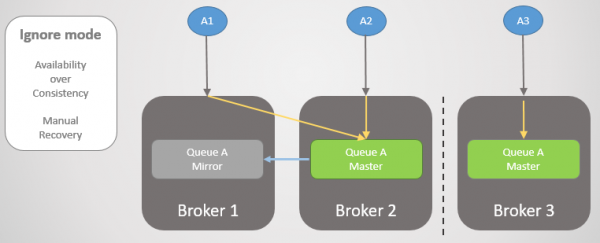
Slika 19. Logičko razdvajanje (split-brain). Zapisi idu u dva glavna reda, i dvije kopije se razdvajaju.
Povezanost se obnavlja, ali logičko razdvajanje ostaje. Administrator mora ručno odabrati gubeću stranu. U prikazanom slučaju administrator restartuje Brokera 3. Gube se sve poruke koje nije успио prenijeti.
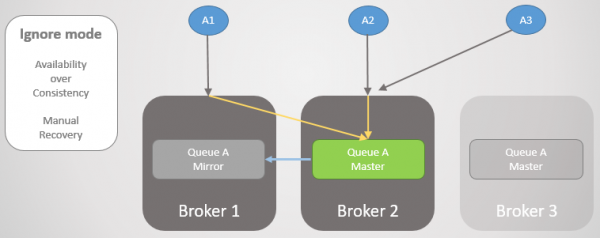
Slika 20. Administrator isključuje Brokera 3.
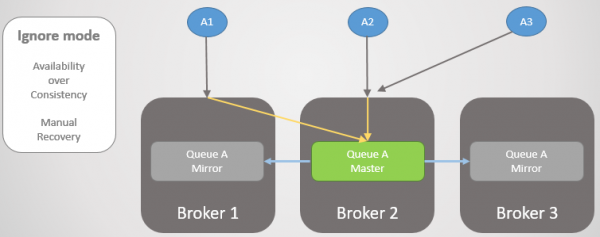
Slika 21. Administrator pokreće Brokera 3, i on se pridružuje klasteru, gubeći sve poruke koje su tu ostale.
Tijekom gubitka povezanosti i nakon njenog obnavljanja, klaster i ovaj red su bili dostupni za čitanje i pisanje.
Režim Autoheal
Radi slično režimu Ignoriraj, osim što sam klaster automatski bira gubeću stranu nakon razdvajanja i obnove povezanosti. Gubi strana se vraća u klaster prazna, a red gubi sve poruke koje su bile poslane samo na tu stranu.
Režim Pauza Manjine
Ako ne želimo dopustiti logičko razdvajanje, onda je naša jedina opcija odbiti čitanje i pisanje na manjoj strani nakon podjela klastera. Kada broker vidi da se nalazi na manjoj strani, on obustavlja rad, zatvara sve postojeće veze i odbija sve nove. Jednom u sekundi provjerava obnovu povezanosti. Čim se povezanost obnovi, on ponovno pokreće rad i pridružuje se klasteru.
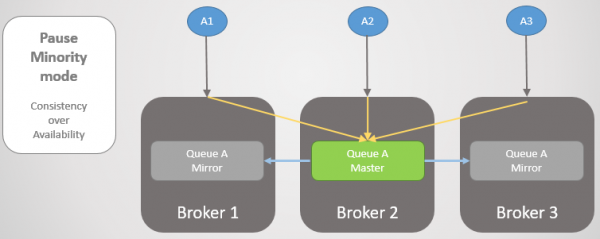
Sl. 22. Tri izdavača povezana su s tri brokera. Interno, klaster prosljeđuje sve zahtjeve u glavnu red na Brokeru 2.
Zatim, Brokera 1 i 2 odvojeni su od Brokera 3. Umjesto da unaprijedi svoje zrcalo u glavnog, Broker 3 obustavlja rad i postaje nedostupan.
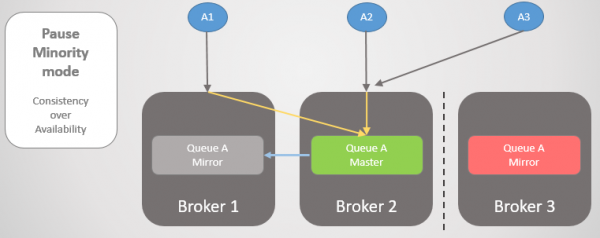
Sl. 23. Broker 3 obustavlja rad, isključuje sve klijente i odbija zahtjeve za povezivanje.
Čim se povezanost obnovi, on se vraća u klaster.
Pogledajmo još jedan primjer, gdje se glavna red nalazi na Brokeru 3.
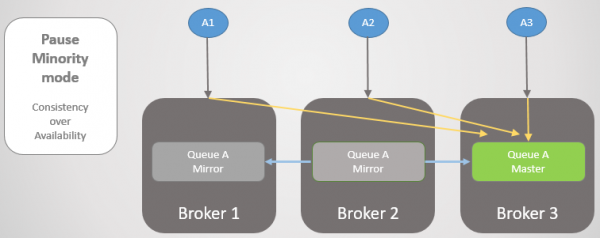
Sl. 24. Glavna red na Brokeru 3.
Tada se događa ista gubitak povezanosti. Broker 3 se stavlja na pauzu, budući da se nalazi na manjoj strani. Na drugoj strani, čvorovi vide da je Broker 3 ispao, tako da starije zrcalo s Brokera 1 i 2 postaje glavni.
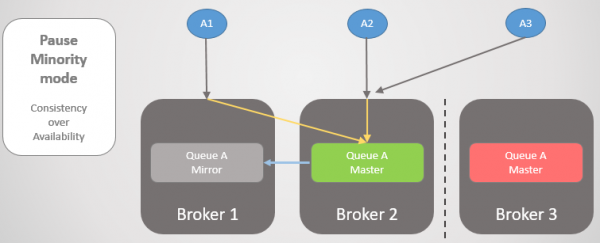
Sl. 25. Prelazak na Brokera 2 kada je Broker 3 nedostupan.
Kada se povezanost obnovi, Broker 3 će se pridružiti klasteru.

Sl. 26. Klaster se vratio u normalan rad.
Ovdje je važno razumjeti da dobivamo dosljednost, ali također možemo dobiti dostupnost, ako uspješno preusmjerimo klijente na veću stranu podjela. Za većinu situacija osobno bih izabrao način Pauza Manjih, ali to zaista ovisi o konkretnoj situaciji.
Za osiguranje dostupnosti važno je osigurati da se klijenti uspješno povezuju s čvorom. Razmotrite naše opcije.
Osiguranje povezanosti klijenata
Imamo nekoliko načina kako nakon gubitka povezanosti usmjeriti klijente na glavnu komponentu klastera ili na aktivne čvoriće (nakon kvara jednog čvora). Prvo, sjetimo se da je određena redoslijed smješten na određenom čvoru, ali usmjeravanje i politike repliciraju se na svim čvorovima. Klijenti se mogu spojiti na bilo koji čvor, a unutarnje usmjeravanje će ih odvesti gdje treba. No, kada je čvor zaustavljen, odbija veze, tako da se klijenti moraju spojiti na drugi čvor. Ako čvor padne, malo toga može učiniti.
Naše opcije:
- Pristup klasteru ostvaruje se preko balansirača opterećenja koji jednostavno ciklički prolazi kroz čvorove, a klijenti ponavljaju pokušaje povezivanja do uspješnog završetka. Ako čvor ne radi ili je zaustavljen, pokušaji povezivanja na taj čvor bit će neuspješni, ali sljedeći pokušaji će ići na druge servere (u cikličkom režimu). Ovo je pogodno za kratkotrajni gubitak povezanosti ili srušeni server koji će brzo biti podignut.
- Pristup klasteru kroz balansirač opterećenja i uklanjanje zaustavljenih/srušenih čvorova iz popisa čim budu otkriveni. Ako to brzo učinimo, i ako su klijenti sposobni na ponovne pokušaje povezivanja, dobit ćemo stalnu dostupnost.
- Dati svakom klijentu popis svih čvorova, a klijent nasumično bira jedan od njih prilikom povezivanja. Ako dobije grešku prilikom pokušaja povezivanja, prelazi na sljedeći čvor na popisu, dok se ne poveže.
- Ukloniti promet s srušenog/zaustavljenog čvora putem DNS-a. Ovo se postiže malim TTL-om.
Zaključci
Klasterizacija RabbitMQ-a ima svoje prednosti i nedostatke. Najozbiljniji nedostaci su:
- prilikom pridruživanja klasteru, čvorovi odbacuju svoje podatke;
- blokirajuća sinkronizacija dovodi do nedostupnosti reda.
Sve teške odluke proizlaze iz ove dvije karakteristike arhitekture. Da RabbitMQ može pohraniti podatke prilikom ponovnog povezivanja klastera, tada bi sinhronizacija bila brža. Kada bi bio sposoban za neblokirajuću sinhronizaciju, bolje bi podržao velike redove. Rješavanje ova dva problema ozbiljno bi poboljšalo performanse RabbitMQ kao tehnologije razmjene poruka otporne na greške i visoke dostupnosti. Ne bih preporučio RabbitMQ s klasterizacijom u sljedećim situacijama:
- Nepouzdana mreža.
- Nepouzdano skladištenje.
- Veći redovi.
Što se tiče postavki za visoku dostupnost, razmotrite sljedeće:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(iliautoheal)- postojane poruke
- osigurajte da se klijenti povezuju na aktivni čvor kada neki čvor ne uspije
Za dosljednost (sigurnost podataka) razmotrite sljedeće postavke:
- Publisher Confirms i Manual Acknowledgements na strani potrošača
ha-promote-on-failure=when-synced, ako izdavači mogu ponoviti pokušaj kasnije i ako imate vrlo pouzdano skladište! Inače, stavite=always.ha-sync-mode=automatic(ali za velike neaktivne redove možda će biti potreban ručni način; osim toga, razmislite hoće li nedostupnost dovesti do gubitka poruka)- mode Pause Minority
- postojane poruke
Nismo razmotrili sve aspekte otpornosti na greške i visoke dostupnosti; na primjer, kako sigurno izvršiti administrativne procedure (kao što su postupna ažuriranja). Takođe, treba razgovarati o federaciji i pluginu Shovel.
Ako sam nešto propustio, molim javite mi.
Pogledajte i moj , gdje sprovodim eksperiment s RabbitMQ klasterom putem Dockera i Blockade, kako bih testirao neke scenarije gubitka poruka opisane u ovom članku.
Prethodni članci serije:
Br. 1 —
Br. 2 —
Br. 3 —
Izvor: habr.com
