

Napomena za prijevod.: Autorica ovog materijala je Cindy Sridharan, inženjerka iz kompanije imgix, koja se bavi razvojem API-a, a posebno testiranjem mikroservisa. U ovom materijalu dijeli svoje sveobuhvatno viđenje aktualnih problema u području distribuiranog praćenja, gdje, prema njenom mišljenju, postoji nedostatak zaista učinkovitih alata za rješavanje hitnih zadataka.
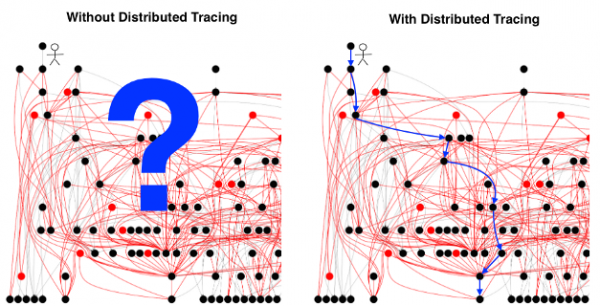
[Ilustracija preuzeta iz o distribuiranom praćenju.]
Smatra se da je teško implementirati, a njegovi rezultati . «Problematičnost» praćenja objašnjava se brojnim razlozima, pri čemu se često poziva na složenost konfiguracije svake komponente sustava za prijenos odgovarajućih zaglavlja s svaki zahtjev. Iako taj problem zaista postoji, ne može se smatrati nepremostivim. Usput, ne objašnjava zašto programeri ne vole praćenje (čak ni već funkcionalno).
Glavna poteškoća kod distribuiranog praćenja nije prikupljanje podataka, ni standardizacija formata distribucije i predstavljanja rezultata niti određivanje kada, gdje i kako vršiti uzorkovanje. Nimalo ne pokušavam predstaviti banalnim te «probleme s usvajanjem» — zapravo postoje prilično značajni tehnički i (ako razmatramo zaista Open Source ) politički izazovi koje treba prevladati da bi se ti problemi mogli smatrati rješenima.
Međutim, ako pretpostavimo da su svi ti problemi riješeni, velika je vjerojatnost da se ništa bitno neće promijeniti u pogledu iskustva krajnjeg korisnika. Praćenje će i dalje možda ne donijeti praktičnu korist u najčešćim scenarijima otklanjanja grešaka — čak i nakon što je implementirano.
Takvo neusklađeno praćenje
Distribuirano praćenje uključuje nekoliko razdvojenih komponenti:
- opremanje aplikacija i middleware-a sredstvima za kontrolu;
- prijenos distribuiranog konteksta;
- prikupljanje praćenja;
- pohrana praćenja;
- njihovo vađenje i vizualizacija.
Mnoge rasprave o distribuiranom praćenju svode se na to da ga se promatra kao neku unarnu operaciju čija je jedina svrha pomoći u potpunoj dijagnostici sustava. U velikoj mjeri to je povezano s načinom na koji su se povijesno oblikovale predstave o distribuiranom praćenju. U , spomenutoj kada su otvoreni izvori Zipkina, naglašeno je da on [Zipkin] čini Twitter bržim.Prve komercijalne ponude za praćenje također su se promovirale kao .
Napomena za prijevod.: Kako bi se daljnji tekst bolje shvatio, definirajmo dva osnovna pojma prema :
- Span — osnovni element distribuiranog praćenja. Predstavlja opis nekog radnog procesa (primjerice, upita u bazu podataka) s imenom, vremenom početka i završetka, oznakama, logovima i kontekstom.
- Spanovi obično sadrže reference na druge spanove, što omogućava povezivanje više spanova u Trace — vizualizaciju života upita dok se kreće kroz distribuirani sustav.
Traceovi sadrže nevjerojatno vrijedne podatke koji mogu pomoći u zadatcima kao što su: testiranje u produkciji, provođenje testova oporavka od kvarova, testiranje s implementacijom grešaka itd. U stvarnosti, neke tvrtke već koriste praćenje za slične svrhe. Počnimo s time da ima i druge primjene osim jednostavnog premještanja spanova u sustav pohrane:
- Na primjer, Uber rezultati praćenja za razdvajanje testnog prometa i produkcijskog prometa.
- Facebook podaci traceova za analizu kritičnog puta i za prebacivanje prometa tijekom redovitih testova oporavka od kvarova.
- Također, društvena mreža Jupyter bilježnice koje omogućuju programerima izvršavanje proizvoljnih upita na rezultatima praćenja.
- Pristalice (Umetanje grešaka vođeno linijom) distribuirani traceovi za testiranje s umetnutim greškama.
Nijedna od spomenutih opcija u potpunosti ne pripada scenariju debugginga, tijekom kojeg inženjer pokušava riješiti problem gledajući trace.
Kada se konačno dođe do scenarija debugiranja, primarno sučelje ostaje dijagram traceview iako ga neki nazivaju «Ganttov dijagram» ili «kaskadnim dijagramom»). Pod traceview ja svi spanovi i prateći metapodaci koji zajedno čine trag. Svaki sustav za praćenje otvorenog koda, kao i svako komercijalno rješenje za praćenje nudi temeljen na traceview korisničko sučelje za vizualizaciju, detaljizaciju i filtraciju tragova.
Problem sa svim sustavima praćenja s kojima sam se do sada susreo je taj što konačna vizualizacija (traceview) praktički potpuno odražava karakteristike procesa generiranja traga. Čak i kada se nude alternativne vizualizacije: karte intenziteta (heatmap), topologije usluga, histogrami kašnjenja (latency), - na kraju se sve svodi na traceview.
U prošlosti sam primijetila da se većina "inovacija" u području praćenja u vezi s UI/UX, čini se, ograničava na dodatnih metapodataka u trag, uključivanje informacija s visokom kardinalnošću (high-cardinality) ili pružanje mogućnosti detaljizacije određenih spanova ili izvođenja upita između i unutar traga. U tom slučaju traceview ostaje glavno sredstvo vizualizacije. Dokle god će ovakva situacija trajati, distribuirano praćenje zauzet će (u najboljem slučaju) 4. mjesto kao alat za debuggiranje, iza metrika, logova i stack traceova, a u najgorem slučaju postat će prazno rasipanje novca i vremena.
Problem s traceview-om
Svrha traceview je pružiti potpunu sliku kretanja pojedinog zahtjeva kroz sve komponente distribuiranog sustava s kojima je povezan. Neki napredniji sustavi praćenja omogućuju detaljizaciju pojedinih spanova i pregled vremenske podjele unutar jednog procesa (kada spanovi imaju funkcionalne granice).
Osnovna pretpostavka arhitekture mikroslužbi leži u ideji da se organizacijska struktura razvija zajedno s potrebama tvrtke. Pristalice mikroslužbi tvrde da raspodjela različitih poslovnih zadataka u zasebne servise omogućava malim, autonomnim timovima programera da kontroliraju cijeli životni ciklus tih servisa, dajući im mogućnost da neovisno kreiraju, testiraju i implementiraju te servise. Međutim, nedostatak takve raspodjele je gubitak informacija o tome kako svaki servis komunicira s drugima. U takvim uvjetima distribuirano praćenje pretendira na ulogu neprocjenjivog alata za debugginga složene interakcije između servisa.
Ako imate stvarno , tada nijedna osoba ne može zadržati u glavi njegovu potpunu sliku. Zapravo, razvoj alata koji polazi od pretpostavke da je to moguće, predstavlja neku vrstu antipatterna (neefikasnog i neproduktivnog pristupa). U idealnom slučaju, za otklanjanje grešaka potreban je alat koji pomaže sužavanju područja pretrage, kako bi inženjeri mogli usmjeriti pozornost na podskup mjerenja (servisa/korisnika/hostova itd.) relevantnih za razmatranu situaciju problema. Tijekom utvrđivanja uzroka neuspjeha, inženjeri ne bi trebali biti obavezni analizirati što se događalo u svim servisima odjednom, jer bi takav zahtjev bio u suprotnosti s samu idejom arhitekture mikroslužbi.
Međutim, traceview predstavlja upravo to. Da, neki sustavi praćenja nude sažeto traceview kada je broj spanova u traceu toliko velik da ih nije moguće prikazati u jednoj vizualizaciji. Ipak, zbog velike količine informacija, čak i u takvoj skraćenoj vizualizaciji, inženjeri i dalje moraju ‘proći’ kroz nju, ručno sužavajući uzorak na skup servisa-izvora problema. Nažalost, na ovom području strojevi su značajno brži od ljudi, manje skloni greškama, a njihovi rezultati su ponovljivi.
Još jedan razlog zbog kojeg smatram da je metoda traceview pogrešna leži u tome što nije pogodna za hipotezno temeljen otklanjanje grešaka. U svojoj suštini, otklanjanje grešaka je iterativno proces koji započinje hipotezom, nakon koje slijedi provjera različitih opažanja i činjenica dobivenih iz sustava po različitim smjerovima, zaključci/sumarizacije i daljnja procjena istinitosti hipoteze.
Mogućnost brzo i jeftino testiranje hipoteza i odgovarajuće poboljšanje mentalnog modela je temeljni kamen debugginga. Svaki alat za ispravljanje grešaka mora biti interaktivan i sužavati prostor pretraživanja ili, u slučaju lažne tragove, omogućiti korisniku da se vrati i usredotoči na drugo područje sustava. Idealni alat će to raditi proaktivno, odmah privlačeći pažnju korisnika na potencijalno problematična područja.
Nažalost, traceview ne može se nazvati alatom s interaktivnim sučeljem. Najbolje što se može nadati pri korištenju istog je otkriti određeni izvor povećanih kašnjenja i pregledati razne oznake i zapise povezane s njim. To ne pomaže inženjeru da otkrije uzorke u prometu, kao što su specifičnosti raspodjele kašnjenja, ili da otkrije korelacije između različitih mjerenja. može pomoći zaobići neke od ovih problema. Doista, uspješnog analize koristeći strojno učenje za otkrivanje anomalnih spanova i identifikaciju podskupa oznaka koje mogu biti povezane s anomalnim ponašanjem. Ipak, još uvijek nisam naišao na uvjerljive vizualizacije otkrića napravljenih uz pomoć strojnog učenja ili analiza podataka primijenjenih na spanove, koje bi se značajno razlikovale od traceview-a ili DAG-a (usmjerenog acikličkog grafa).
Spanova su previše niskorazredni
Temeljni problem s traceviewom je spanovi su previše niskorazredni primitivi za analizu kašnjenja i analizu osnovnih uzroka. To je kao pokušavati analizirati pojedinačne instrukcije procesora u nastojanju da se otkloni iznimka, znajući da postoje mnogo više razine alati poput backtrace-a, s kojima je daleko lakše raditi.
Štoviše, usuđujem se tvrditi sljedeće: u idealnom slučaju, uopće nam nije potrebna cjelovita slika doživljenog tijekom životnog ciklusa zahtjeva, koji predstavljaju suvremeni alati za praćenje. Umjesto toga, potrebna je neka forma apstrakcije višeg nivoa koja sadrži informacije o tome što nije u redu u analogiji s backtraceom, zajedno s nekim kontekstom. Umjesto da promatram cijeli trag, preferiram vidjeti njegov dio, gdje se događa nešto zanimljivo ili neobično. Trenutno se pretraga vrši ručno: inženjer dobije trag i samostalno analizira spanove u potrazi za nečim zanimljivim. Pristup u kojem ljudi upiru pogled u spanove unutar pojedinačnih tragova u nadi da će otkriti sumnjivu aktivnost, potpuno je neodrživ (osobito kada moraju obraditi sve metapodatke kodirane u raznim spanovima, poput ID spanova, imena RPC metode, trajanja spana, logova, oznaka itd.)
Alternativa traceviewu
Rezultati praćenja najkorisniji su kada se mogu vizualizirati na način koji pruža netrivijalnu sliku o tome što se događa u međusobno povezanih dijelovima sustava. Dok to ne bude postignuto, proces ispravljanja grešaka velikim djelom ostaje inertan i ovisi o sposobnosti korisnika da primjećuje ispravne korelacije, provjerava ispravne dijelove sustava ili sastavlja dijelove mozaika zajedno - za razliku od alat, što pomaže korisniku da formuliše te hipoteze.
Nisam vizualni dizajner niti stručnjak za UX, no u sljedećem odjeljku želim podijeliti nekoliko ideja o tome kako takve vizualizacije mogu izgledati.
Fokus na specifične usluge
U uvjetima kada se industrija konsolidira oko ideja , čini se razumnim da pojedini timovi prvenstveno prate usklađenost svojih usluga s ovim ciljevima. Iz toga slijedi da vizualizacija orijentirana na uslugu najbolje odgovara takvim timovima.
Tragovi, osobito bez uzorka, predstavljaju blago informacija o svakom komponentu distribuiranog sustava. Ove informacije mogu se prenijeti pametnom procesoru koji će korisnicima isporučivati nalaze orijentirane na uslugu. Oni se mogu otkriti unaprijed - čak i prije nego što korisnik pogleda tragove:
- Grafikon raspodjele kašnjenja samo za iznimne zahtjeve (iznimni zahtjevi);
- Grafikon raspodjele kašnjenja za slučajeve kada se ne postižu SLO ciljevi usluge;
- Najčešće "obične", "zanimljive" i "čudne" oznake u zahtjevima koje se najčešće ponavljaju;
- Raspodjela kašnjenja za slučajeve kada ovisnosti usluga ne dosežu postavljene SLO ciljeve;
- Raspodjela kašnjenja po raznim downstream uslugama.
Na neka od ovih pitanja ugrađene metrike jednostavno ne mogu odgovoriti, prisiljavajući korisnike da temeljito prouče span-ove. Na kraju imamo izuzetno neprijateljski mehanizam prema korisnicima.
U vezi s tim postavlja se pitanje: što je s kompleksnim interakcijama između raznih usluga koje kontroliraju različiti timovi? Zar to traceview nije najprikladniji alat za osvjetljavanje takve situacije?
Mobilni programeri, vlasnici stateless usluga, vlasnici upravljanih stateful usluga (kao što su baze podataka) i vlasnici platformi mogli bi biti zainteresirani za drugo prikazivanje distribuiranog sustava; traceview — to je previše univerzalno rješenje za ove u osnovi različite potrebe. Čak i u vrlo složenoj mikroservisnoj arhitekturi vlasnicima usluga nisu potrebna duboka znanja o više od dva do tri upstream i downstream servisa. U suštini, u većini scenarija korisnicima je dovoljno odgovarati na pitanja koja se odnose na ograničen skup usluga.
To nalikuje promatranju malog podskupa usluga kroz povećalo radi pomnog proučavanja. To će korisniku omogućiti postavljanje važnijih pitanja koja se odnose na složenu interakciju između tih usluga i njihovih neposrednih ovisnosti. To je slično backtrace-u u svijetu usluga, gdje inženjer zna, šta ne samo to, već i ima određenu predstavu o onome što se događa u okolnim uslugama kako bi razumio, zašto.
Moj pristup je potpuna suprotnost pristupu „odozgo prema dolje“, koji se temelji na traceview, gdje analiza započinje sa cijelim trace-om i postupno se spušta do pojedinačnih span-ova. Nasuprot tome, pristup „odozdo prema gore“ započinje analizom malog segmenta koji je blizu potencijalnog razloga incidenta, a zatim se prostor pretraživanja širi prema potrebi (uz eventualno uključivanje drugih timova za analizu šireg spektra usluga). Drugi pristup je bolje prilagođen za brzo provjeru početnih hipoteza. Nakon dobivanja konkretnog rezultata, može se prijeći na ciljaniju i detaljniju analizu.
Izgradnja topologije
Povezani prikazi specifični za uslugu mogu biti nevjerojatno korisni ako korisnik zna koji usluga ili skupina usluga uzrokuje povećanje latencije ili je izvor grešaka. Međutim, u složenom sustavu, identifikacija usluge koja uzrokuje problem može biti složen zadatak tijekom kvara, osobito ako poruke o grešci od usluga nisu dostupne.
Izgradnja topologije usluga može znatno pomoći pri utvrđivanju koja usluga pokazuje porast učestalosti grešaka ili povećanje latencije, što dovodi do vidnog pogoršanja rada usluge. Kada govorim o izgradnji topologije, mislim ne na kartu usluga, koja prikazuje svaku uslugu u sustavu i poznata je po svojim . Takvo predstavljanje nije bolje od traceview-a koji se temelji na usmjerenom acikličnom grafu. Umjesto toga, volio bih vidjeti dinamički generiranu topologiju usluga, koja se temelji na određenim atributima, poput učestalosti grešaka, vremena odgovora ili bilo kojem parametru koji odredi korisnik, a koji pomaže pojasniti situaciju s određenim sumnjivim uslugama.
Pogledajmo primjer. Zamislimo neki hipotetski informativni web site. Usluga glavne stranice (front page) razmjenjuje podatke s Redisom, uslugom preporuka, marketinškom uslugom i video uslugom. Video usluga uzima videozapise s S3, a metapodatke iz DynamoDB. Usluga preporuka dobiva metapodatke iz DynamoDB, učitava podatke iz Redis i MySQL, te šalje poruke u Kafka. Marketinška usluga dobiva podatke iz MySQL i šalje poruke u Kafka.
Ispod je shematski prikaz ove topologije (topologiju izrađuju mnogi komercijalni programi za praćenje). Može biti koristan ako trebate razumjeti ovisnosti usluga. Međutim, tijekom debugginga, kada neka usluga (recimo, video usluga) pokazuje povećano vrijeme odaziva, takva topologija nije previše korisna.
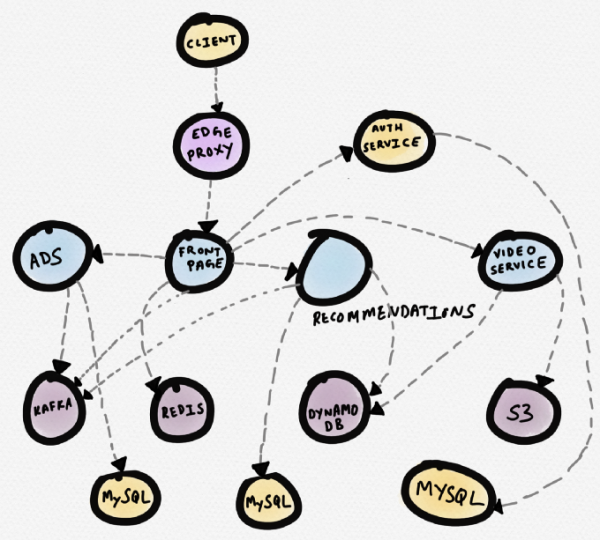
Shema usluga hipotetskog novinskog portala
Bolje bi odgovarala dijagramu prikazanom ispod. Na njemu je problematična usluga (video) prikazana točno u središtu. Korisnik je odmah primijeti. Iz ovog prikaza postaje jasno da video usluga radi anomalno zbog povećanja vremena odaziva S3, što utječe na brzinu učitavanja dijela glavne stranice.
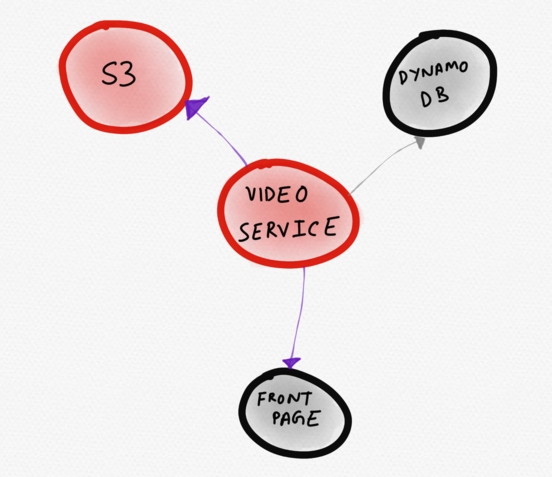
Dinamička topologija koja prikazuje samo "interesantne" usluge
Dinamički generirane topološke sheme mogu biti učinkovitije od statičkih mapa usluga, posebno u fleksibilnim, automatski skalabilnim infrastrukturnim okruženjima. Mogućnost usporedbe i preklapanja topologija usluga omogućuje korisnicima postavljanje relevantnijih pitanja. Preciznija pitanja o sustavu vjerojatno vode do boljeg razumijevanja načina na koji sustav funkcionira.
Usporedni prikaz
Još jedan koristan vizualni prikaz bio bi usporedni prikaz. Trenutno, trace-ovi nisu baš prikladni za usporedbe jedan na jedan, pa se obično uspoređuju spanovi. A osnovna ideja ovog članka je upravo u tome što su span-ovi suviše niskog nivoa da bi se izvukle najvrednije informacije iz rezultata praćenja.
Usporedba dvaju trace-ova ne zahtijeva bitno nove vizualizacije. U stvari, dovoljna je nešto poput histogramskog prikaza koji predstavlja iste informacije kao traceview. Čudno, ali čak i ova jednostavna metoda može donijeti mnogo više koristi nego jednostavno proučavanje dvaju trace-ova odvojeno. Još moćnija bi bila mogućnost vizualizirati usporedba tragova u kombinaciji. Bilo bi iznimno korisno vidjeti kako nedavno implementirana promjena konfiguracije baze podataka s uključenim GC (sakupljanje smeća) utječe na vrijeme odgovora downstream servisa tijekom nekoliko sati. Ako se ono što ovdje opisujem čini sličnim A/B analizi utjecaja infrastrukturnih promjena u mnogim servisima koristeći rezultate praćenja, niste daleko od istine.
Zaključak
Ne dovodim u pitanje korisnost samog praćenja. Iskreno vjerujem da ne postoji drugi način za prikupljanje tako bogatih, slučajnih i kontekstualnih podataka kao što su oni sadržani u tragu. Međutim, također vjerujem da svi alati za praćenje koriste ove podatke izuzetno neučinkovito. Dokle god alati za praćenje budu usredotočeni na prikaz tragova, bit će ograničeni u mogućnosti maksimalno iskoristiti dragocjene informacije koje se mogu izvući iz podataka sadržanih u tragovima. Osim toga, postoji rizik daljnjeg razvoja potpuno neprijateljskog i neintuitivnog vizualnog sučelja koje će značajno ograničiti sposobnost korisnika da otkloni greške u aplikaciji.
Otklanjanje grešaka u složenim sustavima, čak i uz korištenje najnovijih alata, nevjerojatno je složeno. Alati trebaju pomoći programeru da formulira i testira hipoteze, aktivno pružajući relevantne informacije, otkrivajući iznimke i primjećujući značajke u distribuciji kašnjenja. Da bi praćenje postalo alat po izboru programera za otklanjanje problema u produkciji ili rješavanje problema koji obuhvaćaju različite servise, potrebna su originalna korisnička sučelja i vizualizacije, koje u većoj mjeri odgovaraju mentalnom modelu programera koji kreiraju i rade ove servise.
Bit će potrebna značajna mentalna napora za dizajniranje sustava koji će predstavljati različite signale dostupne u rezultatima praćenja na način optimiziran za olakšavanje analize i zaključivanja. Treba razmisliti o tome kako apstrahirati topologiju sustava tijekom otklanjanja grešaka na način koji će pomoći korisniku da prevlada slijepe točke, ne zavirujući u pojedinačne tragove ili rasprostranjenja.
Treba nam dobre mogućnosti abstrahiranja i višerazinskog razdvajanja (posebice u UI). One koje se dobro uklapaju u proces hipoteznoj debagiranja, gdje se mogu iterativno postavljati pitanja i provjeravati hipoteze. Neće automatski riješiti sve probleme s promatračem, ali će pomoći korisnicima da izoštre intuiciju i formuliraju promišljenija pitanja. Pozivam na pažljiviji i inovativniji pristup vizualizaciji. Ovdje postoji stvarna perspektiva za proširenje horizonta.
P.S. od prevodioca
Pročitajte i na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
