

CAP-teorema je kamen temeljac teorije distribuiranih sustava. Naravno, rasprave oko nje ne prestaju: definicije nisu kanonske, a strogo dokazivanje ne postoji... Ipak, čvrsto držeći se zdravog razuma™, intuitivno razumijemo da je teorema točna.
Jedina stvar koja nije očita je značenje slova "P". Kada se klaster podijeli, odlučuje – hoće li ne odgovarati dok se ne postigne kvorum ili će dati podatke koji su dostupni. Ovisno o rezultatima ovog izbora, sustav se klasificira ili kao CP ili kao AP. Cassandra, na primjer, može se ponašati na oba načina, ovisno ne samo o postavkama klastera, već i o parametrima svake pojedine molbe. No, ako sustav nije "P", a podijeljen je, što tada?
Odgovor na ovo pitanje je pomalo iznenađujući: CA-klaster ne može se podijeliti.
Kakav je to klaster koji se ne može podijeliti?
Neizostavan atribut takvog klastera je zajednički sustav pohrane podataka. U velikoj većini slučajeva to znači povezivanje putem SAN-a, što ograničava primjenu CA-rješenja samo na velike kompanije koje mogu održavati SAN infrastrukturu. Da bi nekoliko poslužitelja moglo raditi s istim podacima, potrebna je klasterska datotečna sustava. Takve datotečne sustave imaju u portfeljima HPE (CFS), Veritas (VxCFS) i IBM (GPFS).
Oracle RAC
Opcija Real Application Cluster prvi put se pojavila 2001. godine u izdanju Oracle 9i. U takvom klasteru nekoliko instanci poslužitelja radi s istom bazom podataka.
Oracle može raditi i s klasterskom datotečnom sustavom, kao i s vlastitim rješenjem – ASM, Automatic Storage Management.
Svaka instanca vodi svoj dnevnik. Transakcija se izvršava i bilježi od jedne instance. U slučaju kvara instance, jedan od preživjelih čvorova klastera (instanci) čita njen dnevnik i obnavlja izgubljene podatke – time se osigurava dostupnost.
Sve instance podržavaju vlastiti kaš, a iste stranice (blokovi) mogu se istovremeno nalaziti u kašama više instanci. Štoviše, ako neka stranica treba jednoj instanci, a nalazi se u kašu druge instance, može je dobiti od "susjeda" putem mehanizma cache fusion umjesto da je čita s diska.
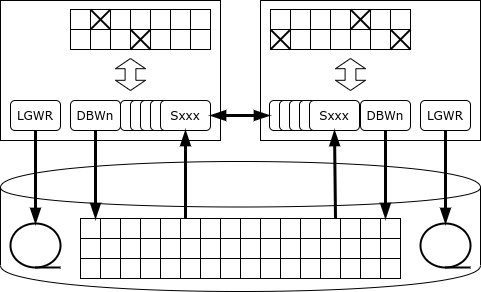
No što će se dogoditi ako jednom od instanci zatreba da promijeni podatke?
Osobitost Oracle-a je u tome što nema posebnu uslugu za zaključavanje: kada poslužitelj želi zaključati redak, zapis o zaključavanju se stavlja izravno na onoj stranici memorije gdje se nalazi zaključani redak. Zbog ovog pristupa, Oracle je prvak u performansama među monolitnim bazama podataka: usluga zaključavanja nikada ne postaje usko grlo. Međutim, u klasterskoj konfiguraciji, ova arhitektura može uzrokovati intenzivnu mrežnu razmjenu i međusobna zaključavanja.
Čim se zapis zaključava, instanca obavještava sve ostale instance da je stranica na kojoj se nalazi taj zapis zauzeta u monopolnom režimu. Ako drugoj instanci zatreba da promijeni zapis na istoj stranici, mora čekati dok se promjene na stranici ne zabilježe, tj. dok se informacija o promjeni ne zapiše u dnevnik na disku (za to vrijeme transakcija može trajati). Također se može dogoditi da se stranica mijenja uzastopno od strane nekoliko instanci, a tada prilikom zapisivanja stranice na disk treba utvrditi kod koga se nalazi aktualna verzija te stranice.
Nasumice ažuriranje istih stranica preko različitih čvorova RAC dovodi do dramatičnog smanjenja performansi baze podataka – do te mjere da performanse klastera mogu biti niže od performansi pojedinačne instance.
Ispravno korištenje Oracle RAC-a uključuje fizičko razdvajanje podataka (na primjer, pomoću mehanizma tablica s particijama) i pristup svakom skupu particija preko dodijeljenog čvora. Glavna svrha RAC-a nije bila horizontalno skaliranje, već osiguranje otpornosti na greške.
Ako čvor prestane odgovarati na heartbeat, tada čvor koji to prvi otkrije pokreće postupak glasovanja na disku. Ako ni ovdje izgubljeni čvor ne potvrdi svoju prisutnost, jedan od čvorova preuzima odgovornosti za oporavak podataka:
- «zamrzava» sve stranice koje su bile u kešu izgubljenog čvora;
- čitajući dnevnike (redo) izgubljenog čvora i ponovo primjenjujući promjene zapisane u tim dnevnicima, pritom provjeravajući imaju li drugi čvorovi novije verzije mijenjanih stranica;
- vraća nezavršene transakcije.
Da bi se olakšalo prebacivanje između čvorova, Oracle koristi pojam servisa – virtualni primjerak. Primjerak može podržavati više servisa, a servis može preći između čvorova. Primjerak aplikacije, koji podržava određeni dio baze (na primjer, grupu klijenata), radi s jednim servisom, a servis odgovoran za taj dio baze premješta se na drugi čvor u slučaju kvara čvora.
IBM Pure Data Systems for Transactions
Klustersko rješenje za DBMS pojavilo se u portfelju Plavog Giganta 2009. godine. Ideološki je nasljednik klastera Parallel Sysplex, izgrađenog na "običnoj" opremi. Godine 2009. lansiran je proizvod DB2 pureScale, koji predstavlja paket softverskih rješenja, a 2012. IBM nudi softversko-hardware rješenje pod nazivom Pure Data Systems for Transactions. Ne treba ga miješati s Pure Data Systems for Analytics, koja je samo preimenovani Netezza.
Arhitektura pureScale na prvi pogled nalikuje Oracle RAC-u: na sličan način više čvorova povezano je s zajedničkim sistemom pohrane podataka, a na svakom čvoru radi svoj primjerak DBMS-a sa svojim memorijskim prostorima i dnevnicima transakcija. Međutim, za razliku od Oracle-a, DB2 ima poseban servis za zaključavanje, predstavljen skupom procesa db2LLM*. U klasterskoj konfiguraciji ovaj servis se premješta na poseban čvor, koji se u Parallel Sysplex-u naziva coupling facility (CF), a u Pure Data – PowerHA.
PowerHA pruža sljedeće usluge:
- menadžer zaključavanja;
- globalni bafer cache;
- područje međuprocesne komunikacije.
Za prijenos podataka od PowerHA do čvorova DB i obrnuto koristi se daljinski pristup memoriji, stoga klasterska međuspojnica mora podržavati RDMA protokol. PureScale može koristiti i Infiniband i RDMA preko Ethernet-a.
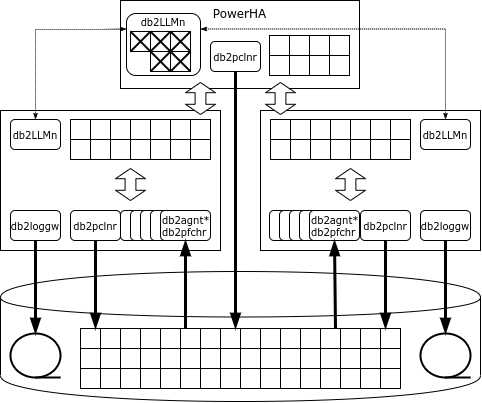
Ako čvor treba stranicu, a te stranice nema u cache-u, čvor traži stranicu u globalnom cache-u, i samo ako je ni tamo nema, čita je s diska. Za razliku od Oracle-a, zahtjev ide samo u PowerHA, a ne u susjedne čvorove.
Ako instanca planira promijeniti red, ona ga blokira u ekskluzivnom režimu, a stranicu na kojoj se red nalazi - u dijeljenom režimu. Sve blokade se registriraju u globalnom upravitelju blokada. Kada transakcija završi, čvor šalje poruku upravitelju blokada, koji kopira promijenjenu stranicu u globalnu predmemoriju, uklanja blokade i invalidira promijenjenu stranicu u predmemorijama drugih čvorova.
Ako je stranica na kojoj se nalazi promijenjeni red već blokirana, upravitelj blokada će pročitati promijenjenu stranicu iz memorije čvora koji je napravio promjene, uklonit će blokadu, invalidirati promijenjenu stranicu u predmemorijama drugih čvorova i vratiti blokadu stranice čvoru koji ju je zatražio.
»Prljave«, odnosno promijenjene, stranice mogu se zapisivati na disk kako s običnog čvora, tako i s PowerHA (castout).
U slučaju kvara jednog od čvorova pureScale, oporavak je ograničen samo na one transakcije koje u trenutku kvara još nisu bile završene: stranice koje je taj čvor promijenio u završnim transakcijama su u globalnoj predmemoriji na PowerHA. Čvor se ponovno pokreće u ograničenoj konfiguraciji na jednom od poslužitelja klastera, poništava nezavršene transakcije i oslobađa blokade.
PowerHA radi na dva poslužitelja, a glavni čvor sinkronizirano replicira svoje stanje. U slučaju kvara glavnog čvora, PowerHA klaster nastavlja rad s rezervnim čvorom.
Naravno, ako se pristupa skupu podataka putem jednog čvora, ukupna performansa klastera će biti viša. PureScale čak može primijetiti da određeno područje podataka obrađuje jedan čvor, a tada će se sve blokade vezane uz to područje obrađivati lokalno, bez komunikacije s PowerHA. No, čim aplikacija pokuša pristupiti tim podacima putem drugog čvora, centralizirana obrada blokada će se nastaviti.
Interni testovi IBM-a pod opterećenjem koje se sastoji od 90% čitanja i 10% pisanja, što vrlo sliči stvarnom industrijskom opterećenju, pokazuju gotovo linearno skaliranje do 128 čvorova. Nažalost, uvjeti testiranja se ne otkrivaju.
HPE NonStop SQL
Vlastita visoko dostupna platforma dostupna je i u portfelju tvrtke Hewlett-Packard Enterprise. To je NonStop platforma koja je na tržište puštena 1976. godine od strane tvrtke Tandem Computers. Godine 1997. tvrtku je preuzela tvrtka Compaq, koja se 2002. godine spojila s Hewlett-Packard.
NonStop se koristi za izgradnju kritičnih aplikacija – poput HLR-a ili procesiranja bankovnih kartica. Platforma dolazi u obliku softversko-hardverskog kompleta (appliance), koji uključuje računalne čvorove, sustav za pohranu podataka i komunikacijsku opremu. Mreža ServerNet (u modernim sustavima – Infiniband) služi kako za razmjenu između čvorova, tako i za pristup sustavu za pohranu podataka.
U ranim verzijama sustava korišteni su proprietarni procesori koji su bili međusobno sinkronizirani: sve operacije izvršavane su sinkrono od strane više procesora, a kada je jedan od procesora imao pogrešku, on se isključivao dok je drugi nastavljao rad. Kasnije je sustav prešao na standardne procesore (prvo MIPS, zatim Itanium, i naposljetku x86), a za sinkronizaciju su korišteni drugi mehanizmi:
- poruke: svaki sustavni proces ima svoj dvostruki „sjena“, kojem aktivni proces povremeno šalje poruke o svom stanju; u slučaju kvara glavnog procesa, sjeni proces započinje rad od trenutka koji je odredila posljednja poruka;
- glasanje: sustav za pohranu podataka ima poseban hardverski komponent koji prima nekoliko istih zahtjeva i izvršava ih samo ako se zahtjevi podudaraju; umjesto fizičke sinkronizacije, procesori rade asinkrono, a rezultati njihova rada uspoređuju se samo u trenucima ulaza/izlaza.
Od 1987. godine na platformi NonStop radi relacijska SUSTAV RAZVOJA BAZA PODATAKA – prvo SQL/MP, a kasnije SQL/MX.
Cijela baza podataka dijeli se na dijelove, a za svaki dio odgovara svoj proces Data Access Manager (DAM). On osigurava zapis podataka, keširanje i mehanizam zaključavanja. Obradom podataka bave se izvršni procesi (Executor Server Process) koji rade na istim čvorovima kao odgovarajući menadžeri podataka. SQL/MX planer dijeli zadatke među izvršiteljima i kombinira rezultate. Kada je potrebno unijeti usklađene promjene, koristi se protokol dvostupanjskog potvrđivanja, koji osigurava TMF (Transaction Management Facility) biblioteka.
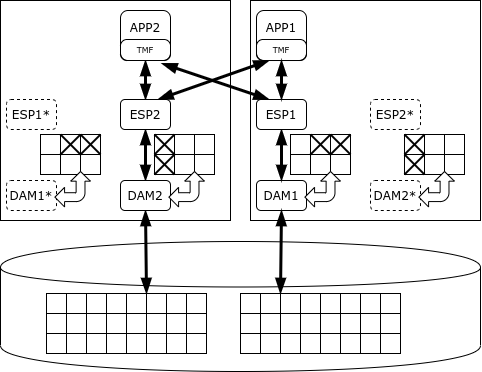
NonStop SQL može prioritizirati procese tako da dugi analitički upiti ne ometaju izvršenje transakcija. Međutim, njegova namjena je upravo obrada kratkih transakcija, a ne analiza. Razvijatelj jamči dostupnost NonStop klastera na razini pet "devetki", što znači da je vrijeme zastoja svega 5 minuta godišnje.
SAP HANA
Prvo stabilno izdanje HANA baze podataka (1.0) objavljeno je u studenom 2010. godine, a paket SAP ERP prešao je na HANA od svibnja 2013. godine. Platforma se temelji na kupljenim tehnologijama: TREX Search Engine (pretraživanje u kolonskoj pohrani), P*TIME DB i MAX DB.
Sama riječ "HANA" je akronim, High performance ANalytical Appliance. Ova baza podataka dolazi u obliku koda koji može raditi na bilo kojim x86 serverima, međutim industrijske instalacije dopuštene su samo na opremi koja je prošla certifikaciju. Dostupna su rješenja od proizvođača HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Neka Lenovo konfiguracije čak dopuštaju rad bez SAN-a – ulogu zajedničke pohrane igra GPFS klaster na lokalnim diskovima.
Za razliku od navedenih platformi, HANA je baza podataka u memoriji, tj. primarni prikaz podataka pohranjuje se u radnoj memoriji, a na disk se zapisuju samo dnevnici i periodične kopije – za oporavak u slučaju kvara.
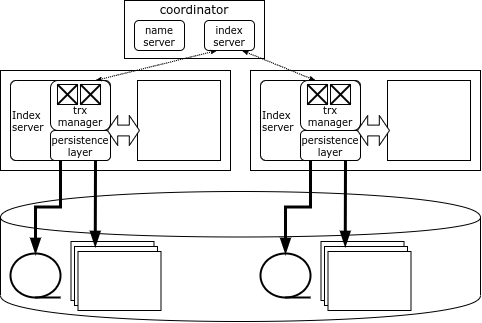
Svaki čvor HANA klastera odgovara za svoj dio podataka, a karta podataka pohranjuje se u posebnoj komponenti – Name Server, koja se nalazi na čvoru koordinatore. Podaci između čvorova se ne dupliciraju. Informacije o zaključavanjima također se pohranjuju na svakom čvoru, ali u sustavu postoji globalni detektor međusobnih zaključavanja.
Klijent HANA, prilikom povezivanja s klasterom, učitava njegovu topologiju i kasnije može izravno pristupati bilo kojem čvoru ovisno o tome koji su mu podaci potrebni. Ako transakcija uključuje podatke samo jednog čvora, može biti izvršena lokalno od strane tog čvora, ali ako se mijenjaju podaci s više čvorova, čvor koji inicira transakciju obraća se čvoru koordinatoru, koji otvara i koordinira distribuiranu transakciju, potvrđujući je pomoću optimiziranog protokola dvostupanjskog zaključavanja.
Čvor koordinator je dupliciran, pa u slučaju kvara koordinatora, odmah preuzima rezervni čvor. Međutim, ako dođe do kvara čvora s podacima, jedini način za pristup njegovim podacima je ponovo pokrenuti čvor. Obično u HANA klasterima drže rezervni (spare) server kako bi se što brže ponovno pokrenuo izgubljeni čvor.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish