

Zovem se Sergey, iz kompanije ITSumma, i želim vam ispričati kako pristupamo rezervaciji u Kubernetesu. U posljednje vrijeme puno se bavim konzultantskim radom na implementaciji raznih devops rješenja za različite timove, a posebno radim na projektima koji koriste K8s. Na konferenciji Uptime day 4, koja je bila posvećena rezervaciji u složenim arhitekturama, imao sam izlaganje o rezervaciji „kubika“, i evo njegovog slobodnog prepričavanja. Samo unaprijed upozoravam da to nije neposredni vodič za akciju, već više općenito razmatranje navedene teme.
U principu, praćenje i rezervacija su dva osnovna alata za povećanje otpornosti bilo kojeg projekta. Ali, vi ćete reći, u K8s se sve balansira samo, sve se samo skalira, i ako se nešto dogodi – to će se samo podići... Dakle, prilikom prvog površnog istraživanja teme, internet mi je odgovorio na pitanje kako se tko približava rezervaciji K8s s "a zašto?" Mnogi misle da K8s predstavlja neku čarobnu stvar koja eliminira sve infrastrukturne probleme i osigurava da projekt nikada ne padne. Ali... svijet nije ono što izgleda.
Kako smo pristupali procesu rezervacije ranije? Imali smo identične platforme za hostanje – bile su to ili virtualne mašine, ili fizički serveri servere, kojima smo primjenjivali tri osnovne prakse:
- synchronize code and static files
- synchronize configurations
- replicate databases
I voilà: u svakom trenutku prebacujemo se na rezervnu platformu, svi su sretni, ustajemo i razilazimo se.
Što nam se nudi za povećanje stalne dostupnosti naše Kubernetes aplikacije? Prvo, o čemu govori neformalne dokumentacija — to je postaviti više strojeva, napraviti više mastera — njihovo bi brojstvo trebalo zadovoljiti uslove za postizanje kvoruma unutar klastera, a da na svakom od mastera bude podignuto etcd, api, MC, scheduler… I, čini se, sve je divno: kada nekoliko radnih čvorova ili mastera izostane, naš klaster se preraspoređuje, a aplikacija nastavlja raditi. Opet izgleda kao čarolija! No, često se naš klaster nalazi unutar jednog centra podataka i to može izazvati određena pitanja. Što ako dođe bager i iskopava kabel, udari munja, dogodi se univerzalna poplava? Sve je propalo, našeg klastera više nema. Kako pristupiti rezervaciji uzimajući u obzir ovu stranu problema?
Prije svega, trebate imati još jedan klaster u vrućoj rezervi, dakle klaster na koji se možete prebaciti u bilo tren. S obzirom na Kubernetes, infrastrukture moraju biti potpuno identične. Dakle, ako postoje nesstandardni pluginovi za rad s datotečnim sustavom, prilagođena rješenja za ingress, ona moraju biti potpuno identična na vašim dva (ili tri, ili deset, tu već koliko ima novca i snage admina) klastera. Potrebno je jasno odrediti dva skupa aplikacija (deploymenta, statefulseta, daemonseta, cronjobova itd.): koje od njih mogu raditi na rezervi kontinuirano, a koje bi bolje bilo ne pokretati do neposrednog prebacivanja.
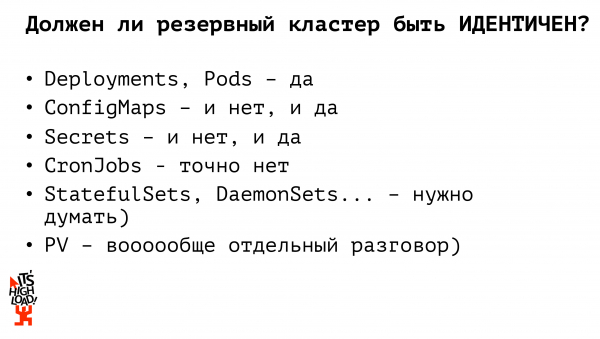
Treba li naš rezervni klaster biti potpuno identičan našem produkcijskom klasteru? Ne. Ako smo ranije u okviru rada s monolitnim projektima, s fizičkom infrastrukturom održavali gotovo potpuno identično okruženje, u okviru Kubernetesa, mislim da to ne bi trebalo biti tako. Poglejmo zašto.
Na primjer, započnimo s osnovnim entitetima kubernetes-a — deployments — koji trebaju biti identični. Trebaju biti pokrenute aplikacije koje u bilo kojem trenutku mogu preuzeti obradu prometa i omogućiti našem projektu da nastavi postojati. Kada govorimo o konfiguracijskim datotekama, onda treba razmisliti o tome trebaju li one biti identične ili ne. Drugim riječima, ako smo pametni ljudi koji ne koriste zabranjene supstance i ne držimo bazu u K8s, tada u configmaps-ima trebamo imati postavke pristupa našoj produkcijskoj bazi (proces rezerviranja koje je izgrađen odvojeno). Prema tome, za osiguranje pristupa rezervnoj instanci baze podataka trebamo imati zasebnu konfiguracijsku datoteku (configmap). Na isti način postupamo i s secret-ima: lozinkama za pristup bazi, api-ključevima; u bilo kojem trenutku može raditi ili produkcijski secret ili rezervni. Dakle, već imamo dvije entitete kubernetes-a čije rezervne verzije ne bi trebale biti identične produkcijskim. Sljedeća entitet na koju treba obratiti pažnju je cronjob. Cronjob-ovi na rezervi nikako ne bi trebali biti identični skupu cronjob-ova produkcijskog klastera! Ako podižemo rezervni klaster i podižemo ga potpuno sa svim uključenim cronjob-ovima — na primjer, ljudi će od vas primiti dvije e-poruke istovremeno umjesto jedne. Ili će neka sinkronizacija podataka s vanjskim izvorima prolaziti dva puta, te tako počinjemo boljeti, plakati, vikati i psovati.
A kako nam predlažu organizirati rezervni klaster ljudi s interneta? Drugi najpopularniji odgovor nakon „a zašto?“ — korištenje Kubernetes Federation.
Što je to? To je, recimo, veliki meta-klaster. Ako zamisliamo arhitekturu Kubernetesa — gdje imamo majstora, nekoliko čvorova — s obzirom na federaciju, također imamo majstora i nekoliko čvorova, samo što je svaki čvor poseban klaster. Dakle, radimo s istim entitetima, s istim primitvima kao i s jedinstvenim Kubernetesom, samo što ne upravljamo našim fizičkim strojevima, već cijelim klasterima. U okviru federacije događa se potpuna sinkronizacija federativnih resursa od roditelja prema potomcima. Na primjer, ako smo pokrenuli neku implementaciju putem federacije — ona će se implementirati na svaki naš pod-klaster. Ako uzmemo neki configmap, tajni ključ i distribuiramo ga putem federacije — on će se proširiti na sve naše pod-klastere; pritom federacija omogućava prilagodbu naših resursa na potomstvom. Dakle, uzeli smo neki configmap, implementirali ga putem federacije, a zatim, ako trebamo nešto prilagoditi na određenim klasterima, idemo ga mijenjati na posebnom klasteru, i ta promjena se više neće sinkronizirati.
Kubernetes Federation — nedavno stvoreni alat koji ne podržava cijeli set resursa koji nudi sam K8s: u trenutku objavljivanja jedne od prvih verzija dokumentacije, pisalo je da podržava samo config-mape, deployment pod replication set, ingress. Tajne nisu podržane, a rad s volume također nije podržan. Izuzetno ograničen skup. Pogotovo ako volimo eksperimentirati, na primjer, prenositi vlastite resurse kubernetesu putem custom resource definition, u federaciju ih već ne možemo ubaciti. Drugim riječima... rješenje koje se čini istinitim, ali nas često tjera da si sami pucamo u nogu. S druge strane, federacija nam omogućava fleksibilno upravljanje našim replicaset-om. Na primjer, želimo da bude pokrenuto 10 replika naše aplikacije, a federacija će to podijeliti proporcionalno između broja klastera. A sve to se može dodatno konfigurirati! Možemo odrediti da na produkcijskom klasteru treba imati 6 replika naše aplikacije, a na rezervnom klasteru, radi uštede resursa, ili radi vlastitih eksperimenta — samo 4 replike naše aplikacije. Što je također vrlo zgodno. No, s federacijom moramo koristiti neka nova rješenja, malo dodatno implementirati, natjerati sebe da malo više razmišljamo...
Može li se pristupiti procesu rezerviranja kubera na jednostavniji način? Koji alati su nam uopće dostupni?
Prvo, uvijek imamo neku ci/cd sistem, što znači da ne idemo ručno, ne pišemo na serverima create/apply. Sustav generira yaml fajlove za naše kontejnere.
Drugo, imamo nekoliko klastera, imamo ili jedan, ili više (ako smo pametni) registry, koji smo također uzeli i rezervirali. A tu je i izvrsna utilita kubectl koja može raditi s više klastera istovremeno.
Dakle, po mom mišljenju, najjednostavnije i najispravnije rješenje za izgradnju rezervnog klastera je primitivni paralelni deploy. Postoji neki pipeline u ci/cd sustavu; prvo gradimo naše kontejnere, testiramo i raspoređujemo aplikacije putem kubectl na nekoliko neovisnih klastera. Možemo ostavljati simultane izdanja na nekoliko klastera. Prema tome, dostavu konfiguracija također rješavamo u ovoj fazi. Možemo unaprijed odrediti skup konfiguracija za naš proizvodni klaster, skup konfiguracija za rezervni klaster i na razini ci/cd sustava rasporediti produkcijsko okruženje u proizvodni klaster, a rezervno okruženje u rezervni klaster. U usporedbi s federacijom, ne trebamo ići nakon određivanja federalnog resursa na svaki podređeni klaster i nešto ponovno definirati. To smo već uradili. Kakvi smo mi genijalci.
Ali... ima... već sam napisao, postoji „korijen svih zala“, ali ih u stvarnosti ima dva. Prvo, datotečni sustav. Postoji neki PV, ili koristimo vanjsko pohranjivanje. Ako pohranjujemo datoteke unutar klastera, onda ćemo ovdje djelovati prema starim praksama koje su preostale iz vremena fizičkih infrastruktura: na primjer, sinkronizirati s lsync-om. Pa ili bilo kojim drugim rješenjem koje osobno preferirate. Raspoređujemo sve na druge mašine i živimo.
Drugo, i, zapravo, još važnija točka spora — baza podataka. Ako smo pametni ljudi i ne držimo bazu unutar kubera, tada je proces rezervacije podataka prema istoj staroj shemi — master-slave replikacija, zatim prebacivanje, dostignemo replikaciju i živimo dobro. No ako ćemo držati naš DB unutar klastera, onda u načelu ima mnogo gotovih rješenja za organizaciju iste master-slave replikacije, mnogo rješenja za pokretanje DB unutar kubera.
O rezervaciji baza podataka već je pročitano milijun izvještaja, napisano milijun članaka, ništa novo ovdje, zapravo, nije potrebno. U svakom slučaju, slijedite svoje snove, živite kako želite, izmišljajte si neke složene mučne nijanse, ali svakako razmislite kako ćete sve to rezervirati.
A sada o tome kako će se, u načelu, odvijati proces prebacivanja na rezervnu lokaciju u slučaju požara. Prvo, paralelno otvaramo stateless aplikacije. One ne utječu na poslovnu logiku naših aplikacija, našeg projekta, možemo kontinuirano održavati dva skupa pokrenutih aplikacija i one mogu početi primati promet. Veoma je važno tijekom prebacivanja na rezervnu lokaciju obavezno provjeriti — treba li redefinirati konfiguracije? Na primjer, imamo produkcijski Kubernetes klaster, imamo rezervni Kubernetes klaster, imamo vanjsku bazu podataka master i rezervnu bazu podataka master. Imamo četiri opcije kako te aplikacije u produkciji mogu početi međusobno komunicirati. Može se prebaciti baza, a onda bi trebalo u produkcijskom klasteru preusmjeriti promet na novu bazu, ili se može dogoditi kvar klastera — i prešli smo na rezervu, ali nastavljamo raditi s produkcijskom bazom, i treća opcija je kada se ovo i ono pokvari, i prebacujemo obje aplikacije, redefiniramo našu konfiguraciju, kako bi nove aplikacije radile s novom bazom podataka.
Dakle, kakve se zaključke može iz toga izvući?
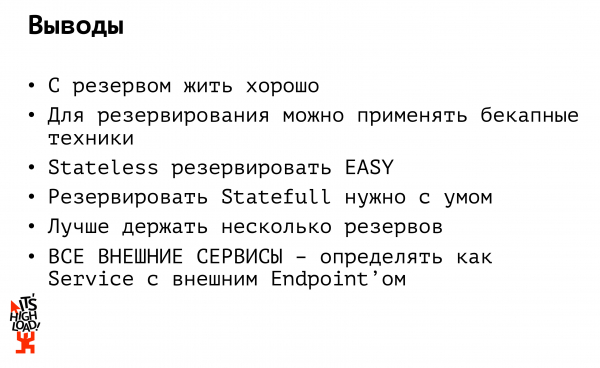
Prvi zaključak: imati rezervu je dobro. Ali skupo. Idealno je ne živjeti s jednom rezervom. Idealno je imati više rezervi. Prvo, rezerva ne bi trebala biti barem u jednom podatkovnom centru, i drugo, barem kod drugog hostera. Često se događalo — i u mojoj praksi je tako bilo. Nažalost, ne mogu nazivljati projekte, kao kad se dogodio požar u data centru… Rekao sam: prebacujemo se na rezervu! A rezervni serveri su stajali u istoj ormaru...
Ili zamislite da je Amazon zabranjen u Rusiji (a to se dogodilo). I sve: kakva je korist od toga što naš rezervni server leži u drugom Amazonu? I on je također nedostupan. Tako da ću ponoviti: držimo rezervu, barem u drugom podatkovnom centru, a poželjno — kod drugog hostera.
Drugo izlaganje: ako vaše aplikacije u Kubernetesu komuniciraju s vanjskim izvorima (to može biti baza podataka ili neki vanjski API), obavezno ih definirajte kao uslugu s vanjskim endpointom, kako ne biste morali ponovno implementirati 15 vaših aplikacija koje pristupaju istoj bazi tijekom prebacivanja. Definirajte bazu kao posebnu uslugu, pristupajte joj kao da je unutar vašeg klastera: ako vam se baza sruši, samo promijenite IP na jednom mjestu i nastavite sretno živjeti.
I za kraj: volim 'kubik', kao i eksperimentiranje s njim. Također volim dijeliti rezultate tih eksperimenata i svoje osobno iskustvo. Zato sam snimio seriju webinara o K8s, dobrodošli na za detalje.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish