

Filozofski uvod
Kako je poznato, postoje samo dvije metode za rješavanje problema:
- Metoda analize ili metoda dedukcije, ili od općeg ka posebnom.
- Metoda sintetiziranja ili metoda indukcije, ili od posebnog ka općem.
Za rješavanje problema 'poboljšati performanse baze podataka' to može izgledati ovako.
Analiza — razlažemo problem na pojedinačne dijelove i rješavajući ih pokušavamo poboljšati performanse baze podataka u cjelini.
U praksi analiza izgleda otprilike ovako:
- Javlja se problem (incidencija performansi)
- Sakupljamo statističke informacije o stanju baze podataka
- Tražimo uska grla (bottlenecks)
- Rješavamo probleme s uskih mjesta
Uska mjesta baze podataka — infrastruktura (CPU, Memorija, Diskovi, Mreža, OS), postavke (postgresql.conf), upiti:
Infrastruktura: mogućnosti utjecaja i promjena za inženjera — gotovo nula.
Postavke baze podataka: mogućnosti za promjene malo su veće nego u prethodnom slučaju, ali obično su još uvijek prilično teške, posebno u oblacima.
Upiti za bazu podataka: jedino područje za manevar.
Sintetiziranje — poboljšavamo performanse pojedinih dijelova, očekujući da će se u rezultatima poboljšati i performanse baze podataka.
Lirski uvod ili zašto je sve ovo potrebno
Kako izgleda proces rješavanja incidencija performansi, ako se performanse baze podataka ne prate:
Naručitelj - 'kod nas je sve loše, sporo, učinite nam dobro'
Inženjer - 'loše kako?'
Naručitelj - 'evo kako sada (prije sat vremena, jučer, u prošloj situaciji), polako'
Inženjer - 'a kada je bilo dobro?'
Naručitelj - 'prije tjedan (dva tjedna) bilo je dobro.' (Imali sreće)
Naručitelj - 'ne sjećam se kada je bilo dobro, ali sada je loše' (Uobičajen odgovor)
Kao rezultat dobivamo klasičnu sliku:
Tko je kriv i što učiniti?
Na prvi dio pitanja najlakše je odgovoriti — kriv je uvijek inženjer DBA.
Na drugi dio također nije previše teško odgovoriti — potrebno je implementirati sustav praćenja performansi baze podataka.
Javlja se prvo pitanje — što pratiti?
Put 1. Pratit ćemo SVE
Opterećenje CPU-a, broj diska za čitanje/zapisivanje, veličina dodijeljene memorije i još megatona raznih brojila koja bilo koji malo djelotvoran sustav praćenja može pružiti.
Rezultat je mnoštvo grafikona, sažetak tablica i neprekidna obavijest na e-mail, kao i 100% zauzetost inženjera rješavanjem gomile istih tiketa, obično s standardnom formulacijom - "Privremeni problem. Nije potrebna akcija". Ipak, svi su zaposleni i uvijek ima što pokazati klijentu - rad se odvija.
Put 2. Monitortati samo ono što je potrebno, a ono što nije potrebno, ne treba pratiti.
Može se malo drugačije pratiti - samo entitete i događaje:
- Na koje inženjer DBA može utjecati.
- Za koje postoji algoritam radnji u slučaju nastanka događaja ili promjene entiteta.
Polazeći od ove pretpostavke i prisjećajući se "Filozofski uvod" kako bismo izbjegli redovito ponavljanje "Lirski uvod ili zašto je sve ovo potrebno" bilo bi prikladno pratiti izvedbu pojedinačnih upita, radi optimizacije i analize, što na kraju treba dovesti do poboljšanja brzine cijele baze podataka.
No, kako bismo poboljšali teške upite koji utječu na ukupnu izvedbu baze podataka, prvo ih moramo pronaći.
Dakle, postavljaju se dva međusobno povezana pitanja:
- koji upit se smatra teškim
- kako tražiti teške upite.
Očigledno, težak upit je upit koji koristi mnogo resursa OS-a za dobivanje rezultata.
Prijelazimo na drugo pitanje - kako tražiti i zatim pratiti teške upite?
Koje mogućnosti praćenja upita postoje u PostgreSQL-u?
U usporedbi s Oracle-om, mogućnosti su nešto manje, ali se i dalje može učiniti nekoliko stvari.
PG_STAT_STATEMENTS
Za pronalaženje i praćenje teških upita u PostgreSQL-u namijenjeno je standardno proširenje pg_stat_statements.
Nakon instalacije proširenja, u ciljnoj bazi podataka pojavljuje se istoimeni prikaz koji se koristi za praćenje.
Ciljane kolone pg_stat_statements za izgradnju sustava praćenja:
- queryid Unutarnji hash-kod, izračunat prema stablu sintaktičke analize operatora.
- max_time Maksimalno vrijeme potrošeno na operator, u milisekundama.
Nakon prikupljanja i korištenja statistike o ova dva stupca, može se izgraditi sustav praćenja.
Kako se koristi pg_stat_statements za praćenje performansi PostgreSQL-a.
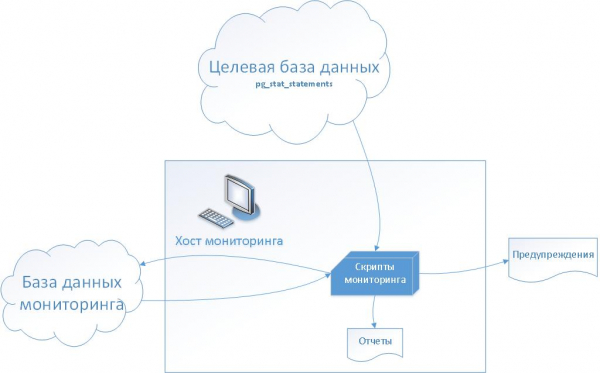
Za praćenje performansi upita koristi se:
Na strani ciljne baze podataka - prikaz pg_stat_statements.
S druge strane poslužitelja i baza podataka za praćenje - skup bash skripti i servisnih tablica.
1. faza — prikupljanje statističkih podataka
Na nadzornom hostu, redovno se pokreće skripta putem cron-a koja kopira sadržaj prikaza pg_stat_statements iz ciljne baze podataka u tabelu pg_stat_history u bazi podataka za nadzor.
Time se formira istorija izvršenja pojedinačnih upita, koja se može koristiti za generisanje izveštaja o performansama i podešavanje metrika.
2. faza — podešavanje metrika performansi
Na osnovu prikupljenih podataka, biramo upite čije je izvršenje najkritičnije/važnije za klijenta (aplikaciju). U skladu sa dogovorom sa klijentom, postavljamo vrednosti metrika performansi koristeći polja queryid i max_time.
Rezultat — pokretanje nadzora performansi
- Nadzorna skripta prilikom pokretanja proverava konfigurirane metrike performansi, upoređujući vrednost max_time metrike sa vrednošću iz prikaza pg_stat_statements u ciljnoj bazi podataka.
- Ako je vrednost u ciljnoj bazi podataka veća od vrednosti metrike – formira se upozorenje (incident u sistemu tiketa)
Dodatna mogućnost 1
Istorija planova izvršenja upita
Za kasnije rešavanje incidenata vezanih za performanse, veoma je korisno imati istoriju promena planova izvršenja upita.
Za čuvanje istorije koristi se servisna tabela log_query. Tabela se popunjava prilikom analize učitanog log-fajla PostgreSQL. Pošto u log-fajl, za razliku od prikaza pg_stat_statements, ulazi ceo tekst sa vrednostima izvršnih parametara, a ne normalizovan tekst, postoji mogućnost vođenja loga ne samo vremena i trajanja upita, već i čuvanja planova izvršenja u trenutnom vremenu.
Dodatna mogućnost 2
Proces kontinuiranog poboljšanja performansi
Nadzor pojedinačnih upita u opštem slučaju nije namenjen rešenju problema kontinuiranog poboljšanja performansi baze podataka u celini, jer kontroliše i rešava probleme performansi samo za pojedinačne upite. Međutim, metod se može proširiti i podešavati tako da nadzire upite za sve baze podataka.
Za to je potrebno uvesti dodatne metrike performansi:
- U poslednjim danima
- Za osnovni period
Skripta bira upite iz prikaza pg_stat_statements u ciljnoj bazi podataka i uspoređuje vrijednost max_time s prosječnom vrijednošću max_time, u prvom slučaju u posljednjim danima ili odabranom razdoblju (bazna linija), a u drugom slučaju.
Dakle, u slučaju degradacije performansi za bilo koji upit, upozorenje će se automatski generirati, bez ručne analize izvještaja.
A kakve veze ima sinteza?
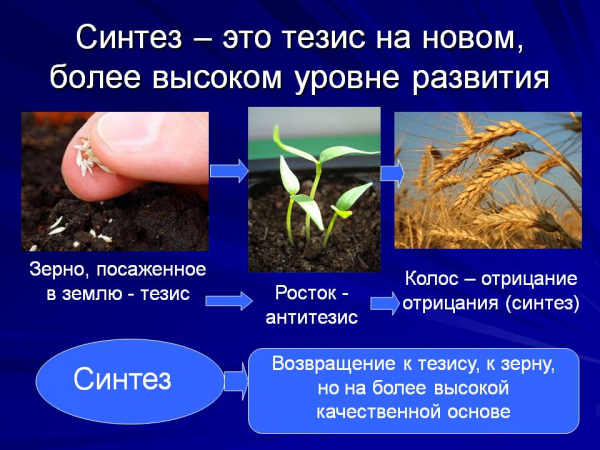
U opisanom pristupu, kao što metoda sinteze sugerira — poboljšanjem pojedinačnih dijelova sustava, poboljšavamo sustav u cjelini.
- Upit koji izvršava baza podataka – tezis
- Izmijenjeni upit – anti-tezis
- Promjena stanja sustava — sinteza
Razvoj sustava
- Proširenje prikupljene statistike dodavanjem povijesti za sustavni prikaz pg_stat_activity
- Proširenje prikupljene statistike dodavanjem povijesti za statistiku pojedinačnih tablica uključenih u upite
- Integracija s sustavom nadzora u oblaku AWS
- I još nešto možemo smisliti...
Izvor: habr.com
