

Ovaj članak je već drugi u nizu o brzinskoj kompresiji podataka. U prvom članku opisan je kompresor koji radi brzinom od 10 GB/s po procesorskom jezgru (minimalna kompresija, RTT-Min).
Ovaj kompresor je već implementiran u opremu kriminalističkih duplicatora za brzu kompresiju dumpova medija i poboljšanje otpornosti kriptografije, a može se koristiti i za kompresiju slika virtualnih mašina i swap datoteka radne memorije prilikom njihove pohrane na brzim SSD pogonima.
U prvom članku također je najavljena izrada algoritma za kompresiju koji komprimira sigurnosne kopije HDD i SSD diskova (srednja kompresija, RTT-Mid) s značajno poboljšanim parametrima kompresije podataka. U ovom trenutku ovaj kompresor je potpuno spreman i ovaj članak je posvećen njemu.
Kompresor koji implementira algoritam RTT-Mid osigurava stupanj kompresije usporediv s standardnim arhivatorima kao što su WinRar, 7-Zip, koji rade u brzinskom režimu. Pri tome je brzina njegovog rada najmanje red veličine viša.
Brzina pakiranja/raspakiranja podataka je kritični parametar koji određuje područje primjene tehnologija kompresije. Teško da bi nekome palo na pamet komprimirati terabajt podataka brzinom od 10-15 MegaByte-a u sekundi (upravo takva je brzina arhivatora u standardnom režimu kompresije), jer bi to trajalo gotovo dvadeset sati pri punom opterećenju procesora...
S druge strane, isti terabajt može se kopirati brzinama od 2-3 Gigabyte-a u sekundi za deset minuta.
Stoga je komprimiranje velikih količina informacija relevantno ako se obavlja brzinom ne manjoj od stvarne brzine ulaza/izlaza. Za moderne sustave to je najmanje 100 MegaByte-a u sekundi.
Takve brzine moderni kompresori mogu postići samo u režimu 'fast'. U tom aktualnom režimu ćemo provesti usporedbu algoritma RTT-Mid s tradicionalnim kompresorima.
Usporedno testiranje novog algoritma kompresije
Kompresor RTT-Mid radio je u okviru testnog programa. U stvarnoj 'radnoj' aplikaciji radi znatno brže, gdje se pametno koristi višedretvenost i primjenjuje 'normalni' kompajler, a ne C#.
Budući da su kompresori korišteni u usporednom testu izgrađeni na različitim principima i različite vrste podataka komprimiraju na različite načine, za objektivnost testa korištena je metoda mjerenja „prosječne temperature u bolnici”…
Izrađen je datoteka po sektorima snimanja logičkog diska s operativnim sustavom Windows 10, što je najprirodnija mješavina različitih struktura podataka koja se nalazi na svakom računalu. Kompresija ove datoteke omogućit će usporedbu brzine i stupnja kompresije novog algoritma s najnaprednijim kompresorima koji se koriste u modernim arhivatorima.
Ova datoteka snimke:
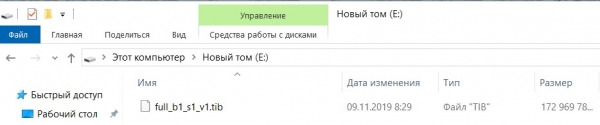
Datoteka snimke komprimirana je kompresorima RTT-Mid, 7-zip, WinRar. Kompresori WinRar i 7-zip postavljeni su na maksimalnu brzinu rada.
Radi kompresor 7-zip:
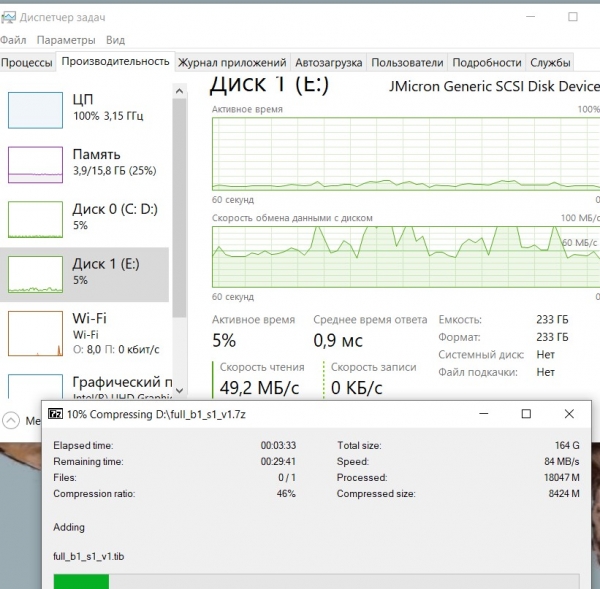
Opterećuje procesor 100%, pri čemu je prosječna brzina čitanja izvorne snimke oko 60 Megabajta/sek.
Radi kompresor WinRar:
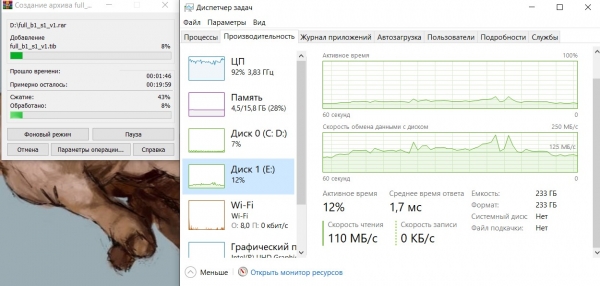
Situacija je slična, opterećenje procesora gotovo 100%, prosječna brzina čitanja snimke oko 125 Megabajta/sek.
Kao i u prethodnom slučaju, brzina rada arhivatora ograničena je mogućnostima procesora.
Sada radi testni program kompresora RTT-Mid:
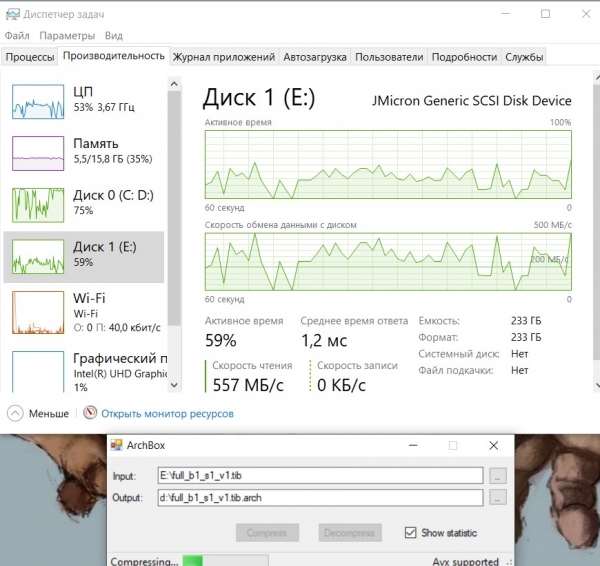
Screenshot pokazuje da je procesor opterećen 50% i ostatak vremena miruje jer nema kamo isporučiti komprimirane podatke. Disk za isporuku podataka (Disk 0) gotovo je potpuno opterećen. Brzina čitanja podataka (Disk 1) znatno varira, ali u prosjeku je veća od 200 Megabajta/sek.
Brzina rada kompresora u ovom slučaju ograničena je mogućnošću pisanja komprimiranih podataka na Disk 0.
Sada stupanj kompresije dobivenih arhiva:
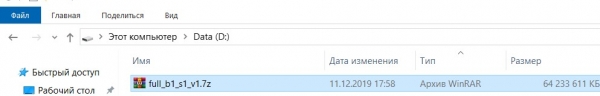
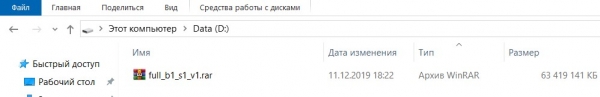
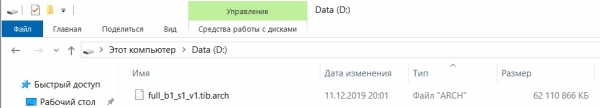
Vidljivo je da je kompresor RTT-Mid najbolje obavio kompresiju, arhiv koji je on stvorio je 1,3 Gigabajta manji od arhiva WinRar i 2,1 Gigabajta manji od arhiva 7z.
Vrijeme utrošeno za izradu arhiva:
- 7-zip – 26 minuta 10 sekundi;
- WinRar – 17 minuta 40 sekundi;
- RTT-Mid – 7 minuta 30 sekundi.
Dakle, čak i testni, neoptimizirani program koristeći algoritam RTT-Mid, mogao je brže stvoriti arhiv više od dva i pol puta, pri čemu je arhiv ispao znatno manji nego kod konkurenata…
Oni koji ne vjeruju screenshotovima mogu provjeriti njihovu točnost sami. Testni program dostupan je na , preuzmite i provjerite.
Ali samo na procesorima koji podržavaju AVX-2, bez podrške za te instrukcije kompresor ne radi, a ne testirajte algoritam na starim AMD procesorima, oni su spori u izvršavanju AVX naredbi…
Metoda kompresije koja se koristi
U algoritmu se koristi metoda indeksiranja ponavljajućih fragmenata teksta u bajtnoj granularnosti. Ova metoda kompresije poznata je od davnina, ali se nije koristila jer je operacija pronalaženja podudaranja bila vrlo skupa po potrebnim resursima i zahtijevala je mnogo više vremena nego izgradnja rječnika. Tako da je algoritam RTT-Mid klasičan primjer povratka u budućnost…
U RTT kompresoru koristi se jedinstveni brzi skener za pronalaženje podudaranja, upravo on je omogućio ubrzanje procesa kompresije. Skener vlastite izrade, to je 'moje blago...', 'cijena mu nije mala, jer je potpuno ručne izrade' (napisan u asembleru).
Skener za pronalaženje podudaranja izveden je po dvostupanjskom probabilističkom shemu, prvo se skenira prisutnost 'znaka' podudaranja, a tek nakon otkrivanja 'znaka' na tom mjestu pokreće se procedura za otkrivanje stvarnog podudaranja.
Prozor za pronalaženje podudaranja ima nepredvidivu veličinu, koja ovisi o stepenu entropije u obrađenom bloku podataka. Za potpuno slučajne (nekompresibilne) podatke ima veličinu od megabajta, dok za podatke koji imaju ponavljanja uvijek ima veličinu veću od megabajta.
Ali mnogi moderni formati podataka su nekompresibilni i ‘vrtnja’ po njima resursno zahtjevnoga skenera je beskorisna i rasipna, stoga skener koristi dva načina rada. Prvo se traže dijelovi izvornog teksta s mogućim ponavljanjima, ova operacija se također provodi probabilističkom metodom i izvodi vrlo brzo (brzinom od 4-6 gigabajta/s). Zatim se dijelovi s mogućim podudaranjima obrađuju glavnim skenerom.
Indeksna kompresija nije vrlo učinkovita, mora se zamijeniti ponavljajući fragmente indeksima, a indeksni niz značajno smanjuje koeficijent kompresije.
Kako bi se povećao stupanj kompresije, indeksiraju se ne samo potpuni podudari bajtnih nizova, već i djelomični, kada u nizu postoje podudarni i nepodudarni bajti. U tu svrhu format indeksa uključuje polje maske podudaranja koja pokazuje podudarne bajte dva bloka. Za još veću kompresiju koristi se indeksiranje s preklapanjem nekoliko djelomično podudarnih blokova na trenutni blok.
Sve to omogućilo je postizanje stupnja kompresije u kompresoru RTT-Mid koji je usporediv s kompresorima izrađenim prema metodi rječnika, ali radi mnogo brže.
Brzina rada novog algoritma kompresije
Ako kompresor radi s monopolnom upotrebom cache memorije (za jednu nit potrebna su 4 Megabajta), brzina rada varira u rasponu od 700-2000 Megabajta/sec. po jednoj procesorskoj jezgri, ovisno o vrsti komprimiranih podataka i malo ovisi o radnoj frekvenciji procesora.
Pri višedretvenoj implementaciji kompresora, učinkovita skalabilnost određuje se volumenom treće razine cache memorije. Na primjer, s 9 Megabajta cache memorije nema smisla pokretati više od dva nite kompresije, brzina se od toga neće povećati. No, s cache memorijom od 20 Megabajta već je moguće pokrenuti pet nitova kompresije.
Također, značajan parametar koji određuje brzinu rada kompresora postaje latencija radne memorije. Algoritam koristi nasumične pristupe RAM-u, od kojih dio ne ulazi u cache memoriju (oko 10%) i mora čekati podatke iz RAM-a, što usporava rad.
Na brzinu kompresora značajno utječe i rad sustava ulaza/izlaza podataka. Zahtjevi za RAM od ulaza/izlaza blokiraju pristupe podacima s strane CPU-a, što također smanjuje brzinu kompresije. Ovaj problem je značajan za prijenosna računala i desktop računala, poslužitelja dok je manje značajan zahvaljujući naprednijem bloku upravljanja pristupom sistemskoj sabirnici i višekanalnoj radnoj memoriji.
U cijelom tekstu članka govori se o kompresiji, dok je dekompresija izvan okvira ovog članka jer je tu "sve u redu". Dekompresija se odvija znatno brže i ograničena je brzinom ulaza/izlaza. Jedno fizičko jezgro u jednom niti može osigurati brzinu dekompresije od 3-4 gigabajta u sekundi.
To je povezano s tim da tijekom dekompresije ne dolazi do operacije pretraživanja podudaranja, koja "troši" glavne resurse procesora i cache memorije tijekom kompresije.
Pouzdanost pohrane komprimiranih podataka
Kako i samo ime cijelog razreda softverskih alata koji koriste kompresiju podataka (archive) sugerira, oni su namijenjeni dugotrajnom pohranjivanju informacija, ne godinama, nego stoljećima i tisućljećima…
Tijekom vremena pohranjivači informacija gube dio podataka, evo primjera:
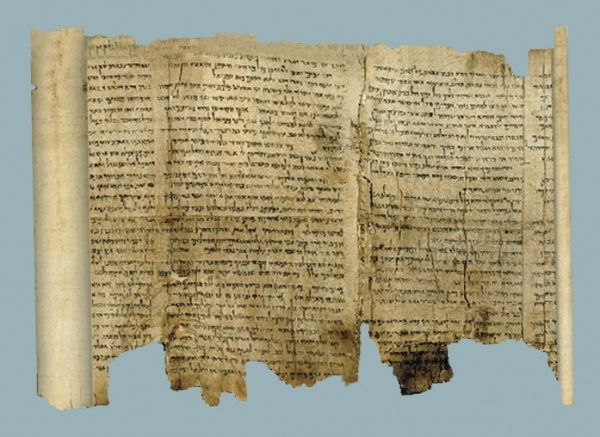
Ovaj "analogne" pohranjivač informacija ima tisuću godina, neki dijelovi su izgubljeni, ali u cjelini je informacija "čitljiva"…
Niti jedan od odgovornih proizvođača modernih digitalnih sustava za pohranu podataka i digitalnih medija ne daje garancije o potpunoj sigurnosti podataka duže od 75 godina.
I to je problem, ali odgođeni problem, koji će rješavati naši potomci…
Sustavi za pohranu digitalnih podataka mogu gubiti podatke ne samo nakon 75 godina, greške u podacima mogu se pojaviti u bilo kojem trenutku, čak i tijekom njihove pohrane, ti se izobličenja pokušavaju minimizirati korištenjem redundancije i ispravljanjem sustavima za ispravak grešaka. Redundancija i sustavi ispravka ne mogu uvijek obnoviti izgubljene informacije, a ako i obnove, nema garancije da je operacija obnove prošla ispravno.
I to je također veliki problem, ali ne odgođeni, nego trenutni.
Moderne kompresore korištene za arhiviranje digitalnih podataka temelje se na različitim varijantama rječničke metode, a kod takvih arhiva gubitak fragmenta informacije bit će fatalni događaj, čak postoji i ustaljeni izraz za takvu situaciju — "oštećeni" arhiv...
Niska pouzdanost pohrane informacija u arhivima sa rečničkim kompresijama povezana je sa strukturom komprimovanih podataka. Informacije u takvom arhivu ne sadrže izvorni tekst, već se skladište brojevi unosa u rečniku, dok se sam rečnik dinamički menja tekućim kompresovanim tekstom. U slučaju gubitka ili izobličenja fragmenta arhiva, nemoguće je identifikovati sve naredne unose arhiva niti prema sadržaju, niti prema dužini unosa u rečniku, jer nije jasno šta odgovara broju rečničkog unosa.
Obnova informacija iz takvog "pokvarenog" arhiva nije moguća.
RTT algoritam je zasnovan na pouzdanijem metodu pohrane komprimovanih podataka. U njemu se primenjuje indeksna metoda praćenja ponavljajućih fragmenata. Ovakav pristup kompresiji omogućava minimizaciju posledica izobličenja informacija na mediju, i u mnogim slučajevima automatski ispravlja izobličenja koja su nastala prilikom pohrane informacija.
To je povezano s tim da arhivska datoteka u slučaju indeksne kompresije sadrži dva polja:
- polje ishodišnog teksta sa uklonjenim odsecima ponavljanja;
- polje indeksa.
Kritično važno polje indeksa za obnovu informacija nije veliko po veličini i može se duplicirati za pouzdaniju pohranu podataka. Stoga, čak i ako deo ishodišnog teksta ili indeksnog niza bude izgubljen, cela ostala informacija će se obnavljati bez problema, kao na slici sa "analognim" medijem informacija.
Nedostaci algoritma
Nema vrlina bez nedostataka. Indeksna metoda kompresije ne kompresuje ponavljajuće sekvence male dužine. To je posledica ograničenja indeksne metode. Indeksi imaju veličinu ne manju od 3 bajta i mogu imati veličinu do 12 bajta. Ako se susretne ponavljanje sa manjom veličinom od onu koja ga opisuje indeks, tada se ne uzima u obzir, bez obzira koliko često se takva ponavljanja otkrivaju u kompresovanom fajlu.
Tradicionalna, leksikografska metoda kompresije učinkovito smanjuje višekratne ponavljanja kratke duljine, a time postiže veći koeficijent kompresije od indeksne kompresije. Naravno, to se postiže visokom opterećenošću CPU-a, jer da bi leksikografska metoda počela učinkovitije komprimirati podatke od indeksne metode, mora smanjiti brzinu obrade podataka na 10-20 megabajta u sekundi na stvarnim računalnim instalacijama pri punom opterećenju CPU-a.
Takve niske brzine su neprihvatljive za moderne sustave pohrane podataka i predstavljaju više 'akademski' interes nego praktički.
Stupanj kompresije informacija bit će značajno povećan u sljedećoj modifikaciji RTT algoritma (RTT-Max), koji je već u razvoju.
Tako da, kao i uvijek, nastavak slijedi…
Izvor: habr.com
