

Posljednjih otprilike pola godine bavio sam se kreiranjem sustava protiv prevara (fraudulent activity, fraud, itd.) bez ikakve inicijalne infrastrukture za to. Ideje koje smo pronašli i implementirali u našem sustavu pomažu nam otkrivati brojne prevarantske aktivnosti i analizirati ih. U ovom članku želim govoriti o principima kojima smo se vodili i o onome što smo učinili za postizanje trenutnog stanja našeg sustava, ne ulazeći u tehničke detalje.
Principi našeg sustava
Kada čujete takve termine kao što su "automatic" i "fraud", vjerojatno počinjete razmišljati o strojnom učenju, Apache Spark, Hadoop, Python, Airflow i drugim tehnologijama ekosustava Apache Foundation i područja Data Science. Mislim da postoji jedan aspekt korištenja tih alata koji se obično ne spominje: oni zahtijevaju određene pretpostavke u vašem korporativnom sustavu prije nego što počnete s njihovim korištenjem. Ukratko, potrebna vam je korporativna platforma podataka koja uključuje jezero podataka i skladište. Ali što ako nemate takvu platformu, a još uvijek trebate razvijati ovu praksu? Sljedeći principi koje opisujem u nastavku pomogli su nam da dođemo do trenutka kada se možemo usredotočiti na poboljšanje naših ideja, a ne na pronalaženje funkcionalne. Ipak, ovo nije "plato" projekta. U planu još ima mnogo stvari s tehničke i produkcijske točke gledišta.
Princip 1: vrijednost za poslovanje na prvom mjestu
Na vrhu svih naših napora stavili smo "vrijednost za poslovanje". U cjelini, svaki sustav automatske analize pripada grupi složenih sustava s visokim stupnjem automatizacije i tehničke složenosti. Izrada završnog rješenja oduzet će puno vremena ako ga stvorite ispočetka. Odlučili smo staviti vrijednost poslovanja na prvo mjesto, a tehnološku dovršenost na drugo. U stvarnom životu to znači da ne prihvaćamo napredne tehnologije kao dogmu. Biramo tehnologiju koja nam najbolje odgovara u tom trenutku. S vremenom se može činiti da ćemo morati ponovo implementirati neke module. To je kompromis koji smo prihvatili.
Princip 2: proširena inteligencija čovjeka (augmented intelligence)
Kladim se da većina ljudi koji nisu duboko uključeni u razvoj rješenja za strojno učenje misliti da je zamjena ljudi cilj. U stvarnosti, rješenja za strojno učenje daleko su od savršenstva i zamjena je moguća samo u određenim područjima. Odbacili smo tu ideju od samog početka iz nekoliko razloga: neuravnoteženi podaci o prevarama i nemogućnost pružanja iscrpnog popisa značajki za modele strojnog učenja. Umjesto toga, odabrali smo opciju s proširenim intelektom. To je alternativna koncepcija umjetne inteligencije koja se fokusira na pomoćnu ulogu AI, naglašavajući činjenicu da su kognitivne tehnologije namijenjene poboljšanju ljudske inteligencije, a ne njenoj zamjeni. [1]
Uzimajući to u obzir, razvoj cjelovitog rješenja za strojno učenje od samog početka zahtijevao bi ogroman trud, što bi usporilo stvaranje vrijednosti za našu tvrtku. Odlučili smo izgraditi sustav s iterativno rastućim aspektom strojnog učenja pod vodstvom naših stručnjaka u predmetnom području. Težak dio razvoja takvog sustava je što mora pružiti našim analitičarima slučajeve ne samo s aspekta je li riječ o prevarantskoj aktivnosti ili nije. Općenito, svaka anomalija u ponašanju klijenata sumnjivi je slučaj koji stručnjaci trebaju istražiti i na neki način odgovoriti. Samo dio zabilježenih slučajeva može se stvarno svrstati u kategoriju prijevare.
Načelo 3: platforma opsežnih analitičkih podataka
Najteži deo našeg sistema je neprekidna provera radnog toka sistema. Analitičari i developeri moraju lako doći do skupova podataka za prethodne periode sa svim metrima koji su korišćeni za analizu. Osim toga, podaci platforme moraju pružiti jednostavan način dopunjavanja postojećeg skupa indikatora novim. Procesi koje kreiramo, a to nisu samo softverski, moraju omogućiti lakše prebrojavanje prethodnih perioda, dodavanje novih metrika i promenu predikcija podataka. Mogli bismo to ostvariti akumulacijom svih podataka koje generiše naš proizvodni sistem. U tom slučaju podaci bi postali postepeno smetnja. Morali bismo da čuvamo rastući volumen podataka koje ne koristimo i da ih štitimo. U tom scenariju s vremenom bi podaci postajali sve manje relevantni, ali bi i dalje zahtevali naš trud za upravljanje njima. Akumulacija podataka nije imala smisla za nas, pa smo odlučili da upotrebimo drugi pristup. Odlučili smo da organizujemo skladišta podataka u realnom vremenu oko ciljnih entiteta koje želimo klasifikovati i da čuvamo samo one podatke koji omogućavaju proveru najnovijih i najaktuelnijih perioda. Složenost ovih napora leži u tome da je naš sistem nehomogen sa više skladišta podataka i softverskih modula koji zahtevaju pažljivo planiranje za dosledno funkcionisanje.
Konstrukcijske koncepcije našeg sistema
Imamo četiri glavna komponente u našem sistemu: sistem prijema (ingestion system), računalni (computational), analiza (BI analysis) i sistem praćenja (tracking system). Oni služe za konkretne izolovane ciljeve, a mi ih držimo izolovanim, prateći određene pristupe u razvoju.
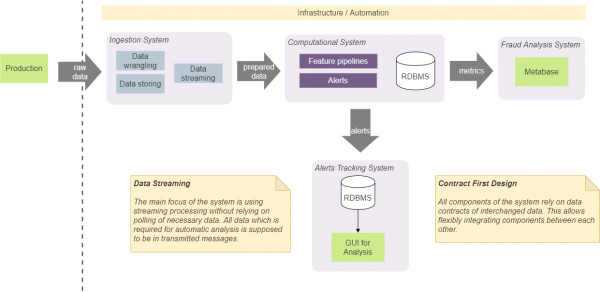
Dizajn zasnovan na ugovorima
Prije svega, dogovorili smo se da se komponente oslanjaju samo na određene strukture podataka (ugovore) koje se između njih prenose. To omogućuje jednostavnu integraciju i ne nameće određeni sastav (i redoslijed) komponenti. Na primjer, u nekim slučajevima to nam omogućuje izravnu integraciju sustava prihvata s sustavom praćenja upozorenja. U tom slučaju to će biti provedeno u skladu s dogovorenim ugovorom o upozorenjima. To znači da će obje komponente biti integrirane koristeći ugovor koji može koristiti bilo koja druga komponenta. Nećemo dodavati dodatni ugovor za dodavanje upozorenja u sustav praćenja iz sustava ulaza. Ovaj pristup zahtijeva korištenje unaprijed definiranog minimalnog broja ugovora i pojednostavljuje sustav i komunikacije. U osnovi, koristimo pristup koji se naziva „Contract First Design“, i primjenjujemo ga na ugovore za prijenos podataka. [2]
Streaming svugdje
Skladištenje i upravljanje stanjem u sustavu neizbježno će dovesti do složenosti u njegovoj implementaciji. Općenito, stanje bi trebalo biti dostupno iz bilo kojeg komponente, mora biti konzistentno i pružiti najrelevantniju vrijednost svim komponentama, te bi trebalo biti pouzdano s točnim vrijednostima. Osim toga, pozivi na trajnu pohranu za dobivanje posljednjeg stanja povećat će broj operacija ulaza-izlaza i složenost algoritama koji se koriste u našim real-time kanalima. Zbog toga smo odlučili potpuno ukloniti pohranu stanja iz našeg sustava kada je to moguće. Ovaj pristup zahtijeva uključivanje svih potrebnih podataka u prenosivu datotečnu jedinicu (poruku). Na primjer, ako trebamo izračunati ukupni broj nekih zapažanja (broj operacija ili slučajeva s određenim karakteristikama), izračunavamo ga u memoriji i generiramo niz takvih vrijednosti. Ovisni moduli će koristiti razdjeljivanje (partition) i grupiranje (batch) kako bi razbili tok podataka po entitetima i operirali s posljednjim vrijednostima. Ovaj pristup eliminira potrebu za trajnom diskovnom pohranom za takve podatke. Naš sustav koristi Kafka kao posrednika poruka, i može se koristiti kao baza podataka s KSQL. [3] Međutim, njegovo korištenje bi snažno povezalo naše rješenje s Kafka-om, te smo odlučili da ga ne koristimo. Odabrani pristup nam omogućuje zamjenu Kafke drugim posrednikom poruka bez značajnih unutrašnjih promjena sustava.
Ova koncepcija ne znači da ne koristimo diskovne pohrane i baze podataka. Za provjeru i analizu izvedbe sustava potrebno je pohraniti na disk značajan dio podataka koji predstavljaju različite pokazatelje i stanja. Važna točka ovdje je da algoritmi u stvarnom vremenu ne ovise o takvim podacima. U većini slučajeva koristimo pohranjene podatke za autonomnu analizu, dijagnostiku i praćenje određenih slučajeva i rezultata koje sustav generira.
Problemi našeg sustava
Postoje određeni problemi koje smo riješili do određene razine, ali zahtijevaju promišljenija rješenja. Sada bih ih samo želio spomenuti ovdje, jer svaka točka zaslužuje poseban članak.
- Još uvijek moramo odrediti procese i politike koje potiču prikupljanje značajnih i relevantnih podataka za našu automatsku analizu, otkrivanje i istraživanje podataka.
- Implementacija rezultata analize od strane ljudi u proces automatskog podešavanja sustava na temelju najnovijih podataka. To nije samo ažuriranje našeg modela, već i ažuriranje procesa i poboljšanje razumijevanja naših podataka.
- Pronalaženje ravnoteže između determinističkog pristupa IF-ELSE i ML. Netko je rekao: "ML je alat za one bez nade". To znači da ćete htjeti koristiti ML kada više ne razumijete kako optimizirati i poboljšati svoje algoritme. S druge strane, deterministički pristup ne omogućava otkrivanje anomalija koje nisu predviđene.
- Trebamo jednostavan način za provjeru naših hipoteza ili korelacija između metrika u podacima.
- Sustav mora imati nekoliko razina stvarno pozitivnih (true positive) rezultata. Slučajevi prevare samo su dio svih slučajeva koji se mogu smatrati pozitivnima za sustav. Na primjer, analitičari žele dobiti sve sumnjive slučajeve na provjeru, a samo mali dio njih je prevara. Sustav treba učinkovito pružati analitičarima sve slučajeve, bez obzira na to je li to stvarna prevara ili samo sumnjivo ponašanje.
- Podatkovna platforma treba omogućiti pristup skupovima podataka iz prethodnih razdoblja s izračunima generiranim i izračunatim u stvarnom vremenu.
- Jednostavno i automatsko implementiranje bilo kojeg od komponenata sustava u najmanje tri različita okruženja: produkcijsko, eksperimentalno (beta) i za programere.
- I na kraju, ali ne manje važno. Moramo stvoriti opsežnu platformu za provjeru performansi na kojoj možemo analizirati naše modele. [4]
Linkovi
Izvor: habr.com
