

Kube-scheduler je ključna komponenta Kubernetes-a koja je odgovorna za planiranje podova na čvorovima prema zadanih politikama. Često, u procesu korištenja Kubernetes klastera, ne razmišljamo o tome po kojim politikama se odvija planiranje podova, jer skup politika defaultnog kube-scheduler-a zadovoljava većinu svakodnevnih zadataka. Međutim, postoje situacije kada je važno precizno upravljati procesom raspodjele podova, a za to postoje dva načina:
- Kreirati kube-scheduler s prilagođenim skupom pravila
- Napisati vlastiti scheduler i naučiti ga kako raditi s API-server zahtjevima
U ovom članku ću opisati implementaciju upravo prve opcije za rješavanje problema neujednačenog planiranja podova u jednom od naših projekata.
Kratki uvod u rad kube-scheduler-a
Važno je napomenuti da kube-scheduler ne odgovara za direktno planiranje podova — on je odgovoran samo za određivanje čvora na kojem treba smjestiti pod. Drugim riječima, rezultat rada kube-scheduler-a je ime čvora koje on vraća API-serveru na zahtjev za planiranje, a time njegova funkcija završava.
Prvo, kube-scheduler sastavlja popis čvorova na koje se može planirati pod u skladu s politikama predicates. Zatim svaki čvor iz ovog popisa dobiva određeni broj bodova u skladu s politikama priorites. Na kraju se bira čvor s maksimalnim brojem bodova. Ako postoje čvorovi s istim maksimalnim brojem bodova, bira se nasumično. Popis i opis politika predicates (filtriranje) i priorites (ocjenjivanje) može se pronaći u .
Opis tijela problema
Unatoč velikom broju različitih Kubernetes klastera kojima upravlja Nixys, s problemom planiranja podova prvi put smo se susreli nedavno, kada je za jedan od naših projekata postojala potreba za pokretanjem velikog broja periodičnih zadataka (~100 entiteta CronJob). Kako bismo maksimalno pojednostavili opis problema, uzmimo za primjer jednu mikroslužbu u okviru koje se svake minute pokreće cron-zadatak koji stvara određeno opterećenje na CPU. Za rad cron-zadatka dodijeljene su tri potpuno identične čvora (24 vCPU na svakoj).
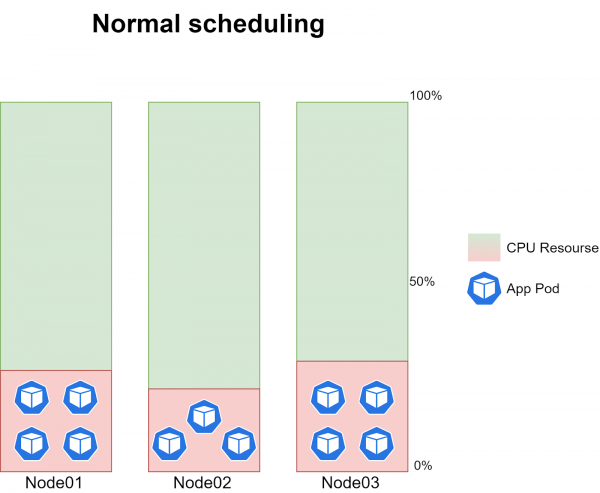
Pri tome se ne može točno reći koliko će vremena trajati izvođenje CronJob-a, jer se količina ulaznih podataka neprekidno mijenja. U prosjeku, pri normalnom radu kube-scheduler-a, na svakoj čvoru radi 3-4 primjerka zadatka, koji stvaraju ~20-30% opterećenja na CPU svake čvora:
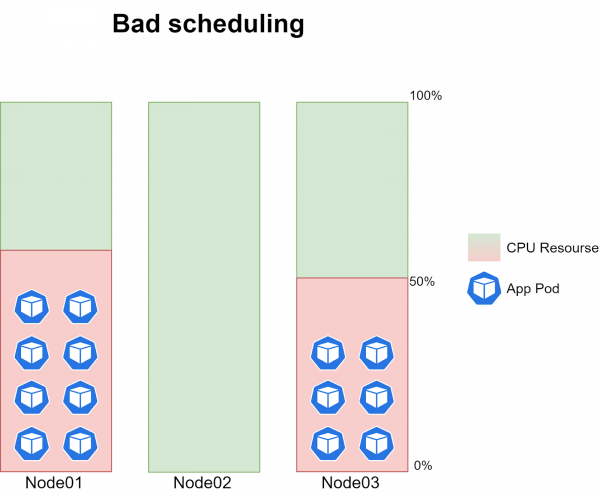
Sam problem leži u tome što su ponekad podovi cron-zadataka prestajali planirati na jedan od tri čvora. Drugim riječima, u nekom trenutku na jedan od čvora nije bio planiran nijedan pod, dok su na druga dva čvora radila po 6-8 primjeraka zadatka, stvarajući ~40-60% opterećenja na CPU:
Problem se ponavljao s potpuno nasumičnom učestalošću i ponekad je korelirao s trenutkom isporuke nove verzije koda.
Povećavši razinu logiranja kube-scheduler-a na 10 (-v=10), počeli smo bilježiti koliko bodova svaka od čvora dobiva tijekom procjene. Pri normalnom radu planiranja, u logovima se mogla vidjeti sljedeća informacija:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1387 millicores 4161694720 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1347 millicores 4444810240 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1387 millicores 4161694720 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1687 millicores 4790840320 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1347 millicores 4444810240 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, kapacitet 23900 millicores 67167186944 bajtova memorije, ukupni zahtjev 1687 millicores 4790840320 bajtova memorije, rezultat 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Rezultat: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Rezultat: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Rezultat: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:781] Host Node01 -> Rezultat 100043
generic_scheduler.go:781] Host Node02 -> Rezultat 100043
generic_scheduler.go:781] Host Node03 -> Rezultat 100043
Dakle, prema informacijama dobivenim iz logova, svaka od nodova ostvarila je jednaku količinu konačnih bodova i za planiranje se birala nasumično. U trenutku problematičnog planiranja logovi su izgledali ovako:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 1587 milikore 4581125120 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 1087 milikore 3532549120 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 1587 milikore 4581125120 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 987 milikore 3322833920 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 987 milikore 3322833920 bajtova memorije, rezultat 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, kapacitet 23900 milikore 67167186944 bajtova memorije, ukupni zahtjev 1087 milikore 3532549120 bajtova memorije, rezultat 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Rezultat: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Rezultat: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Rezultat: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Rezultat: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Rezultat: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Rezultat: (10)
generic_scheduler.go:781] Host Node03 -> Rezultat 100041
generic_scheduler.go:781] Host Node02 -> Rezultat 100041
generic_scheduler.go:781] Host Node01 -> Rezultat 100038
Iz koje je vidljivo da je jedna od nodova skupila manje ukupnih bodova od ostalih, i stoga je planiranje provedeno samo na dvije nodove koje su postigle maksimalan rezultat. Tako smo se uvjerili da problem leži upravo u planiranju podova.
Daljnji algoritam rješenja problema bio nam je očit — analizirati logove, shvatiti po kojem je točno prioritetu nod ne skupio bodove i, po potrebi, prilagoditi politike defaultnog kube-scheduler-a. Međutim, ovdje smo se suočili s dvije značajne poteškoće:
- Na maksimalnoj razini logiranja (10) odražava se skup bodova samo prema nekim prioritetima. U gornjem isječku logova može se primijetiti da prema svim prioritetima prikazanim u logovima, nodovi skupljaju istu količinu bodova pri normalnom i problematičnom planiranju, međutim konačni rezultat u slučaju problematičnog planiranja se razlikuje. Tako se može zaključiti da se prema nekim prioritetima računanje bodova odvija “u pozadini”, i nemamo mogućnost da shvatimo po kojem točno prioritetu nod nije dobio bodove. Ovaj problem smo detaljno opisali u Kubernetes repozitoriju na Githubu. U trenutku pisanja članka smo dobili odgovor od programera da će podrška za logiranje biti dodana u ažuriranjima Kubernetes v1.15, 1.16 i 1.17.
- Ne postoji jednostavan način da se razumije s kojim točno skupom politika trenutno radi kube-scheduler. Da, u ovom popisu je navedeno, ali nema informacija o tome koje su točno težine dodijeljene svakoj od politika prioriteta. Težine se mogu vidjeti ili urediti samo u .
Važno je napomenuti da smo jednom uspjeli zabilježiti da nod nije dobio bodove prema politici ImageLocalityPriority, koja dodaje bodove nodu ako na njemu već postoji slika potrebna za pokretanje aplikacije. To jest, u trenutku izdavanja nove verzije aplikacije, cron-zadatak je uspijevao pokrenuti se na dvije nodove, preuzimajući novu sliku iz docker registry-a, i tako su dvije nodove dobile veći konačni rezultat u odnosu na treću.
Kao što sam već spomenuo, u logovima ne vidimo informacije o procjeni politike ImageLocalityPriority, stoga smo, kako bismo provjerili svoju pretpostavku, preuzeli sliku s novom verzijom aplikacije na treću nodu, nakon čega je planiranje počelo ispravno funkcionirati. Također, problema s planiranjem uzrokovanog politikom ImageLocalityPriority bila je rijetka, češće je bila povezana s nečim drugim. Budući da nismo mogli potpuno debagirati svaku od politika u popisu prioritetā defoltnog kube-scheduler-a, javila se potreba za fleksibilnim upravljanjem politikama planiranja podova.
Postavljanje zadatka
Željeli smo da rješenje problema bude što preciznije, odnosno osnovni entiteti Kubernetes-a (u ovom slučaju se misli na defoltnog kube-scheduler-a) trebaju ostati nepromijenjeni. Nismo željeli rješavati problem na jednom mjestu i stvarati ga na drugom. Tako smo došli do dva rješenja problema koja su bila izložena u uvodu članka — stvaranje dodatnog scheduler-a ili pisanje vlastitog. Glavni zahtjev za planiranje cron-zadataka je ravnomjerno raspoređivanje opterećenja na tri node-a. Ovaj zahtjev može se zadovoljiti postojećim politikama kube-scheduler-a, stoga za rješenje naše zadaće nema smisla pisati vlastiti scheduler.
Upute za izradu i Deployment dodatnog kube-scheduler-a opisane su u . Međutim, smatramo da entiteti Deployment nisu dovoljni za osiguranje otpornosti na greške u radu tako kritične usluge kao što je kube-scheduler, stoga smo odlučili implementirati novi kube-scheduler kao Static Pod, o kojem će brinuti direktno Kubelet. Na taj način, naša nova kube-scheduler zatražit će sljedeće zahtjeve:
- Usluga treba biti implementirana kao Static Pod na svim masterima klastera
- Treba osigurati otpornost na greške u slučaju nedostupnosti aktivnog poda s kube-scheduler-om
- Glavni prioritet prilikom planiranja treba biti količina dostupnih resursa na nodu (LeastRequestedPriority)
Implementacija rješenja
Odmah treba napomenuti da ćemo sav rad raditi u Kubernetes v1.14.7, jer je upravo ova verzija korištena u projektu. Počet ćemo s pisanjem manifesta za naš novi kube-scheduler. Kao osnovu ćemo uzeti manifest defoltnog (/etc/kubernetes/manifests/kube-scheduler.yaml) i dovesti ga do sljedećeg oblika:
vrsta: Pod
metadata:
  oznake:
    komponenta: scheduler
    razina: kontrolna-ploča
  ime: kube-scheduler-cron
  prostor: kube-system
spec:
      kontejneri:
      - naredba:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        slika: gcr.io/google-containers/kube-scheduler:v1.14.7
        politikaPreuzimanjaSlike: AkoNijePrisutno
        livenessProbe:
          pragNeuspjeha: 8
          httpGet:
            host: 127.0.0.1
            putanja: /healthz
            port: 10151
            shema: HTTP
          inicijalnoKašnjenjeSekundi: 15
          vrijemeIstekanjaSekundi: 15
        ime: kube-scheduler-cron-container
        resursi:
          zahtjevi:
            cpu: '0.1'
        montažeVolumena:
        - putanjaMontaže: /etc/kubernetes/scheduler.conf
          ime: kube-config
          samoZaČitanje: true
        - putanjaMontaže: /etc/localtime
          ime: localtime
          samoZaČitanje: true
        - putanjaMontaže: /etc/kubernetes/scheduler-custom.conf
          ime: scheduler-config
          samoZaČitanje: true
        - putanjaMontaže: /etc/kubernetes/scheduler-custom-policy-config.json
          ime: policy-config
          samoZaČitanje: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumeni:
      - hostPath:
          putanja: /etc/kubernetes/scheduler.conf
          tip: FileOrCreate
        ime: kube-config
      - hostPath:
          putanja: /etc/localtime
        ime: localtime
      - hostPath:
          putanja: /etc/kubernetes/scheduler-custom.conf
          tip: FileOrCreate
        ime: scheduler-config
      - hostPath:
          putanja: /etc/kubernetes/scheduler-custom-policy-config.json
          tip: FileOrCreate
        ime: policy-config
Kratak pregled glavnih promjena:
- Promijenili smo ime poda i kontejnera u kube-scheduler-cron
- Postavili smo korištenje portova 10151 i 10159 jer je definirana opcija
hostNetwork: truei ne možemo koristiti iste portove kao defaultni kube-scheduler (10251 i 10259) - Pomoću parametra --config definirali smo datoteku konfiguracije s kojom bi servis trebao početi raditi
- Postavili smo montiranje datoteke konfiguracije (scheduler-custom.conf) i datoteke s pravilima zakazivanja (scheduler-custom-policy-config.json) s hosta
Ne zaboravimo da će našem kube-scheduleru biti potrebne privilegije slične onima koje ima defaultni. Uređujemo njegovu klastersku ulogu:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Sada razgovarajmo o tome što bi trebalo biti sadržano u datoteci s konfiguracijom i datoteci s pravilima zakazivanja:
- Datoteka konfiguracije (scheduler-custom.conf)
Za dobivanje konfiguracije defaultnog kube-scheduler-a potrebno je koristiti parametar--write-config-toiz . Dobivenu konfiguraciju stavit ćemo u datoteku /etc/kubernetes/scheduler-custom.conf i dovedemo je u sljedeći oblik:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Kratak pregled glavnih promjena:
- U schedulerName smo postavili ime našeg servisa kube-scheduler-cron.
- U parametru
lockObjectNametakođer je potrebno postaviti ime našeg servisa i osigurati da je parametarleaderElectpostavljen na true (ako imate samo jedan master čvor, možete postaviti false). - Odredili smo putanju do datoteke s opisom pravila zakazivanja u parametru
algorithmSource.
Treba se detaljnije osvrnuti na drugi odlazak, gdje uređujemo parametre za ključ leaderElection. Kako bismo osigurali otpornost na greške, aktivirali smo (leaderElect) proces izbora vođe (majstora) među podovima našeg kube-scheduler-a korištenjem zajedničkog endpoint-a (resourceLock) s imenom kube-scheduler-cron (lockObjectName) u prostoru imena kube-system (lockObjectNamespace). O tome kako Kubernetes osigurava visoku dostupnost glavnih komponenti (uključujući kube-scheduler) možete pročitati u .
- Datoteka pravila zakazivanja (scheduler-custom-policy-config.json)
Kao što sam ranije spomenuo — kako bismo saznali koja konkretna pravila koristi zadani kube-scheduler, možemo to učiniti samo analizirajući njegov kod. Dakle, ne možemo dobiti datoteku s pravilima zakazivanja za zadani kube-scheduler kao što imamo s datotekom konfiguracije. Opisat ćemo zanimljiva nam pravila zakazivanja u datoteci /etc/kubernetes/scheduler-custom-policy-config.json na sljedeći način:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Dakle, kube-scheduler prvo sastavlja popis nodova na koje se pod može planirati prema politici GeneralPredicates (koja uključuje skup politika PodFitsResources, PodFitsHostPorts, HostName i MatchNodeSelector). Zatim se svaka nod evaluira prema skupu politika u nizu priorities. Za ispunjenje zahtjeva naše zadaće smatrali smo da će takav skup politika biti optimalno rješenje. Podsjećam da je skup politika s njihovim detaljnim opisom dostupan u . Za izvršenje svoje zadaće možete jednostavno promijeniti skup korištenih politika i dodijeliti im odgovarajuće težine.
Manifest novog kube-scheduler-a, koji smo kreirali na početku poglavlja, nazvat ćemo kube-scheduler-custom.yaml i postaviti ga na sljedeći put /etc/kubernetes/manifests na tri master-noda. Ako je sve ispravno izvedeno, Kubelet na svakoj nodi pokrenut će pod, a u logovima našeg novog kube-scheduler-a vidjet ćemo informacije da je naš datoteka s politikama uspješno primijenjena:
Stvaranje planera iz konfiguracije: {{ } [{GeneralPredicates }] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 }]} [] 10 false}
Registracija predikata: GeneralPredicates
Tip predikata GeneralPredicates već registriran, ponovo se koristi.
Registracija prioriteta: ServiceSpreadingPriority
Tip prioriteta ServiceSpreadingPriority već registriran, ponovo se koristi.
Registracija prioriteta: EqualPriority
Tip prioriteta EqualPriority već registriran, ponovo se koristi.
Registracija prioriteta: LeastRequestedPriority
Tip prioriteta LeastRequestedPriority već registriran, ponovo se koristi.
Registracija prioriteta: NodePreferAvoidPodsPriority
Tip prioriteta NodePreferAvoidPodsPriority već registriran, ponovo se koristi.
Registracija prioriteta: NodeAffinityPriority
Tip prioriteta NodeAffinityPriority već registriran, ponovo se koristi.
Stvaranje planera s predikatima 'map[GeneralPredicates:{}]' i funkcijama prioriteta 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Sada ostaje samo naznačiti u spec-u naše CronJob da svi zahtjevi za planiranje njezinih podova trebaju obraditi naš novi kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Zaključak
Na kraju smo dobili dodatni kube-scheduler s jedinstvenim skupom politika planiranja, čiju aktivnost izravno nadzire kubelet. Osim toga, postavili smo izbore novog vođe između podova našeg kube-scheduler-a u slučaju da stari vođa iz bilo kojeg razloga postane nedostupan.
Uobičajene aplikacije i usluge i dalje se planiraju putem zadane kube-scheduler, dok su sve cron-zadatke u potpunosti premještene na novu verziju. Opterećenje stvoreno cron-zadacima sada se ravnomjerno raspoređuje među svim čvorovima. S obzirom na to da se veći dio cron-zadataka izvršava na istim čvorovima kao i glavne aplikacije projekta, ovo je značajno smanjilo rizik od seljenja podova zbog nedostatka resursa. Nakon implementacije dodatnog kube-scheduler-a, problemi s nerazmjernim planiranjem cron-zadataka više se nisu javljali.
Također pročitajte druge članke na našem blogu:
Izvor: habr.com
