

Najava
Kolege, sredinom ljeta planiram objaviti još jedan niz članaka o dizajniranju sustava masovne usluge: “Eksperiment VTrade” — pokušaj pisanja okvira za trgovačke sustave. U nizu će se razmatrati teorija i praksa izgradnje burze, aukcije i trgovine. Na kraju članka predlažem da glasate za teme koje vas najviše zanimaju.
Ovo je završni članak niza o distribuiranim reaktivnim aplikacijama na Erlangu/Elixiru. U može se pronaći teorijska osnova reaktivne arhitekture. ilustrira osnovne uzorke i mehanizme izgradnje sličnih sustava.
Danas ćemo razmotriti pitanja razvoja kodne baze i projekata u cjelini.
Organizacija servisa
U stvarnom životu, prilikom razvoja servisa često je potrebno spojiti nekoliko uzoraka interakcije u jednom kontroleru. Na primjer, servis users, koji rješava zadatke upravljanja profilima korisnika projekta, trebao bi odgovarati na zahtjeve req-resp i obavještavati o ažuriranjima profila putem pub-sub. Ovaj slučaj je prilično jednostavan: iza messaginga stoji jedan kontroler koji implementira logiku servisa i objavljuje ažuriranja.
Situacija se komplikuje kada trebamo realizirati otporan distribuirani servis. Zamislite da su se zahtjevi za users promijenili:
- sada servis treba obraditi zahtjeve na 5 čvorova klastera,
- imati mogućnost izvršavanja pozadinskih zadataka obrade,
- kao i imati mogućnost dinamičkog upravljanja popisima pretplate na ažuriranja profila.
Napomena: Pitanje konzistentnog pohranjivanja i replike podataka ne razmatramo. Pretpostavljamo da su ta pitanja ranije riješena i da sustav već ima pouzdan i skalabilan sloj pohrane, a procesori imaju mehanizme interakcije s njim.
Formalni opis servisa users postao je složeniji. S programerskog stajališta, zahvaljujući korištenju messaginga, promjene su minimalne. Da bismo zadovoljili prvi zahtjev, trebamo postaviti balansiranje na točki izmjene req-resp.
Zahtev za obradu pozadinskih zadataka često se javlja. U korisnicima, to mogu biti provere dokumenata korisnika, obrada učitanih multimedijalnih sadržaja ili sinhronizacija podataka sa društvenim mrežama. Ove zadatke treba nekako raspodeliti unutar klastera i kontrolisati tok izvršenja. Stoga imamo dve opcije rešenja: ili koristiti šablon raspodele zadataka iz prethodnog članka, ili, ako to ne odgovara, napisati prilagođeni planer zadataka koji će upravljati grupom obrtnika na način koji nam je potreban.
3. tačka zahteva proširenje pub-sub šablona. Nakon kreiranja tačke razmene pub-sub, moramo dodatno pokrenuti kontroler te tačke u okviru našeg servisa. Na taj način kao da iznosimo logiku obrade pretplate i otplate iz sloja poruka u implementaciju korisnika.
Na kraju, dekompozicija zadatka pokazala je da, da bismo ispunili zahteve, treba da pokrenemo 5 instanci servisa na različitim čvorovima i stvorimo dodatnu entitet - kontroler pub-sub, odgovoran za pretplatu.
Za pokretanje 5 obrtnika nije potrebno menjati kod servisa. Jedina dodatna akcija je konfiguracija pravila balansiranja na tački razmene, o čemu ćemo govoriti malo kasnije.
Pojavila se dodatna složenost: kontroler pub-sub i prilagođeni planer zadataka treba da rade u jednom jedinom primeru. Ponovo, servis za razmenu poruka, kao fundamentalni, treba da obezbedi mehanizam izbora lidera.
Izbor lidera
U distribuiranim sistemima, izbor lidera je procedura imenovanja jedinog procesa koji je odgovoran za planiranje distribuirane obrade nekog opterećenja.
U sistemima koji nisu skloni centralizaciji, koriste se univerzalni algoritmi i algoritmi zasnovani na konsenzusu, kao što su paxos ili raft.
Budući da je razmena poruka – broker i centralna tačka, ona zna o svim kontrolerima servisa – kandidatima za lidere. Razmena poruka može imenovati lidera bez glasanja.
Svi servisi nakon pokretanja i povezivanja sa tačkom razmene dobijaju sistemsku poruku #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. U slučaju da LeaderPid se podudara sa pid trenutnog procesa, on se imenuje liderom, a lista Servers sadrži sve čvorove i njihove parametre.
Kada se novi čvor klastera pojavi i radni čvor isključi, svi kontroleri servisa primaju #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} i #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} odgovarajuće.
Tako svi komponenti znaju o svim promjenama, a u klasteru je u svakoj trenutku zajamčen jedan lider.
Posrednici
Za realizaciju složenih distribuiranih procesa obrade, kao i u zadacima optimizacije postojeće arhitekture, prikladno je koristiti posrednike.
Kako bismo izbjegli promjenu koda servisa i riješili, na primjer, zadatke dodatne obrade, usmjeravanja ili logiranja poruka, ispred servisa možemo uključiti proxy obrtnika koji će izvršiti sav dodatni posao.
Klasični primjer optimizacije pub-sub je distribuirana aplikacija s poslovnim jezgrima koja generiraju događaje ažuriranja, kao što je promjena cijene na tržištu, i sloj pristupa - N servera koji pružaju websocket API za web klijente.
Ako se stvari rješavaju direktno, usluga klijenta izgleda ovako:
- klijent uspostavlja veze s platformom. Na strani servera, koja terminira promet, pokreće se proces koji opslužuje tu vezu.
- unutar opslužnog procesa događa se autorizacija i pretplata na ažuriranja. Proces poziva metodu subscribe za teme.
- nakon generiranja događaja u jezgri, on se isporučuje procesima koji opslužuju veze.
Zamislimo da imamo 50000 pretplatnika na temu “news”. Pretplatnici su ravnomjerno raspoređeni po 5 servera. Kao rezultat, svako ažuriranje koje stigne na točku razmjene bit će replicirano 50000 puta: 10000 puta na svakom serveru, prema broju pretplatnika na njemu. Nije baš učinkovita shema, zar ne?
Kako bismo poboljšali situaciju, uvest ćemo proxy s istim imenom kao točka razmjene. Registar globalnih imena trebao bi moći vraćati najbliži proces po imenu, što je važno.
Pokrenut ćemo ovaj proxy na serverima sloja pristupa, i svi naši procesi koji opslužuju websocket API će se pretplatiti na njega, a ne na izvorno pub-sub točku razmjene u jezgri. Proxy se pretplaćuje na jezgru samo u slučaju jedinstvene pretplate i replicira primljenu poruku svim svojim pretplatnicima.
Kao rezultat, između jezgre i pristupnih servera bit će proslijeđeno 5 poruka, umjesto 50000.
Usmjeravanje i balansiranje
Req-Resp
U trenutnoj implementaciji messaging sustava postoji 7 strategija raspodjele zahtjeva:
default. Upit se šalje svim kontrolerima.round-robin. Održiv je obilazak i ciklična raspodjela upita između kontrolera.consensus. Kontroleri koji opslužuju servis dijele se na vođu i vođene. Upiti se šalju samo vođi.consensus & round-robin. U grupi postoji vođa, ali se upiti raspoređuju između svih članova.sticky. Izračunava se hash funkcija i pridružuje određenom obrađivaču. Sljedeći upiti s tom potpisom dolaze do istog obrađivača.sticky-fun. Prilikom inicijalizacije točke razmjene dodatno se prenosi funkcija za izračun hash-a zastickybalansiranje.fun. Sličan je sticky-fun, ali je moguće dodatno preusmjeriti, odbiti ili prethodno obraditi.
Strategija raspodjele postavlja se prilikom inicijalizacije točke razmjene.
Osim balansiranja, messaging omogućava označavanje entiteta. Razmotrite vrste oznaka u sustavu:
- Oznaka za povezivanje. Omogućava razumijevanje kako su događaji stigli preko povezivanja. Koristi se kada se proces kontrolera povezuje na jednu točku razmjene, ali s različitim ključevima usmjeravanja.
- Oznaka servisa. Omogućava grupiranje obrađivača za jedan servis i proširuje mogućnosti usmjeravanja i balansiranja. Za req-resp obrazac usmjeravanje je linearno. Šaljemo upit na točku razmjene, a zatim ga ona prosljeđuje servisu. No, ako trebamo podijeliti obrađivače u logičke grupe, to se ostvaruje pomoću oznaka. Kada se označi oznaka, upit će biti poslan konkretnoj grupi kontrolera.
- Oznaka upita. Omogućava razlikovanje odgovora. Budući da je naš sustav asinkroni, za obradu odgovora servisa potrebno je imati mogućnost navesti RequestTag prilikom slanja upita. Prema toj oznaci moći ćemo razumjeti na koji je upit stigao odgovor.
Pub-sub
Za pub-sub je sve malo jednostavnije. Imamo točku razmjene na koju se objavljuju poruke. Točka razmjene raspoređuje poruke između pretplatnika koji su se pretplatili na potrebne ključeve usmjeravanja (može se reći da je to analogno temama).
Skalabilnost i otpornost na greške
Skalabilnost sustava u cjelini ovisi o stupnju skalabilnosti slojeva i komponenti sustava:
- Usluge se skaliraju dodavanjem dodatnih čvorova sa procesorima te usluge u klaster. Tijekom eksperimentalnog rada može se odabrati optimalna politika uravnoteženja.
- Sama usluga messaging u okviru zasebnog klastera obično se skalira ili premještanjem posebno opterećenih točaka razmjene na zasebne čvorove klastera, ili dodavanjem proxy procesa u posebno opterećena područja klastera.
- Skalabilnost cijelog sustava kao karakteristika ovisi o fleksibilnosti arhitekture i mogućnosti spajanja pojedinih klastera u cjelovitu logičku cjelinu.
Jednostavnost i brzina skaliranja često utječu na uspješnost projekta. Messaging u trenutnom obliku raste zajedno s aplikacijom. Čak i ako nemamo dovoljno klastera od 50-60 strojeva, možemo pribjeći federaciji. Nažalost, tema federacije izlazi iz okvira ovog članka.
Sigurnosna kopija
Pri analizi uravnoteženja opterećenja već smo raspravljali o rezervaciji kontrolera usluga. Međutim, messaging također mora biti rezerviran. U slučaju pada čvora ili stroja, messaging se mora automatski oporaviti u najkraćem mogućem roku.
U svojim projektima koristim dodatne čvorove koji preuzimaju opterećenje u slučaju pada. U Erlangu postoji standardna implementacija distribuiranog načina rada za OTP aplikacije. Distribuirani način rada zapravo provodi oporavak u slučaju kvara pokretanjem pao aplikacije na drugom prethodno pokrenutom čvoru. Proces je transparentan, nakon kvara aplikacija se automatski prebacuje na failover čvor. O ovom funkcionalnosti možete pročitati više. .
Performanse
Pokušajmo barem približno usporediti performanse rabbitmq i naše prilagođene messaging usluge.
Pronašao sam testiranja rabbitmq od tima openstack.
U točki 6.14.1.2.1.2.2. originalnog dokumenta predstavljeni su rezultati RPC CAST:
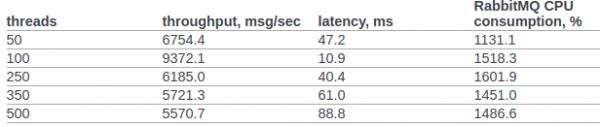
Preliminarno, nikakve dodatne postavke u kernel OS-a ili erlang VM nećemo unositi. Uvjeti za testiranje:
- erl opts: +A1 +sbtu.
- Test u okviru jednog čvora erlang pokreće se na prijenosnom računalu sa starim i7 mobilnim procesorom.
- Klaster testovi se provode na serverima sa 10G mrežom.
- Kod radi u docker kontejnerima. Mreža je u NAT režimu.
Kod testa:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenarij 1: Test se pokreće na prijenosnom računalu s starijim i7 mobilnim procesorom. Test, messaging i servis rade na jednoj instanci unutar jednog docker kontejnera:
Sekvencijalno 10000 ciklusa u ~0 sekundi (26987 ciklusa/s)
Sekvencijalno 20000 ciklusa u ~1 sekundi (26915 ciklusa/s)
Sekvencijalno 100000 ciklusa u ~4 sekundi (26957 ciklusa/s)
Paralelno 2 100000 ciklusa u ~2 sekundi (44240 ciklusa/s)
Paralelno 4 100000 ciklusa u ~2 sekundi (53459 ciklusa/s)
Paralelno 10 100000 ciklusa u ~2 sekundi (52283 ciklusa/s)
Paralelno 100 100000 ciklusa u ~3 sekundi (49317 ciklusa/s)
Scenarij 2: 3 čvora pokrenuta na različitim strojevima pod dockerom (NAT).
Sekvencijalno 10000 ciklusa u ~1 sekundi (8684 ciklusa/s)
Sekvencijalno 20000 ciklusa u ~2 sekundi (8424 ciklusa/s)
Sekvencijalno 100000 ciklusa u ~12 sekundi (8655 ciklusa/s)
Paralelno 2 100000 ciklusa u ~7 sekundi (15160 ciklusa/s)
Paralelno 4 100000 ciklusa u ~5 sekundi (19133 ciklusa/s)
Paralelno 10 100000 ciklusa u ~4 sekundi (24399 ciklusa/s)
Paralelno 100 100000 ciklusa u ~3 sekundi (34517 ciklusa/s)
U svim slučajevima, iskorištenje CPU-a nije prelazilo 250%
Zaključci
Nadam se da ovaj ciklus ne izgleda kao otpad svijesti i da će moje iskustvo pružiti stvarnu korist istraživačima distribuiranih sustava i praktičarima koji su na samom početku izgradnje distribuiranih arhitektura za svoje poslovne sustave i s interesovanjem gledaju na Erlang/Elixir, ali sumnjaju vrijedi li ...
Fotografija
Samo registrirani korisnici mogu sudjelovati u anketi. , molimo.
Koje teme bih trebao detaljno obraditi u okviru ciklusa "Eksperiment VTrade"?
Teorija: Tržišta, nalogi i vrijeme njihovog trajanja: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Knjiga naloga. Teorija i praksa implementacije knjige s grupama
Vizualizacija trgovanja: Tikovi, barovi, rezolucije. Kako pohranjivati i kako povezivati
Backoffice. Planiranje i razvoj. Kontrola zaposlenika i istraga incidenata
API. Istražujemo koje su sučelja potrebna i kako ih implementirati
Pohrana informacija: PostgreSQL, Timescale, Tarantool u trgovačkim sustavima
Reaktivnost u trgovačkim sustavima
Drugo. Napisat ću u komentarima
Glasovalo je 6 korisnika. 4 korisnika se suzdržalo.
Izvor: habr.com
