

Uvod
U ovom članku ću govoriti o poznatom Huffmanovom algoritmu i njegovoj primjeni u kompresiji podataka.
Na kraju ćemo napisati jednostavni arhiver. O tome je već bilo , ali bez praktične implementacije. Teorijski materijal trenutnog posta preuzet je iz školskih časova informatike i knjige Roberta Laforea „Podaci i algoritmi u Javi“. Dakle, sve pod kat!
Malo razmišljanja
U običnom tekstualnom fajlu jedan znak se kodira s 8 bitova (ASCII kodiranje) ili 16 (Unicode kodiranje). Dalje ćemo razmatrati ASCII kodiranje. Kao primjer uzeću string s1 = "SUSIE SAYS IT IS EASYn". Ukupno u stringu ima 22 znaka, prirodno, uključujući razmake i simbol prelaska u novu liniju — ‘n’. Fajl koji sadrži ovaj string će težiti 22*8 = 176 bitova. Odmah se postavlja pitanje: je li racionalno koristiti svih 8 bitova za kodiranje 1 znaka? Mi ne koristimo sve znakove ASCII kodiranja. Čak i kada bismo koristili, racionalnije bi bilo najčešćem znaku — S — dati najkraći mogući kod, a za najrjeđi znak — T (ili U, ili ‘n’) — dati duži kod. U tome se sastoji Huffmanov algoritam: potrebno je pronaći optimalnu varijantu kodiranja, pri kojoj će fajl biti minimalne težine. Sasvim je normalno da različiti znakovi imaju različite dužine koda — na tome se temelji algoritam.
Kodiranje
Zašto ne dati znaku ‘S’ kod, na primjer, dužine 1 bit: 0 ili 1. Neka to bude 1. Tada drugom najčešćem znaku — ‘ ‘ (razmak) — dajemo 0. Zamislite, počeli ste dekodirati svoju poruku — kodirani string s1 — i vidite da kod počinje s 1. Pa, šta učiniti: je li to znak S, ili je to neki drugi znak, na primjer A? Zato se javlja važno pravilo:
Nijedan kod ne smije biti prefiks drugog
Ovo pravilo je ključno u algoritmu. Stoga, kreiranje koda počinje s tablicom frekvencija, u kojoj je navedena frekvencija (broj pojavljivanja) svakog znaka:
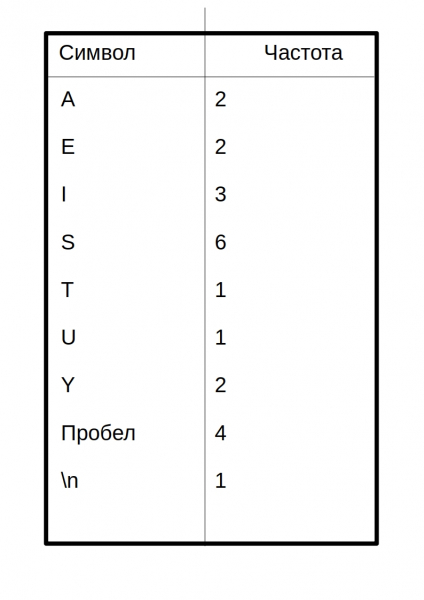 Znakovi s najvećim brojem pojavljivanja trebaju se kodirati najmanjim mogućim brojem bitova. Navest ću primjer jedne od mogućih tablica kodova:
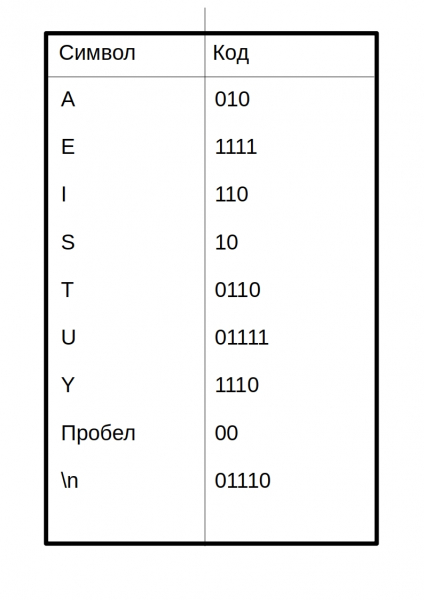 Dakle, kodirana poruka će izgledati ovako:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Kod svakog znaka sam razdvojio razmakom. U stvarnosti u komprimiranom fajlu toga neće biti!
Postavlja se pitanje: kako je ovaj početnik smislio kod za stvaranje tablice kodova? O tome će biti riječi u nastavku.
Izgradnja Huffmanovog stabla
Ovdje na scenu stupa binarno stablo pretraživanja. Ne brinite, ovdje metode pretraživanja, umetanja i brisanja nisu potrebne. Evo struktura stabla na Javi:
public class Node {
    private int frekvencija;
    private char slovo;
    private Node lijeviDijete;
    private Node desniDijete;
    ...
}
class BinaryTree {
    private Node korijen;

    public BinaryTree() {
        korijen = new Node();
    }
    public BinaryTree(Node korijen) {
        this.korijen = korijen;
    }
    ...
}
Ovo nije potpuni kod, potpuni kod će biti ispod.
Evo samog algoritma za izgradnju stabla:
- Stvorite objekt Node za svaki znak iz poruke (niz s1). U našem slučaju bit će 9 čvorova (objekata Node). Svaki čvor se sastoji od dva podatkovna polja: znak i frekvencija.
- Stvorite objekt Stabla (BinaryTree) za svaki od čvorova Node. Čvor postaje korijen stabla.
- Umetnite ta stabla u prioritetnu red. Što je manja frekvencija, to je veći prioritet. Tako, prilikom vađenja, uvijek se odabire stablo s najmanjom frekvencijom.
Nakon toga, potrebno je ciklično izvesti sljedeće:
- Izvadite dva stabla iz prioritetne queue i učinite ih potomcima novog čvora (baš novog čvora bez slova). Frekvencija novog čvora jednaka je zbroju frekvencija dva stabla potomka.
- Za ovaj čvor stvorite stablo s korijenom u ovom čvoru. Umetnite ovo stablo natrag u prioritetnu queue. (Budući da stablo ima novu frekvenciju, vjerojatno će zauzeti novo mjesto u redu.)
- Nastavite provoditi korake 1 i 2, sve dok u redu ne ostane jedno stablo — Huffmanovo stablo.
Razmotrite ovaj algoritam na nizu s1:
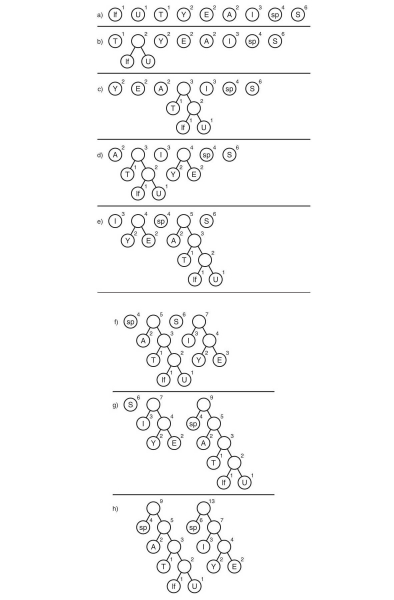
Ovdje simbol "lf" (linefeed) označava prijelaz u novi red, "sp" (space) — to je razmak.
Što dalje?
Dobili smo Huffmanovo stablo. Pa dobro. I što sada s njim? Čak ga ni besplatno ne bi uzeli. A zatim treba pratiti sve moguće putove od korijena do listova stabla. Dogovorimo se označiti rub 0, ako vodi lijevom potomku, i 1 — ako desnom. Strogo govoreći, u ovim oznakama, kod znaka — to je put od korijena stabla do lista koji sadrži taj određeni znak.
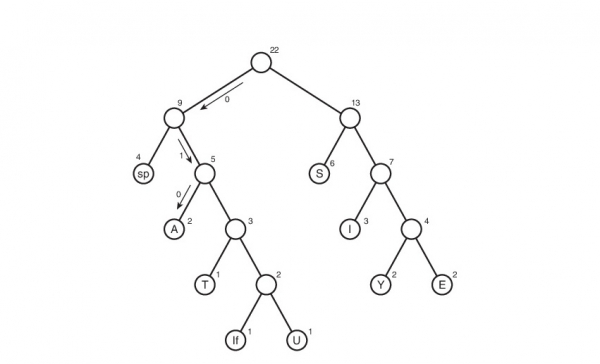
Tako je nastala tablica kodova. Primijetimo da, ako pogledamo ovu tablicu, možemo izvesti zaključak o "težini" svakog simbola — to je dužina njegovog koda. Tada će izvorna datoteka u komprimiranoj verziji težiti: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bita. Isprva je težila 176 bita. Dakle, smanjili smo je čak 176/65 = 2.7 puta! Ali to je utopija. Takav koeficijent teško da ćemo dobiti. Zašto? O tome će biti riječi malo kasnije.
Dekodiranje
Pa, valjda je ostalo najjednostavnije — dekodiranje. Mislim da su mnogi od vas shvatili da jednostavno stvaranje komprimirane datoteke bez ikakvih naznaka kako je ona kodirana nije moguće — neće moći dekodirati! Da, bilo mi je teško to shvatiti, ali morat ćemo stvoriti tekstualnu datoteku table.txt s tablicom kompresije:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Zapisivanje tablice u obliku ‘simbol’«kod simbola». Zašto 01110 bez simbola? U stvarnosti on ima simbol, samo sredstva java koja koristim pri ispravnom ispisu u datoteku pretvaraju simbol prijelaza na novu liniju — ‘n’ u prijelaz na novu liniju (koliko god to glupo zvučalo). Stoga je prazna linija iznad zapravo simbol za kod 01110. Za kod 00 simbol je razmak na početku linije. Odmah ću reći da je naš koeficijent gotov — ovaj način pohranjivanja tablice može se smatrati najneracionalnijim. No, jednostavan je za razumijevanje i implementaciju. Rado ću čuti vaše preporuke u komentarima o optimizaciji.
Imajući ovu tablicu, dekodiranje je vrlo jednostavno. Podsjetimo se kojim pravilom smo se vodili prilikom stvaranja kodiranja:
Nijedan kod ne smije biti prefiks drugog
Tu on igra olakšavajuću ulogu. Čitamo redom bit po bit i, čim dobijena niz d, sastavljen od pročitane bitova, odgovara kodiranju koje odgovara simbolu karaktera, odmah znamo da je kodiran simbol karaktera (i samo on!). Zatim zapisujemo karakter u dekodiranu niz (niz koji sadrži dekodiranu poruku), brišemo niz d, i nastavljamo s čitanjem kodirane datoteke.
Implementacija
Došlo je vrijeme da ponizim svoj kod i napišem arhivator. Nazvat ćemo ga Compressor.
Započnimo od početka. Prvo pišemo klasu Node:
javna klasa Čvor {
    privatni int frekvencija; // frekvencija
    privatni char slovo; // slovo
    privatni Čvor lijeviDijete; // lijevo dijete
    privatni Čvor desniDijete; // desno dijete


    javni Čvor(char slovo, int frekvencija) { // zapravo, konstruktor
        this.slovo = slovo;
        this.frekvencija = frekvencija;
    }

    javni Čvor() {} // preopterećenje konstruktora za bezimenog čvora (vidi iznad u dijelu o građenju Huffmanovog stabla)
    javni void dodajDijete(Čvor novoDijete) { // dodati dijete
        ako (lijeviDijete == null) // ako je lijevi prazan => desni također => dodajemo u lijevi
            lijeviDijete = novoDijete;
        else {
            ako (lijeviDijete.getFrekvenciju() <= novoDijete.getFrekvenciju()) // općenito, lijevim djetetom
                desniDijete = novoDijete; // postat će onaj s manjom frekvencijom
            else {
                desniDijete = lijeviDijete;
                lijeviDijete = novoDijete;
            }
        }

        frekvencija += novoDijete.getFrekvenciju(); // konačna frekvencija
    }

    javni Čvor getLijepoDijete() {
        return lijeviDijete;
    }

    javni Čvor getDesnoDijete() {
        return desniDijete;
    }

    javni int getFrekvenciju() {
        return frekvencija;
    }

    javni char getSlovo() {
        return slovo;
    }

    javni boolean jeList() { // provjera je li list
        return lijeviDijete == null && desniDijete == null;
    }
}
Sada stablo:
klasa BinarnoStablo {
    privatni Čvor korijen;

    javno BinarnoStablo() {
        korijen = new Čvor();
    }

    javno BinarnoStablo(Čvor korijen) {
        this.korijen = korijen;
    }

    javni int getFrekvenciju() {
        return korijen.getFrekvenciju();
    }

    javni Čvor getKorijen() {
        return korijen;
    }
}
Prioritetna redoslijed:
import java.util.ArrayList; // da-da, red će biti na bazi liste

klasa PrioritetnaRed {
    privatni ArrayList podaci; // lista reda
    privatni int nElem; // broj elemenata u redu

    javna PrioritetnaRed() {
        podaci = new ArrayList();
        nElem = 0;
    }

    javni void umetni(BinarnoStablo novoStablo) { // umetanje
        ako (nElem == 0)
            podaci.add(novoStablo);
        else {
            za (int i = 0; i  novoStablo.getFrekvenciju()) { // ako je frekvencija umetnutog stabla manja
                    podaci.add(i, novoStablo); // nego trenutna frekvencija, pomičemo sva stabla na desnoj strani za 1 ćeliju
                    break; // zatim stavljamo novo stablo na poziciju trenutnog
                }
                ako (i == nElem - 1)
                    podaci.add(novoStablo);
            }
        }
        nElem++; // povećavamo broj elemenata za 1
    }

    javni BinarnoStablo ukloni() { // uklanjanje iz reda
        BinarnoStablo tmp = podaci.get(0); // kopiramo uklanjani element
        podaci.remove(0); // zapravo, uklanjamo
        nElem--; // smanjujemo broj elemenata za 1
        return tmp; // vraćamo uklonjeni element (element s najmanjom frekvencijom)
    }
}
Klasa koja stvara Huffmanovo stablo:
javna klasa HuffmanTree {
    private final byte VELIČINA_TABELA_KODIRANJA = 127; // dužina kodne tabele
    private String mojString; // poruka
    private BinaryTree huffmanTree; // Huffmanovo stablo
    private int[] nizFrekvencija; // frekventna tabela
    private String[] nizKodiranja; // kodna tabela


    //----------------konstruktor----------------------
    public HuffmanTree(String noviString) {
        mojString = noviString;

        nizFrekvencija = new int[VELIČINA_TABELA_KODIRANJA];
        popuniNizFrekvencija();

        huffmanTree = dobaviHuffmanTree();

        nizKodiranja = new String[VELIČINA_TABELA_KODIRANJA];
        popuniNizKodiranja(huffmanTree.getRoot(), "", "");
    }

    //--------------------frekventni niz------------------------
    private void popuniNizFrekvencija() {
        for (int i = 0; i < mojString.length(); i++) {
            nizFrekvencija[(int)mojString.charAt(i)]++;
        }
    }

    public int[] getNizFrekvencija() {
        return nizFrekvencija;
    }

    //------------------------kreiranje huffmanovog stabla------------------
    private BinaryTree dobaviHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritam opisan iznad
        for (int i = 0; i < VELIČINA_TABELA_KODIRANJA; i++) {
            if (nizFrekvencija[i] != 0) { // ako simbol postoji u stringu
                Node noviNode = new Node((char) i, nizFrekvencija[i]); // kreirati Node za njega
                BinaryTree novoStablo = new BinaryTree(noviNode); // a za Node kreirati BinaryTree
                pq.insert(novoStablo); // umetnuti u red
            }
        }

        while (true) {
            BinaryTree stablo1 = pq.remove(); // izvući prvo stablo iz reda.

            try {
                BinaryTree stablo2 = pq.remove(); // izvući drugo stablo iz reda

                Node noviNode = new Node(); // kreirati novi Node
                noviNode.addChild(stablo1.getRoot()); // učiniti da su potomci dva izvučena stabla
                noviNode.addChild(stablo2.getRoot());

                pq.insert(new BinaryTree(noviNode));
            } catch (IndexOutOfBoundsException e) { // ostalo je samo jedno stablo u redu
                return stablo1;
            }
        }
    }

    public BinaryTree getStablo() {
        return huffmanTree;
    }

    //-------------------niz kodiranja------------------
    void popuniNizKodiranja(Node node, String kodPre, String smer) { // popuniti kodnu tabelu
        if (node.isLeaf()) {
            nizKodiranja[(int)node.getLetter()] = kodPre + smer;
        } else {
            popuniNizKodiranja(node.getLeftChild(), kodPre + smer, "0");
            popuniNizKodiranja(node.getRightChild(), kodPre + smer, "1");
        }
    }

    String[] getNizKodiranja() {
        return nizKodiranja;
    }

    public void prikaziNizKodiranja() { // za debagovanje
        popuniNizKodiranja(huffmanTree.getRoot(), "", "");

        System.out.println("======================Tabela kodova====================");
        for (int i = 0; i < VELIČINA_TABELA_KODIRANJA; i++) {
            if (nizFrekvencija[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(nizKodiranja[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return mojString;
    }
}
Klasa koja sadrži kod koji kodira/dekodira:
public class HuffmanOperator {
    private final byte VELIČINA_TABELA_KODIRANJA = 127; // dužina tabele
    private HuffmanTree glavnoHuffmanStablo; // Huffmanovo stablo (koristi se samo za kompresiju)
    private String mojaPoruka; // izvorna poruka
    private int[] frekventniNiz; // frekventna tabela
    private String[] nizKodiranja; // kodirajuća tabela
    private double odnos; // koeficijent kompresije


    public HuffmanOperator(HuffmanTree GlavnoHuffmanStablo) { // za kompresiju
        this.glavnoHuffmanStablo = GlavnoHuffmanStablo;

        mojaPoruka = glavnoHuffmanStablo.getOriginalString();

        nizKodiranja = glavnoHuffmanStablo.getEncodingArray();

        frekventniNiz = glavnoHuffmanStablo.getFrequenceArray();
    }

    public HuffmanOperator() {} // za vađenje;

    // ---------------------------------------kompresija-----------------------------------------------------------
    private String getCompressedString() {
        String komprimirana = "";
        String međuznanje = ""; // međuznačna string (bez dodatnih nula)
        // System.out.println("=============================Kompresija=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // potrebno je dodati nule na kraj (može 1, nije važno)
        byte brojač = 0; // broj dodatih nula na kraju (bajt je sasvim dovoljan: 0 <= brojač < 8 < 127)
        for (int dužina = međuznanje.length(), delta = 8 - dužina % 8;
            brojač < delta; brojač++) { // delta - broj dodatih nula
            međuznanje += "0";
        }

        // spojiti broj dodatih nula u binarnom prikazu i međuznačnu stringu
        komprimirana = String.format("%8s", Integer.toBinaryString(brojač & 0xff)).replace(" ", "0") + međuznanje;

        // idealizovani koeficijent
        setCompressionRatio();
        // System.out.println("===============================================================");
        return komprimirana;
    }

    private void setCompressionRatio() { // izračunati idealizovani koeficijent
        double sumaA = 0, sumaB = 0; // A - izvorna suma
        for (int i = 0; i < VELIČINA_TABELA_KODIRANJA; i++) {
            if (frekventniNiz[i] != 0) {
                sumaA += 8 * frekventniNiz[i];
                sumaB += nizKodiranja[i].length() * frekventniNiz[i];
            }
        }
        odnos = sumaA / sumaB;
    }

    public byte[] getBytedMsg() { // finalna kompresija
        StringBuilder komprimiranaPoruka = new StringBuilder(getCompressedString());
        byte[] komprimiraniBajtovi = new byte[komprimiranaPoruka.length() / 8];
        for (int i = 0; i < komprimiraniBajtovi.length; i++) {
            komprimiraniBajtovi[i] = (byte) Integer.parseInt(komprimiranaPoruka.substring(i * 8, (i + 1) * 8), 2);
        }
        return komprimiraniBajtovi;
    }
    // ---------------------------------------kraj kompresije----------------------------------------------------------------
    // ------------------------------------------------------------vađenje-----------------------------------------------------
    public String extract(String komprimirani, String[] noviNizKodiranja) {
        String dekomprimirana = "";
        String trenutni = "";
        String delta = "";
        nizKodiranja = noviNizKodiranja;

        // displayEncodingArray();
        // dobiti broj umetnutih nula
        for (int i = 0; i < 8; i++)
            delta += komprimirani.charAt(i);
        int DODATE_NULA = Integer.parseInt(delta, 2);

        for (int i = 8, l = komprimirani.length() - DODATE_NULA; i < l; i++) {
            // i = 8, jer prvi bajt označava broj umetnutih nula
            trenutni += komprimirani.charAt(i);
            for (int j = 0; j < VELIČINA_TABELA_KODIRANJA; j++) {
                if (trenutni.equals(nizKodiranja[j])) { // ako se poklapa
                    dekomprimirana += (char)j; // dodajemo element
                    trenutni = ""; // i resetujemo trenutnu stringu
                }
            }
        }

        return dekomprimirana;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < nizKodiranja.length; i++) {
            if (frekventniNiz[i] != 0)
                enc += (char)i + nizKodiranja[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return odnos;
    }


    public void displayEncodingArray() { // za debagovanje
        System.out.println("======================Tabela kodiranja====================");
        for (int i = 0; i < VELIČINA_TABELA_KODIRANJA; i++) {
            // if (frekventniNiz[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(nizKodiranja[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Klasa koja olakšava pisanje u datoteku:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Neispravna putanja ili datoteka ne postoji!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Klasa koja olakšava čitanje iz datoteke:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) //ako je datoteka završena
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
I glavni razred:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // указujemo instrukciju pomoću argumenata iz komandne linije
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Neispravan format ulaza argumenata ");
            System.out.println("Pročitajte Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Neispravan put, ili takav fajl ne postoji!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Trenutna kodiranje fajla nije podržana");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // create file with encoding table:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Put do kompresovanog fajla: " + compressedFile.getAbsolutePath());
        System.out.println("Put do kodiranja tabele " + table.getAbsolutePath());
        System.out.println("Bez tabele fajl neće moći da se izvuče!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // idealizovani koeficijent
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // pravi koeficijent

        System.out.println("Idealizovani koeficijent kompresije je " + idealRatio);
        System.out.println("Koeficijent kompresije uzimajući u obzir kodirajuću tabelu " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // read compressed file
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! check here:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // method returns EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // read encoding table:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // skip first empty string
        	encodingArray[(byte)'n'] = fi.readLine(); // read code for 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // extract:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Put do raspakovanog fajla " + extractedFile.getAbsolutePath());
    }
}
Datoteku s uputama readme.txt morate napisati sami 🙂
Zaključak
Možda je to sve što sam htio reći. Ako imate što za reći o mojoj nesposobnosti da unaprijedim kod, algoritam ili bilo koju optimizaciju, slobodno pišite. Ako nešto nisam dovoljno objasnio, također pišite. Bit ću sretan čuti vas u komentarima!
P.S.
Da-da, još sam ovdje, jer nisam zaboravio na omjer. Za niz s1, kodna tablica teži 48 bajtova — mnogo više od izvorne datoteke, a ni na dodatne nule nismo zaboravili (broj dodanih nula jednak je 7) => omjer kompresije bit će manji od jedan: 176/(65 + 48*8 + 7)=0.38. Ako ste to isto primijetili, samo nemojte izgledati previše pametno. Da, ova implementacija bit će izrazito neučinkovita za male datoteke. No što se događa s velikim datotekama? Veličine datoteka mnogo nadmašuju veličinu kodne tablice. Ovdje algoritam radi kako treba! Na primjer, za arhivator daje stvarni (ne idealizirani) omjer, koji iznosi 1.46 — gotovo jedan i pol puta više! I da, pretpostavilo se da će datoteka biti na engleskom jeziku.
Izvor: habr.com
