

Dobar dan! Zovem se Danil Lipovoy, naš tim u Sbertechu počeo je koristiti HBase kao skladište operativnih podataka. Tijekom njegovog istraživanja stekli smo iskustvo koje želimo sistematizirati i opisati (nadamo se da će mnogima biti korisno). Svi eksperimenta navedeni u nastavku provedeni su s verzijama HBase 1.2.0-cdh5.14.2 i 2.0.0-cdh6.0.0-beta1.
- Sveobuhvatna arhitektura
- Upis podataka u HBASE
- Čitanje podataka iz HBASE
- Keširanje podataka
- Batch obrada podataka MultiGet/MultiPut
- Strategija dijeljenja tablica na regije (splitting)
- Otpornost na greške, kompaktiranje i lokalnost podataka
- Postavke i performanse
- Testiranje opterećenja
- Zaključci
1. Sveobuhvatna arhitektura
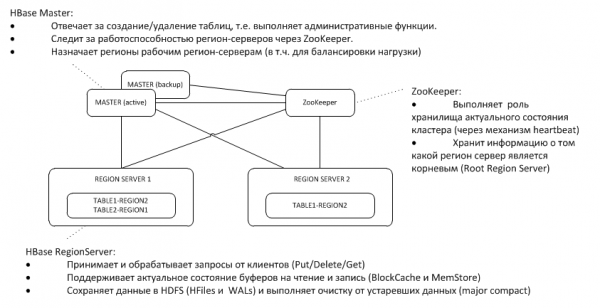
Rezervni Master sluša heartbeat aktivnog na čvoru ZooKeeper i u slučaju nestanka preuzima funkcije mastera.
2. Upis podataka u HBASE
Prvo razmotrite najjednostavniji slučaj – upis objekta ključ-vrijednost u neku tablicu koristeći put(rowkey). Klijent prvo mora otkriti gdje se nalazi korijenski regijski poslužitelj (Root Region Server - RRS), koji pohranjuje tablicu hbase:meta. Te informacije dobiva od ZooKeepera. Nakon toga obraća se RRS-u i čita tablicu hbase:meta, iz koje izdvaja informacije o tome koji RegionServer (RS) odgovara za pohranu podataka po zadanom ključu rowkey u tablici koja ga zanima. U svrhu daljnje upotrebe, meta-tablica se kešira od strane klijenta, stoga su sljedeći zahtjevi brži, izravno prema RS-u.
Nakon što RS primi zahtjev, prvo ga zapisuje u WriteAheadLog (WAL), što je potrebno za oporavak u slučaju pada. Zatim pohranjuje podatke u MemStore. Ovo je predmemorija u memoriji koja sadrži sortirani set ključeva za ovu regiju. Tablica može biti podijeljena na regije (particije), od kojih svaka sadrži nepoklapajući set ključeva. To omogućava, raspoređujući regije na različitim poslužiteljima, postizanje veće performanse. Međutim, unatoč očitosti ove tvrdnje, vidjet ćemo da to ne funkcionira u svim slučajevima.
Nakon što se zapis pohrani u MemStore, klijent dobiva odgovor da je zapis uspješno spremljen. Pri tome se stvarno pohranjuje samo u predmemoriji i bit će na disku tek nakon što prođe neki vremenski interval ili kada se napuni novim podacima.
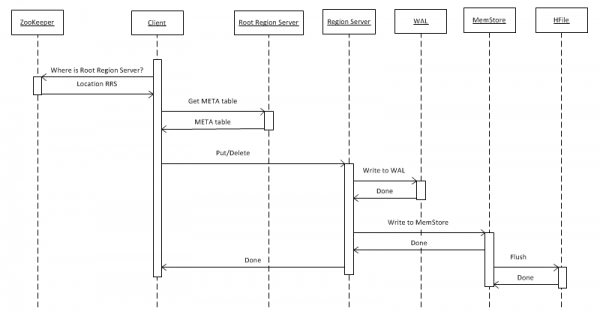
Prilikom izvođenja operacije «Delete», fizičko brisanje podataka se ne događa. Oni su samo označeni kao obrisani, dok se samo uništavanje događa u trenutku pozivanja funkcije major compact, o kojoj je više napisano u točki 7.
Datoteke u formatu HFile se sakupljaju u HDFS-u i s vremena na vrijeme pokreće se proces minor compact, koji jednostavno spaja male datoteke u veće, ne brišući ništa. S vremenom to postaje problem koji se manifestira samo prilikom čitanja podataka (o čemu ćemo se kasnije vratiti).
Osim gornjeg opisanog procesa učitavanja, postoji mnogo učinkovitija procedura, koja je možda najjača strana ove baze podataka – BulkLoad. To podrazumijeva da sami formiramo HFiles i stavimo ih na disk, što omogućava izvrsno skaliranje i postizanje vrlo dobrih brzina. U suštini, ograničenje ovdje nije HBase, već mogućnosti hardvera. U nastavku su prikazani rezultati učitavanja na klasteru koji se sastoji od 16 RegionServera i 16 NodeManager YARN-a (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 niti), verzija HBase 1.2.0-cdh5.14.2.
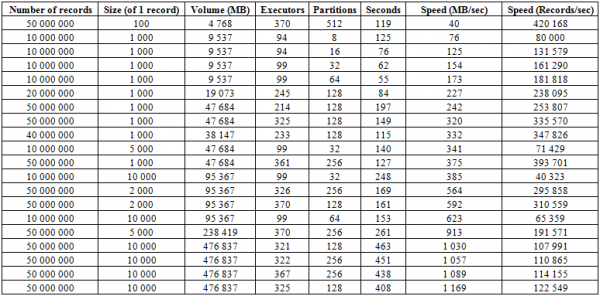
Ovdje se može vidjeti da povećanjem broja particija (regija) u tablici, kao i izvršitelja Sparka, dobivamo povećanje brzine učitavanja. Također, brzina ovisi o volumenu zapisa. Veliki blokovi daju povećanje u mjerenju MB/s, dok manji povećavaju broj umetnutih zapisa u jedinici vremena, pri ostalim jednakim uvjetima.
Također je moguće pokrenuti učitavanje u dvije tablice istovremeno i dobiti udvostručenje brzine. Ispod je vidljivo da zapisi blokova od 10 KB odjednom u dvije tablice idu brzinom od oko 600 Mb/s u svaku (ukupno 1275 Mb/s), što odgovara brzini zapisivanja u jednu tablicu od 623 MB/s (vidi br. 11 iznad).
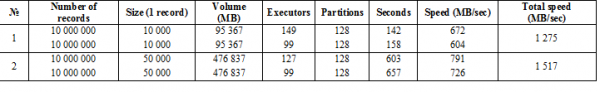
Međutim, drugi pokušaj s zapisima od 50 KB pokazuje da brzina učitavanja raste neznatno, što ukazuje na približavanje graničnim vrijednostima. Pri tome treba imati na umu da na sam HBASE ovdje praktički nema opterećenja, sve što se od njega zahtijeva je prvo predati podatke iz hbase:meta, a nakon umetanja HFiles, isprazniti podatke BlockCache i sačuvati MemStore buffer na disk, ako nije prazan.
3. Čitanje podataka iz HBASE
Ako se uzme u obzir da klijent već ima sve informacije iz hbase:meta (pogledajte točku 2), upit ide odmah na taj RS gdje se nalazi odgovarajući ključ. Prvo se pretražuje u MemCache. Bez obzira na to jesu li podaci prisutni ili ne, pretraživanje se također vrši u bufferu BlockCache i, po potrebi, u HFiles. Ako su podaci pronađeni u datoteci, stavljaju se u BlockCache i pri sljedećem upitu bit će vraćeni brže. Pretraživanje u HFileu se odvija relativno brzo zahvaljujući upotrebi Bloom filtera, tj. čitanjem malog volumena podataka odmah se utvrđuje sadrži li ta datoteka potrebni ključ, a ako ne, prelazi se na sljedeći.
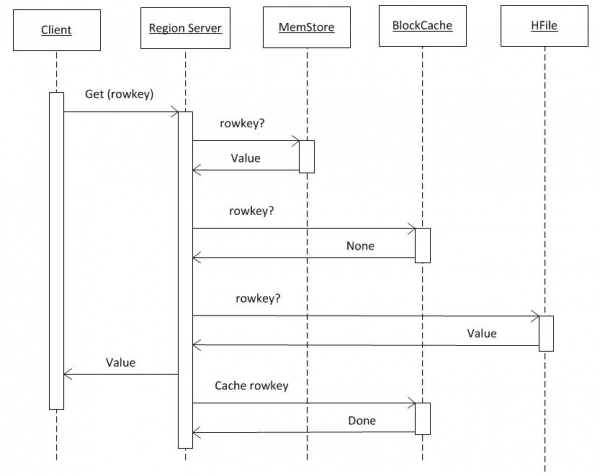
Nakon što prikupi podatke iz ova tri izvora, RS formira odgovor. Konkretno, može odmah poslati nekoliko pronađenih verzija objekta ukoliko je klijent zatražio verzioniranje.
4. Keširanje podataka
MemStore i BlockCache bufferi zauzimaju do 80% dodijeljene on-heap memorije RS-a (ostatak je rezerviran za servisne zadatke RS-a). Ako je tipičan način korištenja takav da procesi najprije pišu, a zatim odmah čitaju iste podatke, onda ima smisla smanjiti BlockCache i povećati MemStore, jer kod pisanja podaci ne ulaze u keš za čitanje, pa će se korištenje BlockCache-a dogoditi rjeđe. BlockCache buffer se sastoji od dva dijela: LruBlockCache (uvijek on-heap) i BucketCache (obično off-heap ili na SSD-u). BucketCache treba koristiti kada ima puno upita za čitanje i kada ne stanu u LruBlockCache, što dovodi do aktivnog rada Garbage Collector-a. Međutim, ne treba očekivati radikalan porast performansi pri korištenju keša za čitanje, ali o tome ćemo se još osvrnuti u točki 8.
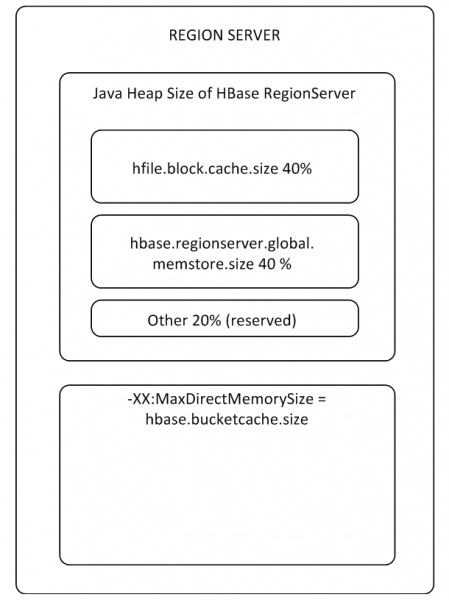
BlockCache je jedan za cijeli RS, dok je MemStore svoj za svaku tablicu (po jedan za svaki Column Family).
Kako Teoretski, kod pisanja podaci ne ulaze u keš i doista su takvi parametri CACHE_DATA_ON_WRITE za tablicu i 'Cache DATA on Write' za RS postavljeni na false. No, u praksi, ako se podaci zapisuju u MemStore, zatim se prebace na disk (tako ga očiste), pa se dobivena datoteka ukloni, nakon čega izvršavanje get upita uspješno vraća podatke. Čak i ako se potpuno isključi BlockCache i napuni tablica novim podacima, a zatim se postigne da se MemStore prebaci na disk, njihovim uklanjanjem i upitom iz druge sesije, oni će se i dalje negdje izvući. Tako da HBase u sebi ne drži samo podatke, već i tajanstvene zagonetke.
hbase(main):001:0> create 'ns:magic', 'cf'
Created table ns:magic
Took 1.1533 seconds
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Took 0.2610 seconds
hbase(main):003:0> flush 'ns:magic'
Took 0.6161 seconds
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Parametar "Cache DATA on Read" postavljen je na false. Ako imate ideje, slobodno ih podijelite u komentarima.
5. Obrada podataka MultiGet/MultiPut
Obrada pojedinačnih zahtjeva (Get/Put/Delete) je prilično skupa operacija, stoga je poželjno grupirati ih u List ili List, što omogućava značajno povećanje performansi. To se posebno odnosi na operacije zapisivanja, dok pri čitanju postoji sljedeća zamka. Na grafikonu ispod prikazano je vrijeme čitanja 50 000 zapisa iz MemStore-a. Čitanje je obavljeno u jednom niti, a na horizontalnoj osi prikazani su broj ključeva u zahtjevu. Ovdje se vidi da se s povećanjem na tisuću ključeva u jednom zahtjevu vrijeme izvršenja smanjuje, tj. brzina se povećava. Međutim, kada je zadani način MSLAB uključen, nakon ovog praga počinje radikalno opadanje performansi, a što je veći volumen podataka u zapisu, to je duže vrijeme rada.
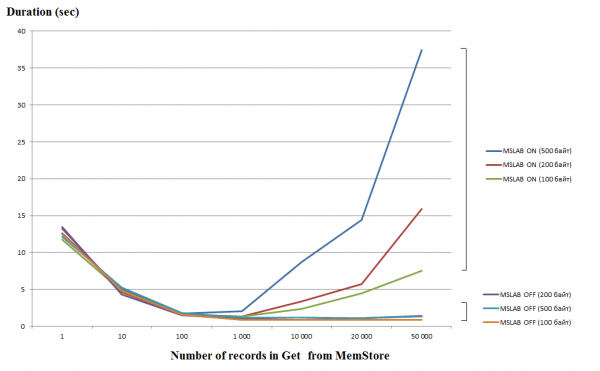
Testovi su provedeni na virtualnoj mašini, 8 jezgri, verzija HBase 2.0.0-cdh6.0.0-beta1.
Način MSLAB je osmišljen da smanji fragmentaciju heap-a, koja nastaje zbog miješanja podataka novih i starih generacija. Kao rješenje problema, kada je MSLAB uključen, podaci se stavljaju u relativno male ćelije (chunk) i obrađuju se u porcijama. Kao rezultat, kada volumen u zatraženom paketu podataka premašuje dodijeljenu veličinu, performanse drastično padaju. S druge strane, isključivanje ovog načina također nije poželjno, jer će dovesti do zastoja zbog GC-a u trenucima intenzivnog rada s podacima. Dobar izlaz je povećanje volumena ćelije, u slučaju aktivnog zapisivanja putem putanja zajedno s čitanjem. Važno je napomenuti da problem ne nastaje ako nakon zapisivanja izvršite naredbu flush koja prebacuje MemStore na disk ili ako se izvršava učitavanje pomoću BulkLoad-a. U tablici ispod prikazano je da zahtjevi iz MemStore-a s većim volumenom podataka (i istim brojem) dovode do usporavanja. Međutim, povećanjem chunksize-a vraćamo vrijeme obrade u normalu.
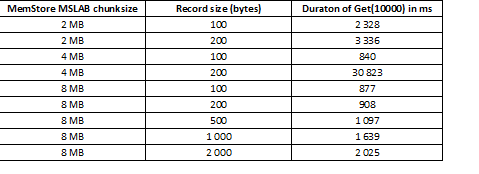
Osim povećanja chunksizea, pomaže i fragmentacija podataka po regijama, tj. splitanje tablica. To dovodi do toga da za svaku regiju dolazi manji broj zahtjeva, a ako se uklapaju u ćeliju, odgovor ostaje dobar.
6. Strategija dijeljenja tablica na regije (splitanje)
Budući da je HBase skladište ključ-vrijednost i particioniranje se provodi prema ključu, izuzetno je važno ravnomjerno razdijeliti podatke po svim regijama. Na primjer, particioniranje takve tablice na tri dijela dovest će do razdvajanja podataka u tri regije:
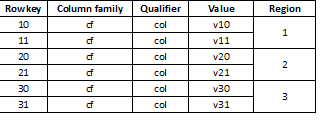
Ponekad to dovodi do naglog usporavanja, ako učitani podaci kasnije imaju oblik, na primjer, long vrijednosti većinom počinjući istom brojkom, kao što su:
1000001
1000002
…
1100003
Budući da se ključevi pohranjuju u obliku niza bajtova, svi će početi jednako i pripadati jednoj regiji #1 koja pohranjuje taj raspon ključeva. Postoji nekoliko strategija dijeljenja:
HexStringSplit – Pretvara ključ u niz s heksadecimalnim kodiranjem u rasponu „00000000” => „FFFFFFFF” i puni lijevo nulama.
UniformSplit – Pretvara ključ u niz bajtova s heksadecimalnim kodiranjem u rasponu „00” => „FF” i puni desno nulama.
Osim toga, možete odrediti bilo koji raspon ili skup ključeva za dijeljenje i postaviti automatsko splitanje. Međutim, jedan od najjednostavnijih i najučinkovitijih pristupa je UniformSplit i korištenje konkatelacije hasha, na primjer, najstarijeg para bajtova kroz funkciju CRC32(rowkey) i samog rowkeya:
hash + rowkey
Tada će svi podaci biti ravnomjerno raspoređeni po regijama. Pri čitanju prva dva bajta jednostavno se odbacuju i ostaje izvorni ključ. Također, RS kontrolira količinu podataka i ključeva u regiji i kada se prekorače limiti, automatski ih dijeli na dijelove.
7. Otpornost na greške i lokalnost podataka
Budući da svaki skup ključeva pripada samo jednoj regiji, rješenje za probleme povezane s padovima RS-a ili isključivanjem je pohranjivanje svih potrebnih podataka u HDFS. Kada dođe do pada RS-a, master to otkriva putem nedostatka heartbeat-a na čvoru ZooKeeper. Tada imenuje novog RS-a za upravljanje regijom, a budući da su HFiles pohranjeni u distribuiranom datotečnom sustavu, novi vlasnik ih čita i nastavlja upravljati podacima. Međutim, budući da dio podataka može biti u MemStore-u i nije stigao u HFiles, za obnavljanje povijesti operacija koristi se WAL, koji se također pohranjuje u HDFS. Nakon primjene promjena, RS je sposoban odgovarati na zahtjeve, no premještaj dovodi do toga da dio podataka i procesi koji ih obrađuju završavaju na različitim čvorovima, tj. smanjuje se lokalnost.
Rješenje problema je major compaction – ova procedura premješta datoteke na one čvorove koji su odgovorni za njih (gdje se nalaze njihove regije), pri čemu u toku ove procedure naglo raste opterećenje mreže i diskova. Međutim, kasnije je pristup podacima znatno brži. Osim toga, major_compaction spaja sve HFiles u jedan datoteku unutar regije, te također čisti podatke u skladu s postavkama tablice. Na primjer, moguće je odrediti koliko verzija objekta treba zadržati ili vrijeme njegovog trajanja, nakon kojeg se objekt fizički briše.
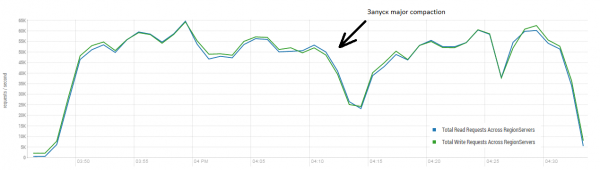
Ova procedura može imati vrlo pozitivan utjecaj na rad HBase-a. Na slici ispod vidljivo je kako je performansa degradirala zbog aktivnog zapisivanja podataka. Ovdje se vidi kako je 40 niti pisalo u jednu tablicu, dok je 40 niti istovremeno čitalo podatke. Niti za pisanje stvaraju sve više i više HFiles, koje druge niti čitaju. Kao rezultat, sve više podataka mora se ukloniti iz memorije i na kraju počinje raditi GC, koji praktički paralizira cijeli rad. Pokretanje major compaction-a dovelo je do čišćenja nastalih nagomilavanja i obnavljanja performansi.
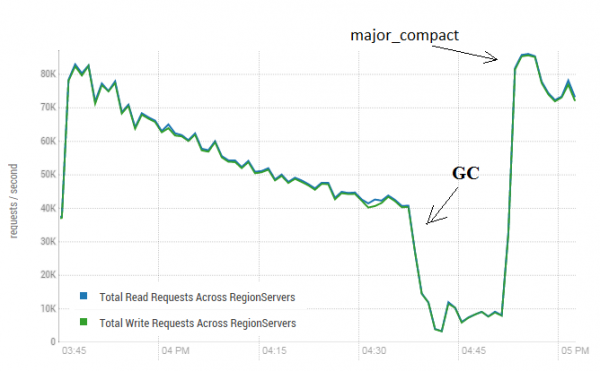
Test je proveden na 3 DataNode-a i 4 RS-a (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 niti). Verzija HBase-a 1.2.0-cdh5.14.2
Važno je napomenuti da je major compaction pokrenut na 'živom' tabeli, u koju se aktivno upisivalo i očitavalo podatke. Na internetu se pojavila tvrdnja da to može dovesti do netočnih odgovora prilikom očitavanja podataka. Za provjeru, pokrenut je proces koji je generirao nove podatke i upisivao ih u tabelu, a zatim ih odmah očitavao i uspoređivao da li se dobivena vrijednost poklapa s onom koja je zapisana. Tokom rada ovog procesa major compaction je pokrenut oko 200 puta i nije zabilježen nijedan kvar. Moguće je da se problem pojavljuje samo rijetko i tokom velike opterećenosti, stoga je ipak sigurnije planirano zaustavljanje procesa pisanja i očitavanja te izvođenje čišćenja bez bogatih GC opterećenja.
Također, major compaction ne utječe na stanje MemStore-a; za njegovo prebacivanje na disk i kompaktiranje potrebno je koristiti flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Postavke i performanse
Kao što je već rečeno, HBase pokazuje najveći uspjeh kada nema drugih zadataka za obaviti tijekom izvođenja BulkLoad-a. Ipak, to se odnosi na većinu sistema i ljudi. Međutim, ovaj alat više odgovara masovnom postavljanju podataka u velikim blokovima, dok se za procese koji zahtijevaju izvršenje brojnih konkurentnih očitavanja i pisanja koriste gore opisane komande Get i Put. Kako bi se odredile optimalne parametre, izvedena su pokretanja uz različite kombinacije parametara tabela i postavki:
- Pokrenuto je 10 niti istovremeno 3 puta zaredom (nazovimo to blokom niti).
- Vrijeme trajanja svih niti unutar bloka se prosječilo i predstavljalo konačni rezultat rada bloka.
- Sve niti su radile s istom tabelom.
- Prije svakog pokretanja bloka niti izvršen je major compaction.
- Svaki blok je izvodio samo jednu od sljedećih operacija:
— Put
— Get
— Get+Put
- Svaki blok je izveo 50.000 ponavljanja svoje operacije.
- Veličina zapisa u bloku bila je 100 bajtova, 1000 bajtova ili 10.000 bajtova (nasumično).
- Blokovi su pokretani s različitim brojem zatraženih ključeva (ili jedan ključ ili 10).
- Blokovi su pokretani uz različite postavke tabele. Varirane su sljedeće postavke:
— BlockCache = uključen ili isključen
— BlockSize = 65 KB ili 16 KB
— Particije = 1, 5 ili 30
— MSLAB = uključen ili isključen
Tako blok izgleda ovako:
a. MSLAB režim je uključen/isključen.
b. Napravila je tablica za koju su postavljeni sljedeći parametri: BlockCache = true/none, BlockSize = 65/16 Kb, Particija = 1/5/30.
c. Postavljena je GZ kompresija.
d. Pokretano je 10 threadova koji istovremeno izvršavaju 1/10 operacija put/get/get+put u ovoj tablici sa zapisima od 100/1000/10000 bajtova, izvršavajući 50.000 upita jedan za drugim (ključevi su nasumični).
e. Stavka d ponovljena je tri puta.
f. Vrijeme rada svih threadova je prosječeno.
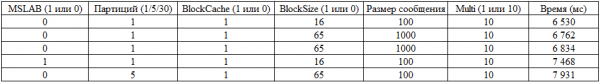
Provjerene su sve moguće kombinacije. Predvidljivo je da će se prilikom povećanja veličine zapisa brzina smanjivati ili da će isključivanje keširanja dovesti do usporavanja. Međutim, cilj je bio razumjeti stepen i značaj utjecaja svakog parametra, stoga su prikupljeni podaci uneseni u funkciju linearne regresije, što omogućava procjenu pouzdanosti pomoću t-statistike. Ispod su prikazani rezultati rada blokova koji izvršavaju Put operacije. Potpuni skup kombinacija 2*2*3*2*3 = 144 opcije + 72 obzirom da su neki izvršeni dvaput. Tako da je ukupno 216 pokretanja:
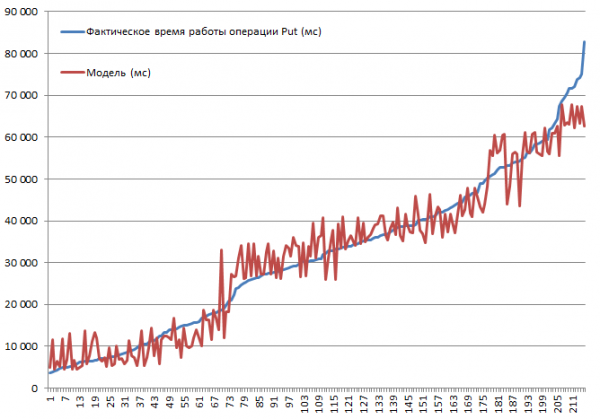
Testiranje je provedeno na mini-klasteru sastavljenom od 3 DataNode i 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threadova). Verzija HBase 1.2.0-cdh5.14.2.
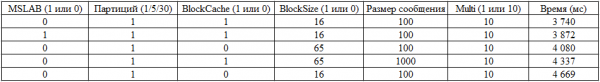
Najviša brzina umetanja od 3,7 sekundi ostvarena je s isključenim MSLAB načinom rada, na tablici s jednom particijom, uz uključen BlockCache, BlockSize = 16, sa zapisima od 100 bajtova po 10 u paketu.
Najniža brzina umetanja od 82,8 sekundi ostvarena je s uključenim MSLAB načinom rada, na tablici s jednom particijom, uz uključen BlockCache, BlockSize = 16, sa zapisima od 10000 bajtova po 1 komadu.
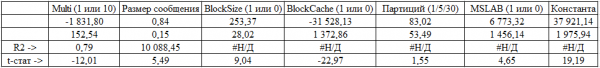
Sada ćemo pogledati model. Vidimo dobru kvalitetu modela prema R2, ali je potpuno jasno da je ekstrapolacija ovdje neprihvatljiva. Stvarno ponašanje sustava prilikom promjene parametara neće biti linearno, ovaj model je potreban ne za prognoze, već za razumijevanje što se dogodilo unutar zadanih parametara. Na primjer, ovdje vidimo prema kriteriju Student, da za operaciju Put parametri BlockSize i BlockCache nemaju značaj (što je, u suštini, sasvim predvidljivo):
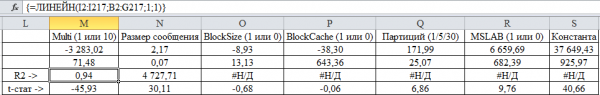
To što povećanje broja particija smanjuje performanse je prilično neočekivano (već smo videli pozitivan uticaj povećanja broja particija prilikom BulkLoad-a), ali i objašnjivo. Prvo, za obradu je potrebno formirati upite za 30 regiona umesto jednog, a obim podataka nije toliko veliki da bi to donelo dobit. Drugo, ukupno vreme rada određuje najsporiji RS, a s obzirom na to da je broj DataNode-a manji od broja RS, neki regioni imaju nultu lokalnost. Pogledajmo pet najboljih:
Sada procenimo rezultate izvršavanja blokova Get:
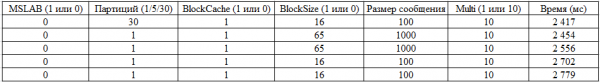
Broj particija je izgubio značaj, što verovatno objašnjava to što se podaci dobro keširaju, a keš za čitanje je jedan od najvažnijih (statistički) parametara. Naravno, povećanje broja poruka u upitu takođe je veoma korisno za performanse. Najbolji rezultati:
I na kraju pogledajmo model bloka koji je prvo izvršio get, a zatim put:
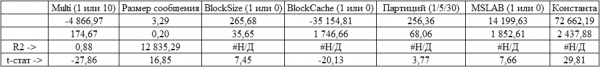
Ovde su svi parametri značajni. I rezultati lidera:
9. Opterećujuće testiranje
Na kraju ćemo pokrenuti prilično pristojno opterećenje, ali uvek je zanimljivije kada imamo s čim da uporedimo. Na sajtu DataStax – ključnog developera Cassandre, postoji NT raznih NoSQL skladišta, uključujući HBase verziju 0.98.6-1. Učitavanje je sprovedeno sa 40 niti, veličina podataka je 100 bajtova, SSD diskovi. Rezultat testiranja operacija Read-Modify-Write dao je ovakve rezultate.
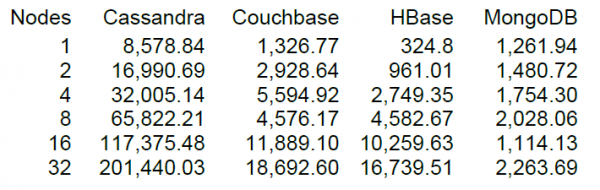
Kako sam razumeo, čitanje je vršeno u blokovima od 100 zapisa i za 16 nodova HBase test DataStax je pokazao performanse od 10.000 operacija u sekundi.
Srećom, u našem klasteru također ima 16 nodova, ali nije baš "srećno" što svaki ima 64 jezgra (tokova), dok je u DataStax testu bilo po 4. S druge strane, oni imaju SSD diskove, a mi HDD i noviju verziju HBase, a iskorištenost CPU tijekom opterećenja nije se značajno povećavala (vizualno za 5-10 posto). Ipak, pokušaćemo pokrenuti s ovom konfiguracijom. Postavke tablica su zadane, čitanje se vrši u rasponu ključeva od 0 do 50 milijuna nasumično (tj. svaki put novi). U tablici je 50 milijuna zapisa, raspršeno na 64 particije. Ključevi su hashirani pomoću crc32. Zadane postavke tablica, MSLAB je uključen. Pokrećemo 40 tokova, svaki tok čita skup od 100 nasumičnih ključeva i odmah zapisuje generiranih 100 bajtova na te ključeve.
Stabilna konfiguracija: 16 DataNode i 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 toka). Verzija HBase 1.2.0-cdh5.14.2.
Prosječni rezultat bliži je 40 tisuća operacija u sekundi, što je značajno bolje nego u DataStax testu. Međutim, u svrhu eksperimenta možemo malo promijeniti uvjete. Veoma je malo vjerojatno da će se sav rad odvijati isključivo s jednom tablicom, kao i samo s jedinstvenim ključevima. Pretpostavimo da postoji neki "vrući" skup ključeva koji generira glavno opterećenje. Stoga ćemo pokušati stvoriti opterećenje s većim zapisima (10 KB), također u paketima od 100, u 4 različite tablice, ograničavajući raspon traženih ključeva na 50 tisuća. Na grafikonu ispod prikazan je pokretanje 40 tokova, svaki tok čita skup od 100 ključeva i odmah zapisuje nasumičnih 10 KB na te ključeve nazad.
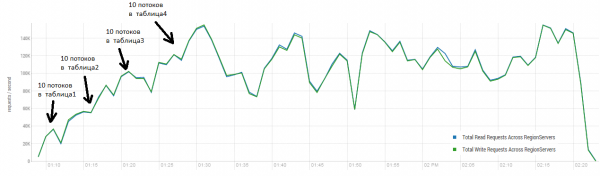
Stabilna konfiguracija: 16 DataNode i 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 toka). Verzija HBase 1.2.0-cdh5.14.2.
Tijekom opterećenja nekoliko puta pokrenut je major compaction, kao što je prikazano iznad bez ovog postupka performanse će postupno degradirati, međutim tijekom izvršenja također nastaje dodatno opterećenje. Padovi su uzrokovani različitim razlozima. Ponekad su tokovi završavali rad, a dok su se ponovno pokretali nastala je pauza, ponekad su vanjske aplikacije stvarale opterećenje na klaster.
Čitanje i odmah pisanje jedan je od najtežih scenarija rada za HBase. Ako se rade samo put zahtjevi manjeg obima, na primjer, od 100 bajta, grupiranjem u pakete od 10-50 tisuća, moguće je postići stotine tisuća operacija u sekundi, a slično je i s zahtjevima koji se koriste samo za čitanje. Valja napomenuti da su rezultati radikalno bolji od onih koje je dobio DataStax, prvo zahvaljujući zahtjevima u blokovima od 50 tisuća.
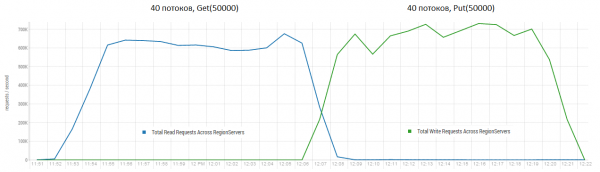
Stabilna konfiguracija: 16 DataNode i 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 toka). Verzija HBase 1.2.0-cdh5.14.2.
10. Zaključci
Ovaj sustav vrlo je fleksibilan za podešavanje, međutim, utjecaj velikog broja parametara još uvijek ostaje nepoznat. Dio njih je testiran, ali nije ušao u rezultantni skup testova. Na primjer, preliminarni eksperimenti pokazali su neznatnu značajnost parametra kao što je DATA_BLOCK_ENCODING, koji kodira informacije koristeći vrijednosti iz susjednih ćelija, što je sasvim razumljivo za podatke generirane nasumično. U slučaju upotrebe velikog broja ponavljajućih objekata, dobitak može biti značajan. Općenito, može se reći da HBase ostavlja dojam dovoljno ozbiljne i promišljene baze podataka koja može biti dovoljno učinkovita prilikom operacija s velikim blokovima podataka. Osobito ako postoji mogućnost kašnjenja između procesa čitanja i pisanja.
Ako nešto po vašem mišljenju nije dovoljno obrađeno, rado ću reći više. Predlažemo da podijelite svoje iskustvo ili da raspravljate ako se s nečim ne slažete.
Izvor: habr.com
