

Bok svima, zovem se Aleksandar i ja sam inženjer kvalitete podataka koji se bavi provjerom kvalitete podataka. U ovom članku govorit ću o tome kako sam do toga došao i zašto je u 2020. godini ovo područje testiranja došlo u središte pozornosti.
Globalni trend
Danas svijet prolazi kroz još jednu tehnološku revoluciju, a jedan od aspekata je način na koji brojne tvrtke koriste akumulirane podatke za unapređenje vlastitih prodajnih ciklusa, dobiti i PR-a. Čini se da je upravo posjedovanje dobrih (kvalitetnih) podataka, kao i sposobnosti onih koji ih mogu pretvoriti u novac (ispravno obraditi, vizualizirati, izgraditi modele strojnog učenja itd.), postalo ključ uspjeha za mnoge. Dok su se prije 15-20 godina predano radili sakupljanje podataka i njihova monetizacija prvenstveno u velikim tvrtkama, danas je to postalo područje gotovo svih razboritih.
U tom kontekstu, prije nekoliko godina, svi portali posvećeni traženju posla širom svijeta počeli su biti preplavljeni oglasima za pozicije Data Scientist-a, jer su svi vjerovali da zapošljavanjem takvog stručnjaka mogu izgraditi supermodel strojnog učenja, predvidjeti budućnost i napraviti "kvantni skok" za tvrtku. S vremenom su ljudi shvatili da takav pristup gotovo nigdje ne funkcionira, jer nisu svi podaci koje ovakvi stručnjaci dobiju prikladni za obučavanje modela.
I počeli su zahtjevi od Data Scientist-a: "Hajde da kupimo više podataka od ovih i onih...", "Nedostaje nam podataka...", "Treba nam još malo podataka, i to kvalitetnih...". Na temelju tih zahtjeva počela su se formirati brojna međusobna povezivanja između tvrtki koje posjeduju razne skupove podataka. Naravno, to je zahtijevalo tehničku organizaciju ovog procesa — povezivanje s izvorom podataka, prenošenje podataka, provjeru da su u potpunosti učitani, itd. Broj takvih procesa je rastao, i danas imamo ogroman zahtjev za drugim vrstama stručnjaka — inženjerima kvalitete podataka — onima koji će nadzirati tok podataka u sustavu (data pipelines), kvalitetu podataka na ulazu i izlazu, te donijeti zaključke o njihovoj dovoljnosti, cjelovitosti i drugim karakteristikama.
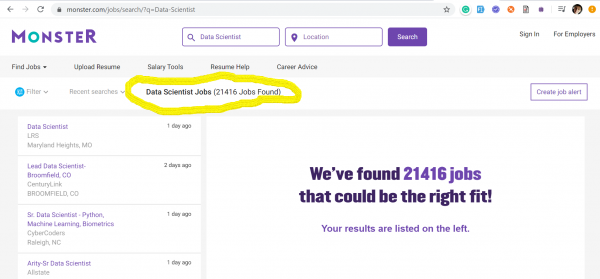
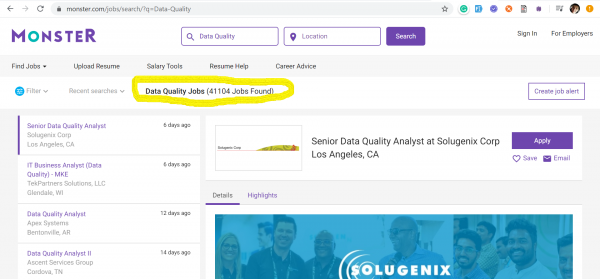
Trend Data Quality inženjera došao je k nama iz SAD-a, gdje u jeku bujne ere kapitalizma nitko nije spreman izgubiti bitku za podatke. Ispod sam prikazao snimke zaslona s dva najpopularnija web mjesta za traženje posla u SAD-u: i — na kojima su prikazani podaci zaključno s 17. ožujka 2020. godine o broju objavljenih radnih mjesta po ključnim riječima: Data Quality i Data Scientist.
Data Scientist – 21416 radnih mjesta
Data Quality – 41104 radna mjesta
Data Scientist – 404 radna mjesta
Data Quality – 2020 radnih mjesta
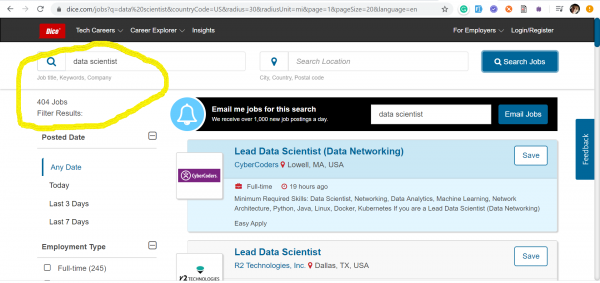
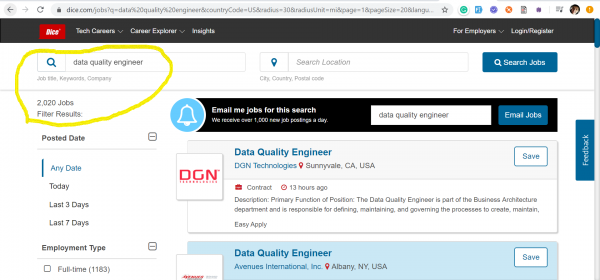
Očigledno, ove profesije ni na koji način ne konkuriraju jedna drugoj. Snimkama zaslona samo sam htio ilustrirati trenutnu situaciju na tržištu rada u vezi s potražnjom za Data Quality inženjerima, kojih sada ima znatno više nego Data Scientist-a.
U lipnju 2019. godine, EPAM, reagirajući na potrebe modernog IT tržišta, izdvojio je Data Quality kao posebnu praksu. Data Quality inženjeri u svom svakodnevnom radu upravljaju podacima, provjeravaju njihovo ponašanje u novim uvjetima i sustavima, te kontroliraju relevantnost podataka, njihovu dovoljnost i aktualnost. Ipak, praktično gledano, Data Quality inženjeri zaista malo vremena posvećuju klasičnom funkcionalnom testiranju, ALI to uvelike ovisi o projektu (primjer ću navesti dalje).
Obveze Data Quality inženjera ne ograničavaju se samo na rutinske ručne/automatske provjere „nulls, count i sums“ u DB tablicama, već zahtijevaju duboko razumijevanje poslovnih potreba naručitelja i, prema tome, sposobnost transformiranja postojećih podataka u korisne poslovne informacije.
Teorija Data Quality
Kako bismo najbolje razumjeli ulogu takvog inženjera, razjasnimo što je Data Quality u teoriji.
Data Quality — jedna od faza upravljanja podacima (cijeli svijet koji ćemo vam ostaviti za samostalno proučavanje) i odgovara za analizu podataka prema sljedećim kriterijima:
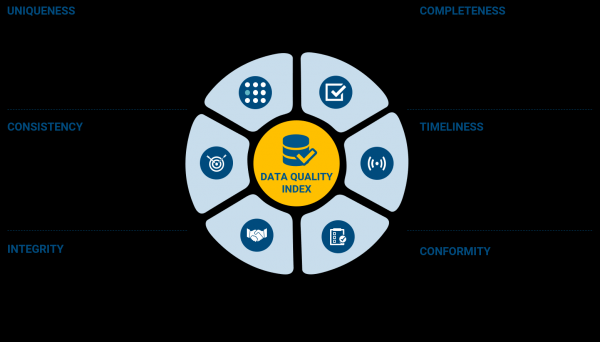
Mislim da ne treba objašnjavati svaku stavku (teorijski nazivaju se „data dimensions“), one su prilično dobro opisane na slici. No, sam proces testiranja ne podrazumijeva strogo Kopiranje ovih osobina u testne slučajeve i njihovu provjeru. U Kvaliteti podataka, kao i u bilo kojem drugom obliku testiranja, potrebno je prvenstveno se oslanjati na zahtjeve za kvalitetu podataka, dogovorene s sudionicima projekta koji donose poslovne odluke.
Ovisno o projektu, inženjer Kvalitete podataka može obavljati različite funkcije: od običnog automatiziranog testera s površinskom procjenom kvalitete podataka, do osobe koja provodi dubinsko profiliranje prema gore navednim osobinama.
Vrlo detaljan opis procesa Upravljanja podacima, Kvalitete podataka i povezanih koncepata izvrsno je opisan u knjizi pod nazivom „DAMA-DMBOK: Body of Knowledge za upravljanje podacima: 2. izdanje“. Iskreno preporučujem ovu knjigu kao uvod u ovu tematiku (link na nju ćete pronaći na kraju članka).
Moja priča
U IT industriji prošao sam put od Junior testera u produktnim kompanijama do Lead Data Quality Engineera u kompaniji EPAM. Nakon otprilike dvije godine rada kao tester imao sam čvrsto uvjerenje da sam prolazio kroz sve vrste testiranja: regresijsko, funkcionalno, stresno, stabilnosti, sigurnosti, UI itd. — i isprobao sam veliki broj alata za testiranje, radeći pritom na tri programska jezika: Java, Scala, Python.
Gledajući unatrag, razumijem zašto je moj set profesionalnih vještina postao toliko raznolik — sudjelovao sam u projektima vezanim uz rad s podacima, velikim i malim. Upravo me to dovelo u svijet velikog broja alata i mogućnosti za rast.
Da biste procijenili raznolikost alata i mogućnosti stjecanja novih znanja i vještina, dovoljno je samo pogledati sliku u nastavku, na kojoj su prikazani najpopularniji među njima u svijetu „Podaci & AI“.
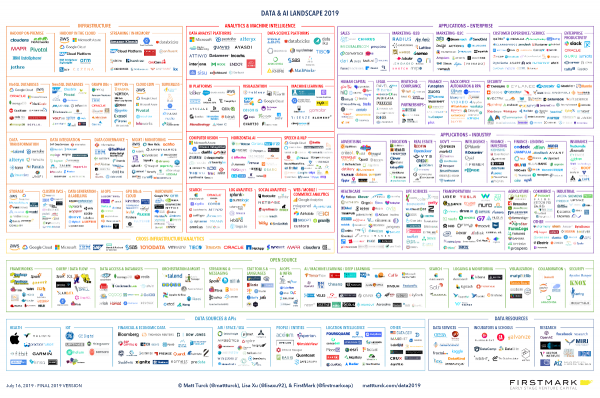
Ove ilustracije sastavlja godišnje jedan od poznatih rizičnih kapitalista Matt Turck, bivši programer. Evo njegovog bloga i , gdje radi kao partner.
Osobito sam brzo napredovao kada sam bio jedini tester na projektu, ili barem na početku projekta. U tom trenutku moraš biti odgovoran za cijeli proces testiranja, bez mogućnosti povlačenja, samo naprijed. Isprva je to bilo zastrašujuće, međutim sada su mi očiti svi pozitivni aspekti tog iskustva:
- Počinješ komunicirati sa cijelim timom kao nikada prije, jer nema posrednika u komunikaciji: ni voditelja testiranja, ni kolega testera.
- Uranjanje u projekt postaje nevjerojatno duboko, a ti posjeduješ informacije o svim komponentama, kako općenito, tako i u detalje.
- Programeri te ne gledaju kao "tog tipa iz testiranja koji nije baš jasan", već kao ravnog partnera koji donosi nevjerojatnu korist timu svojim automatiziranim testovima i predviđanjem nastanka grešaka u određenom dijelu proizvoda.
- Kao rezultat — postaješ učinkovitiji, kvalificiraniji, i traženiji.
Kako projekt raste, u 100% slučajeva postajem mentor novim testerima koji dolaze, obučavam ih i prenosim znanja koja sam sam naučio. Ovisno o projektu, nisam uvijek dobivao od vodstva stručnjake za automatizirano testiranje najvišeg nivoa, pa je postojala potreba ili da ih obučavam za automatizaciju (za one koji su željeli), ili da kreiram alate za njihovo svakodnevno korištenje (alate za generiranje podataka i njihovo učitavanje u sustav, alat za provođenje opterećujućih testova/testiranja stabilnosti "u brzom postupku" itd.).
Primjer konkretnog projekta
Nažalost, zbog obveza o neotkrivanju informacija ne mogu detaljno govoriti o projektima na kojima sam radio, ali ću navesti primjere tipičnih zadataka Data Quality Engineera na jednom od projekata.
Osnovna svrha projekta je realizirati platformu za pripremu podataka za obuku modela strojnog učenja. Naručitelj je bila velika farmaceutska kompanija iz SAD-a. Tehnički, to je bio klaster , podignut na instancama, s nekoliko mikroslužbi i temeljnom Open Source projektom kompanije EPAM — , prilagođen potrebama određenog naručitelja (sada je projekt preobražen u ). ETL procesi su organizirani pomoću i premještali podatke iz sustava naručitelja u Buckets. Zatim se na platformu implementirao Docker imidž modela strojnog učenja, koji se trenirao na svježim podacima i putem REST API sučelja vraćao predikcije od interesa za poslovanje i rješavao specifične zadatke.
Vizualno je sve izgledalo otprilike ovako:
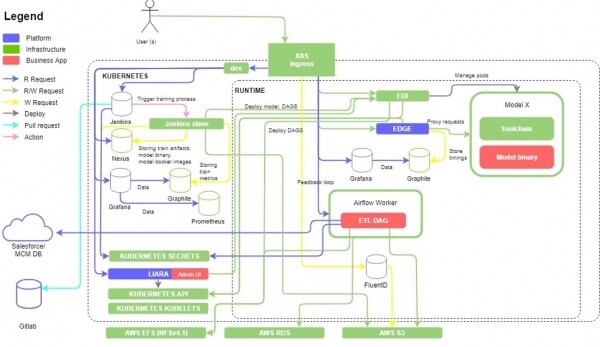
Funkcionalnog testiranja na ovom projektu bilo je više nego dovoljno, a s obzirom na brzinu razvoja značajki i potrebu održavanja tempa ciklusa izdanja (dvotjedni sprintovi), bilo je potrebno odmah razmišljati o automatizaciji testiranja najkritičnijih čvorova sustava. Veliki dio same platforme s Kubernetes temeljem pokriven je automatiziranim testovima, implementiranim na + Python, ali je također bilo potrebno održavati i proširivati ih. Osim toga, za praktičnost naručitelja, stvoreno je GUI sučelje za upravljanje modelima strojnog učenja, implementiranim na klasteru, kao i mogućnost odrediti odakle i kamo je potrebno prenijeti podatke za obuku modela. Ovo opsežno proširenje dovelo je do širenja automatiziranih funkcionalnih provjera, koje su većinom rađene kroz REST API pozive i mali broj end-2-end UI testova. Otprilike na polovici cijelog ovog procesa pridružio nam se ručni tester, koji je odlično obavljao prihvatno testiranje verzija proizvoda i komunicirao s naručiteljem o prihvodu novog izdanja. Osim toga, zahvaljujući novoj stručnjaku, uspjeli smo dokumentirati naš rad i dodati nekoliko vrlo važnih ručnih provjera koje je bilo teško odmah automatizirati.
I konačno, nakon što smo postigli stabilnost platforme i GUI nadogradnje na njoj, pristupili smo izgradnji ETL cjevovoda koristeći Apache Airflow DAG-ove. Automatizirana provjera kvalitete podataka vršena je pisanjem specijalnih Airflow DAG-ova koji su provjeravali podatke prema rezultatima rada ETL procesa. U okviru ovog projekta imali smo sreće jer nam je naručitelj pružio pristup neobduženim skupovima podataka na kojima smo testirali. Provjeravali smo podatke redak po redak na usklađenost s tipovima, prisutnost neispravnih podataka, ukupan broj unosa prije i poslije, te uspoređivali transformacije koje je izvršio ETL proces po agregaciji, promjenama naziva kolona i ostalom. Osim toga, ovi su se pregledi proširili na različite izvore podataka, primjerice, osim SalesForce-a, i na MySQL.
Provjere konačne kvalitete podataka provodile su se već na razini S3, gdje su oni pohranjeni i bili spremni za upotrebu u obuci modela strojnog učenja. Za dobivanje podataka iz konačne CSV datoteke smještene na S3 Bucket-u i njihovu validaciju, napisan je kod koristeći .
Također, sa strane naručitelja postojao je zahtjev za čuvanjem dijela podataka u jednom S3 Bucket-u, a dijela u drugom. Za to je bilo potrebno pisati dodatne provjere koje su nadgledale točnost takve podjele.
Generalizirano iskustvo iz drugih projekata
Primjer najgeneraliziranijeg popisa aktivnosti inženjera kvalitete podataka:
- Pripremiti testne podatke (važeće, nevažeće, velike, male) putem automatiziranog alata.
- Učitati pripremljeni skup podataka u izvorni izvor i provjeriti njegovu spremnost za korištenje.
- Pokrenuti ETL procese obrade skupa podataka iz izvorne pohrane u konačnu ili privremenu koristeći određeni skup postavki (u slučaju mogućnosti zadavanja konfigurabilnih parametara za ETL zadatak).
- Verificirati obrađene podatke ETL procesom u smislu njihove kvalitete i usklađenosti s poslovnim zahtjevima.
Glavni fokus provjera trebao bi biti ne samo na tome je li protok podataka u sustavu uopće funkcionirao i stigao do kraja (što je dio funkcionalnog testiranja), već većinom na provjeri i validaciji podataka kako bi se osiguralo da odgovaraju očekivanim zahtjevima, uočeći anomalije i slično.
Alati
Jedna od tehnika takvog nadzora podataka može biti organizacija lančanih provjera u svakoj fazi obrade podataka, takozvani "data chain" — kontrola podataka od izvora do konačne točke korištenja. Ove provjere najčešće se provode pisanjem SQL upita za provjeru. Naravno, takvi upiti trebaju biti što lakši i usmjereni na provjeru pojedinih dijelova kvalitete podataka (metapodaci tablica, prazne linije, NULL-ovi, greške u sintaksi — drugi potrebni atributi provjere).
U slučaju regresijskog testiranja, u kojem se koriste već pripremljeni (neizmjenjivi ili neznatno izmjenjivi) setovi podataka, u kodu automatiziranih testova mogu biti pohranjeni već gotovi obrasci za provjeru podataka u odnosu na kvalitetu (opis očekivanih metapodataka tablica; nizovi uzoraka koji se mogu nasumično birati tijekom testiranja, i slično).
Također, tijekom testiranja treba pisati testne ETL procese, koristeći okvire poput Apache Airflow, ili potpuno black-box cloud alate poput , i slično. Ova situacija prisiljava testnog inženjera da se uroni u principe rada gore navedenih alata i još učinkovitije provodi funkcionalno testiranje (na primjer, postojećih ETL procesa na projektu), kao i da ih koristi za provjeru podataka. Konkretno, za Apache Airflow već postoje gotovi operatori za rad s popularnim analitičkim bazama podataka, kao što su . Najosnovniji primjer njegove upotrebe već je izložen , stoga neću ponavljati.
Osim gotovih rješenja, nitko vam ne zabranjuje implementaciju vlastitih tehnika i alata. To će biti korisno ne samo za projekt, već i za samog Data Quality Engineera, koji će na taj način unaprijediti svoje tehničke perspektive i vještine programiranja.
Kako to funkcionira na stvarnom projektu
Dobar primjer posljednjih odlomaka o „data chain”-u, ETL-u i sveprisutnim provjerama je sljedeći proces iz jednog stvarnog projekta:
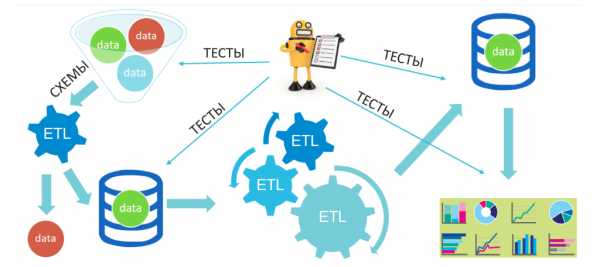
Ovdje u ulaznu „vrhunsku” fazu našeg sustava dolaze različiti podaci (naravno, pripremljeni od strane nas): valjani, nevaljani, miješani itd., zatim se filtriraju i odlaze u međuskladište, nakon čega ponovo prolaze kroz niz transformacija i smještaju se u konačno skladište, iz kojeg će se, zauzvrat, vršiti analitika, izgradnja data vitrina i pretraživanje poslovnih uvida. U takvom sustavu, ne provjeravajući funkcionalnost ETL procesa, fokusiramo se na kvalitetu podataka prije i nakon transformacija, kao i na izlazu u analitiku.
Sažimajući navedeno, bez obzira na mjesta gdje sam radio, svugdje sam bio uključen u Data projekte koji su imali sljedeće karakteristike:
- Samo putem automatizacije može se provjeriti određene slučajeve i postići prihvatljiv ciklus izdanja za poslovanje.
- Tester u takvom projektu je jedan od najcjenjenijih članova tima, jer donosi ogroman doprinos svakom sudioniku (brže testiranje, dobre podatke za Data Scientist-e, identifikacija nedostataka u ranim fazama).
- Nije važno radite li na vlastitoj opremi ili u oblacima - svi resursi su apstrahirani u klastere poput Hortonworks, Cloudera, Mesos, Kubernetes i sl.
- Projekti se temelje na mikroservisnom pristupu, prevladavaju distribuirana i paralelna računanja.
Napominjem da se, baveći se testiranjem u području Data Quality, tester помjera svoj profesionalni fokus na kod proizvoda i korištene alate.
Karakteristike Data Quality testiranja
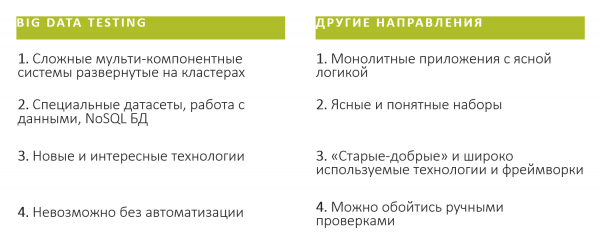
Osim toga, za sebe sam istaknuo sljedeće (odmah da naglasim VEOMA generalizirane i isključivo subjektivne) karakteristike testiranja u Data (Big Data) projektima (sustavima) i drugim područjima:
Koristitne veze
- Teorija: .
- EPAM
- Preporučeni materijali za početnike u Data Quality inženjerstvu:
- Besplatni tečaj na Stepik-u: .
- Tečaj na LinkedIn Learning: .
- Članci:
- ;
- ;
- ;
- Video:
- ;
- ;
Zaključak
Data Quality — ovo je vrlo mlada i perspektivna oblast, a biti deo nje znači biti deo nekog startupa. U okviru Data Quality-a, zaronit ćete u mnoštvo modernih i traženih tehnologija, ali najvažnije je to što će vam se otvoriti ogromne mogućnosti za generisanje i realizaciju vlastitih ideja. Moći ćete primeniti pristup stalnog unapređenja ne samo na projektu, već i za sebe, neprekidno se razvijajući kao stručnjak.
Izvor: habr.com
