

Prijevod članka pripremljen je posebno za studente tečaja .
— programer, entuzijast Go jezika i zaljubljenik u rešavanje složenih problema. Takođe je održavaoc Prometheusa i suosnivač Kubernetes SIG instrumentation. U prošlosti je bio inženjer produkcije u SoundCloudu i vodio je tim za nadgledanje u CoreOS-u. Trenutno radi u Google-u.
— inženjer infrastrukture u Improbable-u. Radoznalost ga vuče ka novim tehnologijama i problemima distribuiranih sistema. Ima iskustvo niskonivojnog programiranja u Intel-u, iskustvo doprinositelja u Mesos-u i produkcijsko iskustvo SRE svetskog nivoa u Improbable-u. Fokusira se na poboljšanje sveta mikroslužbi. Tri njegove ljubavi su: Golang, open source i odbojka.
Gledajući naš vodeći proizvod SpatialOS, možete naslutiti da je Improbable-u potrebna visoko dinamična oblačna infrastruktura globalnog obima sa desetinama Kubernetes klastera. Bili smo jedni od prvih koji su počeli koristiti sistem nadgledanja . Prometheus je sposoban da prati milionske metrike u realnom vremenu i dolazi sa moćnim jezikom upita koji omogućava izvlačenje potrebnih informacija.
Jednostavnost i pouzdanost Prometheusa su jedna od njegovih glavnih prednosti. Međutim, dostigavši određeni obim, suočili smo se s nekoliko nedostataka. Da bismo rešili te probleme, razvili smo — projekat otvorenog koda, razvijen od strane Improbable-a, za besprekorno transformisanje postojećih Prometheus klastera u jedinstveni sistem nadgledanja s neograničenim skladištem istorijskih podataka. Thanos je dostupan na Github-u. .
Naši ciljevi s Thanosom
Na određenom obimu javljaju se problemi koji nadilaze mogućnosti klasičnog Prometheusa. Kako pouzdano i ekonomično skladištiti petabajte istorijskih podataka? Može li se to uraditi bez kompromitovanja vremena odgovora na upit? Može li se pristupiti svim metrima smeštenim na različitim Prometheus serverima putem jednog API zahteva? Može li se na neki način spojiti replikovani podaci prikupljeni uz pomoc Prometheus HA?
Da bismo odgovorili na ta pitanja, stvorili smo Thanos. U sledećim odeljcima objašnjavamo kako smo pristupili rešenju ovih pitanja i objašnjavamo ciljeve koje smo imali.
Upit podataka iz više instanci Prometheusa (global query)
Prometheus nudi funkcionalan pristup sharding-u. Čak i jedan Prometheus server omogućava dovoljnu skalabilnost da oslobodi korisnike od složenosti horizontalnog sharding-a u praktično svim slučajevima upotrebe.
Iako je to sjajan model implementacije, često je potrebno pristupiti podacima na različitim Prometheus serverima putem jednog API ili UI — globalnog pogleda. Naravno, moguće je prikazati više upita na jednom Grafana panelu, ali svaki upit može biti izvršen samo na jedan Prometheus server. S druge strane, uz pomoć Thanosa možete upititi i agregirati podatke s nekoliko Prometheus servera, budući da su svi dostupni s jedne tačke.
Ranije, za postizanje globalnog pogleda u Improbable-u, organizovali smo naše instance Prometheus u višeslojnu . To je značilo kreiranje jednog meta-servera Prometheus koji prikuplja deo metrika sa svakog "leaf" servera.
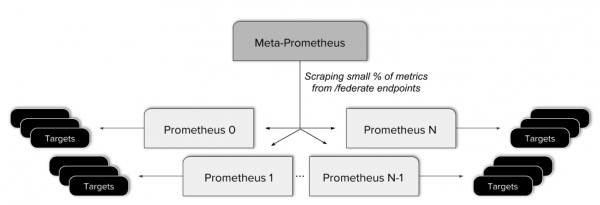
Ovaj pristup se pokazao problematičnim. Doveo je do komplikovanja konfiguracije, dodavanja dodatne potencijalne tačke kvara i primene složenih pravila za omogućavanje federated tački pristupa samo potrebnim podacima. Pored toga, takva federacija ne omogućava pravilan globalni pregled, jer nisu svi podaci dostupni iz jednog API upita.
Tome je blisko vezano jedinstveno predstavljanje podataka prikupljenih na visoko dostupnim (high-availability, HA) Prometheus serverima. HA model Prometheus-a samostalno prikuplja podatke dva puta, što je toliko jednostavno da ne može biti jednostavnije. Ipak, korišćenje objedinjene i deduplikovane verzije oba toka bilo bi mnogo praktičnije.
Naravno, u serverima Prometheus visoke dostupnosti postoji potreba. U Improbable-u ozbiljno shvatamo minutnu analizu podataka, ali postojanje jednog instance Prometheus u klasteru predstavlja jedinstvenu tačku kvara. Svaka greška u konfiguraciji ili kvar opreme može potencijalno dovesti do gubitka važnih podataka. Čak i jednostavno implementiranje može dovesti do malih prekida u prikupljanju metrika, jer ponovno pokretanje može značajno produžiti vreme između skrapinga.
Pouzdano čuvanje istorijskih podataka
Jeftina, brza i dugotrajna pohrana metrika je naš san (koji dijele većina korisnika Prometheusa). U Improbableu smo bili prisiljeni postaviti vrijeme pohrane metrika na devet dana (za Prometheus 1.8). To postavlja očite ograničenja s obzirom na to koliko daleko možemo pogledati unatrag.
Prometheus 2.0 je u tom smislu bolji, jer broj vremenskih serija više ne utječe na ukupnu izvedbu poslužitelja (vidi ). Ipak, Prometheus pohranjuje podatke na lokalnom disku. Iako visoko učinkovito kompresiranje podataka može značajno smanjiti korištenje lokalnog SSD-a, na kraju i dalje postoji ograničenje na količinu pohranjenih povijesnih podataka.
Osim toga, u Improbableu nam je stalo do pouzdanosti, jednostavnosti i troška. Veliki lokalni diskovi su složeniji za upravljanje i sigurnosno kopiranje. Oni su skuplji i zahtijevaju više alata za sigurnosno kopiranje, što dovodi do suvišne složenosti.
Downsampling
Čim smo počeli raditi s povijesnim podacima, shvatili smo da postoje temeljni problemi s O-velikim, koji čine upite sve sporijima i sporijima kada radimo s podacima iz tjedana, mjeseci i godina.
Standardno rješenje za ovaj problem je (downsampling) — smanjenje frekvencije uzorkovanja signala. Smanjenjem uzorkovanja možemo "skratiti" do većeg vremenskog raspona i održavati isti broj uzoraka, što omogućuje održavanje brzine upita.
Downsampling starih podataka je neizbježni zahtjev bilo kakvog rješenja za dugoročnu pohranu i nadmašuje obični Prometheus.
Dodatni ciljevi
Jedan od prvotnih ciljeva projekta Thanos bio je besprijekorna integracija sa svim postojećim instalacijama Prometheusa. Drugi cilj je bio jednostavna upotreba s minimalnom barijerom ulaska. Sve ovisnosti trebaju biti lako zadovoljene kako za male, tako i za velike korisnike, što također podrazumijeva neznatnu osnovnu cijenu.
Arhitektura Thanosa
Nakon što su u prethodnom odjeljku navedeni naši ciljevi, ajmo raditi na njima i vidjeti kako Thanos rješava ove probleme.
Globalni prikaz
Da bismo dobili globalni pregled iznad postojećih instanci Prometheusa, moramo povezati jedinstvenu ulaznu točku zahtjeva sa svim serverima. To upravo čini komponenta Thanos. . Raspoređuje se pored svakog servera Prometheus i djeluje kao proxy, opslužujući lokalne podatke Prometheus putem gRPC sučelja Store API, koje omogućava odabir vremenskih serija podataka prema oznakama i vremenskom rasponu.
S druge strane nalazi se horizontalno skalabilna komponenta Querier bez stanja, koja radi malo više od jednostavnog odgovaranja na zahtjeve PromQL putem standardnog Prometheus HTTP API. Komponente Querier, Sidecar i drugi Thanos komuniciraju putem .
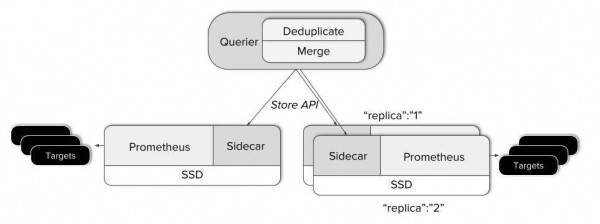
- Querier, prilikom primanja zahtjeva, povezuje se s odgovarajućim serverom Store API, odnosno s našim Sidecar-ima, i dobiva vremenske serije podataka s odgovarajućih Prometheus servera.
- Nakon toga spaja odgovore i izvršava PromQL upit. Querier može spajati kako nepoklapajuće podatke, tako i duplicirane podatke s HA servera Prometheus.
To rješava najveći dio naše zagonetke — spajanje podataka s izoliranih servera Prometheus u jedinstveni prikaz. U stvari, Thanos se može koristiti samo zbog ove mogućnosti. Nema potrebe za promjenama na postojećim Prometheus serverima!
Neograničeno vrijeme pohrane!
Međutim, prije ili kasnije, željet ćemo pohraniti podatke koji izlaze izvan uobičajenog vremena pohrane Prometheus. Za pohranu povijesnih podataka odabrali smo objektno skladište. Ono je široko dostupno u bilo kojem oblaku, kao i u lokalnim podatkovnim centrima, i vrlo je ekonomski isplativo. Osim toga, gotovo svako objektno skladište dostupno je putem dobro poznatog S3 API.
Prometheus zapisuje podatke iz radne memorije na disk otprilike svaka dva sata. Blok pohranjenih podataka sadrži sve podatke za fiksni vremenski interval i nepromjenjiv je. To je vrlo zgodno, jer Thanos Sidecar može jednostavno pregledati katalog podataka Prometheus, a kako se novi blokovi pojavljuju, učitavati ih u bačve objektne pohrane.
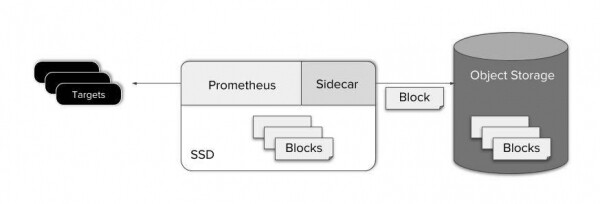
Učitavanje u objektno skladište odmah nakon zapisivanja na disk također omogućava zadržavanje jednostavnosti “scrapera” (Prometheus i Thanos Sidecar). Što pojednostavljuje održavanje, troškove i dizajn sustava.
Kao što vidite, backup podataka se ostvaruje vrlo jednostavno. No, što je s upitima podacima u objektnoj pohrani?
Thanos Store komponenta djeluje kao proxy za dohvaćanje podataka iz objektne pohrane. Poput Thanos Sidecara, sudjeluje u gossip klasteru i implementira Store API. Tako postojeći Querieri mogu gledati na njega kao Sidecar, kao još jedan izvor vremenskih serija podataka — nije potrebno nikakvo posebno podešavanje.
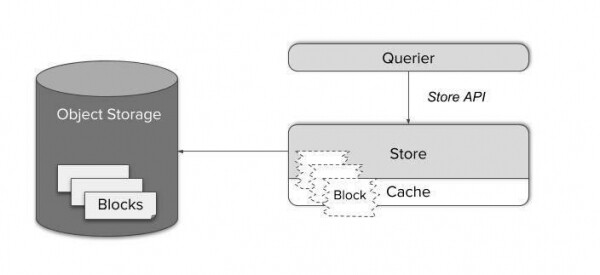
Blokovi vremenskih serija podataka se sastoje od nekoliko velikih datoteka. Dohvaćanje po zahtjevu bi bilo prilično neefikasno, a lokalno keširanje bi zahtijevalo ogromnu memoriju i diskovni prostor.
Umjesto toga, Store Gateway zna kako upravljati formatom pohrane Prometheusa. Zahvaljujući inteligentnom planerima upita i keširanju samo potrebnih indeksnih dijelova blokova, postalo je moguće smanjiti složene upite na minimalan broj HTTP zahtjeva prema datotekama objektne pohrane. Tako je moguće smanjiti broj zahtjeva za četiri do šest redoslijeda i postići vrijeme odgovora koje je u cjelini teško razlikovati od zahtjeva za podacima na lokalnom SSD-u.
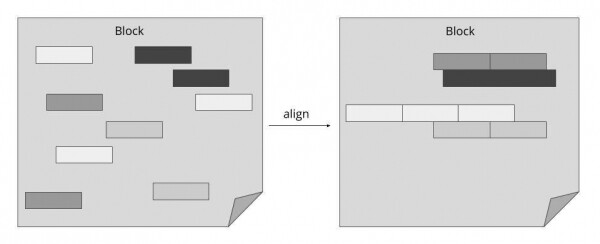
Kao što je prikazano na gornjem dijagramu, Thanos Querier značajno smanjuje troškove za jedan zahtjev za podacima u objektnoj pohrani, koristeći format pohrane Prometheusa i grupirajući povezane podatke blizu sebe. Koristeći ovaj pristup, možemo spojiti mnoštvo pojedinačnih zahtjeva u minimalan broj bulk operacija.
Kompaktiranje i downsampling
Nakon što je novi blok vremenskih serija podataka uspješno učitan u objektno skladište, tretiramo ga kao "historijske" podatke koji su odmah dostupni putem Store Gateway-a.
Međutim, nakon nekog vremena, blokovi iz jednog izvora (Prometheus s Sidecarom) se kumuliraju i više ne koriste sav potencijal indeksiranja. Da bismo riješili ovaj problem, uveli smo još jednu komponentu pod nazivom Compactor. Ona jednostavno primjenjuje lokalni mehanizam kompresije Prometheusa na povijesne podatke u objektnoj pohrani i može se pokrenuti kao jednostavna periodična batch zadaća.
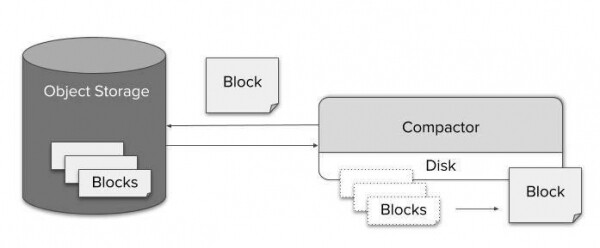
Zahvaljujući učinkovitoj kompresiji, zahtjev za pohranu tijekom dužeg vremenskog razdoblja ne predstavlja problem s aspekta veličine podataka. Međutim, potencijalni trošak dekompresije milijarde vrijednosti i njihovo propuštanje kroz obradu zahtjeva neizbježno će dovesti do oštrog povećanja vremena izvršenja zahtjeva. S druge strane, budući da na svaki piksel ekrana dolazi stotine točaka podataka, postaje nemoguće čak ni vizualizirati podatke u punoj rezoluciji. Stoga, downsampling nije samo moguć, već neće dovesti do značajnog gubitka točnosti.
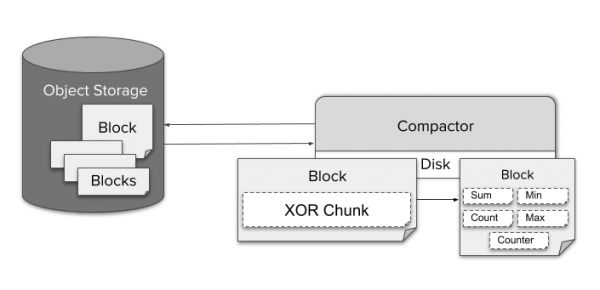
Za downsampling podataka, Compactor neprekidno agregira podatke s rezolucijom od pet minuta i jednog sata. Za svaki neobraden fragment, kodiran uz pomoć TSDB XOR kompresije, pohranjuju se različite vrste agregiranih podataka, poput min, max ili sum za jedan blok. To omogućuje Querieru da automatski odabere agregat koji odgovara danom PromQL zahtjevu.
Za korištenje podataka s nižom preciznošću korisniku nije potrebna nikakva posebna konfiguracija. Querier automatski prelazi između različitih rezolucija i neobrađenih podataka dok korisnik povećava ili smanjuje zoom. Ako se želi, korisnik može izravno upravljati tim putem parametra “step” u zahtjevu.
Budući da je trošak pohrane jednog GB mali, Thanos po defaultu pohranjuje izvorne podatke, podatke s rezolucijom od pet minuta i jednog sata. Nema potrebe za brisanjem izvornih podataka.
Recording pravila
Čak i s Thanos recording pravilima predstavljaju bitan dio stacka za nadzor. Smanjuju složenost, kašnjenje i trošak zahtjeva. Također su zgodni korisnicima za dobivanje agregiranih podataka o metrikama. Thanos se temelji na standardnim instancama Prometheusa, stoga je sasvim prihvatljivo pohranjivati recording i alerting pravila na postojećem Prometheus serveru. Međutim, u nekim slučajevima to može biti nedovoljno:
- Globalni alert i pravilo (na primjer, obavijest kada usluga ne radi na više od dva od tri klastera).
- Pravilo za podatke izvan lokalne pohrane.
- Nastojanje pohraniti sva pravila i alerte na jednom mjestu.
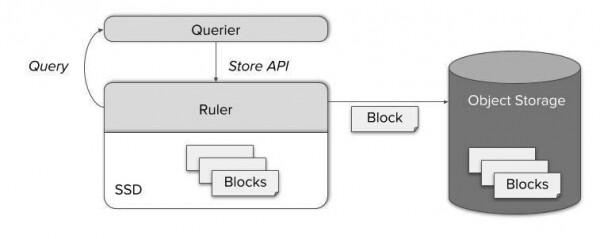
Za sve te slučajeve, Thanos uključuje zasebnu komponentu nazvanu Ruler, koja izračunava pravila i upozorenja putem Thanos upita. Pružajući poznati StoreAPI, Query čvor može pristupiti svežim izračunatim metrikama. Kasnije se također čuvaju u objektnoj pohrani i postaju dostupne putem Store Gateway-a.
Moć Thanosa
Thanos je dovoljno fleksibilan da ga možete prilagoditi svojim potrebama. To je posebno korisno prilikom migracije sa jednostavnog Prometheusa. Pogledajmo na brz način na mali primjer onoga što smo naučili o komponentama Thanosa. Evo kako možete preseliti svoj vanilla Prometheus u svijet “neograničenog pohranjivanja metrika”:
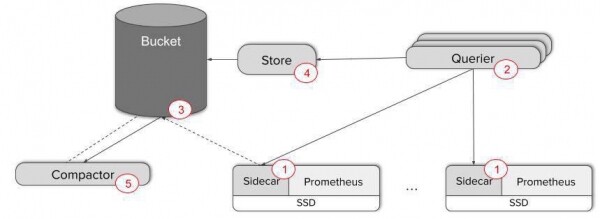
- Dodajte Thanos Sidecar na svoje Prometheus servere - na primjer, susjedni kontejner u Kubernetes podu.
- Postavite nekoliko replika Thanos Queriersa za mogućnost pregleda podataka. U ovoj fazi lako je postaviti gossip između Scraper-a i Queriersa. Da biste provjerili interakciju komponenata, koristite metriku 'thanos_cluster_members'.
Samo ta dva koraka dovoljna su da osiguraju globalni pregled i besprijekornu dedupliciranje podataka od potencijalnih HA-replika Prometheus-a! Jednostavno povežite svoje nadzorne ploče na HTTP end-point Queriersa ili koristite Thanos UI sučelje izravno.
Međutim, ako vam je potrebna sigurnosna kopija metrika i dugoročno pohranjivanje, potrebno je napraviti još tri koraka:
- Stvorite AWS S3 ili GCS bucket. Konfigurirajte Sidecar za kopiranje podataka u te buckete. Sada možete minimizirati lokalno pohranjivanje podataka.
- Postavite Store Gateway i povežite ga s postojećim gossip-klasterom. Sada možete slati upite za podatke u sigurnosnim kopijama!
- Postavite Compactor kako biste poboljšali efikasnost upita za duže vremenske okvire koristeći komprimiranje i downsampling.
Ako želite saznati više, slobodno pogledajte naše i !
Samo pet koraka pretvorili smo Prometheus u pouzdan sustav nadzora s globalnim pregledom, neograničenim vremenom pohrane i potencijalnom visokom dostupnošću metrika.
Pull request: potrebni ste nam!
od početka je bio projekt s otvorenim izvorom. Besprijekorna integracija s Prometheusom i mogućnost korištenja samo dijela Thanosa čini ga odličnim izborom za skaliranje sustava nadzora bez suvišnih napora.
Uvijek smo otvoreni za GitHub Pull Request i Issues. U isto vrijeme, slobodno nas kontaktirajte putem Github Issues ili slacks., ako imate pitanja ili povratne informacije, ili želite podijeliti svoje iskustvo korištenja! Ako vam se sviđa ono što radimo u Improbableu, slobodno nas kontaktirajte — !
Izvor: habr.com
