

Svima dobro!
Moje ime je Nikita, ja sam tim lider inženjerskog tima Cian. Jedna od mojih odgovornosti u firmi je snižavanje broja incidenata vezanih za infrastrukturu u produkciji na nulu.
Ono o čemu ćemo dalje govoriti nanijelo nam je mnogo boli, a cilj ovog članka je spriječiti druge da ponove naše greške ili barem minimizirati njihov utjecaj.
Preamvula
Davno, kada je Cian bio sastavljen od monolita, i kada nije bilo nikakvih tragova mikroservisa, mjerili smo dostupnost resursa provjerom 3-5 stranica.
Odgovaraju — sve je u redu, ne odgovaraju duže vrijeme — alert. Koliko vremena moraju ne raditi da bi se to smatralo incidentom, odlučivali su ljudi na sastancima. Inženjerski tim uvijek je sudjelovao u istragama incidenata. Kada je istraga završena, pisali smo postmortem — svojevrsno izvješće na mail u formatu: što se dogodilo, koliko je trajalo, što smo učinili u tom trenutku, što ćemo učiniti u budućnosti.
Glavne stranice web sajta ili kako shvaćamo da smo udarili u dno
Kako bismo mogli razumjeti prioritet greške, izdvojili smo najkritičnije stranice web sajta za poslovne funkcionalnosti. Na temelju njih mjerimo broj uspješnih/neuspješnih zahtjeva i timeoutova. Tako mjerimo uptime.
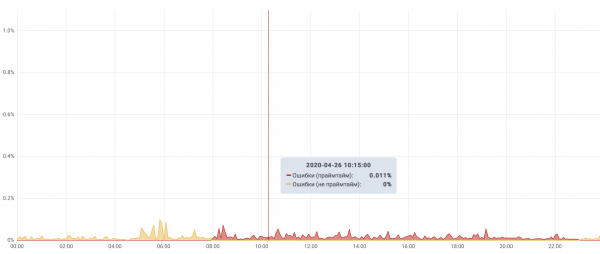
Recimo, otkrili smo da postoji nekoliko izuzetno važnih sekcija web sajta koje su odgovorne za glavnu uslugu — pretraživanje i objavljivanje oglasa. Ako broj zahtjeva koji su završili greškom premaši 1% — to je kritični incident. Ako tijekom 15 minuta u prime time-u postotak grešaka premaši 0,1% — to se također smatra kritičnim incidentom. Ovi kriteriji pokrivaju većinu incidenata, dok ostali izlaze iz okvira ovog članka.
Top najboljih incidenata Ciana
Dakle, definitivno smo naučili prepoznati kada je incident nastao.
Sada je svaki incident detaljno opisan i odražen u epiku Jira. Usput, za ovo smo otvorili poseban projekt, nazvali ga FAIL — u njemu je moguće kreirati samo epike.
Ako prikupimo sve greške u posljednjih nekoliko godina, vode:
- incidente vezane uz mssql;
- incidente nastale zbog vanjskih faktora;
- greške administratora.
Pogledajmo detaljnije greške administratora, kao i neke druge zanimljive greške.
Peto mjesto — 'Uređujemo DNS'
Bio je to oblačan utorak. Odlučili smo srediti DNS klaster.
Željeli smo prebaciti interne DNS poslužitelje s bind-a na powerdns, dodijelivši potpuno odvojene poslužitelje, na kojima nema ništa osim DNS-a.
Postavili smo po jedan DNS poslužitelj na svaku lokaciju naših DC-a, i došao je trenutak preseljenja zona iz bind-a u powerdns i prebacivanja infrastrukture na nove poslužitelje.
U samom vrhuncu preseljenja ostao je samo jedan od svih poslužitelja, koji su bili navedeni u lokalnim cache-ima bind-a na svim poslužiteljima, koji se nalazio u data centru u Sankt Peterburgu. Ovaj DC je prvotno bio proglašen nekritičnim za nas, ali je iznenada postao jedinstvena točka kvara.
Baš u tom razdoblju preseljenja pao je kanal između Moskve i Sankt Peterburga. U praktički smo ostali bez DNS-a pet minuta i podigli se kada hosting otklonio kvar.
Zaključci:
Ako smo ranije zanemarivali vanjske čimbenike tijekom pripreme za radove, sada su i oni uključeni u popis na što se pripremamo. I sada težimo tome da su svi komponente rezervirane n-2, a tijekom radova taj nivo možemo smanjiti na n-1.
- Tijekom sastavljanja plana djelovanja označite točke gdje bi usluga mogla pasti i osmislite scenarij gdje je sve otišlo "loše do lošeg", unaprijed.
- Rasporedite interne DNS poslužitelje po različitim geo-lokacijama/data centrima/rakovima/komutatorima/povezanim točkama.
- Na svakom poslužitelju postavite lokalni caching DNS poslužitelj koji preusmjerava zahtjeve na glavne DNS poslužitelje, a u slučaju njegove nedostupnosti odgovarat će iz cache-a.
Četvrto mjesto — "Sređivanje u Nginxu"
Jednog lijepog dana naš tim odlučio je da je "dosta to trpljenja" i započeo je proces refaktoriranja nginx konfiguracija. Glavni cilj — dovesti konfiguracije u intuitivnu strukturu. Prije je sve bilo "istorijski ranije" i nije imalo nikakvu logiku. Sada je svaki server_name iznesen u istoimeni fajl i svi su konfiguracije raspoređene po mapama. Usput — konfiguracija sadrži 253949 redaka ili 7836520 znakova i zauzima gotovo 7 megabajta. Gornja razina strukture:
Struktura Nginxa
├── pristup
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Značajno je bolje, ali u procesu preimenovanja i raspodjele konfiguracija, neki od njih su imali pogrešnu ekstenziju i nisu došli u direktivu include *.conf. Kao posljedica — neki hostovi su postali nedostupni i vraćali 301 na glavni. Budući da je kod odgovora bio ne 5xx/4xx, to nije primijećeno odmah, već tek ujutro. Nakon toga, počeli smo pisati testove za provjeru infrastrukturalnih komponenti.
Zaključci:
- Ispravno strukturirajte konfiguracije (ne samo nginx) i razmislite o strukturi u ranoj fazi projekta. Tako ćete ih učiniti razumljivijima timu, što će smanjiti TTM.
- Za neke infrastrukturne komponente pišite testove. Na primjer: provjera da svi ključni server_name vraćaju ispravan status, + tijelo odgovora. Bit će dovoljno imati na raspolaganju samo nekoliko skripti koje provjeravaju osnovne funkcije komponente, kako ne biste nervozno prisjećali se u 3 sata ujutro što još treba provjeriti.
Treće mjesto — „Iznenada je ponestalo mjesta u Cassandri“
Podaci su se postepeno povećavali, i sve je bilo dobro do trenutka kada su u klasteru Cassandri počeli padati repair veliki keyspace-ovi, jer na njima ne može odraditi compaction.
Jednog kišnog dana klaster se gotovo pretvorio u bundevu, a točno:
- ostalo je oko 20% ukupno u klasteru;
- ne može se potpuno dodati node, jer cleanup nakon dodavanja node ne prolazi zbog nedostatka mjesta na particijama;
- performanse polako padaju, jer compaction ne radi;
- klaster radi u hitnom režimu.
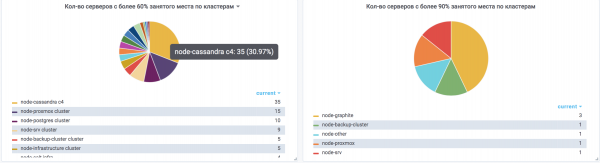
Izlaz — dodali smo još 5 nodova bez čišćenja, nakon čega smo počeli postupno povlačiti iz klastera i ponovo uvođenje, kao prazne nodove, na kojima je nestalo prostora. Vremena je potrošeno daleko više nego što bismo želeli. Postojao je rizik od djelomične ili potpune nedostupnosti klastera.
Zaključci:
- Na svim serverima Cassandra ne bi smjelo biti zauzeto više od 60% prostora na svakom disku.
- Treba da budu opterećeni ne više od 50% po CPU-u.
- Ne biste trebali zapostaviti planiranje kapaciteta i trebate ga razmatrati za svaku komponentu, uzimajući u obzir njenu specifičnost.
- Što više nodova u klasteru, to bolje. Serveri koji sadrže mali obim podataka brže se prekonfiguriraju, i takav klaster je lakše reanimirati.
Drugo mesto — "Nestali podaci iz Consul key-value skladišta"
Za otkrivanje servisa, kao i mnogi, koristimo Consul. No, naš key-value se koristi i za blue-green postavljanje monolita. Tamo se čuva informacija o aktivnim i neaktivnim upstreamima, koji se menjaju mesta tokom deploy-a. Za to je napisan servis za deploy koji je komunicirao s KV. U nekom trenutku, podaci iz KV su nestali. Obnovili smo ih iz pamćenja, ali s nizom grešaka. Kao posledica, prilikom postavljanja, opterećenje na upstreamima raspodeljeno je nerazmjerno, a mi smo dobili mnogo grešaka 502 zbog preopterećenja backendova po CPU-u. Na kraju smo prešli sa Consul KV na Postgres, odakle ih više nije tako lako ukloniti.
Zaključci:
- Servisi bez bilo kakve autorizacije ne bi trebali sadržavati kritične podatke za rad web stranice. Na primer, ako nemate autorizaciju u ES — bolje bi bilo zabraniti pristup na nivou mreže od svuda gde nije potreban, ostaviti samo neophodne, kao i postaviti action.destructive_requires_name: true.
- Vežbajte mehanizam rezervnog kopiranja i obnove unapred. Na primer, unapred napravite skriptu (recimo, u Pythonu) koja umije da pravi i rezervne kopije i da obnavlja.
Prvo mesto — "Kapetan nevidljivost"
U nekom trenutku primijetili smo nerazmjerno opterećenje na upstream nginx-u kada je u backendu bilo više od 10 servera. Budući da je round-robin usmjeravao zahtjeve od prvog do posljednjeg upstream-a redoslijedom, a svaki reload nginx-a je počinjao ispočetka, prvim upstream-ima uvijek je stizalo više zahtjeva nego ostalima. Kao posljedica, oni su radili sporije, a cijeli je sajt patio. To je postajalo sve primjetnije s povećanjem količine prometa. Samo ažuriranje nginx-a za uključivanje random opcije nije bio dovoljno — trebalo je prepravljati tonu lua koda koji nije radio na verziji 1.15 (u to vrijeme). Morali smo patchirati naš nginx 1.14.2, dodavši podršku za random. To je riješilo problem. Ova greška pobjeđuje u nominaciji "kapetan nejasnoće."
Zaključci:
Bilo je jako zanimljivo i uzbudljivo istraživati ovu grešku).
- Postavite monitoring tako da pomaže brzo otkrivanje sličnih fluktuacija. Na primjer, možete koristiti ELK za praćenje rps-a za svaki backend svakog upstream-a, prateći njihovo vrijeme odgovora s gledišta nginx-a. U ovom slučaju to nam je pomoglo da otkrijemo problem.
Većina grešaka mogla bi se izbjeći uz pomniji pristup onome što radite. Uvijek treba imati na umu Murphyjev zakon: Sve što može poći po zlu poći će po zlu, i graditi komponente vodeći se time.
Izvor: habr.com
