

U našim projektima koristimo mikroservisnu arhitekturu. Kada dođe do uskih grla u performansama, obično se troši puno vremena na praćenje i analizu logova. Kada se bilježe vremenski okviri pojedinačnih operacija u log datoteku, obično je teško shvatiti što je uzrokovalo poziv tih operacija, pratiti redoslijed radnji ili vremensko pomjeranje jedne operacije u odnosu na drugu u različitim servisima.
Kako bismo smanjili ručni rad, odlučili smo iskoristiti jedan od alata za praćenje. O tome kako i za što se može koristiti praćenje i kako smo to mi radili, bit će govora u ovom članku.
Koje se probleme može riješiti pomoću praćenja
- Pronaći uska grla u performansama kako unutar jednog servisa, tako i u cijelom stablu izvršavanja između svih uključenih servisa. Na primjer:
- Mnogo kratkih uzastopnih poziva između servisa, primjerice, za geokodiranje ili za bazu podataka.
- Dugotrajna čekanja ulaza i izlaza, kao što su prijenos podataka preko mreže ili čitanje s diska.
- Dugo parsiranje podataka.
- Duge operacije koje zahtijevaju CPU.
- Dijelovi koda koji nisu potrebni za dobivanje konačnog rezultata i mogu se ukloniti ili pokrenuti odloženo.
- Jasno razumjeti u kojem redoslijedu se što poziva i što se događa kada se izvršava operacija.

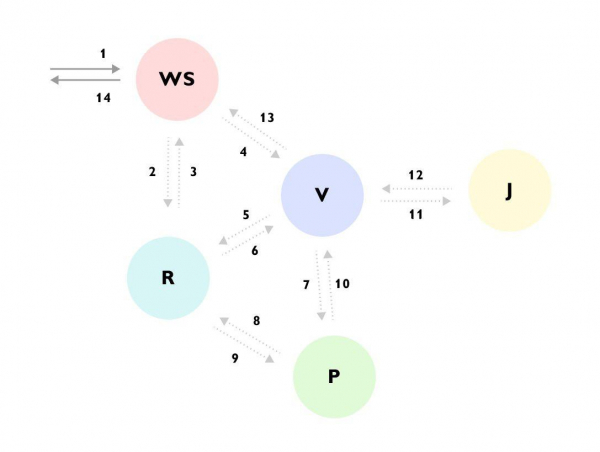
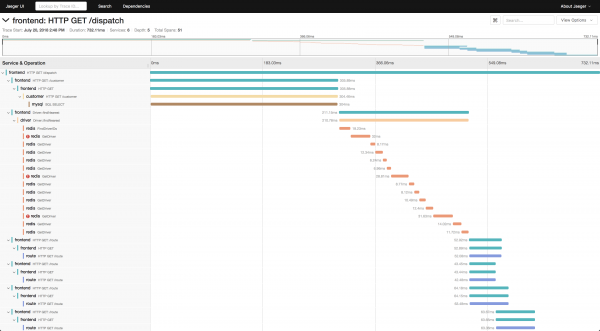
Vidljivo je da je, primjerice, Upit stigao u servis WS -> servis WS je dopunio podatke putem servisa R -> zatim je poslao upit u servis V -> servis V je preuzeo puno podataka iz servisa R -> otišao je u servis P -> servis P je još jednom otišao u servis R -> servis V je ignorirao rezultat i otišao u servis J -> i tek tada vratio odgovor u servis WS, pri čemu je nastavio u pozadini izračunavati nešto drugo.
Bez takvog praćenja ili detaljne dokumentacije o cijelom procesu vrlo je teško shvatiti što se događa kada prvi put pogledate kod, a kod je također raspršen po različitim servisima i skriven iza mnoštva binova i sučelja. - Prikupljanje informacija o stablu izvršavanja za kasniju odgođenu analizu. U svakoj fazi izvršavanja u praćenje se može dodati informacija koja je dostupna u toj fazi, a zatim istražiti koje su ulazne informacije dovele do takvog scenarija. Na primjer:
- ID korisnika
- Prava
- Tip odabrane metode
- Log ili greška izvršavanja
- Pretvaranje tragova u podskup metrika i daljnja analiza u obliku metrika.
Što može bilježiti trag. Span
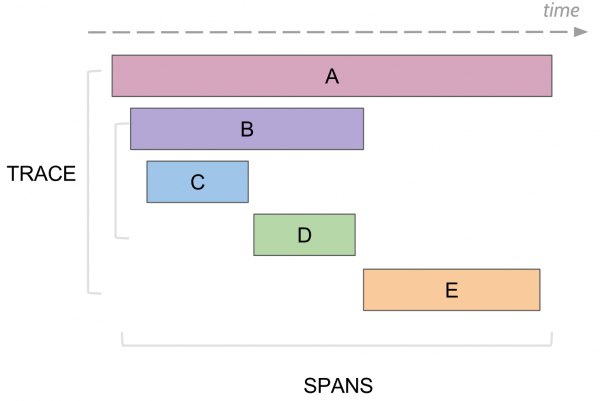
U tragovima postoji pojam span, koji je ekvivalent jednoj zabilježenoj stavci u konzoli. Span ima:
- Naziv, obično je to naziv metode koja se izvodila
- Naziv servisa u kojem je generiran span
- Vlastiti jedinstveni ID
- Neka metainformacija u obliku key/value koja je zabilježena. Na primjer, parametri metode ili je metoda završila greškom ili ne
- Vrijeme početka i završetka izvršavanja ovog spana
- ID roditeljskog spana
Svaki span se šalje u kolektor spanova radi pohrane u bazu za kasniji pregled čim završi svoje izvršavanje. Kasnije, može se izgraditi stablo svih spanova povezujući ih po id roditelja. Tijekom analize može se pronaći, na primjer, svi spanovi u nekom servisu koji su trajali duže od nekog vremena. Zatim, odlaskom na određeni span, može se vidjeti cijelo stablo iznad i ispod tog spana.
Opentrace, Jagger i kako smo to implementirali za svoje projekte
Postoji opći standard , koji opisuje kako i što treba prikupljati, ne vezujući tragove za konkretnu implementaciju na nekom jeziku. Na primjer, u Javi se sav rad s tragovima obavlja putem zajedničkog API-ja Opentrace, a ispod njega može se skrivati, primjerice, Jaeger ili prazna zadana implementacija koja ne radi ništa.
Kod nas se koristi kao implementacija Opentrace. Sastoji se od nekoliko komponenti:
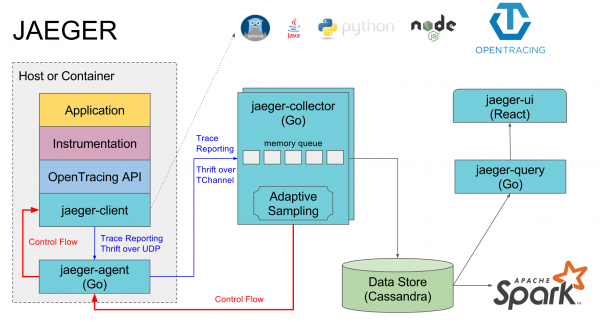
- Jaeger-agent — lokalni agent koji obično radi na svakoj mašini i u njega zabilježavaju servisi na lokalni zadani port. Ako agenta nema, tragovi svih servisa na toj mašini obično su isključeni.
- Jaeger-collector — u njega svi agenti šalju prikupljene tragove, a on ih pohranjuje u odabranu bazu podataka.
- Baza podataka — njihova preferirana je Cassandra, ali kod nas se koristi Elasticsearch, postoji implementacija i za nekoliko drugih baza i in-memory implementacija koja ne pohranjuje ništa na disk.
- Jaeger-query — to je servis koji pristupa bazi podataka i isporučuje već prikupljene tragove za analizu.
- Jaeger-ui — web sučelje za pretraživanje i pregled tragova, koje se povezuje s jaeger-query.
Odvojena komponenta može se smatrati implementacijom opentrace jaeger za konkretne jezike, kroz koju se spanovi šalju u jaeger-agent.
sve se svodi na implementaciju sučelja io.opentracing.Tracer, nakon čega će svi tragovi prolaziti kroz njega do pravog agenta.
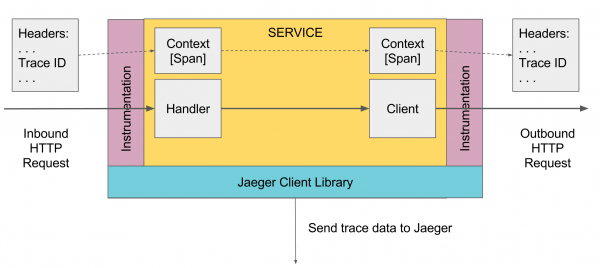
Također se za Spring komponente može povezati i implementacija od Jaeger koja automatski konfigurira praćenje za sve što prolazi kroz ove komponente, poput http zahtjeva u kontrolere, zahtjeva prema bazi podataka putem jdbc itd.
Zapisivanje tragova u Javi
Negdje na najvišoj razini treba biti stvoren prvi Span, što se može učiniti automatski, primjerice, kontrolerom Springa prilikom primanja zahtjeva, ili ručno ako takvog nema. Zatim se prosljeđuje kroz Scope niže. Ako neki metod želi dodati Span, uzima iz Scope trenutni activeSpan, stvara novi Span i postavlja da mu je roditelj trenutni activeSpan, te čini novi Span aktivnim. Prilikom pozivanja vanjskih servisa, trenutni aktivni span se prosljeđuje njima, a ti servisi kreiraju nove spane povezane s tim spanom.
Sav rad se odvija kroz instancu Tracer, koju možete dobiti putem mehanizma DI, ili GlobalTracer.get() kao globalnu varijablu, ako mehanizam DI ne radi. Ako tracer nije inicijaliziran, prema zadanim postavkama vratit će se NoopTracer koji ne radi ništa.
Nakon toga se iz tracer-a preko ScopeManager-a dobiva trenutni scope, stvara se novi scope od trenutnog s povezanim novim spanom, a potom se zatvara stvoreni Scope, koji zatvara stvoreni span i vraća prethodni Scope u aktivno stanje. Scope je vezan uz nit, stoga kod višedretvenog programiranja treba imati na umu da se aktivni span mora prenositi u drugu nit, radi daljnje aktivacije Scope-a druge niti povezano s tim spanom.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Radite stvari.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // KORAK 2 IZGORE: ponovo aktivirajte Span u povratnom pozivu, proslijedite true da
            // startActive() ako/kada se Span treba završiti.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Za višekratno programiranje postoje TracedExecutorService i slični omotači koji automatski prosljeđuju trenutni span u niti prilikom pokretanja asinkronih zadataka:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Za vanjske http zahtjeve postoji
HttpClient httpClient = new TracingHttpClientBuilder().build();Problemi s kojima smo se susreli
- Bini i DI ne rade uvijek ako se tracer ne koristi u servisu ili komponenti, tada Tracer možda neće raditi i bit će potrebno koristiti GlobalTracer.get().
- Anotacije ne rade ako to nije komponenta ili servis, ili ako se poziv metode događa iz susjedne metode iste klase. Treba biti oprezan, provjeriti što radi, i koristiti ručno stvaranje tračnica ako @Traced ne funkcioniše. Također se može priključiti dodatni kompajler za java anotacije, onda bi trebali raditi svugdje.
- U starim spring i spring boot verzijama automatska konfiguracija opentracing spring clouda ne radi zbog bugova u DI, tako da ako želite da automatski rade tračnice u komponentama springa možete napraviti po analogiji sa
- U groovyju ne radi try with resources, mora se obavezno koristiti try finally.
- Za svaki servis treba navesti svoj spring.application.name pod kojim će se logirati tračnice. Osim toga, treba imati odvojeni naziv za produkciju i testiranje, kako se ne bi miješali.
- Ako se koristi GlobalTracer i tomcat, svi servisi pokrenuti u tom tomcatu imaju jedan GlobalTracer, stoga će imati isto ime servisa.
- Pri dodavanju tračnica u metodu, treba biti siguran da se ne poziva u petlji više puta. Treba dodati jedan zajednički trač za sve pozive, koji će zabilježiti ukupno vrijeme trajanja. Inače će doći do prekomjernog opterećenja.
- Jednom smo u jaeger-ui napravili prevelike zahtjeve za veliku količinu tračnica i budući da nismo čekali odgovor, ponovno smo to učinili. Kao rezultat, jaeger-query je počeo trošiti puno memorije i usporavao elastičan sustav. Pomoglo je ponovno pokretanje jaeger-query-a.
Uzorak, pohrana i pregled tračnica
Postoje tri tipa :
- Const koji šalje i pohranjuje sve tračnice.
- Probabilistički koji filtrira tračnice s nekom zadatom vjerojatnošću.
- Limitiranje brzine koje ograničava broj tragova u sekundi. Ove postavke mogu se konfigurirati na klijentu, ili na jaeger-agentu ili u kolektoru. Trenutno u našem stogu validatora koristimo const 1, jer nema mnogo zahtjeva, ali oduzimaju duže vrijeme. U budućnosti, ako ovo počne prekomjerno opterećivati sustav, možemo postaviti ograničenje.
Ako koristite Cassandru, po defaultu ona čuva tragove samo dva dana. Mi koristimo i tragovi se čuvaju zauvijek i ne brišu se. Za svaki dan kreira se jedan indeks, na primjer jaeger-service-2019-03-04. Kasnije je potrebno postaviti automatsko čišćenje starih tragova.
Da biste vidjeli tragove, potrebno je:
- Odabrati servis prema kojem želite filtrirati tragove, na primjer tomcat7-default za servis koji je pokrenut u Tomcat-u i ne može imati svoje ime.
- Zatim odabrati operaciju, vremenski okvir i minimalno trajanje operacije, na primjer od 10 sekundi, kako bismo uzeli samo duža izvršenja.

- Preći u jedan od tragova i provjeriti što je izazvalo usporavanje.

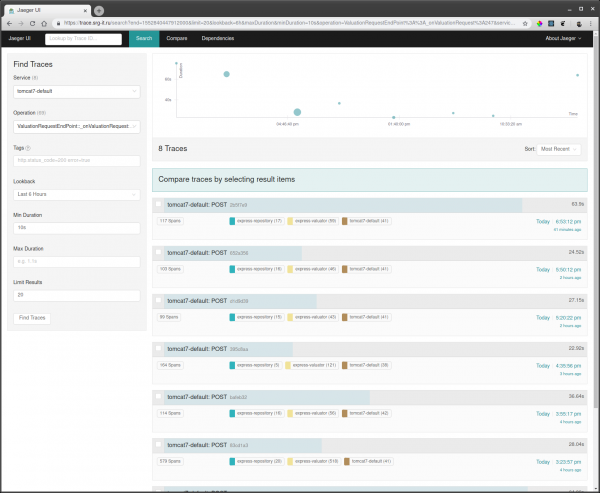
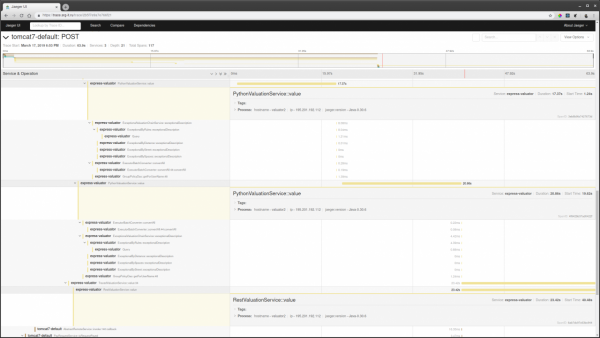
Također, ako je poznat neki id zahtjeva, može se pronaći trag prema tom id-u putem pretraživanja prema oznakama, ako je taj id evidentiran u span trag.
Dokumentacija
- Dokumentacija opentracing
- Dokumentacija jaeger
- Povezivanje jaeger java
- Povezivanje spring opentracing
Članci
- Jaeger Opentracing i mikroservisi u pravom projektu na PHP-u i Golangu
- Evolving Distributed Tracing at Uber Engineering
- Pokretanje Jaeger Agenata na bare metal
Video
- Kako smo koristili Jaeger i Prometheus za isporuku ultra brzih korisničkih upita — Bryan Boreham
- Intro: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, “Mala priča o velikoj pobjedi: OpenTracing, AWS i Jaeger”
Izvor: habr.com
