

Vjerojatno, danas već nitko ne preispituje pitanje zašto je potrebno prikupljati metrike servisa. Sljedeći logičan korak je postaviti alerte na prikupljene metrike, koji će vas obavještavati o bilo kojim odstupanjima u podacima putem kanala koji vam odgovaraju (e-mail, Slack, Telegram). U servisu za online rezervaciju hotela sve metrike naših servisa slijevaju se u InfluxDB i prikazuju u Grafani, a tamo je također postavljen osnovni alertering. Za zadatke poput „treba nešto izračunati i usporediti s tim“ koristimo Kapacitor.
Kapacitor je dio TICK stoga koji može obrađivati metrike iz InfluxDB-a. Može povezati nekoliko mjerenja (join), iz dobivenih podataka izračunati nešto korisno, zapisati rezultat nazad u InfluxDB i poslati alert u Slack/Telegram/e-mail.
Cijeli stog ima izvrsnu i detaljnu , ali uvijek će se naći korisne stvari koje u uputama nisu izričito navedene. U ovom članku odlučio sam prikupiti niz takvih korisnih neočitih savjeta (osnovna sintaksa TICKscript-a opisna je ) i pokazati kako ih možemo primijeniti, na primjeru rješavanja jedne od naših poteškoća.
Idemo!
float & int, greške u izračunima
Apsolutno standardan problem, rješava se putem cast-a:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Korištenje default()
Ako oznaka/polje nije ispunjeno, doći će do grešaka u izračunima:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill u join (inner vs outer)
Prema zadanim postavkama join će odbaciti točke bez podataka (inner).
Pri fill('null') bit će izvršen outer join, nakon čega je potrebno napraviti default() i popuniti prazne vrijednosti:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Tu ipak postoji nijansa. Ako je u gornjem primjeru jedna od serija (res1 ili res2) prazna, završna serija (data) također će biti prazna. O ovoj temi postoje nekoliko tiket-a na GitHub-u (, , ) – čekamo ispravke i malo patimo.
Korištenje uvjeta u izračunima (if u lambda)
|eval(lambda: if("value" > 0, true, false)
Zadnjih pet minuta iz cjevovoda za razdoblje
Na primjer, trebate usporediti vrijednosti zadnjih pet minuta s prethodnim tjednom. Možete uzeti dva paketa podataka s dva odvojena batch-a ili izvući dio podataka iz većeg razdoblja:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Alternativa za posljednjih pet minuta može biti korištenje čvora BarrierNode, koji isključuje podatke ranije od navedenog vremena:
|barrier()
        .period(5m)
Primjeri korištenja Go-ovih predložaka u porukama
Predlošci odgovaraju formatu iz paketa , u nastavku nekoliko često postavljanih zadataka.
if-else
Uređujemo, ne provociramo ljude suvišnim tekstom:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Sve je sada u redu{{ else }}Šefe, sve je pokvareno{{end}}'
    )
Dvije decimale nakon zareza u poruci
Poboljšavamo čitljivost poruke:
|alert()
    ...
    .message(
        'sada je vrijednost {{ index .Fields "value" | printf "%0.2f" }}'
    )
Rasparčavanje varijabli u poruci
U poruci izdvajamo više informacija za odgovor na pitanje „Zašto se to događa“?
var warnAlert = 10
  |alert()
    ...
    .message(
       'Današnja vrijednost manja od '+string(warnAlert)+'%'
    )
Jedinstveni identifikator alarma
Potrebna stvar kada u podacima ima više grupa, inače će se generirati samo jedan alarm:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Kustomni handleri
U velikom popisu handlera postoji exec, koji omogućuje izvršavanje vlastitog skripata s proslijeđenim parametrima (stdin) – kreativnost bez sumnje!
Jedan od naših prilagođenih handlera je mali Python skript za slanje obavijesti na Slack.
Isprva smo željeli slati sliku iz Grafane, zaštićene autorizacijom, u poruci. Nakon toga – pisati OK u nit prethodnog alarma iz iste grupe, a ne kao zasebnu poruku. Još malo kasnije – dodavati u poruku najčešću grešku u zadnjih X minuta.
Odvojena tema – povezivanje s drugim servisima i bilo kakve akcije inicirane alarmom (samo ako vaša provjera funkcionira dovoljno dobro).
Primjer opisa handlera, gdje je slack_handler.py naš vlastiti skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Kako debagirati?
Opcija s ispisom u log:
|log()
      .level("error")
      .prefix("something")
Gledati (cli): kapacitor -url :9092 logs lvl=error
Opcija s httpOut
Prikazuje podatke u trenutnom pipeline-u:
|httpOut('something')
Gledati (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Shema izvršenja
- Svaki zadatak vraća stablo izvršenja s korisnim podacima u formatu .
- Uzmi blok .
- Umetni u viewer, .
Gdje još možemo dobiti 'timestamp' u InfluxDB prilikom obratne zapisivanja
timestamp u influxdb prilikom obrnute zapisivanja
Na primjer, postavljamo upozorenje na broj zahtjeva po satu (groupBy(1h)) i želimo zabilježiti to upozorenje u influxdb (kako bismo lijepo prikazali problem na grafu u grafani).
influxDBOut() će zapisati vrijednost vremena iz upozorenja, stoga će točka na grafu biti zabilježena ranije/kasnije nego što je došlo upozorenje.
Kada je potrebna točnost: zaobilazimo ovaj problem putem poziva prilagođenog handler-a, koji će zapisati podatke u influxdb s trenutnim timestamp-om.
docker, izgradnja i implementacija
Pri pokretanju kapacitor može učitati zadatke, predloške i handler-e iz direktorija koji je naveden u konfiguraciji, u bloku [load].
Za ispravno kreiranje zadatka potrebne su sljedeće stvari:
- Naziv datoteke – razvija se u id/naziv skripte
- Tip – stream/batch
- dbrp – ključna riječ za navođenje u kojoj bazi + politici skripta radi (dbrp "supplier"."autogen")
Ako u nekoj batch-zadatku ne bude retka s dbrp, cijela usluga će odbiti da se pokrene i pošteno će o tome zapisati u log.
U chronograf-u, s druge strane, ovaj redak ne bi trebao biti, jer se putem sučelja ne prihvaća i pokazuje grešku.
Hack prilikom izgradnje kontejnera: Dockerfile izlazi s -1, ako postoje retci s //.+dbrp, što će omogućiti odmah da se razumije razlog neuspjeha prilikom izgradnje.
join jedan prema mnogima
Zadatak-primjer: potrebno je uzeti 95. percentil vremena rada usluge tjedno, usporediti svaku minutu iz posljednjih 10 s ovom vrijednošću.
Nije moguće napraviti join jedan prema mnogima, last/mean/median po grupi točaka pretvaraju čvor u stream, vraća se greška „cannot add child mismatched edges: batch -> stream”.
Rezultat batch-a, kao varijabla u lambda-izrazu, također se ne zamjenjuje.
Postoji mogućnost spremanja potrebnih brojeva iz prvog batch-a u datoteku putem udf i učitavanja te datoteke putem sideload.
Što smo time riješili?
Imamo oko 100 dobavljača hotela, od kojih svaki može imati nekoliko povezanosti, nazovimo to kanalom. Ima ih otprilike 300, svaki od kanala može otpasti. Od svih snimanih metrika pratimo stopu grešaka (requests i errors).
Zašto ne grafana?
Upozorenja o greškama, postavljena u grafani, imaju nekoliko nedostataka. Neki su kritični, na neke se može zažmiriti, ovisno o situaciji.
Grafana ne zna računati između mjerenja + alerting, a nama je potrebna stopa (requests-errors)/requests.
Greške izgledaju zloslutno:
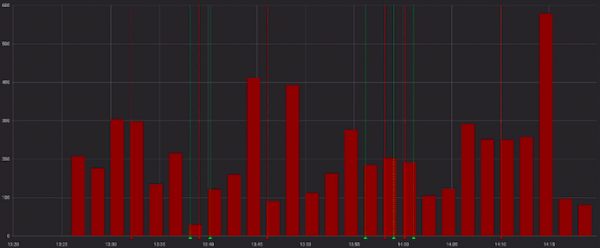
I manje zloslutno, ako se gleda s uspješnim zahtjevima:
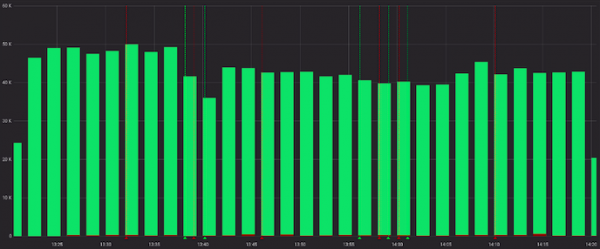
U redu, možemo preliminarno izračunati stopu u servisu do Grafane, i u nekim slučajevima to će odgovarati. No, ne u našem slučaju, jer se za svaki kanal smatra „normalnim“ različito, a upozorenja funkcionišu prema statičkim vrijednostima (tražimo vlastitim očima, mijenjamo ako često upozorava).
Ovo su primjeri „normalnog“ za različite kanale:
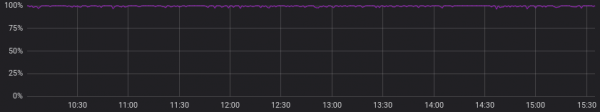
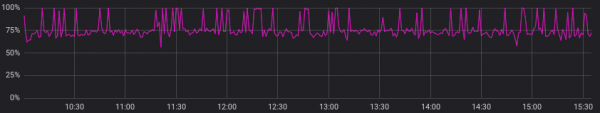
Zanemarujemo prethodnu tačku i pretpostavljamo da svi dobavljači imaju sličnu „normalnu“ sliku. Sada je sve u redu, možemo li se osloniti na upozorenja u Grafani?
Možemo, ali ne želimo, jer se treba odlučiti za jednu od opcija:
a) napraviti mnogo grafova za svaki kanal posebno (i mučiti se s njihovim održavanjem)
b) ostaviti jedan graf sa svim kanalima (i izgubiti se u šarenim linijama i postavljenim upozorenjima)
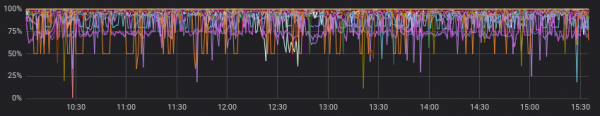
Što smo napravili?
Ponovno, u dokumentaciji ima dobar početni primjer (), može se pogledati ili uzeti kao osnova za slične zadatke.
Što smo na kraju uradili:
- spajanje dvije serije u nekoliko sati, grupisanje po kanalima;
- popunjavanje serija po grupama, ako podataka nije bilo;
- uspoređujemo medijanu posljednjih 10 minuta s prethodnim podacima;
- kličemo ako nešto otkrijemo;
- upisujemo izračunate stope i dogodila se upozorenja u influxdb;
- šaljemo korisnu poruku na slack.
Po mom mišljenju, uspjeli smo maksimalno lijepo ostvariti sve što smo željeli dobiti na izlazu (i čak malo više s prilagođenim handlerima).
Na github.com možete pogledati i dobivenog skripta.
Primjer dobijenog koda:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // пополняем значения нулями, если их не было
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if в lambda: считаем рейт, только если ошибки были
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// записываем посчитанные значения в инфлюкс
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// выбираем данные за последние 10 минут, считаем медиану
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // собираем в message ссылку на график дашборда графаны
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Sada je sve u redu{{ else }}
'+string(todayPeriod)+' медиана је {{ index .Fields "today.median" | printf "%0.2f" }}%, по претходном '+string(period)+' је {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" дублируем као "value", такође пишемо у инфлюкс остале филдове аларта (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
A koji je ishod?
Kapacitor izvrsno može obavljati monitoring i alarmiranje s brojnim grupiranjima, izvoditi dodatne proračune na već snimljenim metričkim podacima, izvršavati prilagođene radnje i pokretati skripte (udf).
Prag ulaska nije jako visok – isprobajte ga, ako Grafana ili drugi alati nisu potpuno zadovoljili vaše potrebe.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish