

Što biste osjećali ako bi jednog lijepog ljetnog dana podatkovni centar s vašom opremom izgledao ovako?
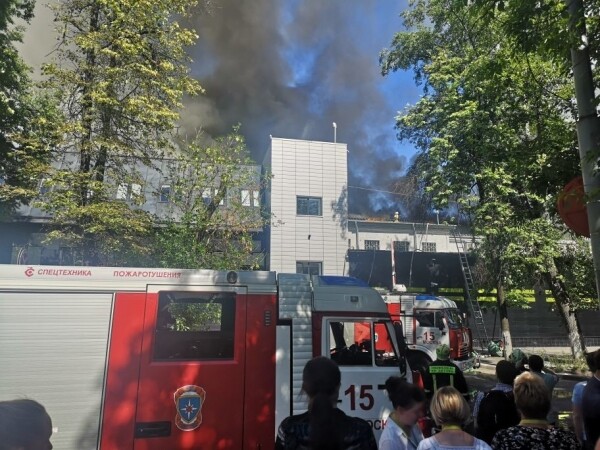
Pozdrav svima! Zovem se Dmitrij Samsonov, radim kao glavni sustavni administrator u „“ Na fotografiji je jedan od četiri podatkovna centra gdje je smještena oprema koja podržava naš projekt. Iza tih zidova nalazi se oko 4 tisuće jedinica opreme: poslužitelji, sustav pohrane podataka, mrežna oprema itd. — gotovo ⅓ naše opreme.
Većina poslužitelja koristi Linux. Imamo i nekoliko desetaka poslužitelja na Windowsu (MS SQL) — naše naslijeđe, od kojeg se postepeno odričemo već dugi niz godina.
Dakle, 5. lipnja 2019. u 14:35 inženjeri jednog od naših podatkovnih centara izvijestili su o požarnoj uzbuni.
Poricanje
14:45. Sitni incidenti sa dimom u podatkovnim centrima događaju se češće nego što se čini. Parametri unutar dvorana bili su normalni, stoga je naša prva reakcija bila relativno mirna: uveli smo zabranu rada s produkcijom, to jest na sve izmjene konfiguracija, implementaciju novih verzija itd., osim radova povezanih s popravkom nečega.
Bijes
Jeste li ikad pokušali pitati vatrogasce gdje se točno na krov dogodio požar, ili ste sami pokušali doći na gori krov da biste procijenili situaciju? Koliko će biti povjerenja u informacije dobivene kroz pet osoba?
14:50. Stigla je informacija da se vatra približava sustavu hlađenja. No, hoće li doći do njega? Dežurni sustavni administrator isključuje vanjski promet s frontova ovog podatkovnog centra.
Trenutno su svi naši servisi duplicirani u tri podatkovna centra, koristi se balansiranje na razini DNS-a što omogućuje uklanjanje adresa jednog podatkovnog centra iz DNS-a, čime se korisnici štite od potencijalnih problema s pristupom servisima. Ukoliko do problema u podatkovnom centru dođe, automatski izlazi iz rotacije. Više detalja možete pročitati ovdje:
Na nas požar za sada nije imao nikakav utjecaj — ni korisnici ni oprema nisu stradali. Je li to nesreća? Prvi dio dokumenta „Plan djelovanja u slučaju nesreće” definira pojam „Nesreća”, a završava dio ovako:
«Ako postoji sumnja je li to nesreća ili nije, onda je to nesreća!»
14:53. Imenuje se koordinator za hitne situacije.
Koordinator je osoba koja kontrolira komunikaciju između svih sudionika, procjenjuje razmjere hitne situacije, koristi "Plan djelovanja u hitnim situacijama", angažira potrebni osoblje, nadzire završetak popravka, a najvažnije — delegira sve zadatke. Drugim riječima, to je osoba koja upravlja cijelim procesom otklanjanja hitne situacije.
Ponuđeno
15:01. Počinjem isključivati servere koji nisu povezani s produkcijom.
15:03. Isključujemo sve rezervirane servise na pravilan način.
Ovdje ne spadaju samo frontovi (na koje u ovom trenutku korisnici već ne ulaze) i njihovi pomoćni servisi (poslovna logika, keširanje itd.), već i razne baze podataka s faktorom replikacije 2 i više (, , , i drugi).
15:06. Primljene su informacije da požar prijeti jednoj od dvorana data centra. U toj dvorani nemamo opreme, ali što se vatra može prenijeti s krova, na dvorane, značajno mijenja situaciju.
(Kasnije se ispostavilo da fizičke prijetnje za dvoranu nije bilo, jer je ona hermetički izolirana od krova. Prijetnja je postojala samo za sustav hlađenja te dvorane.)
15:07. Odobravamo izvršavanje komandi na serverima u ubrzanom režimu bez dodatnih provjera ().
15:08. Temperatura u dvoranama je unutar normale.
15:12. Zabilježen je porast temperature u dvoranama.
15:13. Više od polovice servera u data centru je isključeno. Nastavljamo.
15:16. Donijeta je odluka o isključivanju cijele opreme.
15:21. Počinjem isključivati napajanje na stateless serverima bez pravilnog gašenja aplikacije i operacijskog sustava.
15:23. Određena je grupa odgovornih za MS SQL (njih je malo, ovisnost usluga o njima nije velika, ali postupak obnavljanja funkcionalnosti traje duže i složeniji je nego, na primjer, kod Cassandre).
Depresija
15:25. Primljene su informacije o isključenju napajanja u četiri dvorane od 16 (br. 6, 7, 8, 9). U 7. i 8. dvorani nalaze se naši uređaji. Još nemamo informacija o dvije naše dvorane (br. 1 i 3).
Obično se prilikom požara odmah isključuje električno napajanje, ali u ovom slučaju, zahvaljujući koordiniranom radu vatrogasaca i tehničkog osoblja data centra, nije se isključivalo svugdje i odmah, već prema potrebi.
(Kasnije se ispostavilo da napajanje u dvoranama 8 i 9 nije isključeno.)
15:28. Počinjemo s oporavkom MS SQL baza iz rezervnih kopija u drugim podatkovnim centrima.
Koliko vremena će to trajati? Hoće li propusnost mreže biti dovoljna kroz sve rute?
15:37. Zabilježeno isključenje nekih dijelova mreže.
Menadžment i produkcijska mreža su fizički izolirani jedni od drugih. Ako je produkcijska mreža dostupna, možete se prijaviti na server, zaustaviti aplikaciju i isključiti OS. Ako nije dostupna, možete se prijaviti putem IPMI, zaustaviti aplikaciju i isključiti OS. Ako nijedna mreža nije dostupna, ne možete ništa učiniti. "Hvala, kapetane!", pomislit ćete.
"I uopće, čini se da je previše pompa", pomislit ćete možda također.
Činjenica je da serveri, čak i bez požara, generiraju ogromnu količinu topline. Točnije, kada postoji hlađenje, oni generiraju toplinu, a kada ga nema, stvaraju pakleno vrućinu koja će u najboljem slučaju otopiti dio opreme i isključiti drugi dio, a u najgorem... uzrokovati požar unutar dvorane, koji gotovo zajamčeno uništava sve.
15:39. Zabilježavamo probleme s bazom conf.
Baza conf je backend za istoimenu uslugu koja se koristi svim aplikacijama produkcije za trenutne promjene postavki. Bez ove baze ne možemo upravljati radom portala, ali sam portal može raditi.
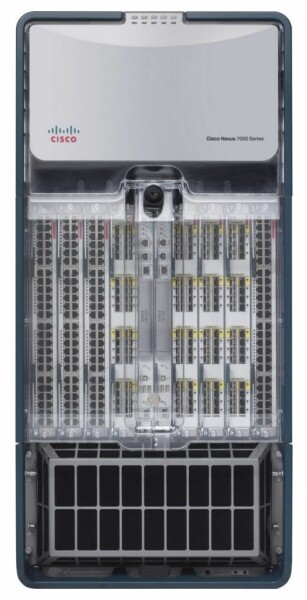
15:41. Temperaturni senzori na Core mrežnoj opremi zabilježavaju vrijednosti blizu maksimalno dopuštenih. To je kutija koja zauzima cijeli ormarić i osigurava rad svih mreža unutar podatkovnog centra.
15:42. Issue tracker i wiki nisu dostupni, prelazimo na rezervno stanje.
Ovo nije produkcija, ali u slučaju nesreće dostupnost bilo koje baze znanja može biti kritična.
15:50. Isključio se jedan od sustava za nadzor.
Ima ih nekoliko, i odgovorni su za različite aspekte rada usluga. Dio njih je postavljen za autonomni rad unutar svakog podatkovnog centra (tj. nadziru samo svoj podatkovni centar), dok drugi sadrže distribuirane komponente koje bez problema podnose gubitak bilo kojeg podatkovnog centra.
U ovom slučaju prestao je raditi , koji radi u načinu master-standby. Prebacili smo se na rezervno stanje.
Prihvaćanje
15:51. Putem IPMI isključeni su svi serveri bez pravilnog završetka rada, osim MS SQL.
Jeste li spremni za masovno upravljanje poslužiteljima putem IPMI ako zatreba?
Onaj trenutak kada je spašavanje opreme u podatkovnom centru na ovoj fazi završeno. Sve što se moglo učiniti, učinjeno je. Neki kolege mogu odmoriti.
16:13. Dohvaćene su informacije da su se na krovu pokidale cijevi za freon iz klima uređaja - to će odgoditi otvaranje podatkovnog centra nakon gašenja požara.
16:19. Prema podacima koje je dostavio tehnički osoblje podatkovnog centra, prestalo je povećanje temperature u dvoranama.
17:10. Obnovljen je rad baze conf. Sada možemo promijeniti postavke aplikacija.
Zašto je to toliko važno, ako je sve redundantno i radi i bez jednog podatkovnog centra?
Prvo, nije sve redundantno. Postoje razne sporedne usluge koje još uvijek ne preživljavaju dobro neuspjeh podatkovnog centra, i postoje baze u režimu master-standby. Mogućnost upravljanja postavkama omogućava poduzimanje svih potrebnih mjera kako bi se čak i u teškim uvjetima minimalizirale posljedice nesreće na korisnike.
Drugo, postalo je jasno da se rad podatkovnog centra neće potpuno obnoviti u sljedećim satima, pa je bilo potrebno poduzeti mjere da dugotrajna nedostupnost replika ne dovede do dodatnih problema poput preopterećenja diskova u preostalim podatkovnim centrima.
17:29. Vrijeme za pizzu! Imamo ljude na poslu, a ne robote.
Rehabilitacija
18:02. U dvoranama br. 8 (naša), 9, 10 i 11 stabilizirala se temperatura. U jednoj od onih koje ostaju isključene (br. 7) nalazi se naša oprema, a temperatura tamo nastavlja rasti.
18:31. Dali smo zeleno svjetlo za pokretanje opreme u dvoranama br. 1 i 3 - te dvorane požar nisu zahvatile.
U ovom trenutku pokreću se poslužitelji u dvoranama br. 1, 3, 8, počevši od najkritičnijih. Provjerava se ispravnost rada svih pokrenutih usluga. I dalje postoje problemi s dvoranom br. 7.
18:44. Tehničko osoblje podatkovnog centra otkrilo je da u dvorani br. 7 (gdje se nalazi samo naša oprema) mnogi poslužitelji nisu isključeni. Prema našim podacima, ostaje uključeno 26 poslužitelja. Nakon ponovne provjere otkrivamo 58 poslužitelja.
20:18. Tehničko osoblje podatkovnog centra provjetrava zrak u dvorani bez klima uređaja putem mobilnih zračnih kanala postavljenih kroz hodnike.
23:08. Pustili smo prvog administratora kući. Netko mora noćas spavati kako bi sutra nastavio s radom. Nakon toga puštamo još dio administratora i developera.
02:56. Pokrenuli smo sve što je moglo biti pokrenuto. Izvršavamo veliku provjeru svih usluga automatskim testovima.
03:02. Klimatizacija u posljednjoj, 7. dvorani je obnovljena.
03:36. Uključili smo fronte u podatkovnom centru u rotaciju u DNS-u. Od ovog trenutka počinje dolaziti korisnički promet.
Raspustili smo većinu tima administratora o kući. Ali nekoliko ljudi zadržavamo.
Mali FAQ:
P: Što se događalo od 18:31 do 02:56?
O: Slijedeći „Plan djelovanja u slučaju nesreće“, pokrećemo sve usluge, počinjemo s najvažnijima. U međuvremenu, koordinator u chatu dodjeljuje uslugu slobodnom administratoru koji provjerava jesu li sustavi i aplikacije pokrenuti, nema li pogrešaka, jesu li parametri u redu. Nakon završetka pokretanja javlja u chat da je slobodan i od koordinatora dobiva novu uslugu.
Proces dodatno usporava kvareno računalo. Čak i ako je zaustavljanje sustava i isključivanje poslužitelja prošlo ispravno, neki poslužitelji se ne vraćaju zbog iznenada kvara diskova, memorije, šasije. U slučaju gubitka napajanja postotak kvarova se povećava.
P: Zašto se ne može jednostavno sve pokrenuti odjednom, a zatim popraviti što se pojavi u nadzoru?
O: Sve treba raditi postupno, jer postoje ovisnosti između usluga. A sve treba provjeriti odmah, ne čekajući nadzor — jer je bolje riješiti probleme odmah, nego čekati da se pogoršaju.
7:40. Posljednji administrator (koordinator) otišao je na spavanje. Radovi prvog dana završeni.
8:09. Prvi developeri, inženjeri u podatkovnim centrima i administratori (uključujući novog koordinatora) započeli su s obnoviteljskim radovima.
09:37. Započeli smo s podizanjem dvorane br. 7 (posljednje).
Paralelno nastavljamo obnavljati ono što nismo dovršili u drugim dvoranama: zamjena diskova/memorije/poslužitelja, popravak svega što „gori“ u nadzoru, povratno prebacivanje uloge u shemama master-standby i drugi sitni detalji kojih, međutim, ima dovoljno.
17:08. Dozvoljavamo sve redovne radove s produkcijom.
21:45. Radovi drugog dana završeni.
09:45. Danas je petak. U monitoring sustavu i dalje ima mnogo malih problema. Ispred su vikendi, svima se želi odmoriti. Nastavljamo masovno popravljati sve što možemo. Uobičajeni administratorski zadaci koji su se mogli odgoditi, odgođeni su. Novi koordinator.
15:40. Iznenada je restartana polovica Core mrežne opreme u DRUGOM data centru. Iz rotacije su izbačeni frontovi radi minimiziranja rizika. Nema efekta za korisnike. Kasnije se ispostavilo da je to bilo neispravno šasije. Koordinator radi na popravljanju odmah dvije havarije.
17:17. Rad mreže u drugom data centru je obnovljen, sve je provjereno. Data centar je vraćen u rotaciju.
18:29. Radovi trećeg dana i općenito obnova nakon havarije su završeni.
Epilog
04.04.2013. godine, , „OdnoKlassniki“ — tijekom tri dana portal je bio potpuno ili djelomično nedostupan. Tijekom cijelog tog vremena više od 100 ljudi iz raznih gradova, iz raznih tvrtki (još jednom hvala!), je daljinski i izravno u data centrima, ručno i automatski popravljalo tisuće poslužitelja.
Iznijeli smo zaključke. Kako se ovakvo nešto ne bi ponovilo, proveli smo i nastavljamo provoditi opsežne radove.
Koje su glavne razlike između trenutne havarije i 404?
- Imamo „Plan djelovanja u slučaju havarije“. Svakog kvartala provodimo vježbe — simuliramo havarijsku situaciju koju grupu administratora (svi redom) moraju riješiti koristeći „Plan djelovanja u slučaju havarije“. Vodeći sistemski administratori naizmjenično vježbaju ulogu koordinatora.
- Svaki kvartal u testnom režimu izoliramo data centre (sve redom) putem LAN i WAN mreže, što omogućava pravovremeno otkrivanje uskih grla.
- Manje neispravnih diskova, jer smo pojačali standarde: manja radna opterećenja, stroži pragovi za S.M.A.R.T.,
- Potpuno smo napustili BerkeleyDB — staru i nestabilnu bazu podataka koja je zahtijevala mnogo vremena za obnovu nakon restarta poslužitelja.
- Smanjili smo broj poslužitelja s MS SQL i smanjili ovisnost o preostalim.
- Imamo vlastito , u koji aktivno migriramo sve usluge već dvije godine. Oblak značajno pojednostavljuje ciklus rada s aplikacijom, a u slučaju havarije pruža jedinstvene alate, kao što su:
- ispravna zaustavljanja svih aplikacija jednim klikom;
- jednostavna migracija aplikacija s neuspjelih poslužitelja;
- automatsko rangiranje (po prioritetu usluga) pokretanja cijelog data centra.
Nezgoda opisana u ovom članku bila je najveća od 404. godine. Naravno, nije sve išlo glatko. Na primjer, tijekom nedostupnosti pogođenog data centra, na drugom data centru otkazao je disk na jednom od poslužitelja, što je značilo da je dostupna bila samo jedna od tri replike u Cassandra klasteru, pa 4,2% korisnika mobilnih aplikacija nije moglo izvršiti prijavu. Ipak, već povezani korisnici nastavili su raditi. Ukupno je tijekom istrage nezgode otkriveno više od 30 problema — od banalnih grešaka do nedostataka u arhitekturi usluga.
No, najvažnija razlika između trenutne nezgode i 404. godine je u tome što su dok smo otklanjali posljedice požara, korisnici i dalje slali poruke i obavljali video pozive u , igrali igre, slušali muziku, darivali jedni druge sitnicama, gledali video zapise, serije i televizijske kanale u , kao i streamali na .
Kako prolaze vaše nezgode?
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish