

Kratka uvodna rečenica
Mislim da bismo mogli obaviti mnogo više poslova kada bismo imali korak-po-korak upute koje bi nam rekle što i kako raditi. Sjećam se trenutaka u svom životu kada nisam mogao započeti neki zadatak jednostavno zato što je bilo teško shvatiti odakle početi. Možda si nekad davno na internetu vidio izraz „Data Science“ i pomislio da je to daleko od tebe, a ljudi koji se time bave su negdje drugdje, u drugom svijetu. No, nisu, oni su upravo ovdje. I, možda, zahvaljujući ljudima iz ove sfere, došla ti je članak putem feeda. Postoji mnogo tečajeva koji će ti pomoći da se uklopeš u ovo zanimanje, a ja ću ti ovdje pomoći da napraviš prvi korak.
Pa, je li si spreman? Odmah ću reći da ćeš morati znati Python 3, jer ću ga koristiti ovdje. Također preporučujem da unaprijed instaliraš Jupyter Notebook ili pogledaš kako koristiti Google Colab.
Prvi korak
Kaggle je tvoj značajan pomoćnik u ovom poslu. U načelima, možeš i bez njega, ali o tome ću govoriti u drugom članku. To je platforma koja nudi natjecanja u oblasti Data Science. U svakom od tih natjecanja u ranim fazama dobivat ćeš nevjerojatnu količinu iskustva rješavanja raznih zadataka, kao i iskustva u razvoju i timskom radu, što je važno u ovom vremenu.
Naš zadatak ćemo uzeti odatle. Zove se „Titanic“. Uslov je: predvidjeti hoće li svaka pojedinačna osoba preživjeti. U suštini, zadatak osobe koja se bavi DS-om je prikupljanje podataka, njihova obrada, obuka modela, prognoza i tako dalje. Na Kaggle-u, međutim, omogućavaju nam da preskočimo fazu prikupljanja podataka — oni su već dostupni na platformi. Moramo ih preuzeti i možemo početi raditi!
To možemo učiniti na sljedeći način:
na kartici Data nalaze se datoteke koje sadrže podatke


Podaci su preuzeti, pripremili smo naše Jupyter bilješke i…
Drugi korak
Kako sada možemo preuzeti ove podatke?
Prvo, uvozimo potrebne biblioteke:
import pandas as pd
import numpy as np
Pandas će nam omogućiti da preuzmemo .csv datoteke za daljnju obradu.
Numpy nam je potreban da naše podatke predstavimo u obliku matrice s brojevima.
Idemo dalje. Uzet ćemo datoteku train.csv i preuzeti je kod nas:
dataset = pd.read_csv('train.csv')
Referirat ćemo na našu zbirku podataka train.csv putem varijable dataset. Pogledajmo što se tamo nalazi:
dataset.head()
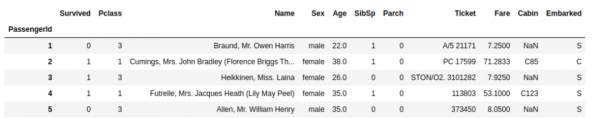
Funkcija head() omogućuje nam pregled prvih nekoliko redaka dataframe-a.
Stupac Survived sadrži naše rezultate, koji su u ovom dataframe-u poznati. U vezi s problemom, trebamo predvidjeti stupac Survived za podatke test.csv. U tim podacima nalazi se informacija o drugim putnicima Titanica, za koje nam, kao rješavateljima problema, ishod nije poznat.
Dakle, podijelit ćemo našu tablicu na zavisne i neovisne podatke. Ovdje je sve jednostavno. Zavisni podaci su oni koji ovise o neovisnim, tj. oni koji se nalaze u ishodima. Neovisni podaci su oni koji utječu na ishod.
Na primjer, imamo ovakav skup podataka:
„Vova je učio informatiku — ne.
Vova je dobio 2 iz informatike.“
Ocjena iz informatike ovisi o odgovoru na pitanje: je li Vova učio informatiku? Jasno? Idemo dalje, bliže smo cilju!
Tradicionalna varijabla za neovisne podatke je X. Za zavisne - y.
Radimo sljedeće:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Što je to? Funkcijom iloc[:, 2: ] govorimo Pythonu: želim vidjeti u varijabli X podatke koji počinju od drugog stupca (uključivo i pod uvjetom da broj počinje od nule). U drugom retku kažemo da želimo vidjeti u y podatke prvog stupca.
[ a:b, c:d ] — ovo je konstrukcija koju koristimo u zagradama. Ako ne navedemo neke varijable, one će ostati zadane. Dakle, možemo navesti [:,: d] i tada ćemo dobiti u dataframe-u sve stupce, osim onih koji počinju od broja d naviše. Varijable a i b određuju redke, ali to su nam svi potrebni, pa to ostavljamo zadano.
Pogledajmo što smo dobili:
X.head() 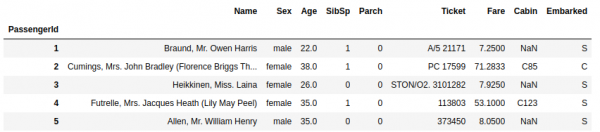
y.head() 
Kako bismo pojednostavili ovu malu lekciju, uklonit ćemo stupce koji zahtijevaju posebnu "njegu", ili uopće ne utječu na preživljavanje. Sadrže podatke tipa str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Idemo na sljedeći korak.
Korak tri
Ovdje ćemo morati kodirati naše podatke kako bi mašina bolje razumjela kako ti podaci utječu na rezultat. No, kodirat ćemo samo podatke tipa str koje smo ostavili. Stupac „Spol“. Kako želimo kodirati? Predstavimo podatke o spolu osobe vektorom: 10 — muški spol, 01 — ženski spol.
Na početku ćemo naše tablice pretvoriti u NumPy matricu:
X = np.array(X)
y = np.array(y)
A sada pogledajmo:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Biblioteka sklearn je sjajna biblioteka koja nam omogućava da obavljamo cjelokupan rad u Data Science-u. Sadrži ogroman broj zanimljivih modela strojnog učenja te nam omogućava pripremu podataka.
OneHotEncoder će nam omogućiti da kodiramo spol osobe na način kako smo opisali. Bit će stvorena 2 klase: muški i ženski. Ako je osoba muškarac, u stupac „muški“ bit će zabilježena 1, a u „ženski“, posljedično, 0.
Nakon OneHotEncoder() slijedi [1] — to znači da želimo kodirati stupac broj 1 (brojimo od nule).
Super. Idemo još dalje!
Obično se događa da neki podaci ostanu nepopunjeni (odnosno NaN — not a number). Na primjer, postoje informacije o osobi: njezino ime, spol. No, podataka o njezinoj dobi nema. U takvim slučajevima primijenit ćemo metodu: naći ćemo aritmetičku sredinu svih stupaca i, ako su neki podaci u stupcu promašeni, popunit ćemo prazno mjestom srednjom aritmetičkom.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
A sada uzimamo u obzir da se događaju situacije kada su podaci jako raspršeni. Neki podaci nalaze se u rasponu [0:1], dok neki mogu doseći stotine i tisuće. Kako bismo isključili takav raspon i kako bi računalo bilo točnije u izračunima, skalirat ćemo podatke, odabrati njihove dimenzije. Neka sve brojke ne prelaze tri. U tu svrhu iskoristit ćemo funkciju StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Sada naši podaci izgledaju ovako:

Super. Već smo blizu našem cilju!
Korak četvrti
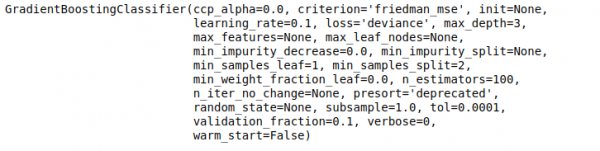
Učimo naš prvi model! U biblioteci sklearn možemo pronaći ogroman broj zanimljivosti. Primijenio sam model Gradient Boosting Classifier na ovaj zadatak. Koristimo klasifikator jer je naš zadatak klasifikacija. Trebamo prognozu koja će se odnositi na 1 (preživio) ili 0 (nije preživio).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funkcija fit govori Pythonu: Neka model traži veze između X i y.
Manje od sekunde i model je spreman.
Kako ga primijeniti? Sada ćemo vidjeti!
Korak peti. Zaključak
Sada trebamo učitati tablicu s našim testnim podacima za koje trebamo napraviti prognozu. S ovom tablicom ćemo napraviti sve iste radnje koje smo radili za X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Primijenimo naš model!
gbc_predict = gbc.predict(X_test)
Sve. Napravili smo prognozu. Sada je trebamo zapisati u csv i poslati na stranicu.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Gotovo. Dobili smo datoteku koja sadrži predikcije za svakog putnika. Treba još uploadati ta rješenja na stranicu i dobiti ocjenu prognoze. Ovo primitivno rješenje daje ne samo 74% točnih odgovora na javnom, već i određeni poticaj u Data Science. Najzanimljiviji me mogu slobodno kontaktirati u privatnim porukama s pitanjima. Hvala svima!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish