

Ili malo praktične tetrisologije.
Sve novo je dobro zaboravljeno staro.
Epigrafi.
Postavljanje zadatka
Povremeno je potrebno preuzimati trenutni log-fajl PostgreSQL iz AWS oblaka na lokalni Linux host. Ne u realnom vremenu, ali recimo s malim kašnjenjem.
Razdoblje ažuriranja log-fajla je 5 minuta.
Log-fajl u AWS-u rotira se svake sata.
Korišteni alati
Za preuzimanje log-fajla na host koristi se bash skripta koja poziva AWS API „».
Parametri:
- —db-instance-identifier: Ime instance u AWS-u;
- —log-file-name: ime trenutno generiranog log-fajla
- —max-item: Ukupan broj elemenata koji se vraćaju u izlaznim podacima naredbe.Veličina porcije preuzimanog fajla.
- —starting-token: Oznaka za početnu porciju
U ovom konkretnom slučaju, zadatak preuzimanja logova se pojavio tokom rada na
I jednostavno — zanimljiv zadatak, za vježbu i raznolikost tokom radnog vremena.
Pretpostavljam da je zadatak zbog uobičajenosti već rešen. No, brzi Google rezultati nisu sugerisali rešenja, a nisu postojale ni želje za dubljim pretraživanjem. U svakom slučaju — dobar trening.
Formalizacija zadatka
Konačni log-fajl se sastoji od više redaka varijabilne dužine. Grafički, log-fajl se može predstaviti, otprilike ovako:
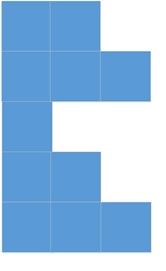
Već liči na nešto? Kako se ovde pojavljuje „tetris”? Pa, evo kako.
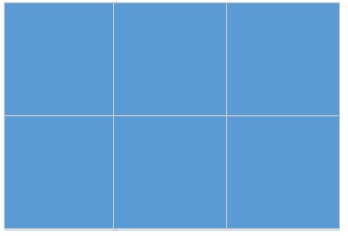
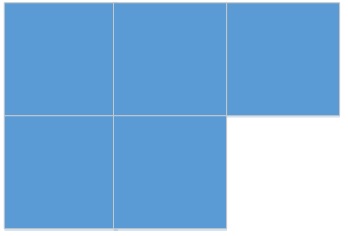
Ako grafički prikažemo moguće opcije koje nastaju pri preuzimanju narednog fajla (za jednostavnost, u ovom slučaju, neka redovi imaju istu dužinu), dobijamo standardne tetris figure:
1) Fajl je potpuno preuzet i nije konačan. Veličina porcije je veća od veličine konačnog fajla:
2) Fajl ima nastavak. Veličina porcije je manja od veličine konačnog fajla:
3) Fajl je nastavak prethodnog fajla i ima nastavak. Veličina porcije je manja od preostalog dela konačnog fajla:
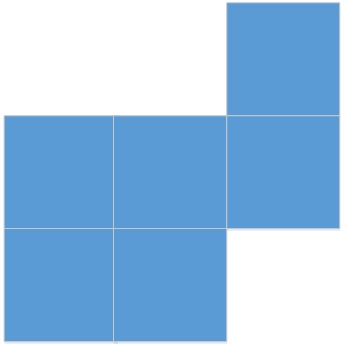
4) Fajl je nastavak prethodnog fajla i konačan je. Veličina porcije je veća od preostalog dela konačnog fajla:
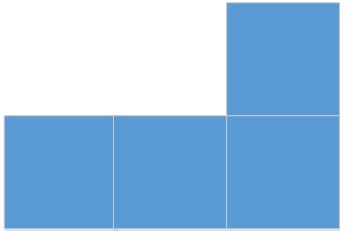
Zadatak — sastaviti pravougaonik ili igrati tetris, na novom nivou.
Problemi koji se javljaju tokom rešavanja zadatka
1) Spojiti red iz 2 porcije
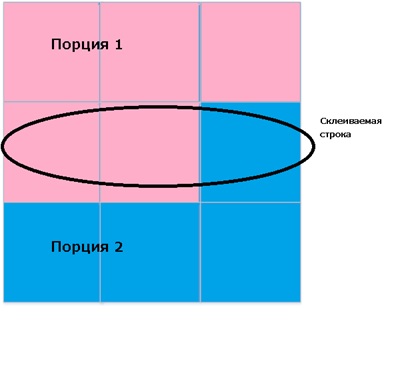
U suštini nije došlo do nikakvih posebnih problema. Standardni zadatak iz početnog kursa programiranja.
Optimalna veličina porcije
A ovo je, nešto zanimljivije.
Nažalost, nema mogućnosti korištenja pomaka nakon oznake početnog tokena:
Kao što već znate, opcija —starting-token koristi se za određivanje mjesta odakle početi paginaciju. Ova opcija prihvaća String vrijednosti, što znači da ako pokušate dodati vrijednost pomaka ispred stringa Next Token, opcija se neće uzeti u obzir kao pomak.
I stoga, treba čitati u komadima.
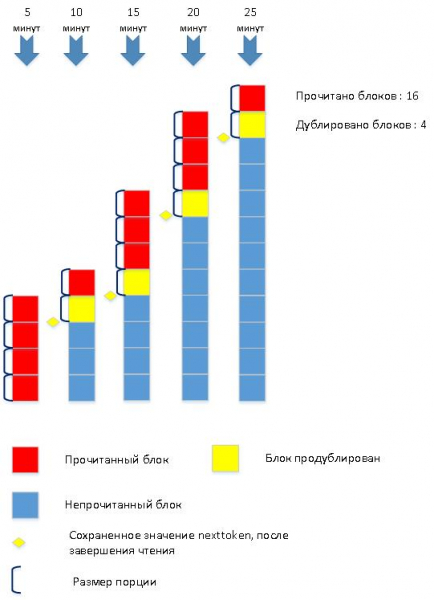
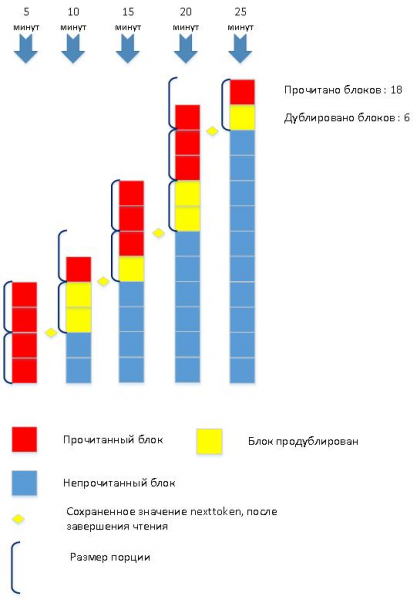
Ako čitate u velikim količinama, broj čitanja će biti minimalan, ali volumen će biti maksimalan.
Ako čitate u malim količinama, broj čitanja će biti maksimalan, ali volumen će biti minimalan.
Stoga, kako bismo smanjili promet i za opći izgled rješenja, morali smo smisliti određeno rješenje, nažalost, malo nalik na improvizaciju.
Za ilustraciju, razmotrite proces učitavanja log datoteke u dva jako pojednostavljena varijante. Broj čitanja u oba slučaja ovisi o veličini porcije.
1) Učitavamo malim porcijama:
2) Učitavamo velikim porcijama:
Kao i obično, optimalno rješenje je u sredini..
Veličina porcije je minimalna, ali u procesu čitanja, veličinu se može povećati, kako bi se smanjio broj čitanja.
Treba napomenuti, da je zadatak odabira optimalne veličine čitljive porcije još uvijek neriješen i zahtijeva dublju obradu i analizu. Možda nešto kasnije.
Opći opis implementacije
Korištene servisne tablice
CREATE TABLE endpoint
(
id SERIAL ,
host text
);

TABLE database
(
id SERIAL ,
…
last_aws_log_time text ,
last_aws_nexttoken text ,
aws_max_item_size integer
);
last_aws_log_time — vremenska oznaka zadnje učitane log-datoteke u formatu YYYY-MM-DD-HH24.
last_aws_nexttoken — tekstualna oznaka posljednje učitane porcije.
aws_max_item_size - empirijski odabrana početna veličina porcije.
Puni tekst skripte
download_aws_piece.sh
#!/bin/bash
#########################################################
# download_aws_piece.sh
# downloan piece of log from AWS
# version HABR
 let min_item_size=1024
 let max_item_size=1048576
 let growth_factor=3
 let growth_counter=1
 let growth_counter_max=3

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:''STARTED'

 AWS_LOG_TIME=$1
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:AWS_LOG_TIME='$AWS_LOG_TIME

 database_id=$2
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:database_id='$database_id
 RESULT_FILE=$3

 endpoint=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE_DATABASE -A -t -c "select e.host from endpoint e join database d on e.id = d.endpoint_id where d.id = $database_id "`
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:endpoint='$endpoint

 db_instance=`echo $endpoint | awk -F"." '{print toupper($1)}'`

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:db_instance='$db_instance

 LOG_FILE=$RESULT_FILE'.tmp_log'
 TMP_FILE=$LOG_FILE'.tmp'
 TMP_MIDDLE=$LOG_FILE'.tmp_mid'
 TMP_MIDDLE2=$LOG_FILE'.tmp_mid2'

 current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`

 echo $(date +%Y%m%d%H%M)':      download_aws_piece.sh:current_aws_log_time='$current_aws_log_time

  if [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  then
    is_new_log='1'
	if ! psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	then
	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  else
    is_new_log='0'
  fi

  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:is_new_log='$is_new_log

  let last_aws_max_item_size=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select aws_max_item_size from database where id = $database_id "`
  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: last_aws_max_item_size='$last_aws_max_item_size

  let count=1
  if [[ $is_new_log == '1' ]];
  then
	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF NEW AWS LOG'
	if ! aws rds download-db-log-file-portion
		--max-items $last_aws_max_item_size
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 2
	fi
  else
    next_token=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "select last_aws_nexttoken from database where id = $database_id "`

	if [[ $next_token == '' ]];
	then
	  next_token='0'
	fi

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: CONTINUE DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
	    --max-items $last_aws_max_item_size
		--starting-token $next_token
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 3
	fi

	line_count=`cat  $LOG_FILE | wc -l`
	let lines=$line_count-1

	tail -$lines $LOG_FILE > $TMP_MIDDLE
	mv -f $TMP_MIDDLE $LOG_FILE
  fi

  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

  grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

  if [[ $next_token == '' ]];
  then
	  cp $TMP_FILE $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
  else
	psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "
  fi

  first_str=`tail -1 $TMP_FILE`

  line_count=`cat  $TMP_FILE | wc -l`
  let lines=$line_count-1

  head -$lines $TMP_FILE  > $RESULT_FILE

###############################################
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
             --max-items $last_aws_max_item_size
             --starting-token $next_token
             --region REGION
             --db-instance-identifier  $db_instance
             --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
#
#################################################################

exit 0
Izdvojci skripte s nekim objašnjenjima:
Ulazni parametri skripte:
- Vremenska oznaka imena log-fajla u formatu YYYY-MM-DD-HH24: AWS_LOG_TIME=$1
- ID baze podataka: database_id=$2
- Ime prikupljene log-datoteke: RESULT_FILE=$3
Dobiti vremensku oznaku posljednje učitane log-datoteke:
current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`Ako vremenska oznaka posljednje učitane log-datoteke ne odgovara ulaznom parametru — učitava se nova log-datoteka:
ako [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  onda
    is_new_log='1'
	ako ne psql -h ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	onda
	  echo '***download_aws_piece.sh -FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  inače
    is_new_log='0'
  fi
Dobivanje vrijednosti oznake nexttoken iz učitanog datoteke:
  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `
Prazna vrijednost nexttoken označava završetak učitavanja.
U petlji prebrojavamo dijelove datoteke, istovremeno povezujući linije i povećavajući veličinu dijela:
Glavna petlja
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
     --max-items $last_aws_max_item_size
	 --starting-token $next_token
     --region REGION
     --db-instance-identifier  $db_instance
     --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
         rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
Što dalje?
Dakle, prvi međufazni zadatak — "učitati log-datoteku iz oblaka" je riješen. Što učiniti s učitanim logom?
Prvo je potrebno analizirati log-datoteku i izdvojiti iz nje same upite.
Zadatak nije previše težak. Najjednostavniji bash-skript sasvim dobro obavlja ovu funkciju.
upload_log_query.sh
#!/bin/bash
#########################################################
# upload_log_query.sh
# Upload table table from dowloaded aws file
# version HABR
###########################################################
echo 'TIMESTAMP:'$(date +%c)' Upload log_query table '
source_file=$1
echo 'source_file='$source_file
database_id=$2
echo 'database_id='$database_id

beginer=' '
first_line='1'
let "line_count=0"
sql_line=' '
sql_flag=' '
space=' '
cat $source_file | while read line
do
  line="$space$line"

  if [[ $first_line == "1" ]]; then
    beginer=`echo $line | awk -F" " '{ print $1}' `
    first_line='0'
  fi

  current_beginer=`echo $line | awk -F" " '{ print $1}' `

  if [[ $current_beginer == $beginer ]]; then
    if [[ $sql_flag == '1' ]]; then
     sql_flag='0'
     log_date=`echo $sql_line | awk -F" " '{ print $1}' `
     log_time=`echo $sql_line | awk -F" " '{ print $2}' `
     duration=`echo $sql_line | awk -F" " '{ print $5}' `

     #replace ' to ''
     sql_modline=`echo "$sql_line" | sed 's/'''/''''''/g'`
     sql_line=' '

	 ################
	 #PROCESSING OF THE SQL-SELECT IS HERE
     if ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d DATABASE -v ON_ERROR_STOP=1 -A -t -c "select log_query('$ip_port',$database_id , '$log_date' , '$log_time' , '$duration' , '$sql_modline' )"
     then
        echo 'FATAL_ERROR - log_query '
        exit 1
     fi
	 ################

    fi #if [[ $sql_flag == '1' ]]; then

    let "line_count=line_count+1"

    check=`echo $line | awk -F" " '{ print $8}' `
    check_sql=${check^^}

    #echo 'check_sql='$check_sql

    if [[ $check_sql == 'SELECT' ]]; then
     sql_flag='1'
     sql_line="$sql_line$line"
	 ip_port=`echo $sql_line | awk -F":" '{ print $4}' `
    fi
  else

    if [[ $sql_flag == '1' ]]; then
      sql_line="$sql_line$line"
    fi

  fi #if [[ $current_beginer == $beginer ]]; then

done
Sada, s izdvojenim upitom iz log-datoteke, možemo raditi.
Otvara se nekoliko korisnih mogućnosti.
Izdvojeni upiti trebaju biti pohranjeni negdje. Za to se koristi servisna tablica log_query
CREATE TABLE log_query
(
   id SERIAL ,
   queryid bigint ,
   query_md5hash text not null ,
   database_id integer not null ,
   timepoint timestamp without time zone not null,
   duration double precision not null ,
   query text not null ,
   explained_plan text[],
   plan_md5hash text  ,
   explained_plan_wo_costs text[],
   plan_hash_value text  ,
   baseline_id integer ,
   ip text ,
   port text
);
ALTER TABLE log_query ADD PRIMARY KEY (id);
ALTER TABLE log_query ADD CONSTRAINT queryid_timepoint_unique_key UNIQUE (queryid, timepoint );
ALTER TABLE log_query ADD CONSTRAINT query_md5hash_timepoint_unique_key UNIQUE (query_md5hash, timepoint );

CREATE INDEX log_query_timepoint_idx ON log_query (timepoint);
CREATE INDEX log_query_queryid_idx ON log_query (queryid);
ALTER TABLE log_query ADD CONSTRAINT database_id_fk FOREIGN KEY (database_id) REFERENCES database (id) ON DELETE CASCADE ;
Obrada analiziranog upita vrši se u plpgsql funkciji «log_query».
log_query.sql
--log_query.sql
--verison HABR
CREATE OR REPLACE FUNCTION log_query( ip_port text ,log_database_id integer , log_date text , log_time text , duration text , sql_line text   ) RETURNS boolean AS $$
DECLARE
  result boolean ;
  log_timepoint timestamp without time zone ;
  log_duration double precision ;
  pos integer ;
  log_query text ;
  activity_string text ;
  log_md5hash text ;
  log_explain_plan text[] ;

  log_planhash text ;
  log_plan_wo_costs text[] ;

  database_rec record ;

  pg_stat_query text ;
  test_log_query text ;
  log_query_rec record;
  found_flag boolean;

  pg_stat_history_rec record ;
  port_start integer ;
  port_end integer ;
  client_ip text ;
  client_port text ;
  log_queryid bigint ;
  log_query_text text ;
  pg_stat_query_text text ;
BEGIN
  result = TRUE ;

  RAISE NOTICE '***log_query';

  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = duration:: double precision;


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);


  log_md5hash = md5( log_query::text );

  --Explain execution plan--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
	activity_string = 	'New query has logged '||
						' database_id = '|| log_database_id ||
						' query_md5hash='||log_md5hash||
						' , timepoint = '||to_char(log_timepoint,'YYYYMMDD HH24:MI:SS');

	RAISE NOTICE '%',activity_string;

	PERFORM pg_log( log_database_id , 'log_query' , activity_string);

	EXCEPTION
	  WHEN unique_violation THEN
		RAISE NOTICE '*** unique_violation *** query already has logged';
	END;

	SELECT 	queryid
	INTO   	log_queryid
	FROM 	log_query
	WHERE 	query_md5hash = log_md5hash AND
			timepoint = log_timepoint;

	IF log_queryid IS NOT NULL
	THEN
	  RAISE NOTICE 'log_query with query_md5hash = % and timepoint = % has already has a QUERYID = %',log_md5hash,log_timepoint , log_queryid ;
	  RETURN result;
	END IF;

	------------------------------------------------
	RAISE NOTICE 'Update queryid';

	SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
         queryid ,
	  query
	 FROM
         pg_stat_db_queries
     WHERE
      database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;


	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' for log_query with id = '||log_query_rec.id
		   				    ;
	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;

  RETURN result ;
END
$$ LANGUAGE plpgsql;
U obradi se koristi servisna tabela pg_stat_db_queries, koja sadrži trenutne upite iz tabele pg_stat_history (Korišćenje tabele je opisano ovde — )
TABLE pg_stat_db_queries
(
   database_id integer,
   queryid bigint ,
   query text ,
   max_time double precision
);
TABLE pg_stat_history
(
…
database_id integer ,
…
queryid bigint ,
…
max_time double precision	 ,
…
);
Funkcija omogućava niz korisnih mogućnosti za obradu upita iz log fajla. Konkretno:
Mogućnost #1 — Istorija izvršavanja upita
Veoma korisno za početak rešavanja incidenta sa performansama. Prvo pregledajte istoriju — kada je počelo usporenje?
Zatim, kao i obično – potražite spoljne uzroke. Možda je jednostavno naglo poraslo opterećenje baze podataka i konkretan upit nije kriv.
Dodajte novu stavku u tabelu log_query
  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = to_number(duration,'99999999999999999999D9999999999');


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);

  RAISE NOTICE 'log_query=%',log_query ;

  log_md5hash = md5( log_query::text );

  --Objašnjenje izvršnog plana--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
Mogućnost #2 — Čuvanje planova izvršavanja upita
Na ovom mestu može se postaviti prigovor-preciziranje-komentar: „Ali već postoji autoexplain“. Postoji, ali kakva je korist, ako se plan izvršenja čuva u istom log-fajlu i da bi ga sačuvali za dalju analizu, moraćete da parsirate log-fajl?
Meni je, međutim, bilo potrebno:
prvo: čuvati plan izvršenja u servisnoj tabeli baze podataka za monitoring;
U drugom redu: imati mogućnosti usporedbe planova izvršavanja jedan s drugim, kako bi odmah vidjeli da se plan izvršavanja zahtjeva promijenio.
Postoji zahtjev s konkretnim parametrima izvršavanja. Dobiti i pohraniti njegov plan izvršavanja koristeći EXPLAIN — elementarni je zadatak.
Štoviše, koristeći izraz EXPLAIN (COSTS FALSE), možete dobiti okvirni plan koji će se koristiti za dobivanje hash-vrijednosti plana, što pomaže pri kasnijoj analizi povijesti promjena plana izvršavanja.
Dobiti predložak plana izvršavanja
  --Objasni plan izvršavanja--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
Mogućnost br. 3 — Korištenje dnevnika zahtjeva za praćenje
Budući da su metričke performanse postavljene ne na tekst zahtjeva, već na njegov ID, potrebno je povezati zahtjeve iz dnevničkih datoteka s zahtjevima za koje su postavljene metričke performanse.
Pa barem da biste imali točno vrijeme nastanka incidenta s performansama.
Tako će, prilikom nastanka incidenta s performansama za ID zahtjeva, biti poveznica na određeni zahtjev s konkretnim vrijednostima parametara i točnim vremenom izvršavanja i trajanja zahtjeva. Ove informacije možete dobiti koristeći samo prikaz pg_stat_statements — ne može.
Pronađite queryid zahtjeva i ažurirajte zapis u tablici log_query
SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
      queryid ,
	  query
	 FROM
       pg_stat_db_queries
     WHERE
	   database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;

	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' for log_query with id = '||log_query_rec.id
		   				    ;

	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;
Epilog
Opisanička metoda na kraju je našla primjenu u , omogućujući više informacija za analizu prilikom rješavanja incidenata u performansama upita.
Iako, na moj osobni autoritativni pogled, još uvijek trebamo raditi na algoritmu odabira i promjene veličine učitane serije. Zadatak još nije riješen u općem slučaju. Vjerojatno će biti zanimljivo.
Ali to je već sasvim druga priča …
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish