

Dijelim osobno iskustvo o tome što, gdje i kada može biti korisno. Pregledno i sažeto, da bude jasno što i kamo dalje istraživati — no ovo su isključivo moja subjektivna iskustva, vi možda imate sve potpuno drugačije.
Zašto je važno znati i razumjeti jezike upita? U suštini, u Data Science-u postoji nekoliko ključnih faza rada, a prva i najvažnija (bez koje definitivno ništa neće funkcionirati!) — to je prikupljanje ili ekstrakcija podataka. Najčešće su podaci negdje pohranjeni u nekom formatu, a potrebno ih je 'izvući'.
Jezici upita upravo omogućuju ovu ekstrakciju podataka! Danas ću govoriti o jezicima upita koji su mi bili korisni i pokazat ću gdje i kako — zašto je to potrebno za učenje.
Zajedno ćemo obraditi tri glavna bloka tipova upita na podatke u ovom članku:
- „Standardni“ jezici upita — to je ono o čemu obično razmišljamo kada govorimo o jeziku upita, kao što su relacijska algebra ili SQL.
- Skriptnog jezika upita: na primjer, Python alati kao što su pandas, numpy ili shell scripting.
- Jezici upita za grafove znanja i graf baze podataka.
Sve što je ovdje napisano — to je samo osobno iskustvo, što je bilo korisno, s opisom situacija i „zašto je to bilo potrebno“ — svatko može procijeniti koliko se slične situacije mogu dogoditi i pokušati se unaprijed pripremiti, razrađujući ove jezike prije nego što ih bude morao (hitno) primijeniti na projektu ili uopće doći na projekt gdje su potrebni.
„Standardni“ jezici upita
Standardni jezici upita su oni o kojima obično razmišljamo kada govorimo o upitima.
Relacijska algebra
Zašto je danas potrebna relacijska algebra? Kako bismo imali dobar uvid u to zašto su jezici upita oblikovani na određeni način, moramo shvatiti osnovu koja leži iza njih.
Što je relacijska algebra?
Formalna definicija je: relacijska algebra — zatvoreni sustav operacija nad odnosima u relacijskoj modelu podataka. Ako malo ljudski kažemo, to je sustav operacija nad tablicama, tako da je rezultat također uvijek tablica.
Pogledajte sve relacijske operacije u Članak s Habr-a — ovdje opisujemo zašto je važno znati i gdje se to koristi.
Zašto?
Počinješ razumjeti na čemu se temelje jezici upita i koje operacije stoje iza izraza konkretnih jezika upita — često pruža dublje razumijevanje onoga što i kako radi u jezicima upita.
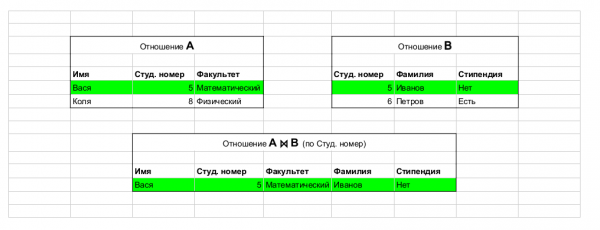
Preuzeto iz članka. Primjer operacije: join, koja spaja tablice.
Materijali za učenje:
. Uglavnom, postoji mnogo materijala o relacijalnoj algebri i teoriji — Coursera, Udacity. Također postoji veliki broj materijala online, uključujući dobre . Moj osobni savjet: potrebno je jako dobro razumjeti relacijalnu algebru — to je osnova osnova.
SQL
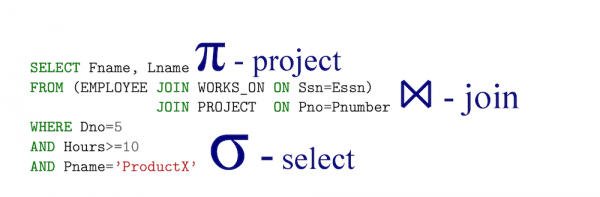
Preuzeto iz članka.
SQL je, u osnovi, implementacija relacijske algebre — s važnom napomenom, SQL je deklarativan! To jest, pišući upit na jeziku relacijske algebre, zapravo govoriš kako treba izračunati — dok sa SQL-om postavljaš što želiš izvući, a dalje DBMS već generira (efikasne) izraze na jeziku relacijske algebre (njihova ekvivalentnost je poznata pod ).
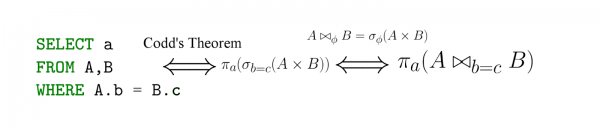
Preuzeto iz članka.
Zašto?
Relacijski DBMS: Oracle, Postgres, SQL Server itd. — i dalje su prakticki svuda i nevjerojatna je vjerojatnost da ćeš morati s njima komunicirati, a to znači da ćeš ili morati čitati SQL (što je vrlo vjerojatno), ili pisati na njemu (također nije malo vjerojatno).
Što čitati i učiti
Na istim linkovima iznad (o relacijskoj algebri) postoje nevjerojatne količine materijala, na primjer, .
Usput, što je to NoSQL?
„Još jednom treba naglasiti da termin 'NoSQL' ima potpuno spontanog podrijetla i nema općeprihvaćenu definiciju ili znanstvenu instituciju koja stoji iza njega.” Odgovarajući na Habru.
U osnovi, ljudi su shvatili da potpuna relacijska paradigma nije potrebna za rješavanje mnogih zadataka, posebno za one u kojima, primjerice, je bitna performansa i dominiraju određeni jednostavni upiti s agregacijom — tu je ključno brzo izračunati metrike i upisati ih u bazu, dok se većina karakteristika relacijske arhitekture pokazala ne samo nepotrebnima, nego i štetnima — zašto normalizirati nešto ako to narušava ono što nam je najvažnije (za neki konkretan zadatak) — performansu?
Također se često koriste fleksibilne sheme umjesto fiksnih matematičkih shema klasičnog relacijskog modela — to nevjerojatno pojednostavljuje razvoj aplikacija kada je kritično brzo implementirati sustav i početi raditi, obrađujući rezultate — ili shema i tipovi pohranjenih podataka nisu toliko važni.
Na primjer, stvaramo ekspertni sustav i želimo pohraniti informacije o određenoj domeni zajedno s nekim metapodacima — možemo niti ne znati sva polja i jednostavno pohraniti JSON za svaki zapis — to nam daje vrlo fleksibilno okruženje za proširenje modela podataka i brzo iteriranje — stoga bi u takvom slučaju NoSQL bio čak i poželjniji i čitljiviji. Primjer zapisa (iz jednog mog projekta, gdje je NoSQL bio baš gdje treba).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Više se može pročitati o NoSQL-u.
Što učiti?
Ovdje je vjerojatno potrebno samo dobro analizirati svoju zadaću, koje su njene karakteristike i koje NoSQL sustave imate koji bi odgovarali tom opisu — i potom se posvetiti proučavanju tog sustava.
Skriptski jezici upita
Prvo, čini se, kakve veze ima Python — to je programski jezik, a ne radi se uopće o upitima.
- Pandas je pravi švicarski nož za Data Science, golem broj transformacija podataka, agregacija itd. odvija se u njemu.
- Numpy — vektorske proračune, matrice i linearnu algebru tu.
- Scipy — puno matematike u ovom paketu, posebno statistike.
- Jupyter lab — puno istraživačke analize podataka dobro se uklapa u bilješke — korisno je znati.
- Requests — rad s mrežom.
- Pyspark — vrlo popularan među inženjerima podataka, vjerojatno ćete morati raditi s ovim ili Spark-om, jednostavno zbog njihove popularnosti.
- *Selenium — vrlo koristan za sakupljanje podataka sa stranica i resursa, ponekad jednostavno nije moguće dobiti podatke na drugi način.
Moj glavni savjet: učite Python!
Pandas
Uzmimo za primjer sljedeći kod:
import pandas as pd
df = pd.read_csv(“data/dataset.csv”)
# Izračunajte i preimenujte agregacije
all_together = (df[df[‘trip_type’] == “return”]
    .groupby(['start_station_name','end_station_name'])
                    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': min_duration_seconds',
           ‘amax': 'max_duration_seconds'}))
U suštini, vidimo da se kod uklapa u klasični SQL obrazac.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Ali važan deo je da je ovaj kod deo skripte i pipeline-a, zapravo ugrađujemo upite u Python pipeline. U ovoj situaciji jezik upita dolazi iz biblioteka kao što su Pandas ili pySpark.
U suštini, u pySpark-u vidimo sličan tip transformacije podataka kroz jezik upita u duhu:
df.filter(df.trip_type = "return")
  .groupby("day")
  .agg({duration: 'mean'})
  .sort()
Gde i šta pročitati
O samom Pythonu uopšte naći materijale za učenje. Na mreži postoji ogroman broj tutorijala o , i kursevima o (kao i o samom ). U suštini, materijali se fenomenalno nalaze na Google-u i ako bih morao da izaberem jedan paket na kojem treba da se fokusiram — to bi svakako bio pandas. O vezi DS+Python materijala takođe .
Shell kao jezik upita
Nekoliko projekata za obradu i analizu podataka s kojima sam radio — to su zapravo shell skripte koje pozivaju kod na Pythonu, na Javi i same shell komande. Zbog toga se pipeline-i u bashu/zsh/itd. mogu smatrati nekom visokom razinom upita (možete tu, naravno, ubaciti i petlje, ali to nije tipično za DS kod na shell jezicima), daćemo jednostavan primer — morao sam da napravim mapiranje QID sa Vikipedije i potpune linkove na rusku i englesku Vikipediju, za to sam napisao jednostavan upit iz komandi u bashu i za izlaz napisao jednostavni skript na Pythonu, koje sam spojio ovako:
pv "data/latest-all.json.gz" |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
gdje
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' To je zapravo bio ceo pipeline, koji je kreirao potrebno mapiranje, kao što vidimo, sve je radilo u režimu toka:
- pv filepath — daje progress bar na osnovu veličine fajla i prosleđuje njegov sadržaj dalje
- unpigz -c čitao deo arhive i prosleđivao jq
- jq sa ključem — stream odmah izdavao rezultat i prosleđivao ga postprocesoru (kao i sa samim prvim primerom) na Pythonu
- unutar postprocesora — to je jednostavna mašina stanja koja formatira izlaz
Dakle, složena pipeline koja radi u režimu strimanja na velikim podacima (0.5TB), bez značajnih resursa, sastavljena je od jednostavnog pipeline-a i nekoliko alata.
Još jedan važan savjet: naučite dobro i efikasno raditi u terminalu i pisati na bash/zsh/itd.
Gdje se to može primijeniti? Pa gotovo svugdje — materijala za učenje opet ima JAKO mnogo na mreži. Konkretno, evo mog prethodnog članka.
R skripting
Ponovo, čitatelj bi mogao uzviknuti — pa to je cijeli programski jezik! I, naravno, bio bi u pravu. Međutim, obično sam se susretao s R uvijek u kontekstu gdje je to u suštini ličilo na jezik upita.
R je okruženje za statističke proračune i jezik za statističke proračune i vizualizaciju (prema ).
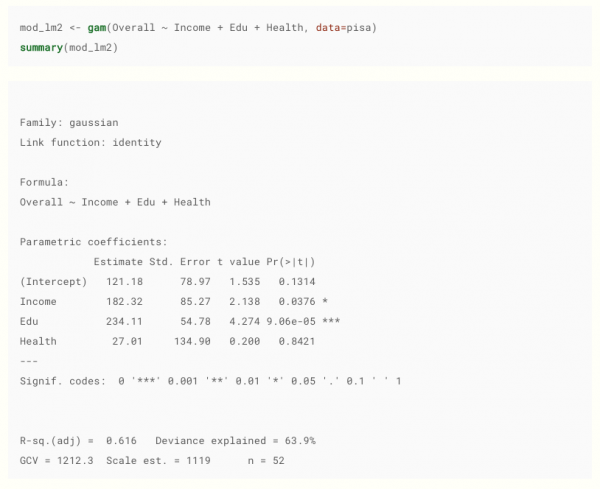
Uzimajući . Usput, preporučujem, dobar materijal.
Zašto bi data scientist trebao znati R? Prije svega, zato što postoji ogroman broj ljudi van IT-a koji se bave analizom podataka u R. Susretao sam ih na sljedećim mjestima:
- Farmaceutski sektor.
- Biolozi.
- Financijski sektor.
- Ljudi sa čistim matematičkim obrazovanjem koji se bave statistikom.
- Specijalizirani statistički modeli i modeli strojnog učenja (koji se često mogu naći samo u autorskoj verziji kao R paketi).
Zašto je to zapravo jezik upita? U obliku u kojem se najčešće susreće — to je zapravo upit za izradu modela, uključujući čitanje podataka i fiksiranje parametara upita (modela), kao i vizualizaciju podataka u paketima poput ggplot2 — to je također oblik pisanja upita.
Primjer upita za vizualizaciju
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Općenito, mnoge ideje iz R-a prešle su u pakete za python, kao što su pandas, numpy ili scipy, poput dataframe-a i vektorizacije podataka — stoga će vam većina stvari u R-u djelovati poznato i udobno.
Ima mnogo izvora za učenje, na primjer, .
Grafovi znanja (Knowledge graph)
Ovdje imam malo nesvakidašnje iskustvo, jer često moram raditi s grafovima znanja i jezicima upita za grafove. Zato ćemo samo ukratko proći kroz osnove, jer je ovaj dio malo egzotičniji.
U klasičnim relacijskim bazama imamo fiksnu shemu - ovdje je shema fleksibilna, svaki predikat je zapravo "stupac" i čak više od toga.
Zamislite da modelirate osobu i želite opisati ključne stvari, uzmimo za primjer konkretnu osobu Douglasa Adamsa, oslonimo se na ovo opis.
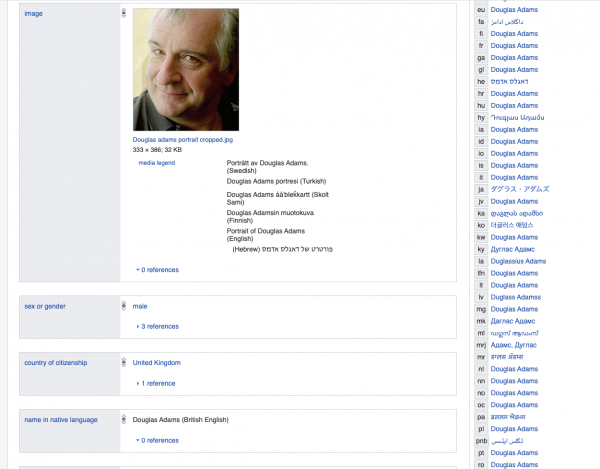
Da smo koristili relacijsku bazu, morali bismo stvoriti ogroman stol ili stolove s ogromnim brojem stupaca, većina kojih bi bila NULL ili ispunjena nekim zadanim lažnim vrijednostima, na primjer, rijetko tko od nas ima zapis u nacionalnoj korejskoj biblioteci - naravno, mogli bismo ih izdvojiti u odvojene tablice, ali to bi na kraju bila pokušaj modeliranja fleksibilne logičke sheme s predikatima korištenjem fiksne relacijske.
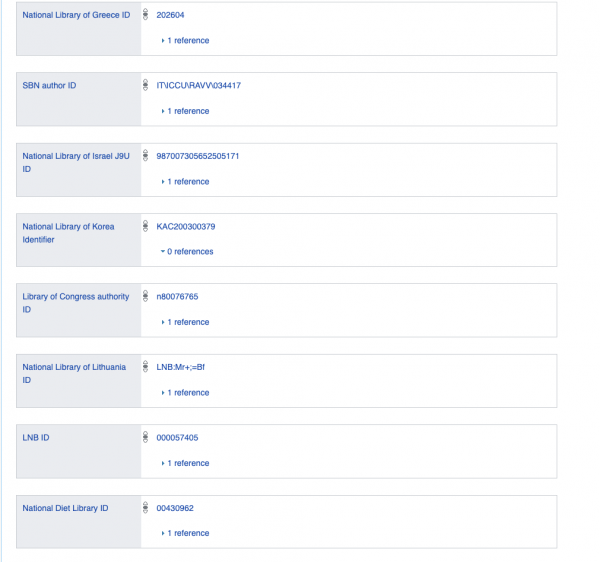
Stoga zamislite da se svi podaci pohranjuju u obliku grafa ili u obliku binarnih i unarnih logičkih izraza.
Gdje se uopće možete s tim susresti? Prvo, radeći s , i bilo kojim grafovnim bazama podataka ili povezanim podacima.
Zatim slijede glavni jezici upita koje sam morao primijeniti i s kojima sam radio.
SPARQL
Wiki:
SPARQL ( od SPARQL Protocol and RDF Query Language) — , predstavljene prema modelu , kao i za prijenos tih upita i odgovora na njih. SPARQL je preporuka i jedna od tehnologija .
U suštini, to je jezik upita za logičke unarne i binarne predikate. Jednostavno je uvjetno navedeno što je fiksno u logičkom izrazu, a što nije (veoma pojednostavljeno).
Sama RDF baza (Resource Description Framework), na kojoj se izvršavaju SPARQL upiti - to su trojke objekt, predikat, subjekt — i upit bira potrebne trojke prema navedenim ograničenjima u duhu: pronaći takvo X da p_55(X, q_33) vrijedi - gdje, naravno, p_55 je neka veza s ID-jem 55, a q_33 je objekt s ID-jem 33 (to je cijela priča, opet zanemarujući razne detalje).
Primjer predstavljanja podataka:
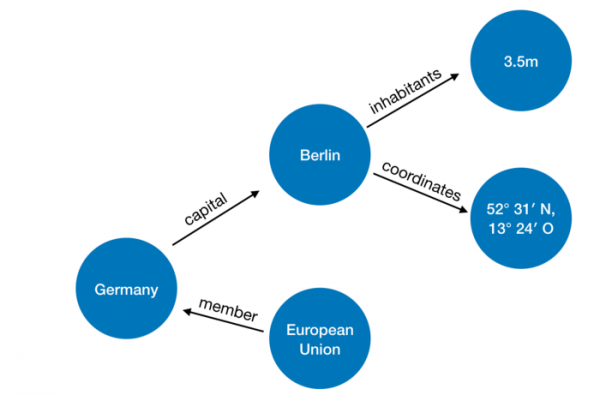
Slike i primjer s državama su ovdje .
Primjer osnovnog upita
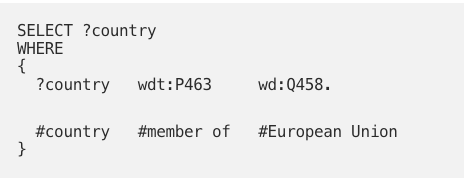
U suštini želimo pronaći vrijednost varijable ?country, takvu da za predikat
member_of, vrijedi da member_of(?country,q458), a q458 je ID Europske unije.
Primjer stvarnog SPARQL upita unutar Python motora:
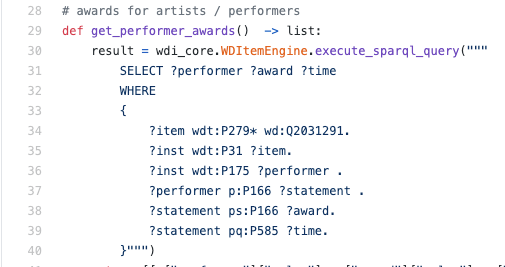
Obično sam morao čitati SPARQL, a ne pisati – u takvoj situaciji, vjerojatno će biti korisno znati jezik barem na osnovnoj razini kako bih razumio kako se podaci izvode.
Online ima mnogo materijala za učenje: na primjer, evo i . Obično pretražujem specifične konstrukcije i primjere, i dosad mi je to bilo dovoljno.
Logički jezici upita
Više o toj temi možete pročitati u mom članku . Ovdje ćemo samo ukratko razmotriti zašto su logički jezici dobri za pisanje upita. U suštini, RDF je samo skup logičkih tvrdnji poput p(X) i h(X,Y), a logički upit ima sljedeći oblik:
output(X) :- country(X), member_of(X, "EU").
Ovdje govorimo o stvaranju novog predikata output/1 ( /1 – znači unarni), pod uvjetom da za X vrijedi da je country(X) – tj., X je država, i također member_of(X, "EU").
Dakle, u našem slučaju podaci i pravila su predstavljeni potpuno jednako, što omogućuje vrlo jednostavno i dobro modeliranje problema.
Gdje se susreću u industriji: cijeli veliki projekt s tvrtkom koja piše upite na takvom jeziku, kao i na trenutnom projektu u jezgru sustava – činilo bi se, stvar prilično egzotična, no ponekad se susreće.
Primjer fragmenta koda na logičkom jeziku koji obrađuje wikidata:
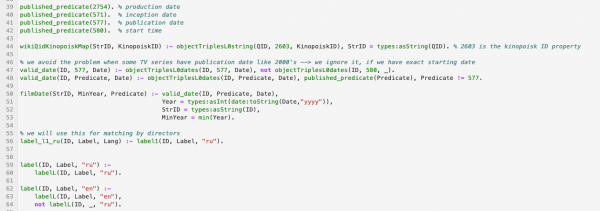
Materijali: ovdje ću navesti nekoliko linkova na moderni logički programski jezik Answer Set Programming – preporučujem da baš njega naučite:
Izvor: habr.com
