

Dragi čitatelji, dobar dan. Danas ćemo malo razgovarati o Apache Sparku i njegovim perspektivama razvoja.
U današnjem svijetu Big Data, Apache Spark je de facto standard za razvoj aplikacija za grupnu obradu podataka. Osim toga, koristi se i za izradu streaming aplikacija koje rade u konceptu micro batch, obrađujući i isporučujući podatke u malim količinama (Spark Structured Streaming). Tradicionalno, bio je dio općeg Hadoop stoga, koristeći YARN kao menadžer resursa (ili, u nekim slučajevima, Apache Mesos). Do 2020. godine, njegova upotreba u tradicionalnom obliku za većinu kompanija dovela je u pitanje zbog nedostatka kvalitetnih Hadoop distribucija - razvoj HDP-a i CDH-a je zaustavljen, CDH nije dovoljno razvijen i ima visoku cijenu, dok su ostali Hadoop dobavljači ili prestali s postojanjem ili imaju nejasnu budućnost. Stoga sve veći interes u zajednici i među velikim kompanijama izaziva pokretanje Apache Sparka putem Kubernetes-a - postajući standard u orkestraciji kontejnera i upravljanju resursima u privatnim i javnim oblacima, rješava problem s neugodnim planiranjem resursa zadataka Sparka na YARN-u i pruža stabilnu platformu s brojnim komercijalnim i otvorenim distribucijama za kompanije svih veličina i profila. Osim toga, zbog porasta popularnosti većina je već uspela stvoriti nekoliko vlastitih instalacija i steći ekspertizu u njegovoj upotrebi, što olakšava migraciju.
Od verzije 2.3.0, Apache Spark je dobio službenu podršku za pokretanje zadataka u Kubernetes klasteru i danas ćemo razgovarati o trenutnoj zrelosti ovog pristupa, različitim vremenima njegove upotrebe i preprekama s kojima ćete se susresti prilikom implementacije.
Prvo, razmotrite proces razvoja zadataka i aplikacija temeljenih na Apache Sparku i istaknite tipične slučajeve kada je potrebno pokrenuti zadatak na Kubernetes klasteru. U pripremi ovog posta korišten je OpenShift kao distribucija, a bit će navedene komande relevantne za njegov CLI alat (oc). Za druge Kubernetes distribucije mogu se koristiti odgovarajuće komande standardnog Kubernetes CLI alata (kubectl) ili njihovi ekvivalenti (npr. za oc adm policy).
Prva opcija korištenja — spark-submit
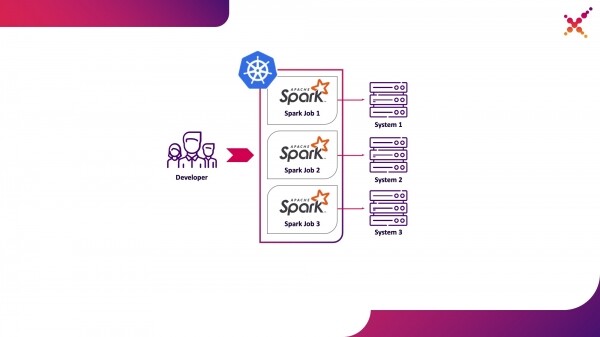
Tijekom razvoja zadataka i aplikacija, programer treba pokretati zadatke radi debugiranja transformacija podataka. Teoretski, za te svrhe mogu se koristiti stubovi, no razvoj s pravim (čak i testnim) primjerima krajnjih sustava pokazao se u ovoj klasi zadataka bržim i kvalitetnijim. U slučaju kada izvršavamo debugiranje na stvarnim primjerima krajnjih sustava, mogući su dva scenarija rada:
- programer pokreće Spark zadatak lokalno u standalone modu;

- programer pokreće Spark zadatak na Kubernetes klasteru u testnom okruženju.
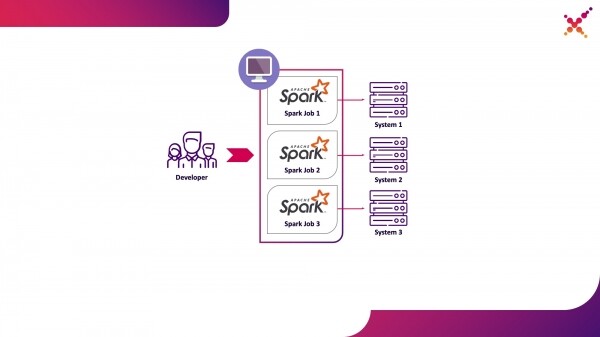
Prva opcija ima pravo na postojanje, ali nosi sa sobom niz nedostataka:
- za svakog programera potrebno je osigurati pristup sa radnog mjesta do svih potrebnih mu primjeraka krajnjih sustava;
- na radnoj mašini potrebno je imati dovoljno resursa za pokretanje razvijenog zadatka.
Druga opcija je lišena tih nedostataka, jer korištenje Kubernetes klastera omogućava dodjeljivanje potrebnog skupa resursa za pokretanje zadataka i osiguranje potrebnih pristupa do primjeraka krajnjih sustava, fleksibilno pružajući pristup putem uloge modela Kubernetes za sve članove razvojne ekipe. Istaknimo to kao prvu opciju korištenja — pokretanje Spark zadataka s lokalnog računala programera na Kubernetes klasteru u testnom okruženju.
Detaljnije ćemo objasniti proces postavljanja Sparka za lokalno pokretanje. Da biste počeli koristiti Spark, potrebno ga je instalirati:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Skupljamo potrebne pakete za rad s Kubernetesom:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Potpuna izgradnja traje dugo, a za stvaranje Docker slika i njihovo pokretanje na Kubernetes klasteru u stvarnosti potrebni su samo jar datoteke iz direktorija «assembly/», stoga se može izgraditi samo ovaj podprojekt:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Za pokretanje Spark zadataka u Kubernetesu potrebno je stvoriti Docker sliku koja će se koristiti kao osnovna. Postoje dva pristupa:
- Stvorena Docker slika uključuje izvršni kod Spark zadatka;
- Stvoreni obraz uključuje samo Spark i potrebne zavisnosti, izvršni kod se pohranjuje na udaljeno mjesto (npr. u HDFS).
Za početak, sastavimo Docker sliku koja sadrži testni primjer zadatka Spark. Za izradu Docker slika Spark ima odgovarajući alat pod nazivom "docker-image-tool". Proučimo njegovu pomoć:
.\/bin\/docker-image-tool.sh --help
Pomoću njega možete stvarati Docker slike i učitavati ih u udaljene registre, ali prema zadanim postavkama ima niz nedostataka:
- obavezno stvara odmah 3 Docker slike — pod Spark, PySpark i R;
- ne omogućuje navediti ime slike.
Stoga ćemo koristiti modificiranu verziju ovog alata, prikazanu u nastavku:
vi bin\/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Pomoću njega sastavljamo osnovni Spark obrazac, koji sadrži testni zadatak za izračunavanje broja Pi uz pomoć Sparka (ovdje {docker-registry-url} — URL vašeg registra Docker slika, {repo} — ime repozitorija unutar registra, koje odgovara projektu u OpenShift, {image-name} — ime slike (ako se koristi trostupanjska podjela slika, npr. kao u integriranom registru slika Red Hat OpenShift), {tag} — oznaka ove verzije slike):
.\/bin\/docker-image-tool-upd.sh -f resource-managers\/kubernetes\/docker\/src\/main\/dockerfiles\/spark\/Dockerfile -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} build
Autentificiramo se u OKD klasteru putem konzolne utilite (ovdje {OKD-API-URL} — URL API klastera OKD):
oc login {OKD-API-URL}
Dobijamo token trenutnog korisnika za autentifikaciju u Docker Registry:
oc whoami -t
Autentificiramo se u unutarnjem Docker Registry klastera OKD (kao lozinku koristimo token dobiven prethodnom naredbom):
docker login {docker-registry-url}
Učitavamo sastavljeni Docker obraz u Docker Registry OKD:
.\/bin\/docker-image-tool-upd.sh -r {docker-registry-url}\/ {repo} -i {image-name} -t {tag} push
Provjeravamo da li je sastavljeni obraz dostupan u OKD. Za to otvaramo u pregledniku URL sa popisom slika odgovarajućeg projekta (ovdje {project} — ime projekta unutar klastera OpenShift, {OKD-WEBUI-URL} — URL Web konzole OpenShift) — https:\/{OKD-WEBUI-URL}\/console\/project\/{project}\/browse\/images\/{image-name}.
Za pokretanje zadataka treba stvoriti korisnički račun s privilegijama pokretanja podova s rootom (o tome ćemo dalje raspraviti):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Izvršit ćemo naredbu spark-submit za objavljivanje zadatka Spark u klasteru OKD, navodeći stvoreni korisnički račun i Docker sliku:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Ovdje:
—name — ime zadatka, koje će učestvovati u formiranju imena podova Kubernetes;
—class — klasa izvršne datoteke koja se poziva prilikom pokretanja zadatka;
—conf — konfiguracijski parametri Sparka;
spark.executor.instances — broj pokrenutih Spark izvršitelja;
spark.kubernetes.authenticate.driver.serviceAccountName — ime servisnog računa Kubernetes koji se koristi prilikom pokretanja podova (za određivanje sigurnosnog konteksta i mogućnosti prilikom interakcije s Kubernetes API-em);
spark.kubernetes.namespace — Kubernetes prostor imena u kojem će se pokretati podovi vozača i izvršitelja;
spark.submit.deployMode — način pokretanja Sparka (za standardni spark-submit koristi se «cluster», za Spark Operator i novije verzije Sparka «client»);
spark.kubernetes.container.image — Docker slika koja se koristi za pokretanje podova;
spark.master — URL Kubernetes API-ja (navodi se vanjski URL za pristup s lokalnog računala);
local:// — put do izvršne datoteke Sparka unutar Docker slike.
Idemo u odgovarajući OKD projekt i proučavamo stvorene podove — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Za pojednostavljenje razvoja može se koristiti još jedna opcija, gdje se stvara zajednička osnovna Spark slika koja se koristi za sve zadatke za pokretanje, a snimke izvršnih datoteka se objavljuju na vanjskoj pohrani (npr. Hadoop) i navode se prilikom poziva spark-submit kao poveznica. U tom slučaju se mogu pokretati različite verzije Spark zadataka bez ponovne izgradnje Docker slika, koristeći za objavu slika, na primjer, WebHDFS. Šaljemo zahtjev za izradu datoteke (ovdje {host} — host WebHDFS usluge, {port} — port WebHDFS usluge, {path-to-file-on-hdfs} — željeni put do datoteke na HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
U tom slučaju dobit ćemo odgovor u obliku (ovdje {location} — URL koji treba koristiti za prijenos datoteke):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Prijenos izvršne datoteke Sparka na HDFS (ovdje {path-to-local-file} — put do izvršne datoteke Sparka na trenutnom hostu):
curl -i -X PUT -T {path-to-local-file} "{location}"
Nakon toga možemo izvršiti spark-submit koristeći datoteku Sparka prenesenu na HDFS (ovdje {class-name} — ime klase koju treba pokrenuti radi izvršenja zadatka):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Treba napomenuti da za pristup HDFS-u i osiguranje rada zadatka može biti potrebno promijeniti Dockerfile i skriptu entrypoint.sh — dodati u Dockerfile direktivu za kopiranje ovisnih knjižnica u direktorij /opt/spark/jars i uključiti datoteku konfiguracije HDFS u SPARK_CLASSPATH u entrypoint.sh.
Druga opcija korištenja — Apache Livy
Zatim, kada je zadatak razvijen i potrebno je testirati dobivene rezultate, pojavljuje se pitanje pokretanja unutar CI/CD procesa i praćenja statusa njegove izvedbe. Naravno, može se pokretati pomoću lokalnog poziva spark-submit, ali to komplicira CI/CD infrastrukturu jer zahtijeva instalaciju i konfiguraciju Sparka na agentima/runnerima CI servera oraz postavljanje pristupa API-ju Kubernetesa. Za ovaj slučaj izabrana je implementacija korištenja Apache Livy kao REST API-a za pokretanje Spark zadataka smještenih unutar Kubernetesa. Pomoću toga se mogu pokretati Spark zadaci unutar Kubernetesa koristeći obične cURL zahtjeve, što je lako provedivo na osnovi bilo kojeg CI rješenja, a njegovo smještanje unutar Kubernetesa rješava pitanje autentifikacije prilikom interakcije s API-jem Kubernetesa.
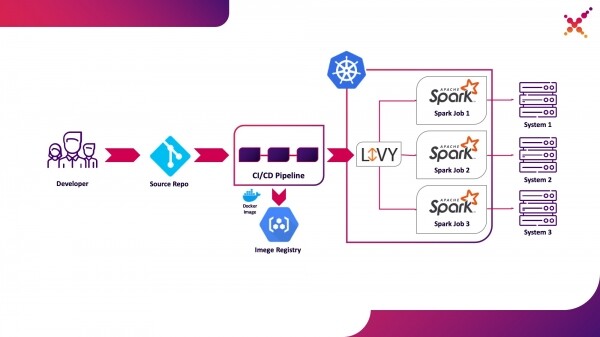
Izdvojit ćemo ga kao drugu opciju korištenja — pokretanje Spark zadataka unutar CI/CD procesa na Kubernetescu u testnom okruženju.
Malo o Apache Livy — on djeluje kao HTTP server koji pruža web sučelje i RESTful API, omogućujući daljinsko pokretanje spark-submit-a s potrebnim parametrima. Tradicionalno se isporučivao u okviru distribucije HDP, ali se također može implementirati u OKD ili bilo kojoj drugoj instalaciji Kubernetesa pomoću pripadajuće manifeste i seta Docker slika, na primjer, ove — . Za naš slučaj je izgrađena slična Docker slika koja uključuje Spark verzije 2.4.5 iz sljedećeg Dockerfile-a:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Stvorena slika može se sastaviti i učitati u vaš postojeći Docker repozitorij, na primjer, unutarnji repozitorij OKD. Za njegovo postavljanje koristi se sljedeći manifest ({registry-url} — URL Docker repozitorija, {image-name} — naziv Docker slike, {tag} — oznaka Docker slike, {livy-url} — željeni URL putem kojeg će biti dostupan Livy server; manifest "Route" koristi se ako se kao distribucija Kubernetes koristi Red Hat OpenShift, u suprotnom se koristi odgovarajući manifest Ingress ili Service tipa NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Nakon njegove primjene i uspješnog pokretanja poda, grafičko sučelje Livy dostupno je na poveznici: http://{livy-url}/ui. Uz Livy možemo objaviti našu Spark zadatak koristeći REST zahtjev, primjerice, iz Postmana. Primjer kolekcije sa zahtjevima predstavljen je u nastavku (u nizu „args“ mogu se prenijeti konfiguracijski argumenti s varijablama potrebnim za rad pokretane zadaće):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Pošaljite posao s jar-om",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Pošaljite posao bez jar-a",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Izvršimo prvi zahtjev iz kolekcije, idemo u sučelje OKD i provjeravamo je li zadatak uspješno pokrenut — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. U isto vrijeme, u sučelju Livy (http://{livy-url}/ui) će se pojaviti sesija u okviru koje se putem Livy API-a ili grafičkog sučelja može pratiti napredak izvršavanja zadataka i proučiti logove sesije.
Sada ćemo prikazati mehanizam rada Livy. Za to ćemo proučiti dnevnike Livy kontejnera unutar poda s Livy serverom — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Iz njih se može vidjeti da se prilikom pozivanja Livy REST API-a u kontejneru s imenom „livy” izvršava spark-submit, sličan onome koji smo koristili ranije (ovdje {livy-pod-name} predstavlja ime stvorenog poda s Livy serverom). U kolekciji je također predstavljen drugi zahtjev koji omogućuje pokretanje zadataka s udaljenim smještajem izvršnog datoteke Spark putem Livy servera.
Treća opcija korištenja — Spark Operator
Sada, kada je zadatak testiran, postavlja se pitanje njegove redovite izvedbe. Nativni način za redovito pokretanje zadataka u Kubernetes klasteru je entitet CronJob i može se koristiti, no trenutno se sve više popularizira korištenje operatora za upravljanje aplikacijama u Kubernetesu, a za Spark postoji dovoljno zreo operator koji se, između ostalog, koristi u rješenjima poduzeća (na primjer, Lightbend FastData Platform). Preporučujemo njegovo korištenje — trenutna stabilna verzija Sparka (2.4.5) ima prilično ograničene mogućnosti konfiguracije pokretanja Spark zadataka u Kubernetesu, dok je u sljedećoj glavnoj verziji (3.0.0) najavljena potpuna podrška za Kubernetes, ali datum njenog izlaska ostaje nepoznat. Spark Operator nadoknađuje ovaj nedostatak dodavanjem važnih parametara konfiguracije (na primjer, montiranje ConfigMap s konfiguracijom pristupa Hadoop-u u Spark podove) i mogućnost redovitog pokretanja zadataka prema rasporedu.
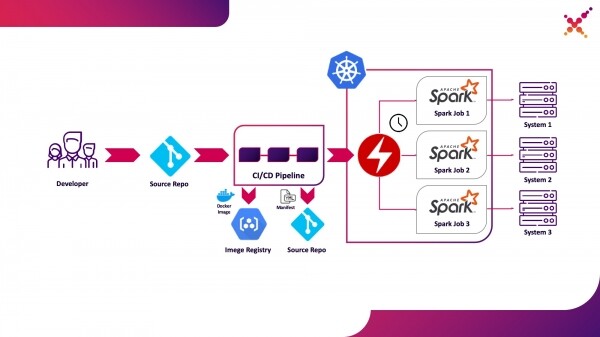
Istaknimo ga kao treću opciju korištenja — redovito pokretanje Spark zadataka u Kubernetes klasteru u produkcijskom okruženju.
Spark Operator ima otvoreni izvorni kod i razvija se unutar Google Cloud Platforme — . Njegova instalacija može se izvršiti na 3 načina:
- Kroz instalaciju Lightbend FastData Platform/Cloudflow;
- Pomoću Helma:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Korištenjem manifestacija iz službenog repozitorija (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Važno je napomenuti da Cloudflow uključuje operator s API verzijom v1beta1. Ako se koristi ovaj tip instalacije, opisi manifestacija aplikacija Spark trebaju se temeljiti na primjerima iz oznaka u Gitu s odgovarajućom verzijom API-a, na primjer, «v1beta1-0.9.0-2.4.0». Verziju operatora možete provjeriti u opisu CRD-a koji dolazi s operatorom u rječniku «versions»:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Ako je operator ispravno instaliran, u odgovarajućem projektu pojavit će se aktivni pod s operatorom Spark (na primjer, cloudflow-fdp-sparkoperator u prostoru Cloudflow za instalaciju Cloudflow) i pojavit će se odgovarajući tip resursa Kubernetes s imenom «sparkapplications». Postojeće aplikacije Spark možete pregledati pomoću sljedeće naredbe:
oc get sparkapplications -n {project}
Za pokretanje zadataka putem Spark Operatora potrebno je učiniti 3 stvari:
- stvoriti Docker imidž koji uključuje sve potrebne biblioteke, kao i konfiguracijske i izvršne datoteke. U ciljanom scenariju to je imidž koji je kreiran tijekom CI/CD faze i testiran na testnom klasteru;
- objaviti Docker imidž u registru dostupnom iz Kubernetes klastera;
- formirati manifest s tipom «SparkApplication» i opisom pokretane zadaće. Primjeri manifestacija dostupni su u službenom repozitoriju (na primjer, ). Važno je istaknuti nekoliko bitnih točaka o manifestu:
- u rječniku «apiVersion» mora biti navedena verzija API-a koja odgovara verziji operatora;
- u rječniku «metadata.namespace» mora biti navedeno ime prostora u kojem će aplikacija biti pokrenuta;
- u rječniku «spec.image» mora biti navedena adresa izrađenog Docker imidža u dostupnom registru;
- u rječniku «spec.mainClass» mora biti naveden klasa Spark zadatka koji treba pokrenuti prilikom pokretanja procesa;
- u rječniku «spec.mainApplicationFile» mora biti navedena putanja do izvršne jar datoteke;
- u rječniku «spec.sparkVersion» mora biti navedena korištena verzija Sparka;
- u rječniku «spec.driver.serviceAccount» mora biti navedena servisna korisnička račun unutar odgovarajućeg Kubernetes prostora koji će se koristiti za pokretanje aplikacije;
- u rječniku «spec.executor» treba biti navedena količina resursa dodijeljenih aplikaciji;
- U rječniku «spec.volumeMounts» mora biti navedena lokalna direktorija u kojoj će se stvarati lokalne datoteke zadatka Spark.
Primjer formiranja manifesta (ovdje {spark-service-account} je servisni račun unutar Kubernetes klastera za pokretanje Spark zadataka):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Ovaj manifest navodi servisni račun za koji je potrebno stvoriti potrebne veze uloga prije objave manifesta, koje daju potrebna dopuštenja za interakciju Spark aplikacije s Kubernetes API-em (ako je potrebno). U našem slučaju aplikaciji su potrebna prava za stvaranje Pod-ova. Stvorit ćemo potrebnu vezu uloge:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Također, važno je napomenuti da u specifikaciji ovog manifesta može biti naveden parametar „hadoopConfigMap“, koji omogućava označavanje ConfigMap s Hadoop konfiguracijom bez potrebe za prethodnim smještanjem odgovarajuće datoteke u Docker sliku. Također se uklapa za redovno pokretanje zadataka — uz pomoć parametra „schedule“ može se odrediti raspored pokretanja ovog zadatka.
Nakon toga spremamo naš manifest u datoteku spark-pi.yaml i primjenjujemo ga na naš Kubernetes klaster:
oc apply -f spark-pi.yaml
Tako će se stvoriti objekt tipa „sparkapplications“:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Također će biti stvoren pod s aplikacijom, čiji će status biti prikazan u stvaranom „sparkapplications“. Može se pregledati sljedećom komandom:
oc get sparkapplications spark-pi -o yaml -n {project}
Nakon završetka zadatka POD će preći u status „Completed“, koji će također biti ažuriran u „sparkapplications“. Logove aplikacije može se pregledati u pregledniku ili pomoću sljedeće komande (ovdje {sparkapplications-pod-name} je ime poda pokrenutog zadatka):
oc logs {sparkapplications-pod-name} -n {project}
Upravljanje Spark zadacima također može biti obavljeno pomoću specijaliziranog alata sparkctl. Za njegovu instalaciju kloniramo repozitorij s izvorim kodom, instaliramo Go i sastavljamo ovaj alat:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Pogledajmo popis pokrenutih Spark zadataka:
sparkctl list -n {project}
Stvorit ćemo opis za Spark zadatak:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Pokrenut ćemo opisani zadatak pomoću sparkctl:
sparkctl create spark-app.yaml -n {project}
Pogledajmo popis pokrenutih Spark zadataka:
sparkctl list -n {project}
Pogledajmo popis događaja pokrenutog Spark zadatka:
sparkctl event spark-pi -n {project} -f
Pogledajmo status pokrenutog Spark zadatka:
sparkctl status spark-pi -n {project}
Na kraju, željeli bismo razmotriti otkrivene nedostatke u korištenju trenutne stabilne verzije Sparka (2.4.5) u Kubernetesu:
- Prva i, vjerojatno, glavna mana je nedostatak lokalnosti podataka. Unatoč svim nedostacima, YARN je imao i prednosti, poput principa isporuke koda do podataka (umjesto podataka do koda). Zbog toga su Spark zadaci izvršavani na čvorovima gdje su se nalazili podaci potrebni za izračune, što je znatno smanjilo vrijeme prijenosa podataka preko mreže. Kada koristimo Kubernetes, suočavamo se s potrebom prijenosa podataka preko mreže koji su uključeni u izvršavanje zadatak. U slučaju da su ti podaci dovoljno veliki, vrijeme izvršavanja zadatka može se značajno povećati, kao i potreba za velikim volumenom diskovnog prostora dodijeljenog instancama Spark zadatka za njihovo privremeno pohranjivanje. Ovaj nedostatak može se smanjiti korištenjem specijaliziranih softverskih alata za osiguravanje lokalnosti podataka u Kubernetesu (npr. Alluxio), ali to zapravo znači potrebu za pohranom pune kopije podataka na čvorovima Kubernetes klastera.
- Druga značajna mana je sigurnost. Zadano su funkcije povezane s osiguravanjem sigurnosti pokretanja Spark zadataka onemogućene, a upotreba Kerberosa nije pokrivena u službenoj dokumentaciji (iako su odgovarajući parametri uvedeni u verziji 3.0.0, što zahtijeva dodatno razrađivanje). U dokumentaciji o osiguranju sigurnosti pri korištenju Sparka (https://spark.apache.org/docs/2.4.5/security.html) kao spremišta ključeva spominju se samo YARN, Mesos i Samostalni Klaster. Pri tome se korisnik pod kojim se pokreću Spark zadaci ne može izravno odrediti — samo zadamo servisni račun pod kojim će raditi, a korisnik se bira na temelju postavljenih politika sigurnosti. Zbog toga koristimo ili korisnika root, što nije sigurno u produkcijskom okruženju, ili korisnika s nasumičnim UID-om, što je nezgodno pri dodjeli prava pristupa podacima (što se može riješiti kreiranjem PodSecurityPolicies i njihovom vezom s odgovarajućim servisnim računima). Trenutno se to rješava ili stavljanjem svih potrebnih datoteka izravno u Docker sliku, ili modifikacijom pokretačkog skripta Sparka za korištenje mehanizma pohrane i preuzimanja tajni koji je prihvaćen u vašoj organizaciji.
- Pokretanje Spark zadataka putem Kubernetesa službeno se i dalje nalazi u eksperimentalnoj fazi, a u budućnosti su moguće značajne promjene u korištenim artefaktima (konfiguracijskim datotekama, osnovnim Docker slikama i skriptama za pokretanje). I doista — prilikom pripreme materijala testirane su verzije 2.3.0 i 2.4.5, a ponašanje se znatno razlikovalo.
Čekamo ažuriranja — nedavno je objavljena nova verzija Sparka (3.0.0), koja je donijela značajne promjene u radu Sparka na Kubernetesu, ali je zadržala eksperimentalni status podrške za ovog menadžera resursa. Moguće je da će sljedeća ažuriranja doista omogućiti punu preporuku odustajanja od YARN-a i pokretanja Spark zadataka na Kubernetesu, bez brige o sigurnosti vašeg sustava i bez potrebe za vlastitim doradama funkcionalnih komponenti.
Kraj.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish