

Bok, Habr! Predstavljam vam prijevod članka
.
Kada je u pitanju relacijske baze podataka, ne mogu se oteti dojmu da nešto nedostaje. Koriste se svugdje. Postoji mnogo različitih baza podataka: od malog i korisnog SQLite-a do moćne Teradate. No, postoji samo nekoliko članaka koji objašnjavaju kako baza podataka funkcionira. Možete sami pretraživati pod upitom "howdoesarelationaldatabasework" kako biste vidjeli koliko je malo rezultata. Štoviše, ti članci su kratki. Ako pak tražite najnovije popularne tehnologije (BigData, NoSQL ili JavaScript), pronaći ćete više dubinskih članaka koji objašnjavaju kako funkcionišu.
Jesmo li relacijske baze podataka previše stare i dosadne da bi se objasnile izvan sveučilišnih kolegija, istraživačkih radova i knjiga?
Kao programer, mrzim koristiti ono što ne razumijem. A ako se baze podataka koriste više od 40 godina, mora postojati razlog za to. Tijekom tih godina, potrošio sam stotine sati pokušavajući zaista razumjeti te posebne crne kutije koje koristim svaki dan. Relacijske baze podataka vrlo su zanimljive, jer su temeljene na korisnim i višekratno korištenim konceptima. Ako vas zanima razumijevanje baze podataka, ali nikada niste imali vremena ili volje zaroniti u ovu opsežnu temu, ova će vam se članak svidjeti.
Iako je naziv ovog članka jasan, cilj ovog članka nije razumjeti kako koristiti bazu podataka. Stoga, već biste trebali znati kako napisati jednostavni upit za spoj i osnovne upite CRUD; inače možda nećete razumjeti ovaj članak. To je jedina stvar koju trebate znati, objasnit ću sve ostalo.
Počet ću s nekim osnovama računalnih znanosti, poput vremenske složenosti algoritama (BigO). Znam da neki od vas mrze ovaj koncept, ali bez njega nećete moći razumjeti suptilnosti unutar baze podataka. Budući da je to ogromna tema, usredotočit ću se na ono što smatram važnim kako baza podataka obrađuje: upit SQL upit. Predstavit ću samo osnovne koncepte baze podataka, tako da na kraju članka imate predstavu o tome što se događa ispod haube.
Budući da je ovo dugačak i tehnički članak koji uključuje brojne algoritme i strukture podataka, ne žurite s čitanjem. Neke koncepte može biti teško razumjeti; možete ih preskočiti i i dalje dobiti opće razumijevanje.
Za vas bolje informirane, ovaj članak je podijeljen u 3 dijela:
- Pregled niskonivojskih i visokoinivojskih komponenti baze podataka
- Pregled procesa optimizacije upita
- Pregled upravljanja transakcijama i međuspremnikom
Vraćajući se osnovama
Prije mnogo godina (u dalekoj, dalekoj galaksiji…), programeri su morali točno znati broj operacija koje su kodirali. Znali su napamet svoje algoritme i strukture podataka, jer nisu mogli priuštiti trošenje CPU-a i memorije svojih sporih računala.
U ovom dijelu ću vam podsjetiti na neke od tih koncepata, budući da su neophodni za razumijevanje baze podataka. Također ću uvesti pojam indeksa baze podataka.
O(1) vs O(n2)
Danas mnogi programeri ne brinu o vremenskoj složenosti algoritama… i u pravu su!
Ali kada se suočavate s velikim količinama podataka (ne govorim o tisućama) ili se borite za milisekunde, postaje od kritične važnosti razumjeti ovaj koncept. I kao što razumijete, baze podataka moraju se nositi s obje situacije! Neću vas natjerati da potrošite više vremena nego što je potrebno da shvatite bit. Ovo će nam kasnije pomoći da razumijemo koncept optimizacije temeljen na trošku (cost based optimization).
Koncept
Vremenska složenost algoritma koristi se za procjenu koliko će vremena trebati za izvršavanje algoritma za određenu količinu podataka.. Da bi se opisala ova složenost, koriste se matematičke oznake velikog O. Ova notacija se koristi s funkcijom koja opisuje koliko operacija algoritmu treba za određenu količinu ulaznih podataka.
Na primjer, kada kažem "ovaj algoritam ima složenost O (some_function() )", to znači da za obradu određene količine podataka algoritmu treba some_function(a_certain_amount_of_data) operacija.
U tom kontekstu bitno je ne koliko podataka,već to, kako se povećava broj operacija s povećanjem količine podataka.Vremenska složenost ne daje točan broj operacija, ali je dobar način za procjenu vremena izvršavanja.
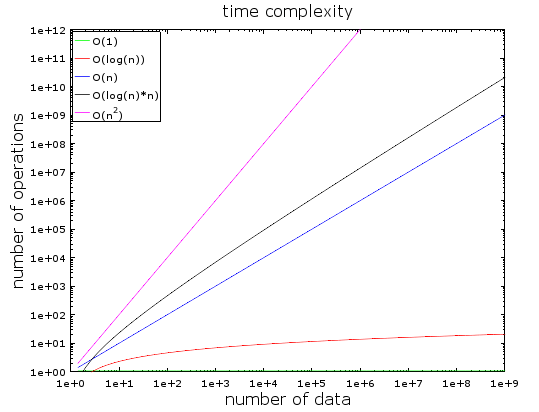
Na ovom grafikonu možete vidjeti ovisnost broja operacija o veličini ulaznih podataka za različite tipove vremenskih složenosti algoritama. Koristio sam logaritamsku skalu za njihovo prikazivanje. Drugim riječima, količina podataka brzo raste od 1 do 1 milijarde. Možemo primijetiti da:
- O(1) ili konstantna složenost ostaje konstanta (inače se ne bi zvala konstantnom složenošću).
- O(log(n)) ostaje niska čak i s milijardama podataka.
- Najgora složenost je O(n2), gdje broj operacija brzo raste.
- Druga dva složenja također brzo rastu.
Primjeri
Pri malom broju podataka razlika između O(1) i O(n2) je beznačajna. Na primjer, pretpostavimo da imate algoritam koji mora obraditi 2000 elemenata.
- Algoritam O(1) koštat će vas 1 operaciju
- Algoritam O(log(n)) koštat će vas 7 operacija
- Algoritam O(n) koštat će vas 2000 operacija
- Algoritam O(n * log(n)) koštat će vas 14 000 operacija
- Algoritam O(n2) koštat će vas 4 000 000 operacija
Razlika između O(1) i O(n2) čini se velikom (4 milijuna operacija), ali izgubit ćete najviše 2 ms, koliko vam je potrebno da trepnete. Doista, moderni procesori mogu obraditi . Zato performanse i optimizacija nisu problem u mnogim IT projektima.
Kao što sam već rekao, još uvijek je važno poznavati ovu koncept pri radu s ogromnim količinama podataka. Ako ovaj put algoritam mora obraditi 1 000 000 elemenata (što nije toliko puno za bazu podataka):
- Algoritam O(1) koštat će vas 1 operaciju
- Algoritam O(log(n)) koštat će vas 14 operacija
- Algoritam O(n) koštat će vas 1 000 000 operacija
- Algoritam O(n * log(n)) koštat će vas 14 000 000 operacija
- Algoritam O(n2) koštat će vas 1 000 000 000 000 operacija
Nisam napravio izračune, ali rekao bih da s algoritmom O(n2) imate vremena popiti kafu (čak i dvije!). Ako dodate još 0 na veličinu podataka, imat ćete vremena za dremku.
Idemo dublje
Za referencu:
- Pretraživanje u dobroj hash tablici pronalazi element u O(1).
- Pretraživanje u dobro uravnoteženom stablu daje rezultat u O(log(n)).
- Pretraživanje u nizu daje rezultat u O(n).
- Najbolji algoritmi sortiranja imaju složenost O(n * log(n)).
- Loš algoritam sortiranja ima složenost O(n2).
Napomena: u sljedećim dijelovima vidjet ćemo te algoritme i strukture podataka.
Postoji nekoliko tipova vremenske složenosti algoritma:
- srednji slučaj
- najbolji mogući ishod
- i najgori slučaj
Vremenska složenost često je najgori slučaj.
Govorio sam samo o vremenskoj složenosti algoritma, ali složenost se također primjenjuje na:
- potrošnju memorije algoritmom
- potrošnju diskovnog ulaza / izlaza algoritmom
Naravno, postoje složenosti koje su gore od n², na primjer:
- n⁴: to je strašno! Neki od spomenutih algoritama imaju takvu složenost.
- 3n: to je još gore! Jedan od algoritama koje ćemo vidjeti sredinom ovog članka ima tu složenost (i zaista se koristi u mnogim bazama podataka).
- faktorijel n: nikada nećete dobiti svoje rezultate čak ni s malim brojem podataka.
- nⁿ: ako se suočite s ovom složenošću, trebate se pitati, je li ovo zaista vaše područje djelovanja ...
Napomena: dao sam vam ne stvarnu definiciju oznake „veliko O“, već samo ideju. Možete pročitati ovaj članak u za stvarnu (asimptotsku) definiciju.
MergeSort (Sortiranje spajanjem)
Što radite kada trebate sortirati kolekciju? Što? Pozivate funkciju sort()… U redu, dobar odgovor… Ali za baze podataka morate razumjeti kako ta funkcija sort() radi.
Postoji nekoliko dobrih algoritama za sortiranje, pa ću se usredotočiti na najvažnije: sortiranje spajanjem. Možda sada ne razumijete zašto je sortiranje podataka korisno, ali trebate ga razumjeti nakon dijela posvećenog optimizaciji upita. Osim toga, razumijevanje sortiranja spajanjem pomoći će nam kasnije da razumijemo opću operaciju join bazama podataka, koja se naziva merge join (spajanje spajanjem).
Merge (spajanje)
Kao i mnogi korisni algoritmi, sortiranje spajanjem temelji se na trik: spajanje 2 sortirana niza veličine N/2 u N-elementni sortirani niz košta samo N operacija. Ova operacija se naziva spajanje.
Pogledajmo što to znači na jednostavnom primjeru:
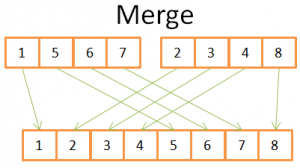
Na ovoj slici vidite da za izgradnju konačnog sortiranog niza od 8 elemenata trebate samo izvršiti iteraciju jednom kroz 2 niza od 4 elementa. Budući da su oba niza od 4 elementa već sortirana:
- 1) uspoređujete oba trenutna elementa u dva niza (na početku trenutni = prvi)
- 2) zatim uzmite najmanji element da ga smjestite u niz od 8 elemenata
- 3) i pređite na sljedeći element u nizu, gdje ste uzeli najniži element
- i ponavljajte 1, 2, 3, dok ne dođete do zadnjeg elementa jednog od nizova.
- Zatim uzimate preostale elemente iz drugog niza da ih smjestite u niz od 8 elemenata.
To funkcionira jer su oba 4-elementna niza sortirana, tako da se ne trebate "vraćati" unutar njih.
Sada kada smo shvatili ovu caku, evo mog pseudokoda za merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekurzivni pozivi
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //spajanje 2 mala sortirana niza u jedan veliki
   array result := merge(new_left_array,new_right_array);
   return result;
Sortiranje pomoću spajanja razbija zadatak na manje zadatke, a zatim nalazi rezultate manjih zadataka kako bi dobio rezultat izvorne zadaće (napomena: ovaj tip algoritama se naziva podijeli i vladaj). Ako ne razumijete ovaj algoritam, ne brinite; ni ja ga nisam shvatio prvi put kada sam ga vidio. Ako vam može pomoći, vidim ovaj algoritam kao dvostruki algoritam:
- Faza dijeljenja, gdje se niz dijeli na manje nizove
- Faza sortiranja, gdje se mali nizovi spajaju (koristeći spajanje) kako bi se formirao veći niz.
Faza dijeljenja
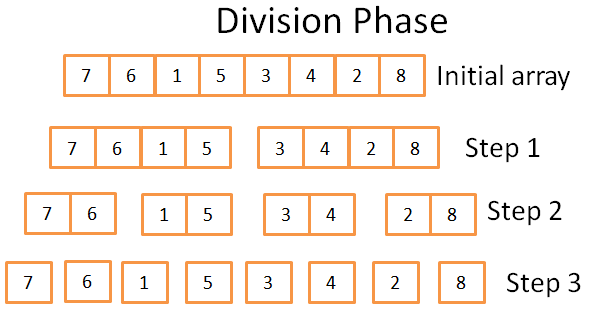
U fazi dijeljenja niz se dijeli na jedinične nizove u 3 koraka. Formalan broj koraka je log(N) (budući da je N=8, log(N) = 3).
Odakle to znam?
Ja sam genije! Jednom riječi — matematika. Ideja je da svaki korak dijeli veličinu izvorne niza na 2. Broj koraka je koliko puta možete podijeliti izvorni niz na dva. To je točna definicija logaritma (s osnovom 2).
Faza sortiranja
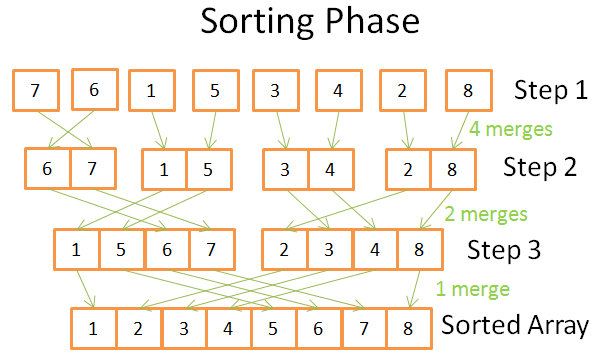
U fazi sortiranja počinjete s jediničnim (jednoelementnim) nizovima. Tijekom svake faze primjenjujete nekoliko operacija spajanja, a ukupni trošak iznosi N = 8 operacija:
- U prvom koraku imate 4 spajanja, koja koštaju 2 operacije svako
- U drugom koraku imate 2 spajanja, koja koštaju 4 operacije svako
- U trećem koraku imate 1 spajanje, koje košta 8 operacija
Budući da postoji log(N) koraka, ukupni trošak N * log(N) operacija.
Prednosti sortiranja pomoću spajanja
Zašto je ovaj algoritam toliko moćan?
Jer:
- Možete ga prilagoditi kako biste smanjili količinu memorije, tako da ne stvarate nove nizove, već direktno mijenjate ulazni niz.
Napomena: ovaj tip algoritama se naziva (sortiranje bez dodatne memorije).
- Možete ga promijeniti da istovremeno koristi diskovni prostor i malu količinu memorije bez značajnih troškova za diskovni ulaz/izlaz. Ideja je učitati u memoriju samo one dijelove koji se trenutno obrađuju. Ovo je važno kada trebate sortirati tablicu veličine nekoliko gigabajta samo s memorijskim bufferom od 100 megabajta.
Napomena: ovaj tip algoritama se naziva .
- Možete ga prilagoditi da radi na više procesa / niti / poslužitelja.
Na primjer, distribuirano sortiranje spajanjem jedan je od ključnih komponenti (koji je struktura u velikim podacima).
- Ovaj algoritam može pretvoriti olovo u zlato (ne šalim se!).
Ovaj algoritam sortiranja se koristi u većini (ako ne i u svim) bazama podataka, ali nije jedini. Ako želite saznati više, možete pročitati ovaj , koji raspravlja o prednostima i nedostacima uobičajenih algoritama sortiranja u bazama podataka.
Niz, Drvo i Heš-tablica
Sada kada razumijemo ideju vremenske složenosti i sortiranja, moram vam reći o 3 strukture podataka. Ovo je važno jer one čine osnovu modernih baza podataka. Također ću uvesti pojam indeksa baze podataka.
Niz
Dvodimenzionalni niz je najjednostavnija struktura podataka. Tablicu možemo smatrati nizom. Na primjer:
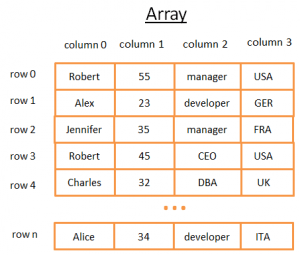
Ovaj 2D niz predstavlja tablicu sa redovima i stupcima:
- Svaki red predstavlja entitet
- Stupci pohranjuju svojstva koja opisuju entitet.
- Svaki stupac pohranjuje podatke određenog tipa (cijeli broj, string, datum …).
Tako je zgodno pohranjivati i vizualizirati podatke, međutim, kada trebate pronaći određenu vrijednost, to nije prikladno.
Na primjer, ako želite pronaći sve dečke koji rade u Velikoj Britaniji, morat ćete pregledati svaki red da biste odredili pripada li taj red Velikoj Britaniji. To će vas koštati N operacija, gdje N — broj redaka, što nije loše, ali postoji li brži način? Sada je vrijeme da se upoznamo s stablima.
Napomena: većina modernih baza podataka pruža proširene nizove za učinkovito pohranjivanje tablica: heap-organized tables i index-organized tables. No, to ne rješava problem brzog pretraživanja određenog uvjeta u grupi stupaca.
Stablo i indeks baze podataka
Binarno stablo pretraživanja je binarno stablo sa posebnim svojstvom, ključ u svakom čvoru mora biti:
- veći od svih ključeva pohranjenih u lijevom podstabla
- manji od svih ključeva pohranjenih u desnom podstabla
Pogledajmo što to vizualno znači
Ideja
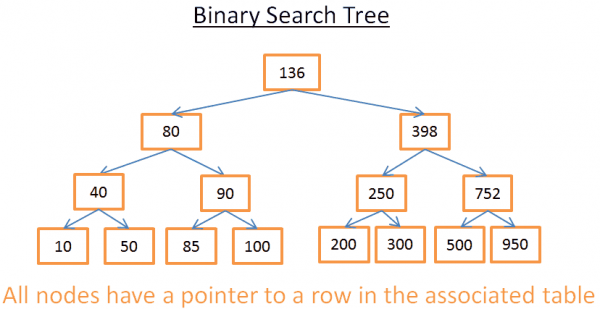
Ovo stablo ima N = 15 elemenata. Recimo da tražim 208:
- Počinjemo s korijenom, čiji je ključ 136. Budući da je 136 < 208, gledam u desno podstablo čvora 136.
- 398 > 208, stoga gledam u lijevo podstablo čvora 398
- 250 > 208, stoga gledam u lijevo podstablo čvora 250
- 200 < 208, stoga gledam u desno podstablo čvora 200. No 200 nema desno podstablo, vrijednost ne postoji (jer ako postoji, biti će u desnom podstablju 200).
Sada, recimo, da tražim 40
- Počinjemo s korijenom, čiji je ključ 136. Budući da je 136 > 40, gledam u lijevo podstablo čvora 136.
- 80 > 40, stoga gledam u lijevo podstablo čvora 80
- 40= 40, čvor postoji. Izvlačim identifikator retka unutar čvora (to nije prikazano na slici) i gledam u tablici za dani identifikator retka.
- Poznavanje identifikatora retka omogućava mi da saznam gdje se podaci u tablici točno nalaze, i tako ih mogu dobiti odmah.
Na kraju, oba pretraživanja će me koštati broj razina unutar stabla. Ako pažljivo pročitate dio o spajanju, trebali biste vidjeti da ovdje postoji log (N) razina. Tako dobivamo, cijena pretraživanja log(N), nije loše!
Vraćamo se našem problemu
Ali to je vrlo apstraktno, tako da se vratimo našem problemu. Umjesto jednostavnog cijelog broja, zamislite niz koji predstavlja zemlju nekoga u prethodnoj tablici. Pretpostavljamo da imate stablo koje sadrži polje "country" (stupac 3) tablice:
- Ako želite znati tko radi u Velikoj Britaniji
- gledate u stablo kako biste dobili čvor koji predstavlja Veliku Britaniju
- unutar "UK node" pronaći ćete mjesto zapisa zaposlenika u Velikoj Britaniji.
Ova pretraga će koštati log(N) operacija umjesto N operacija ako izravno koristite niz. Ono što ste upravo predstavili - to je bilo indeks baze podataka.
Možete izgraditi indeksno stablo za bilo koju grupu polja (niz, broj, 2 niza, broj i niz, datum ...) sve dok imate funkciju za usporedbu ključeva (tj. grupa polja) tako da možete uspostaviti redoslijed među ključevima (što vrijedi za sve osnovne tipove u bazi podataka).
B+StabloIndeksi
Iako ovo stablo dobro funkcionira za pronalaženje određenih vrijednosti, postoji VEĆI problem kada morate dobiti nekoliko elemenata između dviju vrijednosti. To će koštati O(N) jer ćete morati pregledati svaki čvor u stablu i provjeriti nalazi li se između tih dviju vrijednosti (na primjer, s uređenim obilaskom stabla). Štoviše, ova operacija nije prikladna za ulazno-izlazne operacije na disku, jer ćete morati čitati cijelo stablo. Moramo pronaći način da učinkovito izvršimo raspon upita. Da bismo riješili ovaj problem, suvremene baze podataka koriste modificiranu verziju prethodnog stabla pod nazivom B+Stablo. U B+Stablo:
- samo najniži čvorovi (lišće) pohranjuju informacije (lokacije redaka u povezanoj tablici)
- ostali čvorovi nalaze se ovdje za usmjeravanje do pravog čvora za vrijeme pretraživanja.
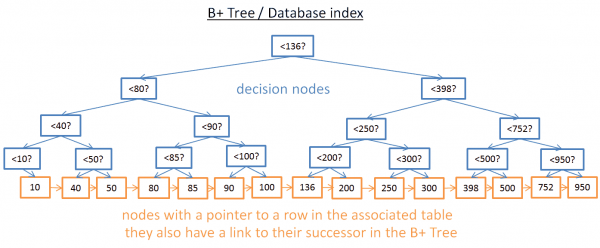
Kao što možete vidjeti, ovdje ima više čvorova (dvostruko više). Doista, imate dodatne čvorove, 'čvorove donošenja odluka', koji će vam pomoći pronaći pravi čvor (koji pohranjuje lokacije redaka u povezanoj tablici). Ali složenost pretraživanja je i dalje O(log(N)) (ima samo još jednu razinu). Velika razlika je u tome što čvorovi na donjoj razini povezani su sa svojim nasljednicima.
S ovim B+Stablom, ako tražite vrijednosti od 40 do 100:
- Samo trebate tražiti 40 (ili najbližu vrijednost nakon 40, ako 40 ne postoji), kao što ste to radili s prethodnim stablom.
- Zatim prikupite nasljednike 40, koristeći izravne poveznice na nasljednike, sve dok ne dođete do 100.
Pretpostavimo da ste pronašli M nasljednika, a stablo ima N čvorova. Traženje određenog čvora košta log(N) slično prethodnom stablu. No, dobivanjem tog čvora, dobit ćete M nasljednika u M operacija s poveznicama na njihove nasljednike. Ova pretraga košta samo M+log(N) operacija u usporedbi s N operacijama s prethodnim stablom. Osim toga, nije potrebno čitati cijelo stablo (samo M + log (N) čvorova), što znači manju upotrebu diska. Ako je M malo (npr. 200 redaka) a N veliko (1 000 000 redaka), to će biti VELIKA razlika.
No, ovdje se javljaju novi problemi (opet!). Ako dodajete ili brišete red u bazi podataka (i, samim time, u povezanim indeksima B+Tree):
- morate održavati redoslijed između čvorova unutar B+Tree, inače nećete moći pronaći čvorove unutar nesortiranog stabla.
- morate održati minimalan mogući broj razina u B+Tree, inače će vremenska složenost u O (log (N)) postati O (N).
Drugim riječima, B+Tree treba biti samostalno uredno i uravnoteženo. Srećom, to je moguće uz pametne operacije brisanja i umetanja. No, to je skupo: umetanje i brisanje u B+ stablu iznosi O (log (N)). Zato su neki od vas čuli da korištenje previše indeksa nije baš dobra ideja. Uistinu, usporaćujete brzo umetanje/ ažuriranje/ brisanje reda u tablici, budući da baza podataka mora ažurirati indekse tablice uz skupu operaciju O (log (N)) za svaki indeks. Štoviše, dodavanje indeksa znači veće opterećenje za menadžera transakcija koji će biti opisan na kraju članka.
Za više detalja, možete pogledati članak na Wikipediji o . Ako želite primjer implementacije B+Tree u bazi podataka, pogledajte i od vodećeg programera MySQL-a. Oboje se fokusiraju na to kako InnoDB (MySQL motor) obrađuje indekse.
Napomena: čitatelj mi je rekao da zbog niskorazinskih optimizacija B+ stablo treba biti potpuno uravnoteženo.
Hashtable (Hash-tablica)
Naša posljednja važna struktura podataka je hash-tablica. Ovo je vrlo korisno kada želite brzo pretraživati vrijednosti. Osim toga, razumijevanje hash-tablice će nam pomoći kasnije razumjeti opću operaciju spajanja u bazi podataka, koju nazivamo hash spajanjem ( hash join). Ova struktura podataka koristi se u bazi podataka za pohranu nekih internih stvari (npr., tablica zaključavanja ili buferni pool, vidjet ćemo obje te pojmove kasnije).
Hash tabela je struktura podataka koja brzo pronalazi element prema njegovom ključu. Da biste izgradili hash tabelu, morate definirati:
- ključ za vaše elemente
- hash funkciju za ključeve. Izračunati hash-evi ključeva daju položaj elemenata (nazvanih segmetima ).
- funkciju za usporedbu ključeva. Kada pronađete pravi segment, morate pronaći element koji tražite unutar segmenta koristeći ovu usporedbu.
Jednostavan primjer
Uzmimo jednostavan primjer:
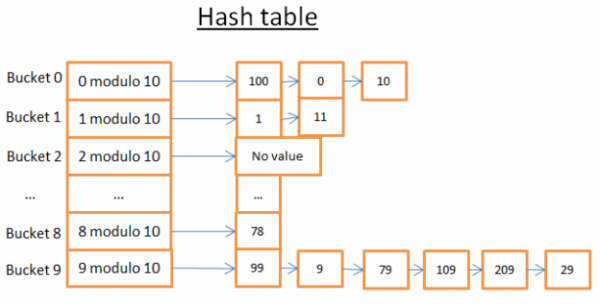
Ova hash tabela ima 10 segmenata. Budući da sam lenj, prikazao sam samo 5 segmenata, ali znam da ste pametni, pa ću vam dopustiti da zamislite 5 drugih sami. Koristio sam hash funkciju modulo 10 ključa. Drugim riječima, čuvam samo posljednju cifru ključa elementa kako bih pronašao njegov segment:
- ako je posljednja cifra 0, element ide u segment 0,
- ako je posljednja cifra 1, element ide u segment 1,
- ako je posljednja cifra 2, element ide u segment 2,
- …
Funkcija usporedbe koju sam koristio jednostavno je jednakost između dva cijela broja.
Recimo da želite dobiti element 78:
- Hash tabela izračunava hash kod za 78, koji je 8.
- Hash tabela gleda u segment 8, a prvi element koji pronađe je 78.
- Vraća vam element 78
- Pretraživanje je koštalo samo 2 operacije (jedna za izračunavanje vrijednosti hash funkcije, a druga za pronalaženje elementa unutar segmenta).
Sada, recimo da želite dobiti element 59:
- Hash tabela izračunava hash kod za 59, koji je 9.
- Hash tabela traži u segmentu 9, prvi pronađeni element je 99. Budući da 99!=59, element 99 nije pravi element.
- Koristeći istu logiku, uzimaju se drugi element (9), treći (79), …, posljednji (29).
- Element nije pronađen.
- Pretraživanje je koštalo 7 operacija.
Dobra hash funkcija
Kao što vidite, ovisno o vrijednosti koju tražite, cijena nije ista!
Ako sada promijenim hash funkciju modulo 1 000 000 ključa (tj. uzimajući posljednjih 6 cifara), drugo pretraživanje će koštati samo 1 operaciju, jer u segmentu 000059 nema elemenata. Stvarni izazov je pronaći dobru hash funkciju koja će stvarati segmente koji sadrže vrlo mali broj elemenata..
U mom primjeru lako je pronaći dobru hash funkciju. No, to je jednostavan primjer, pronaći dobru hash funkciju je teže kada je ključ:
- niz (na primjer — prezime)
- 2 niza (na primjer — prezime i ime)
- 2 niza i datum (na primjer — prezime, ime i datum rođenja)
- …
S dobrom hash funkcijom, pretraživanje u hash tablici se obavlja za O(1).
Polje vs hash tablica
Zašto ne koristiti polje?
Hmm, dobro pitanje.
- Hash tablica može biti djelomično učitana u memoriju, a ostale segmente mogu ostati na disku.
- S poljem morate koristiti neprekidan prostor u memoriji. Ako učitavate veliku tablicu vrlo je teško pronaći dovoljno neprekidnog prostora.
- Za hash tablicu možete odabrati željeni ključ (na primjer, državu i prezime osobe).
Za dodatne informacije, možete pročitati članak o , koja je učinkovita implementacija hash tablice; ne morate razumjeti Javu da biste shvatili koncepta izloženog u ovom članku.
Izvor: habr.com
