

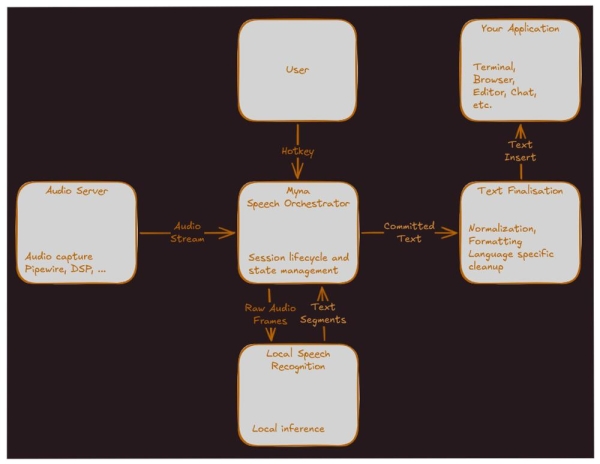
Canonical je predstavio projekt Myna — novi sustav pretvaranja govora u tekst za Ubuntu Desktop. Projekt je usmjeren na ugrađeno diktiranje: korisnik pritisne tipku prečaca, govori, a prepoznati tekst se pojavljuje u aktivnoj aplikaciji. U najavi se naglašava da Myna treba djelovati kao prirodni dio radne površine Ubuntu i istovremeno raditi uzimajući u obzir privatnost korisnika. Popis podržanih jezika unosa u trenutku objave vijesti nije objavljen.
Prvi cilj projekta — Ubuntu 26.10. U ovoj fazi Canonical ne pokušava stvoriti punopravnog glasovnog asistenta ili sustav upravljanja radnom površinom glasom. Programeri su namjerno ograničili područje prve verzije na osnovno, pouzdano diktiranje: pritisnite kombinaciju tipki, izgovorite tekst i dobijte rezultat u trenutnom svom polju unosa. Primarno testno okruženje — Ubuntu Desktop na Waylandu s GNOME-om, ali arhitektura se planira ostaviti dovoljno otvorenom za buduću podršku drugim okruženjima.
Myna je dizajnirana za lokalno prepoznavanje govora. Nakon instalacije potrebnih modela, internetska veza nije potrebna za rad diktiranja, mikrofon se mora koristiti samo nakon izričitog aktiviranja od strane korisnika, audio se obrađuje u memoriji i zatim se odbacuje, a zapisi se ne šalju vanjskim uslugama. U projektnoj specifikaciji također je navedeno da rješenje treba izbjegavati pohranu audio zapisa prema zadanim postavkama i ne smije se neprimjetno prebacivati na oblačku uslugu.
Kod i dokumentacija Myna objavljeni su u repozitoriju Canonical na GitHub. Projekt je opisan kao lako aplikacija za pretvaranje govora u tekst za Ubuntu Desktop i distribuira se pod GPL-3.0 licencom. Ipak, projekt je u ranoj fazi: u repozitoriju trenutno nema objavljenih izdanja, a arhitektonska specifikacija ima status Predloženo.
Glavne funkcije i značajke Myna
Push-to-talk diktiranje. Korisnik drži prilagodljivu tipku prečaca, govori, a sustav umetne prepoznati tekst u odabranom polju unosa. Diktiranje završava nakon puštanja tipke.
Lokalno prepoznavanje govora. Prepoznavanje se obavlja na korisničkoj mašini putem lokalnog inference stack-a. To smanjuje ovisnost o oblaku i omogućuje rad bez mreže nakon instalacije modela.
Privatna obrada audio zapisa. Mikrofon se aktivira samo tijekom korisničke sesije diktiranja. Zvuk se po defaultu ne snima na disk, koristi se ograničeni memorijski profil koji se čisti nakon završetka sesije.
Vizualni indikator aktivnosti. Tijekom snimanja i transkripcije, korisnik mora vidjeti jasan indikator stanja. U specifikaciji se spominju stanja poput Snimanja, Transkribiranja, Finaliziranja i Greške.
Umetanje isključivo stabilnog teksta. U prvoj implementaciji, međufinalni hipoteze prepoznavanja ne smiju se direktno umetati u aplikaciju. U ciljano polje se šalje samo potvrđeni finalni tekst.
Postobrada teksta. Siroka transkripcija može proći normalizaciju, dodavanje interpunkcije, kapitalizaciju, formatiranje i transformaciju usmenih oblika u pisane, na primjer, “twenty two” → “22”.
Odabir jezika diktiranja. Sustav mora podržavati prilagodljiv jezik diktiranja, po defaultu orijentiran na jezik korisničkog sučelja, ako je dostupnot odgovarajući model.
Profili kvalitete modela. U specifikaciji su predviđeni različiti profili modela: lagana varijanta s manjom potrošnjom resursa, uravnoteženi profil po defaultu i kvalitetnija, ali teža varijanta.
Siguran rad s fokusom unos. Cilj za umetanje teksta odabire se na početku sesije. Ako se fokus prozora mijenja tijekom diktiranja, sustav ne smije tiho slati tekst u drugu aplikaciju.
Blokiranje u zaštićenim poljima. Diktiranje treba biti blokirano u password-poljima, prozorima autentifikacije i drugim zaštićenim mjestima, ako aplikacija ili toolkit to mogu odrediti.
Integracija s Wayland/GNOME. Prva verzija usmjerena je na Wayland i GNOME. Za inicijalno umetanje teksta razmatra se IBus, a u budućnosti se planira više nativni Wayland pristup putem input-method/text-input protokola.
Postavke korisnika. U planiranom sučelju postavki trebaju biti uključivanje/isključivanje STT, odabir prečaca, jezika diktiranja, mikrofona, profila modela, postavki postobrade i indikatora aktivnosti.
U prvoj iteraciji izvan projekta ostaju buđenje prema ključnoj frazi, stalno pozadinsko slušanje, oblačno prepoznavanje, glasovni asistent, glasovne naredbe, upravljanje radnom površinom, prevođenje govora, identifikacija govornika, automatsko prepoznavanje jezika i povijest diktata. Drugim riječima, Canonical ne počinje s "AI-asistentom", već s prizemljenijom функцијом: lokalnim glasovnim unosom teksta u obične aplikacije Ubuntu.
Izvor: linux.org.ru
