

Objavljen je 0.9.0 biblioteka za C++ (standard C++20) libunicode. Projekt razvija tim programera emulatora terminala Contour i ljuske Endo (u aktivnom razvoju) i distribuira se pod Apache 2.0 licencom.
- podrška standardima Unicode 17.0:
- API za dobivanje svojstava Unicode-a;
- SIMD optimizacija nekih funkcija (uz korištenje std::simd ili std::experimental::simd kada su dostupni);
- optimizirano konvertiranje UTF-8 UTF-16/UTF-32;
- ekvivalent funkciji wcwidth (int unicode::width(char32_t));
- segmentiranje teksta prema grafemima, simbolima, emojijima i pismima;
- pretvaranje registra i usporedba nizova;
- visoko nivo API za segmentiranje teksta, prikladan za implementaciju oblika teksta.
- pokritost testovima većine mogućnosti biblioteke (širina simbola i segmentiranje).
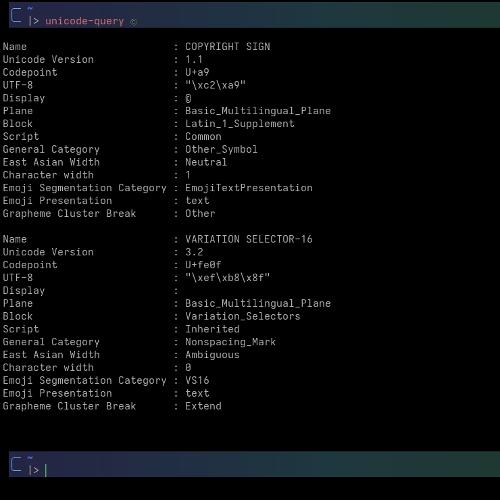
U isporuci se također nalazi konzolna alatka unicode-query za dobivanje detaljnih informacija o nizovima.
Promjene:
- dodana API funkcija grapheme_cluster_width;
- unapređenja u radu s verzijama Unicode-a („Age“);
- puna podrška UAX #15 Unicode Normalization Forms s podrškom za obradu u tokovima:
normalizer norm(Normalization_Form::NFC); // Unesi decomponirani e + kombinirajući akcent, zatim novi starter za pokretanje emisije auto result = norm.feed(U’e’); CHECK(result.empty()); // još se ne emituje result = norm.feed(U’u0301′); CHECK(result.empty()); // još se ne emituje (kombinacijski znak) result = norm.feed(U’x’); // starter pokreće emisiju prethodnog segmenta REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + akcenta se sastavlja u e-akcent result = norm.flush(); CHECK(result == U"x"); // završni segment
- funkcija script_extensions sada vraća std::optional<std::span>;
- implementirano pravilo GB9c za razdvajanje grupa grafema za kombinacije simbola u jezicima grupe Indic;
- u grapheme_segmenter ispravljena pravila za GB11 i GB4/GB5; uklonjen zastarjeli API;
- implementirano SIMD optimizirano konvertiranje UTF-8 u UTF-16/UTF-32;
- širina spajajućih simbola Hangul V/T sada je jednaka nuli;
- implementirano segmentiranje po granicama riječi;
- ispravke u C API;
- refaktoriranje sistema izgradnje i pomoćnog generatora tablica C++;
- dodani kompleksni testovi za konvertiranje UTF-16/UTF-32;
- u CI dodana statička izgradnja alatke unicode-query.
Izvor: linux.org.ru
