

U okviru istraživačkog projekta započeo je rad na dodavanju podrške za razdvajanje procesa kompilacije u više paralelno izvršavanih niti u GCC-u. Trenutno se za povećanje brzine izgradnje na višekrdnim sustavima koristi pokretanje zasebnih procesa prevoditelja, od kojih svaki izgrađuje zasebnu datoteku s kodom na razini alata make. Novi projekt eksperimentira s osiguravanjem paralelizacije na razini prevoditelja, što potencijalno može povećati učinkovitost rada na višekrdnim sustavima.
Za testiranje odvojena paralelna grana GCC-a, za koju je predložen novi parametar „—param=num-threads=N” za postavljanje broja niti. U početnoj fazi implementirano je izvođenje međuprocjenskih optimizacija u odvojene niti, koje se ciklički pozivaju za svaku funkciju i dobro se paraleliziraju. U odvojene niti prebačene su GIMPLE operacije koje su odgovorne za optimizacije neovisne o hardveru i koje ocjenjuju međusobnu interakciju funkcija.
U sljedećoj fazi također je planirano prebacivanje međuprocjenskih RTL optimizacija u odvojene niti, uzimajući u obzir karakteristike hardverske platforme. Nakon toga planirano je realizirati paralelizaciju unutarproceduralnih optimizacija (IPA), koje se primjenjuju na kod unutar funkcije, neovisno o specifičnostima poziva. Ograničavajući faktor za sada je sakupljač smeća, kojem je dodana globalna blokada, onemogućujući operacije sakupljanja smeća tijekom rada u višedretvenom načinu (u budućnosti će sakupljač smeća biti prilagođen za višedretveno izvršavanje GCC-a).
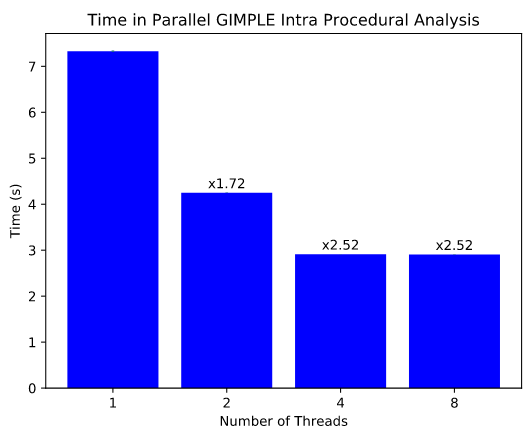
Za procjenu promjene performansi pripremljen je testni set koji provodi izgradnju datoteke gimple-match.c, koja uključuje više od 100 tisuća redaka koda i 1700 funkcija. Testovi na sustavu s CPU-om Intel Core i5-8250U sa 4 fizička jezgra i 8 virtualnih (Hyperthreading) pokazali su smanjenje vremena izvođenja optimizacija Intra Procedural GIMPLE sa 7 na 4 sekunde pri pokretanju 2 niti i do 3 sekunde pri pokretanju 4 niti, tj. postignuto je povećanje brzine razmatrane faze izgradnje za 1.72 i 2.52 puta, respektivno. Testovi su također pokazali da korištenje virtualnih jezgri pri Hyperthreadingu ne dovodi do rasta performansi.
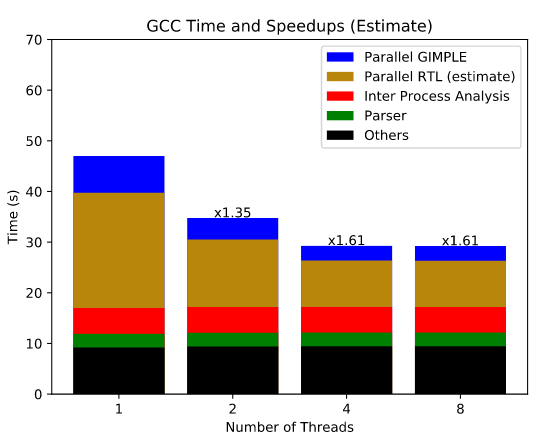
Ukupno vrijeme sastavljanja smanjeno je otprilike 10%, no prema prognozama, paralelizacija RTL optimizacija omogućit će postizanje značajnijih rezultata, jer ova faza prilikom kompajliranja zauzima znatno više vremena. Očekuje se da će nakon paralelizacije RTL ukupno vrijeme sastavljanja biti smanjeno 1,61 puta. Nakon toga, dodatnih 5-10% vremena mogu se smanjiti zahvaljujući paralelizaciji IPA optimizacija.
Izvor: opennet.ru
