

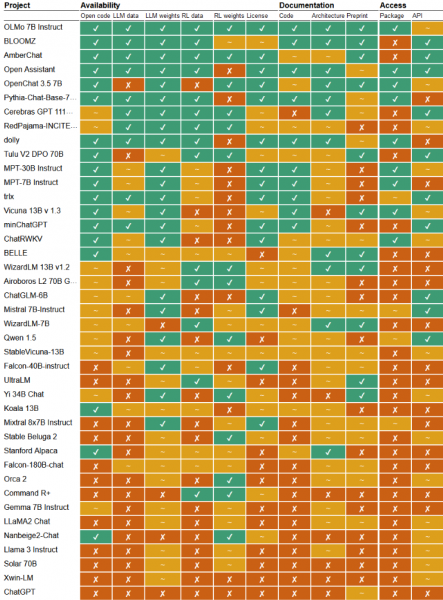
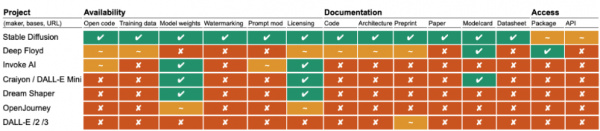
Istraživači s Univerziteta Nimwegen (Nizozemska) pripremili su rang otvorenosti 40 velikih jezičnih modela i 7 modela za generiranje slika prema tekstualnom opisu, koji su od strane proizvođača deklarirani kao otvoreni. Zbog toga što se kriteriji otvorenosti modela strojnog učenja još uvijek formiraju, trenutno je došlo do situacije gdje se pod krinkom otvorenih šire modeli s licencama koje ograničavaju područje korištenja (na primjer, mnogi modeli zabranjuju korištenje u komercijalnim projektima). Također, često proizvođači ne pružaju pristup podacima korištenim za obuku, ne otkrivaju detalje implementacije ili ne otvaraju u potpunosti prateći kod.
Većinu modela, koji se predstavljaju kao 'otvoreni', zapravo je bolje shvatiti kao 'otvorene težinske koeficijente' ili preciznije 'dostupne težinske koeficijente', budući da se distribuiraju pod ograničavajućim licencama koje zabranjuju korištenje u komercijalnim proizvodima. Vanjski istraživači mogu eksperimentirati s ovakvim modelima, ali nemaju mogućnosti prilagoditi model svojim potrebama ili pregledati implementaciju. Više od polovice modela ne pruža detaljne informacije o podacima koji se koriste za obuku, kao ni ne objavljuje informacije o unutrašnjoj strukturi i arhitekturi.
Najotvorenijim su priznati modeli BloomZ, AmberChat, OLMo, Open Assistant i Stable Diffusion, koji su objavljeni pod otvorenim licencama zajedno s izvornim podacima, kodom i implementacijom API-ja. Modeli od Google-a (Gemma 7B), Microsoft-a (Orca 2) i Meta (Llama 3), koji su od strane proizvođača predstavljeni kao otvoreni, našli su se bliže kraju rang liste, jer ne pružaju pristup izvornih podacima, ne otkrivaju tehničke detalje implementacije, a težinski koeficijenti modela distribuiraju pod licencama koje ograničavaju područje korištenja. Popularni model Mistral 7B našao se približno na sredini rang liste, budući da se isporučuje pod otvorenom licencom, ali samo djelomično dokumentiran, ne otkriva podatke korištene za obuku i ima nedovoljno otvoren prateći kod.
Istraživači su predložili 14 kriterija otvorenosti AI modela, koji obuhvaćaju uvjete distribucije koda, podataka za obuku, težinskih koeficijenata, varijanti podataka i koeficijenata optimiziranih uz pomoć učenja s povratnom spregom (RL), kao i dostupnost paketa, API-ja, dokumentacije i detaljnog opisa implementacije.
Prema prijedlogu organizacije OSI (Open Source Initiative) o definiciji otvorenog AI, osnovni kriteriji otvorenosti AI sustava su pružanje mogućnosti korištenja u bilo koje svrhe bez potrebe za dobivanjem posebnog odobrenja; proučavanje rada sustava i inspekcija njegovih komponenti; omogućavanje izmjena u bilo koje svrhe; prijenos drugima, bilo u izvornom obliku ili u revidiranoj verziji nakon izmjena.
Kako bi se omogućile izmjene, AI sustav mora uključivati:
- Detaljne informacije o podacima korištenim za obuku i metodologiji obuke. Informacija mora biti dovoljno za to da profesionalni programer može samostalno rekonstruirati ekvivalentni AI sustav koristeći iste ili slične podatke za obuku.
- Dostupnost izvornog koda, koji omogućava pokretanje AI sustava kao i proces njegove obuke (u razmatranoj tablici, u stupcu "kod" za mnoge modele naznačeno je "~", što podrazumijeva djelomičnu dostupnost koda, kada je kod za pokretanje modela dostupan, ali kod za obuku ili stvaranje modela nije). Kod također mora obuhvatiti područja kao što su pretprocesiranje, provjera podataka i tokenizacija. Osim toga, mora biti osigurano detaljno objašnjenje arhitekture modela.
- Parametri modela (težinski koeficijenti), što implicira postojanje gotovog stanja nakon obuke ili postojanje konačne optimizirane verzije modela.
Izvor: opennet.ru
