

U članku se razmatra nekoliko načina za određivanje matematičke jednadžbe linije jednostavne (parne) regresije.
Svi načini rješavanja jednadžbe ovdje opisani temelje se na metodi najmanjih kvadrata. Oznake za načine bit će:
- Analitičko rješenje
- Gradijentni spust
- Stohastički gradijentni spust
Za svaki od načina rješavanja jednadžbe ravne linije, u članku su navedene različite funkcije, koje se uglavnom dijele na one koje su napisane bez upotrebe biblioteke NumPy i one koje koriste NumPy. Smatra se da će vješto korištenje NumPy omogućiti smanjenje troškova izračuna.
Sav kod naveden u članku napisan je na jeziku python 2.7 s korištenjem Jupyter Notebook. Izvorni kod i datoteka s uzorkom objavljeni su na
Članak je usmjeren kako prema početnicima, tako i prema onima koji su već malo počeli usvajati prilično opsežnu oblast umjetne inteligencije — strojnog učenja.
Za ilustraciju materijala koristimo vrlo jednostavan primjer.
Uvjeti primjera
Imamo pet vrijednosti koje karakteriziraju ovisnost Y od X (Tablica br. 1):
Tablica br. 1 "Uvjeti primjera"
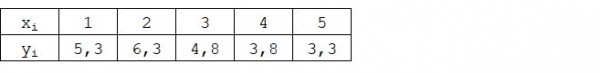
Pretpostavljamo da su vrijednosti  — to mjesec u godini, a
 — prihodi u tom mjesecu. Drugim riječima, prihodi ovise o mjesecu u godini, a
 — jedina karakteristika od koje ovise prihodi.
Primjer je osrednji, kako u pogledu uvjetne ovisnosti prihoda o mjesecu u godini, tako i u pogledu broja vrijednosti — vrlo ih je malo. Međutim, takvo pojednostavljenje će, što se kaže "na prste", objasniti, ne uvijek lako, materijal koji usvajaju početnici. Također, jednostavnost brojeva omogućit će onima koji žele da lako riješe primjer "na papiru".
Pretpostavimo da se navedena u primjeru ovisnost može dovoljno dobro aproksimirati matematičkom jednadžbom linije jednostavne (parne) regresije oblika:

gdje  — to je mjesec u kojem su ostvareni prihodi,
 — prihodi koji odgovaraju mjesecu,
 i
 — koeficijenti regresije procijenjene linije.
Napominjemo da se koeficijent  često naziva kutni koeficijent ili gradijent procijenjene linije; predstavlja iznos za koji će se promijeniti
 prilikom promjene
 .
Očito je da je naš cilj u primjeru pronaći takve koeficijente u jednadžbi  i
 , pri čemu će odstupanja naših izračunatih vrijednosti prihoda po mjesecima od stvarnih odgovora, tj. vrijednosti prikazanih u uzorku, biti minimalna.
Metoda najmanjih kvadrata
Prema metodi najmanjih kvadrata, odstupanje treba izračunati podizanjem na kvadrat. Ovaj pristup omogućuje izbjegavanje međusobnog poništavanja odstupanja, ukoliko imaju suprotne znakove. Na primjer, ako je u jednom slučaju odstupanje +5 (plus pet), a u drugom -5 (minus pet), tada će zbroj odstupanja međusobno biti poništen i iznositi 0 (nula). Možemo i ne podizati odstupanje na kvadrat, nego iskoristiti svojstvo modula, tako da će sve naše odstupanja biti pozitivna i akumulirati se. Nećemo se detaljno zadržavati na ovom trenutku, već ćemo samo označiti da se zbog praktičnosti izračuna, odstupanje obično podiže na kvadrat.
Ovako izgleda formula pomoću koje ćemo odrediti najmanji zbroj kvadrata odstupanja (greške):

gdje  — to je funkcija aproksimacije stvarnih odgovora (tj. izračunati prihod),
 — to su stvarni odgovori (prikazani u uzorku prihod),
 — to je indeks uzorka (broj mjeseca u kojem se određuje odstupanje)
Provedimo diferenciranje funkcije, odredimo jednadžbe parcijalnih derivacija i budimo spremni preći na analitičko rješenje. No, prvo ćemo provesti kratki izlet o tome što je diferenciranje i prisjetiti se geometrijskog značenja derivacije.
Diferenciranje
Diferenciranje je operacija pronalaženja derivacije funkcije.
Zašto je derivacija potrebna? Derivacija funkcije karakterizira brzinu promjene funkcije i ukazuje nam na njen smjer. Ako je derivacija u zadanom trenutku pozitivna, funkcija raste, u suprotnom slučaju — funkcija opada. A što je veća vrijednost derivacije po apsolutnoj vrijednosti, brža je brzina promjene vrijednosti funkcije, kao i strmiji kut nagiba grafikona funkcije.
Na primjer, u uvjetima dekartovskog koordinatnog sustava, vrijednost derivacije u točki M(0,0) jednaka je +25 što znači da u zadanoj točki, pri pomaku vrijednosti  desno za jednu uvjetnu jedinicu, vrijednost
 povećava se za 25 uvjetnih jedinica. Na grafu to izgleda kao prilično strm kut uzlaza vrijednosti
 s zadanom točkom.
Drugi primjer. Vrijednost derivacije jednaka -0,1 znači da, s pomakom  za jednu uvjetnu jedinicu, vrijednost
 opada samo za 0,1 uvjetne jedinice. Pritom, na grafu funkcije možemo primijetiti jedva primjetan nagib prema dolje. Pritom možemo povući analogiju s planinom, gdje se polako spuštamo po blagog nagiba planine, za razliku od prethodnog primjera gdje smo morali penjati se na vrlo strme vrhove :)
Tako, provodeći diferenciranje funkcije  prema koeficijentima
 i
 , odredit ćemo jednadžbe parcijalnih derivacija 1. reda. Nakon određivanja jednadžbi, dobit ćemo sustav od dvije jednadžbe, a rješavanjem ćemo moći odabrati takve vrijednosti koeficijenata
 i
 , pri čemu se vrijednosti odgovarajućih derivacija u zadanih točkama mijenjaju za vrlo malu količinu, a u slučaju analitičkog rješenja ne mijenjaju se uopće. Drugim riječima, funkcija pogreške pri pronađenim koeficijentima će dostići minimum, jer će vrijednosti parcijalnih derivacija u tim točkama biti jednake nuli.
Dakle, prema pravilima diferenciranja, jednadžba parcijalne derivacije 1. reda prema koeficijentu  će imati oblik:

jednadžba parcijalne derivacije 1. reda prema  će imati oblik:

Kao rezultat dobili smo sustav jednadžbi, koji ima prilično jednostavno analitičko rješenje:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Prije nego što riješimo jednadžbu, unaprijed ćemo učitati, provjeriti ispravnost učitavanja i formatirati podatke.
Učitavanje i formatiranje podataka
Treba napomenuti da, s obzirom na to da za analitičko rješenje, a kasnije i za gradijentni i stohastički gradijentni spust, primjenjujemo kod u dvije varijante: s korištenjem biblioteke NumPy i bez nje, te nam je potrebno odgovarajuće formatiranje podataka (vidi kod).
Kod za učitavanje i obradu podataka
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Vizualizacija
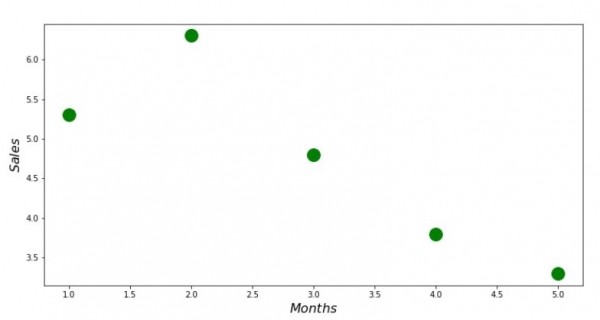
Sada, nakon što smo, prvo, učitali podatke, drugo, provjerili ispravnost učitavanja i konačno formatirali podatke, provest ćemo prvu vizualizaciju. Često se za to koristi metoda pairplot biblioteka Seaborn. U našem primjeru, zbog ograničenosti brojeva nemamo smisla primijeniti biblioteku Seaborn. Iskoristit ćemo običnu biblioteku Matplotlib i pogledati samo na dijagram raspršenja.
Kod dijagrama raspršenja
print 'Grafikon br. 1 "Zavisnost prihoda od mjeseca u godini"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Mjeseci$', size=16)
plt.ylabel('$Prodaja$', size=16)
plt.show()
Grafikon br. 1 «Zavisnost prihoda od mjeseca u godini»
Analitičko rješenje
Iskoristit ćemo najobičnije alate u python i riješiti sustav jednadžbi:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Prema Cramerovom pravilu pronaći ćemo glavni determinantu, kao i determinante po  i po
 , nakon čega ćemo, podijelivši determinantu po
 s glavnom determinantom — pronaći koeficijent
 , slično ćemo pronaći koeficijent
 .
Kod analitičkog rješenja
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Evo što smo dobili:
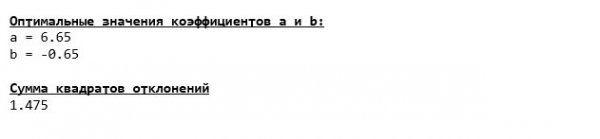
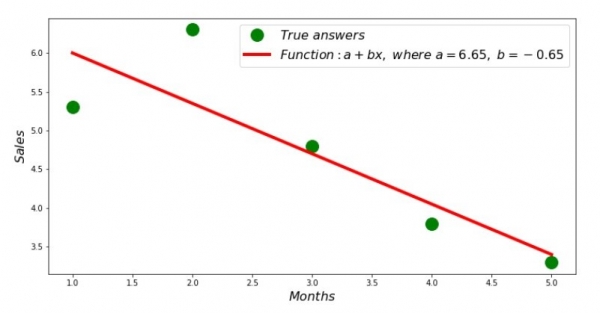
Dakle, vrijednosti koeficijenata su pronađene, suma kvadrata odstupanja je utvrđena. Nacrtat ćemo na histogramu raspršenja pravac prema pronađenim koeficijentima.
Kod linije regresije
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Grafikon br. 2 «Pravi i izračunati odgovori»
Možemo pogledati grafikon odstupanja za svaki mjesec. U našem slučaju, ne možemo izvući nikakvu značajnu praktičnu vrijednost iz njega, ali zadovoljiti ćemo znatiželju koliko dobro jednadžba jednostavne linearne regresije prikazuje zavisnost prihoda od mjeseca u godini.
Kod grafikona odstupanja
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Grafikon br. 3 «Odstupanja, %»
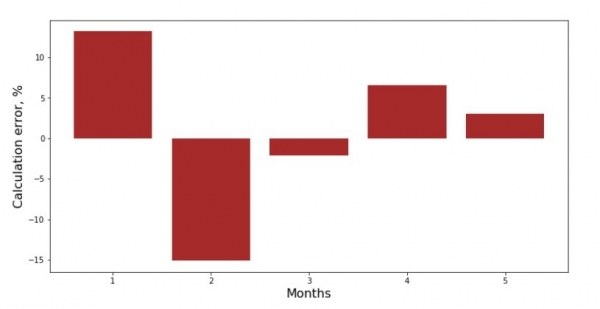
Nije savršeno, ali naš zadatak smo ispunili.
Napisat ćemo funkciju koja za određivanje koeficijenata  i
 koristi biblioteku NumPy, točnije — napisat ćemo dvije funkcije: jednu koristeći pseudo-inverznu matricu (ne preporučuje se u praksi, jer je proces računski složen i nestabilan), drugu koristeći matričnu jednadžbu.
Kod analitičkog rješenja (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Usporedimo vrijeme koje je potrošeno za određivanje koeficijenata  i
 , u skladu s 3 predstavljena načina.
Kod za izračunavanje vremena proračuna
print ' 33[1m' + ' 33[4m' + "Vrijeme izvođenja izračuna koeficijenata bez korištenja biblioteke NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Vrijeme izvođenja izračuna koeficijenata s korištenjem pseudoobratne matrice:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Vrijeme izvođenja izračuna koeficijenata s korištenjem matrične jednadžbe:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)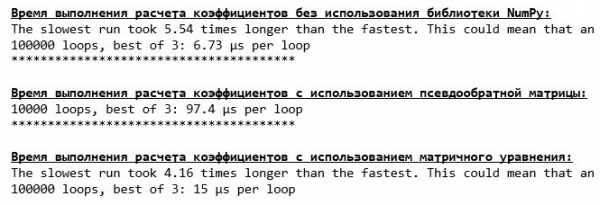
Na maloj količini podataka, najbolju izvedbu ostvaruje "samostalno" napisana funkcija koja pronalazi koeficijente metodom Kramera.
Sada možemo preći na druge metode pronalaženja koeficijenata.  i
 .
Gradijentni spust
Prvo, definirajmo što je gradijent. U najjednostavnijim terminima, gradijent je segment koji ukazuje na smjer maksimalnog rasta funkcije. U analognom smislu s penjanjem na planinu, smjer u kojem gradijent gleda predstavlja najstrmiji uspon prema vrhu planine. Nastavljajući s primjerom planine, sjetimo se da nam zapravo treba najstrmija staza prema dolje kako bismo što brže došli do nizine, odnosno minimuma — mjestu gdje funkcija ne raste i ne opada. Na tom mjestu derivacija će biti nula. Dakle, trebamo ne gradijent, već antigradijent. Da bismo pronašli antigradijent, jednostavno je potrebno pomnožiti gradijent s -1 (minus jedan).
Obratimo pažnju na to da funkcija može imati više minimuma, a ako smo upali u jedan od njih prema algoritmu koji slijedi, nećemo moći pronaći drugi minimum koji se možda nalazi ispod pronađenog. Opustimo se, to nas ne prijeti! U našem slučaju, imamo posla s jednim jedinim minimumom, budući da naša funkcija  na grafu izgleda kao obična parabola. A kako svi dobro znamo iz školskog matematčkog kursa — parabola ima samo jedan minimum.
Nakon što smo utvrdili zašto nam treba gradijent, kao i da je gradijent segment, odnosno vektor s određenim koordinatama koje su upravo oni koeficijenti  i
 možemo implementirati gradijentni spust.
Prije pokretanja, predlažem da pročitate doslovno nekoliko rečenica o algoritmu spuštanja:
- Određujemo koordinate koeficijenata na pseudo slučajan način.
 i . U našem primjeru, definirat ćemo koeficijente u blizini nule. To je uobičajena praksa, no za svaki slučaj može postojati vlastita praksa.
- Od koordinate oduzimamo vrijednost parcijalne derivacije prvog reda u točki . Tako, ako je derivacija pozitivna, funkcija raste. Stoga, oduzimajući vrijednost derivacije, krećemo se u suprotnom smjeru rasta, odnosno prema silasku. Ako je derivacija negativna, znači da funkcija u toj točki opada i oduzimajući vrijednost derivacije krećemo se prema silasku.
- Provodimo sličnu operaciju s koordinatom : oduzimamo vrijednost parcijalne derivacije u točki .
- Kako bismo izbjegli preskakanje minimuma i ne otišli u daleki svemir, potrebno je postaviti veličinu koraka u smjeru silaska. Općenito, može se napisati cijeli članak o tome kako pravilno postaviti korak i kako ga mijenjati tijekom silaska, kako bismo smanjili troškove izračuna. No, sada imamo nešto drugačiji zadatak, i znanstvenom metodom "nasumce" ili kako narod voli reći, empiričkim putem, postavit ćemo veličinu koraka.
- Nakon što smo od zadatih koordinata i oduzeli vrijednosti derivacija, dobivamo nove koordinate i . Izvršavamo sljedeći korak (oduzimanje), već iz izračunatih koordinata. I tako se ciklus iznova pokreće, sve dok ne postignemo potrebnu konvergenciju.
 i
 . U našem primjeru, definirat ćemo koeficijente u blizini nule. To je uobičajena praksa, no za svaki slučaj može postojati vlastita praksa.
 oduzimamo vrijednost parcijalne derivacije prvog reda u točki
 . Tako, ako je derivacija pozitivna, funkcija raste. Stoga, oduzimajući vrijednost derivacije, krećemo se u suprotnom smjeru rasta, odnosno prema silasku. Ako je derivacija negativna, znači da funkcija u toj točki opada i oduzimajući vrijednost derivacije krećemo se prema silasku.
 : oduzimamo vrijednost parcijalne derivacije u točki
 .
 i
 oduzeli vrijednosti derivacija, dobivamo nove koordinate
 i
 . Izvršavamo sljedeći korak (oduzimanje), već iz izračunatih koordinata. I tako se ciklus iznova pokreće, sve dok ne postignemo potrebnu konvergenciju.
Sve! Sada smo spremni započeti potragu za najdubljom kanjonom Marijanske brazde. Krenimo.
Kod za gradijentni silazak
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print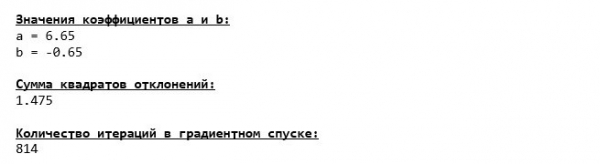
Zaronili smo na samo dno Marijanske brazde i tamo otkrili sve iste vrijednosti koeficijenata  i
 , što je zapravo i bilo za očekivati.
Izvršit ćemo još jedno uranjanje, samo što će ovoga puta, sadržaj našeg dubokomorskog aparata biti druge tehnologije, a to je knjižnica NumPy.
Kod za gradijentni silazak (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print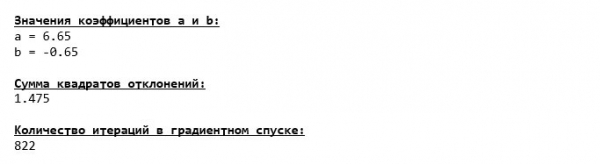
Vrijednosti koeficijenata  i
 ostaju nepromijenjene.
Pogledajmo kako se greška mijenjala tijekom gradijentnog silaska, odnosno kako se mijenjala suma kvadrata odstupanja s svakim korakom.
Kod za grafikon suma kvadrata odstupanja
print 'Grafikon br. 4 "Suma kvadrata odstupanja po koracima"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Koraci (Iteracija)', size=16)
plt.ylabel('Suma kvadrata odstupanja', size=16)
plt.show()
Grafikon br. 4 „Zbroj kvadrata odstupanja pri gradijentnom spuštanju“
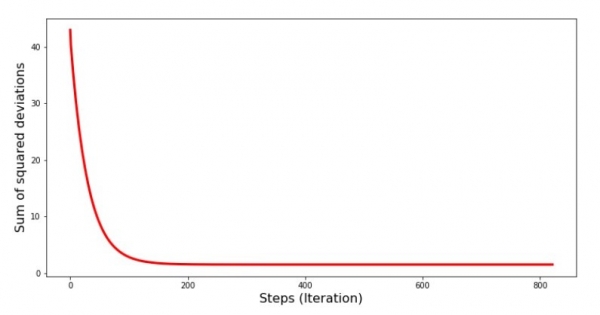
Na grafiku vidimo da greška opada sa svakim korakom, a nakon određenog broja iteracija primjećujemo skoro horizontalnu liniju.
Na kraju, procijenimo razliku u vremenu izvršavanja koda:
Kod za određivanje vremena izračunavanja gradijentnog spuštanja
print ' 33[1m' + ' 33[4m' + "Vrijeme izvršavanja gradijentnog spuštanja bez korištenja biblioteke NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Vrijeme izvršavanja gradijentnog spuštanja korištenjem biblioteke NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)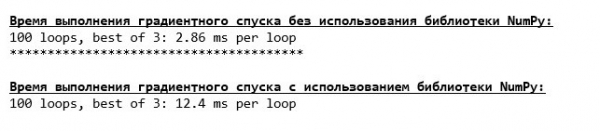
Moguće je da radimo nešto pogrešno, ali opet jednostavna „samoizradena“ funkcija koja ne koristi biblioteku NumPy prečinjava vrijeme izvršavanja izračuna funkciji koja koristi biblioteku NumPy.
No, ne stojimo na mjestu, već se krećemo prema istraživanju još jednog fascinantnog načina rješavanja jednadžbe jednostavne linearne regresije. Upoznajte!
Stohastički gradijentni spust
Kako bismo brže razumjeli princip rada stohastičkog gradijentnog spuštanja, bolje je odrediti njegove razlike od običnog gradijentnog spuštanja. U slučaju gradijentnog spuštanja, u jednadžbama izvedenica koristili smo zbrojeve svih značajki i stvarnih odgovora koji se nalaze u uzorku (tj. zbroj svih  i
 ). U stohastičkom gradijentnom spuštanju nećemo koristiti sve vrijednosti koje se nalaze u uzorku, već ćemo umjesto toga, pseudo-slučajno odabrati tzv. indeks uzorka i koristiti njegove vrijednosti.
 i
 Na primjer, ako je indeks odabran kao broj 3 (tri), uzimamo vrijednosti
, zatim te vrijednosti zamjenjujemo u jednadžbama izvedenica i određujemo nove koordinate. Nakon što odredimo koordinate, ponovno pseudo-slučajno određujemo indeks uzorka, zamjenjujemo vrijednosti koje odgovaraju indeksu u jednadžbama parcijalnih izvedenica te ponovno određujemo koordinate  i
 itd. do izbijanja konvergencije. Na prvi pogled, može se činiti kako to uopće može funkcionirati, no radi. Međutim, treba napomenuti da greška ne opada s svakim korakom, ali tendencija je nesumnjivo prisutna.
 i
 i tako dalje do zelenjenja konvergencije. Na prvi pogled može se činiti kako to uopće može funkcionirati, no funkcionira. Istina je da ne dolazi do smanjenja pogreške s svakim korakom, ali tendencija je neosporna.
Koje su prednosti stohastičkog gradijentnog spuštanja u odnosu na klasično? U slučaju da je veličina uzorka vrlo velika i mjeri se u desecima tisuća vrijednosti, mnogo je jednostavnije obraditi, primjerice, slučajnu tisuću od njih, nego cijeli uzorak. U tom slučaju se pokreće stohastičko gradijentno spuštanje. U našem slučaju, naravno, nećemo primijetiti veliku razliku.
Pogledajmo kod.
Kod za stohastičko gradijentno spuštanje
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])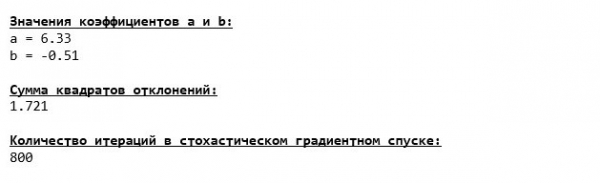
Pazimo pažljivo na koeficijente i postavljamo si pitanje „Kako to?“. Imamo drugačije vrijednosti koeficijenata.  i
 . Možda je stohastičko gradijentno spuštanje našlo optimalnije parametre jednadžbe? Nažalost, nije. Dovoljno je pogledati na sumu kvadrata devijacija i vidjeti da je s novim vrijednostima koeficijenata greška veća. Ne žurimo s očajem. Izradit ćemo grafikon promjene greške.
Kod za grafikon sume kvadrata devijacija pri stohastičkom gradijentnom spuštanju
print 'Grafikon br. 5 "Suma kvadrata devijacija po koracima"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Koraci (Iteracija)', size=16)
plt.ylabel('Suma kvadrata devijacija', size=16)
plt.show()
Grafikon br. 5 «Suma kvadrata devijacija pri stohastičkom gradijentnom spuštanju»
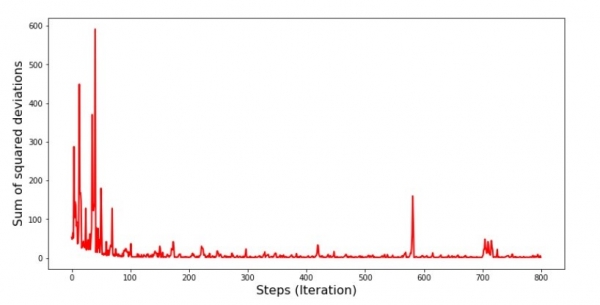
Pogledavši grafikon, sve postaje jasno i sada ćemo sve ispraviti.
Dakle, što se zapravo dogodilo? Dogodilo se sljedeće. Kada nasumično biramo mjesec, naš algoritam nastoji smanjiti grešku u izračunu prihoda za odabrani mjesec. Zatim biramo drugi mjesec i ponavljamo izračun, ali već smanjujemo grešku za drugi odabrani mjesec. A sada se sjetimo da se naših prvih dva mjeseca značajno odvajaju od linije jednadžbe obične linearne regresije. To znači da, kada se odabere bilo koji od tih dvaju mjeseci, smanjujući grešku svakog od njih, naš algoritam ozbiljno povećava grešku za cijeli uzorak. Pa što učiniti? Odgovor je jednostavan: treba smanjiti korak spuštanja. Jer smanjivanjem koraka spuštanja, greška će prestati „skočiti“ gore-dolje. Točnije, greška „skakanja“ neće prestati, ali to će činiti sporije :) Provjerimo.
Kod za pokretanje SGD s manjim korakom
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()
Grafikon br. 6 «Suma kvadrata devijacija pri stohastičkom gradijentnom spuštanju (80 tisuća koraka)»
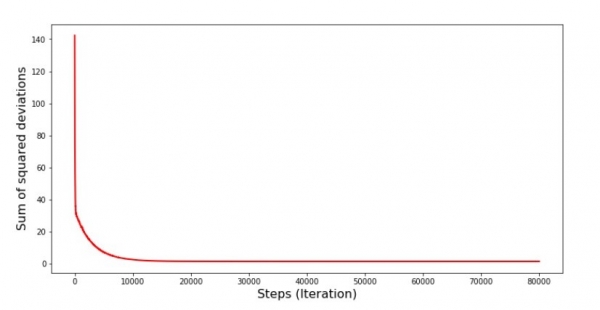
Vrijednosti koeficijenata su se poboljšale, ali još uvijek nisu savršene. Teoretski, to se može ispraviti na sljedeći način. Odaberemo, na primjer, vrijednosti koeficijenata koje su imale minimalnu grešku tokom posljednjih 1000 iteracija. Međutim, za to ćemo morati zabilježiti i same vrijednosti koeficijenata. Nećemo to raditi, već ćemo se fokusirati na grafikon. Izgleda glatko, a greška se čini da se smanjuje ravnomjerno. U stvarnosti to nije tako. Pogledajmo prvih 1000 iteracija i uporedimo ih s posljednjima.
Kod za grafikon SGD (prvih 1000 koraka)
print 'Grafikon br. 7 "Zbroj kvadrata odstupanja po koraku. Prvih 1000 iteracija"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Koraci (Iteracija)', size=16)
plt.ylabel('Zbroj kvadrata odstupanja', size=16)
plt.show()

print 'Grafikon br. 7 "Zbroj kvadrata odstupanja po koraku. Posljednjih 1000 iteracija"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Koraci (Iteracija)', size=16)
plt.ylabel('Zbroj kvadrata odstupanja', size=16)
plt.show()
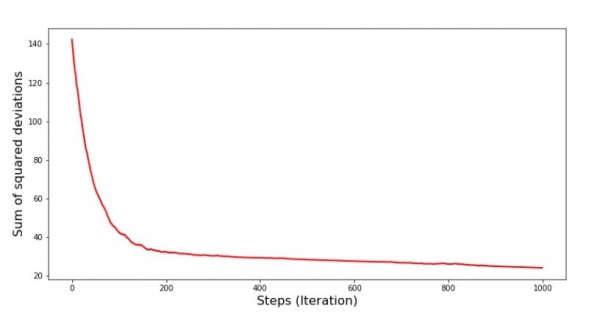
Grafikon br. 7 «Zbroj kvadrata odstupanja SGD (prvih 1000 koraka)»
Grafikon br. 8 «Zbroj kvadrata odstupanja SGD (posljednjih 1000 koraka)»
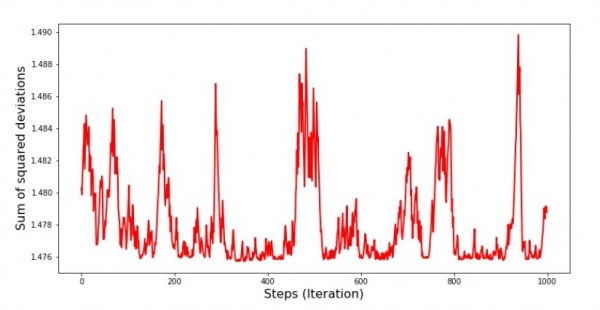
Na početku spuštanja primjećujemo dovoljno ravnomjerno i strmo smanjenje greške. U posljednjim iteracijama vidimo da greška oscilira oko vrijednosti od 1,475 i u nekim trenucima čak dostiže tu optimalnu vrijednost, ali se ipak ponovo povećava... Ponovo ću reći, možemo zapisivati vrijednosti koeficijenata  i
 , a zatim odabrati one za koje je greška minimalna. Međutim, suočili smo se s ozbiljnijim problemom: morali smo napraviti 80 tisuća koraka (vidi kod) kako bismo dobili vrijednosti bliske optimalnim. A to, već proturječi ideji o uštedi vremena prilikom izračunavanja uz stohastičko spuštanje u odnosu na gradijentno. Što se može ispraviti i poboljšati? Nije teško primijetiti da na prvim iteracijama sigurno idemo prema dolje i stoga bismo trebali zadržati veliki korak na prvim iteracijama, a kako napredujemo, korak smanjivati. Nećemo to raditi u ovom članku — već se odužio. Oni koji žele mogu sami razmisliti kako to učiniti, nije teško 🙂
Sada ćemo izvršiti stohastičko spuštanje koristeći biblioteku NumPy (i nećemo se spoticati o kamenje koje smo prethodno otkrili)
Kod za stohastičko optimiziranje gradijentnim spustom (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print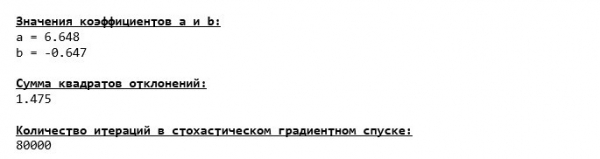
Dobijene vrijednosti su gotovo identične onima koje smo dobili bez korištenja NumPy. Ipak, to je logično.
Saznajmo koliko je vremena trebalo našim stohastičkim gradijentnim spustovima.
Kod za određivanje vremena izvršenja SGD (80 tisuća koraka)
print ' 33[1m' + ' 33[4m' +
"Vreme izvršenja stohastičkog gradijentnog spusta bez korištenja NumPy biblioteke:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Vreme izvršenja stohastičkog gradijentnog spusta uz korištenje NumPy biblioteke:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)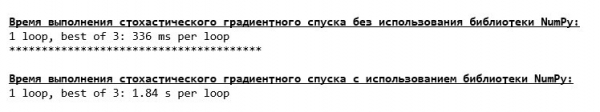
Što dalje idemo, tmurnije su oblaci: opet 'home-made' formula pokazuje bolje rezultate. Sve ovo navodi na razmišljanje da bi mogli postojati još sofisticiraniji načini korištenja biblioteke NumPy, koji zaista ubrzavaju matematičke operacije. U ovom članku o njima nećemo saznati. Biće o čemu razmišljati u slobodno vreme :)
Rekapitulirajmo
Prije nego rezimiramo, želio bih odgovoriti na pitanje koje je sigurno postavio naš dragi čitalac. Šta nam zapravo donose ovi 'mučni' spustovi, zašto treba da se penjemo brdom gore i dolje (pretežno dolje), kako bismo pronašli željenu nizinu, kada u našim rukama imamo moćan i jednostavan alat u obliku analitičkog rješenja, koji nas trenutačno teleportira na pravo mjesto?
Odgovor na ovo pitanje je na površini. Sada smo razmatrali vrlo jednostavan primjer, u kojem pravi odgovor  zavisi od jedne karakteristike
 . U stvarnosti to se ne događa često, stoga pretpostavimo da imamo 2, 30, 50 ili više karakteristika. Dodajmo tome tisuće, čak i desetke tisuća vrijednosti za svaku karakteristiku. U ovom slučaju analitičko rješenje možda neće izdržati test i može zakazati. S druge strane, gradijentni spust i njegove varijacije će nas polako, ali sigurno približiti cilju — minimumu funkcije. A što se tiče brzine, ne brinite — sigurno ćemo još jednom razmatrati načine koji nam omogućavaju da postavljamo i regulišemo dužinu koraka (tj. brzinu).
A sada, evo kratkog rezimea.
Prvo, nadam se da će materijal iz članka pomoći početnicima "data scientistima" u razumijevanju kako rješavati jednadžbe jednostavne (i ne samo) linearne regresije.
Drugo, razmotrili smo nekoliko metoda rješavanja jednadžbe. Sada, ovisno o situaciji, možemo odabrati onu koja najbolje odgovara rješavanju postavljenog zadatka.
Treće, vidjeli smo snagu dodatnih postavki, posebno duljine koraka gradijentnog spuštanja. Ova postavka se ne može zanemariti. Kao što je ranije spomenuto, kako bismo smanjili troškove računalnih operacija, duljinu koraka treba mijenjati tijekom spuštanja.
Četvrto, u našem slučaju, "prilagođene" funkcije su pokazale bolje vremenske rezultate proračuna. Vjerojatno je to povezano s manje profesionalnim korištenjem mogućnosti biblioteke. NumPyNo, kako god bilo, slijedi sljedeći zaključak. S jedne strane, ponekad vrijedi preispitati ustaljena mišljenja, a s druge strane, ne treba uvijek komplicirati — naprotiv, ponekad se učinkovitijim pokaže jednostavniji način rješavanja zadatka. Kako smo imali za cilj razmotriti tri pristupa rješavanju jednadžbe jednostavne linearne regresije, korištenje "prilagođenih" funkcija nam je bilo sasvim dovoljno.
Literatura (ili nešto slično)
1. Linearna regresija
2. Metoda najmanjih kvadrata
3. Derivacija
4. Gradijent
5. Gradijentno spuštanje
6. Biblioteka NumPy
Izvor: habr.com
