

U ovom članku ćemo razgovarati o funkcionalnim zavisnostima u bazama podataka – što su one, gdje se primjenjuju i koje algoritme postoje za njihovo pronalaženje.
Funkcionalne zavisnosti razmatrat ćemo u kontekstu relacijskih baza podataka. Ako kažemo dosta grubo, u takvim bazama podaci se pohranjuju u obliku tablica. Dalje ćemo koristiti približne pojmove koji u strogoj relacijskoj teoriji nisu zamjenjivi: samu tablicu ćemo nazivati relacijom, stupce – atributima (njihovo mnoštvo – shemom relacije), a skup vrijednosti jedne retke na podskupu atributa – tuplom.
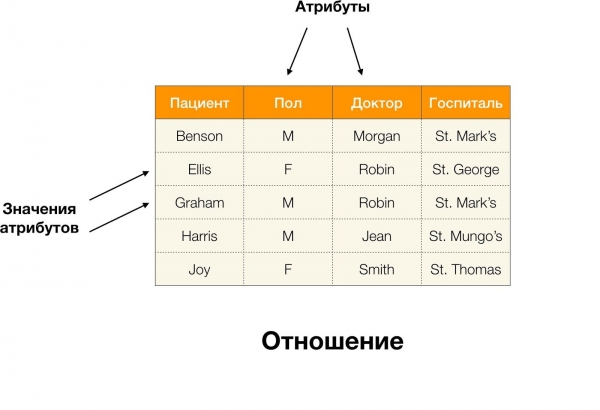
Na primjer, u gornjoj tablici, (Benson, M, M organ) je tuplom po atributima (Pacijent, Spol, Doktor).
Kao formalno, to se zapisuje u sljedećem obliku:  [Pacijent, Spol, Doktor] = (Benson, M, M organ).
Sada možemo uvesti pojam funkcionalne zavisnosti (FZ):
Definicija 1. Relacija R zadovoljava FZ X → Y (gdje su X, Y ⊆ R) ako i samo ako za sve tuple  ,
 ∈ R važi: ako
 [X] =
 [X], tada
 [Y] =
 [Y]. U tom slučaju se kaže da X (determinanta ili određujuće mnoštvo atributa) funkcionalno određuje Y (zavisno mnoštvo).
Drugim riječima, postojanje FZ X → Y znači da ako imamo dvije tuple u R i one se podudaraju po atributima X, tada će se podudarati i po atributima Y.
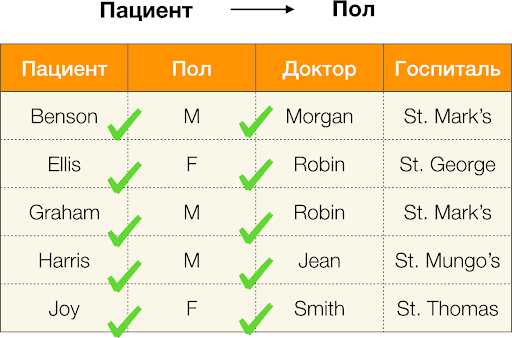
A sada redom. Razmotrit ćemo atribute Pacijent i Rod za koje želimo saznati postoje li zavisnosti među njima ili ne. Za takvo mnoštvo atributa mogu postojati slijedeće zavisnosti:
- Pacijent → Spol
- Spol → Pacijent
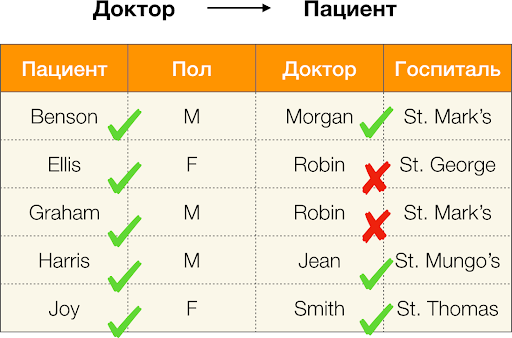
Prema gornjoj definiciji, da bi prva zavisnost opstala, svakom jedinstvenom vrijednosti stupca Pacijent mora odgovarati samo jedna vrijednost stupca Rod. I za tablicu-primjer to zaista vrijedi. Međutim, u obrnutom smjeru to ne funkcionira, tj. druga zavisnost ne važi, a atribut Rod nije determinanta za Pacijenta.Slično tome, ako uzmemo zavisnost Doktor → Pacijent, možemo primijetiti da je ona narušena, jer vrijednost Robin po tom atributu ima nekoliko različitih vrijednosti – Ellis i Graham.
Na taj način, funkcionalne ovisnosti omogućuju određivanje postojećih veza među skupovima atributa tablice. Stoga ćemo ubuduće razmatrati najzanimljivije veze, točnije one X → Y, koje su:
- netrivijalne, to jest desna strana ovisnosti nije podskup lijeve (Y ̸⊆ X);
- minimalne, to jest ne postoji takva ovisnost Z → Y, što Z ⊂ X.
Ovisnosti razmatrane do sada bile su stroge, to jest nisu predviđale nikakva kršenja na tablici, no osim njih postoje i takve koje dopuštaju određenu nesukladnost između vrijednosti dvojnika. Takve ovisnosti izdvajaju se u posebnu klasu, nazivaju se približnima i dopuštaju im da budu povrijeđene u određenom broju dvojnika. Taj broj regulira pokazatelj maksimalne pogreške emax. Na primjer, udio pogreške  = 0.01 može značiti da se ovisnost može kršiti na 1% od postojećih dvojnika u razmatranom skupu atributa. To jest, za 1000 zapisa maksimalno 10 dvojnika mogu kršiti FZ. Međutim, razmatrat ćemo malo drugačiju metriku, temeljenju na usporedivim različitim vrijednostima dvojnika. Za ovisnost X → Y na relaciji r izračunava se ovako:

Izračunajmo pogrešku za Doktor → Pacijent iz prethodnog primjera. Imamo dva dvojnika, čije se vrijednosti razlikuju po atributu Pacijent, ali se podudaraju na Doktoru:  [Doktor, Pacijent] = (Robin, Ellis) i
 [Doktor, Pacijent] = (Robin, Graham). Slijedeći definiciju pogreške, moramo uzeti u obzir sve sukobljene parove, a to znači da ih je dvoje: (
 ,
 ) i njihova inverzija (
 ,
 ). Umetnimo u formulu i dobijemo:

A sada pokušajmo odgovoriti na pitanje: „A zašto sve to?“. U stvari, FZ mogu biti različite. Prvi tip su takve ovisnosti koje određuje administrator tijekom dizajniranja baze podataka. Obično ih je malo, one su stroge, a njihova osnovna primjena je normalizacija podataka i dizajn relacijske sheme.
Drugi tip su ovisnosti, koje predstavljaju "skrivene" podatke i ranije nepoznate veze između atributa. Drugim riječima, o takvim ovisnostima nije se razmišljalo u trenutku planiranja, a nalaze se kasnije unutar postojećeg skupa podataka, kako bi se na temelju niza otkrivenih funkcionalnih ovisnosti donijeli neki zaključci o pohranjenim informacijama. Upravo se s takvim ovisnostima bavimo. Postoji cijelo područje data mininga s različitim tehnikama pretraživanja i algoritmima temeljenima na njima. Istražimo kako mogu biti korisne otkrivene funkcionalne ovisnosti (točne ili približne) u nekim podacima.
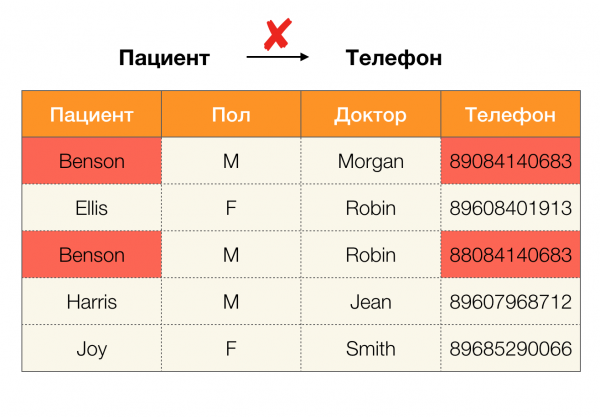
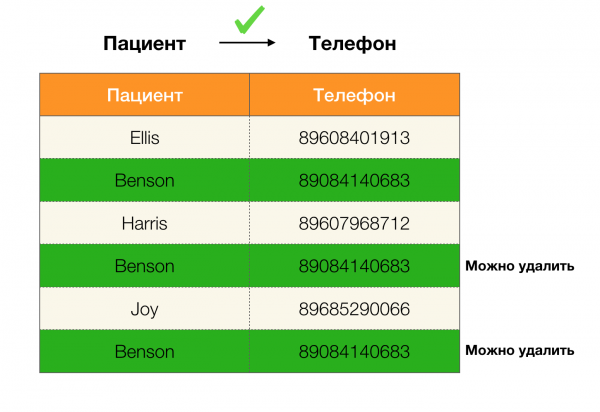
Danas se među glavnim područjima primjene ovisnosti ističe čišćenje podataka. Ono uključuje razvoj procesa prepoznavanja "prljavih podataka" s naknadnom ispravkom. Istaknuti primjeri "prljavih podataka" su duplikati, greške u podacima ili tipfelere, propuštene vrijednosti, zastarjeli podaci, viškovi razmaka i slično.
Primjer greške u podacima:
Primjer duplikata u podacima:
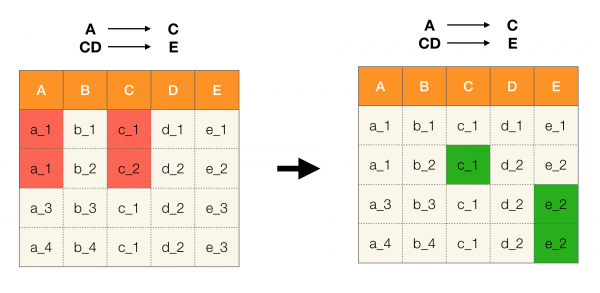
Na primjer, imamo tablicu i skup funkcionalnih ovisnosti koje bi trebale biti zadovoljene. Čišćenje podataka u ovom slučaju podrazumijeva mijenjanje podataka tako da ovisnosti postanu ispravne. Pri tome bi broj modifikacija trebao biti minimalan (za ovu proceduru postoje vlastiti algoritmi, na kojima se nećemo zadržavati u ovom članku). Dolje je prikazan primjer takve transformacije podataka. S lijeve strane je izvorna relacija, u kojoj se očito ne poštuju potrebne ovisnosti (crvenom bojom je istaknuta povreda jedne od ovisnosti). S desne strane je prikazana ažurirana relacija, u kojoj zeleni ćelije pokazuju promijenjene vrijednosti. Nakon provedbe takve procedure, potrebne ovisnosti su počele biti zadovoljene.
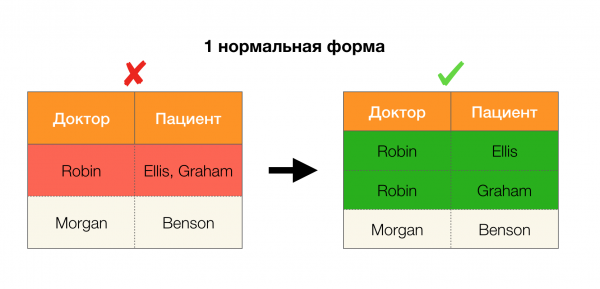
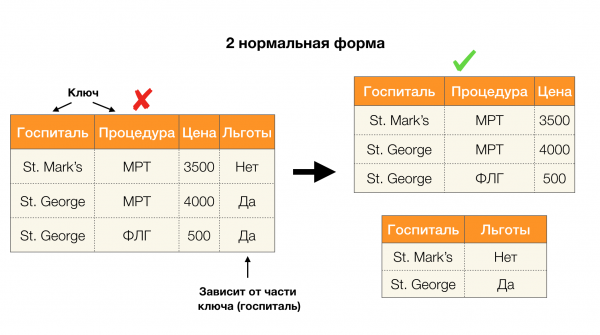
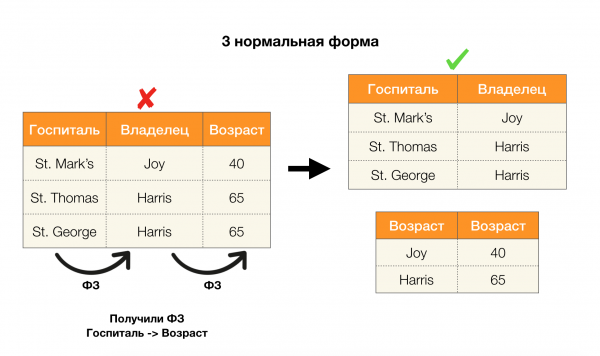
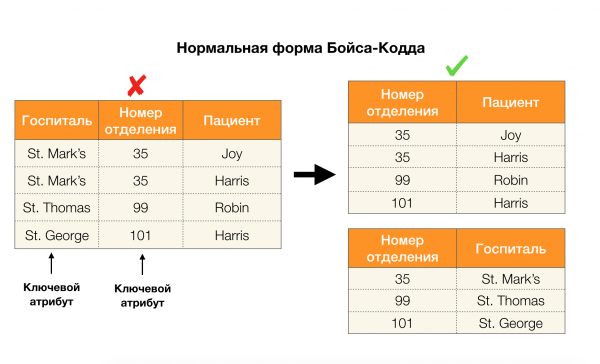
Druga popularna primjena je dizajn baza podataka. Ovdje se valja prisjetiti normalnih oblika i normalizacije. Normalizacija je proces usklađivanja odnosa s određenim skupom zahtjeva, od kojih svaki na svoj način definira normalni oblik. Nećemo se zadržavati na zahtjevima raznih normalnih oblika (to je obrađeno u svakoj knjizi o Bazi podataka za početnike), nego ćemo primijetiti da svaki od njih na svoj način koristi koncept funkcionalnih ovisnosti. Naime, funkcionalne ovisnosti su u suštini ograničenja integriteta koja se uzimaju u obzir prilikom dizajniranja baze podataka (u kontekstu ove teme, funkcionalne ovisnosti ponekad nazivamo superključevima).
Razmotrit ćemo njihovu primjenu za četiri normalna oblika na slici ispod. Podsjetimo, Boyce-Codd normalni oblik je stroži od trećeg oblika, ali manje strožeg od četvrtog. Četvrti oblik ne raspravljamo još, jer za njegovu primjenu je potrebno razumijevanje višeznačnih ovisnosti, koje u ovom članku nisu tema interesa.
Još jedno područje u kojem su ovisnosti pronašle svoju primjenu je smanjenje dimenzionalnosti prostora značajki u zadatcima poput izrade naivnog Bayesovog klasifikatora, isticanja značajnih značajki i reparameetrizacije regresijske modela. U izvornim člancima, ovaj zadatak se naziva određivanje suvišnih značajki (feature redundancy) i relevantnih (feature relevancy) [5, 6], a rješava se uz aktivno korištenje koncepta baza podataka. S pojavom takvih radova možemo reći da je danas prisutan zahtjev za rješenjima koja omogućuju integraciju baza podataka, analitike i implementaciju navedenih problema optimizacije u jedan alat [7, 8, 9].
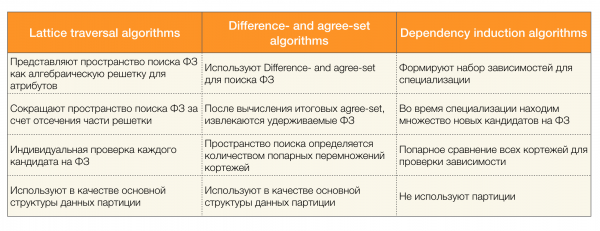
Za pronalazak funkcionalnih ovisnosti u skupu podataka postoji mnoštvo algoritama (kako modernih, tako i manje novih). Takvi algoritmi se mogu podijeliti u tri grupe:
- Algoritmi koji koriste pretraživanje algebarskih rešetki (Lattice traversal algorithms)
- Algoritmi temeljeni na pretraživanju usklađenih vrijednosti (Difference- and agree-set algorithms)
- Algoritmi temeljeni na parnim usporedbama (Dependency induction algorithms)
Kratak opis svakog tipa algoritma predstavljen je u tablici ispod:
Više o ovoj klasifikaciji možete pročitati [4]. Ispod su navedeni primjeri algoritama za svaku od tipova:
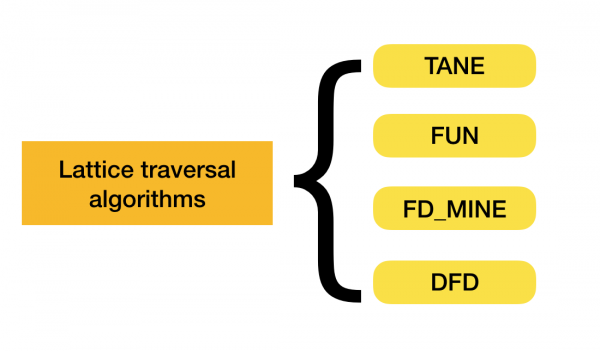
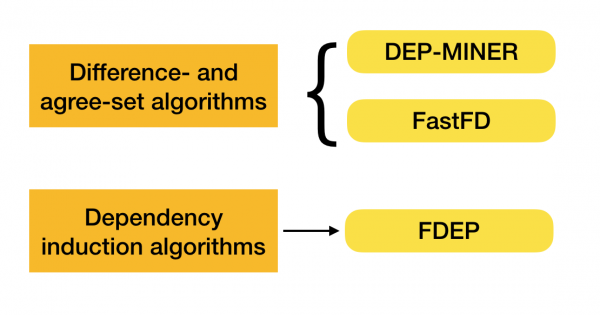
Trenutno se pojavljuju novi algoritmi koji kombiniraju nekoliko pristupa za otkrivanje funkcionalnih zavisnosti. Primjeri takvih algoritama su Pyro [2] i HyFD [3]. Analiza njihovog rada predviđena je u sljedećim člancima ovog ciklusa. U ovom članku ćemo samo obraditi osnovne pojmove i lemme potrebne za razumijevanje tehnika otkrivanja zavisnosti.
Počnimo s jednostavnim – difference-set i agree-set, korištenim u drugom tipu algoritama. Difference-set predstavlja skup uređenih parova koji se ne podudaraju po vrijednostima, dok se agree-set suprotno – uređenih parova koji se podudaraju po vrijednostima. Treba napomenuti da u ovom slučaju razmatramo samo lijevu stranu zavisnosti.
Još jedan važan pojam koji je spomenut ranije je algebraička rešetka. Budući da mnogi moderni algoritmi koriste ovu koncepciju, moramo imati predstavu o tome što ona jeste.
Da bismo uveli pojam rešetke, potrebno je definirati djelomično uređen skup (ili partially ordered set, skraćeno – poset).
Definicija 2. Kaže se da je skup S djelomično uređen binarnom relacijom ⩽, ako za sve a, b, c ∈ S važe sljedeća svojstva:
- Refleksivnost, tj. a ⩽ a
- Antisimmetričnost, tj. ako a ⩽ b i b ⩽ a, onda a = b
- Tranzitivnost, tj. za a ⩽ b i b ⩽ c, slijedi da a ⩽ c
Ova relacija naziva se relacijom (ne-strogog) djelomičnog reda, a sam skup – djelomično uređenim skupom. Formalna oznaka: ⟨S, ⩽⟩.
Kao najjednostavniji primjer djelomično uređenog skupa možemo uzeti skup svih prirodnih brojeva N s uobičajenom relacijom reda ⩽. Nije teško provjeriti da su svi potrebni axiomati ispunjeni.
Više sadržajan primjer. Razmotrite skup svih podskupova {1, 2, 3}, uređen relacijom uključivanja ⊆. Naime, ova relacija zadovoljava sve uvjete djelomičnog reda, stoga je ⟨P ({1, 2, 3}), ⊆⟩ – djelomično uređen skup. Na slici ispod prikazana je struktura ovog skupa: ako se iz jednog elementa može doći do drugog elementa po strelicama, tada su oni u relaciji reda.
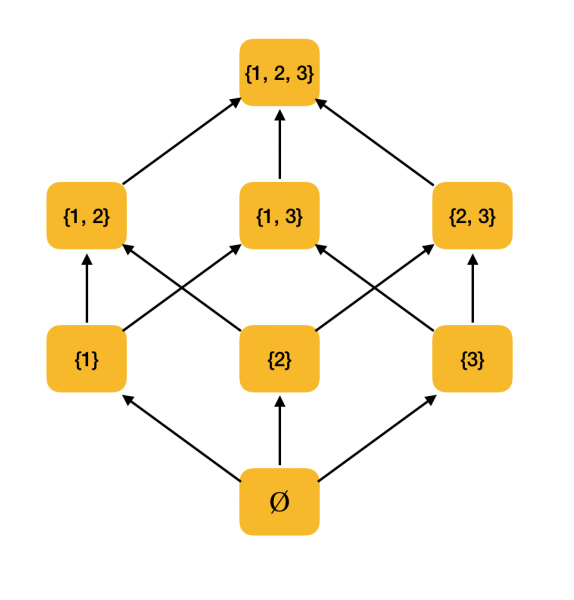
Trebaju nam još dva jednostavna pojma iz matematike — supremum (supremum) i infimum (infimum).
Definicija 3. Neka ⟨S, ⩽⟩ — parcijalno uređen skup, A ⊆ S. Gornja granica A je element u ∈ S takav da ∀x ∈ S: x ⩽ u. Neka U bude skup svih gornjih granica S. Ako u U postoji najmanji element, tada se on naziva supremum i označava kao sup A.
Slično se uvodi pojam točne donje granice.
Definicija 4. Neka ⟨S, ⩽⟩ — parcijalno uređen skup, A ⊆ S. Donja granica A je element l ∈ S takav da ∀x ∈ S: l ⩽ x. Neka L bude skup svih donjih granica S. Ako u L postoji najveći element, tada se on naziva infimum i označava kao inf A.
Razmotrite kao primjer gore navedeni parcijalno uređen skup ⟨P ({1, 2, 3}), ⊆⟩ i pronađimo u njemu supremum i infimum:
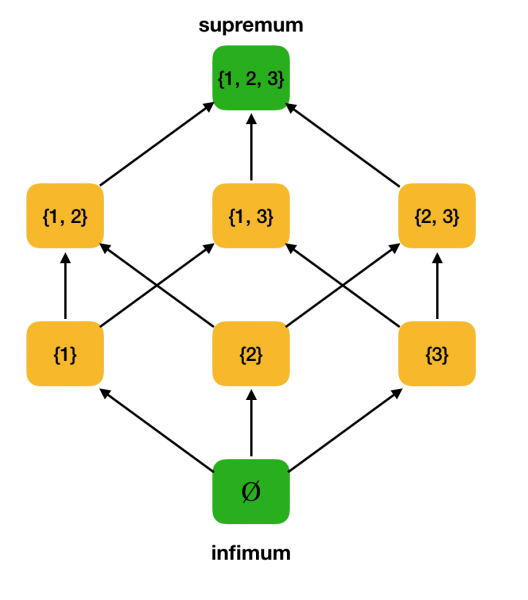
Sada možemo formulirati definiciju algebarske rešetke.
Definicija 5. Neka ⟨P, ⩽⟩ — parcijalno uređen skup tako da svako dvoelementno podskup ima točne gornje i donje granice. Tada se P naziva algebarskom rešetkom. Pri tome se sup{x, y} zapisuje kao x ∨ y, a inf {x, y} — kao x ∧ y.
Provjerimo da naš radni primjer ⟨P ({1, 2, 3}), ⊆⟩ predstavlja rešetku. Naime, za svako a, b ∈ P ({1, 2, 3}), a∨b = a∪b, a a∧b = a∩b. Na primjer, razmotrite skupove {1, 2} i {1, 3} i pronađimo njihov infimum i supremum. Ako ih presiječemo, dobit ćemo skup {1}, koji će biti infimum. Supremum ćemo dobiti njihovim ujedinjenjem — {1, 2, 3}.
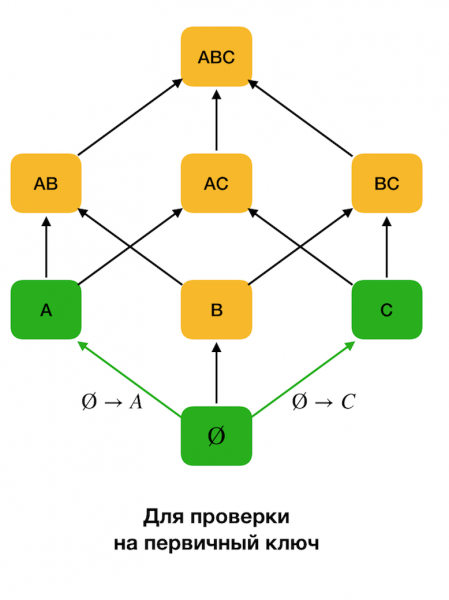
U algoritmima za otkrivanje FZ, prostor pretraživanja često se prikazuje u obliku rešetke, gdje skupovi od jednog elementa (čitajte prvi nivo rešetke pretraživanja, gdje lijeva strana ovisnosti sastoji od jednog atributa) predstavljaju svaki atribut izvorne relacije.
U početku se razmatraju ovisnosti oblika ∅ → Jedinstveni atribut. Ovaj korak omogućava određivanje koji atributi su primarni ključevi (za takve atribute ne mogu postojati determinanti, pa je lijeva strana prazna). Nakon toga, takvi se algoritmi kreću prema rešetki prema gore. Pri tome, treba napomenuti da rešetku nije potrebno prolaziti cijelu, tj. ako se kao ulaz proslijedi željena maksimalna veličina lijeve strane, algoritam dalje neće ići iznad nivoa s tom veličinom.
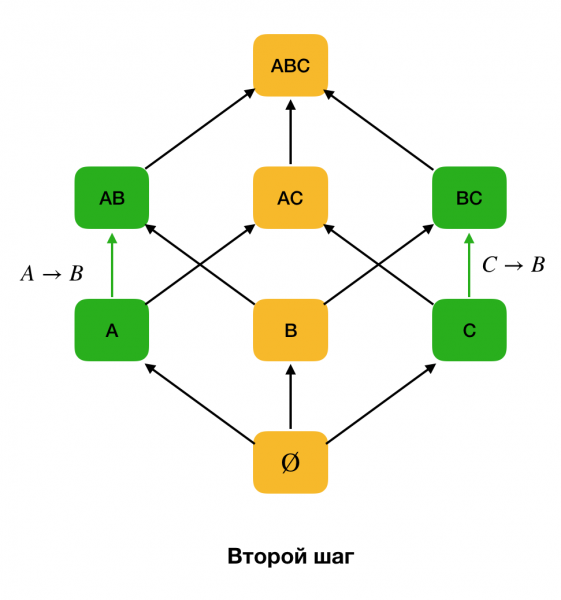
Na slici ispod prikazano je kako se algebarska mreža može koristiti u zadatku pretraživanja FZ. Ovdje svaka grana (X, XY) predstavlja zavisnost X → Y. Na primjer, prošli smo prvi nivo i znamo da se zadržava zavisnost A → B (to ćemo prikazati zelenom vezom između vrhova A i B). To znači da, kada budemo napredovali kroz mrežu, ne možemo provjeravati zavisnost A, C → B, jer ona više neće biti minimalna. Slično, ne bismo je provjeravali ako bi se zadržala zavisnost C → B.
. Osim toga, obično svi moderni algoritmi za pretraživanje FZ koriste strukturu podataka poput particije (u izvoru – stripped partition [1]). Formalna definicija particije izgleda ovako:
Definicija 6. Neka X ⊆ R – skup atributa za relaciju r. Klaster je skup indeksa tuplji iz r, koji imaju istu vrijednost za X, to jest c(t) = {i|ti[X] = t[X]}. Particija je skup klastera, isključujući klastere jedinstvene dužine:

Jednostavnim riječima, particija za atribut X predstavlja skup lista, gdje svaka lista sadrži brojeve redaka sa istim vrijednostima za X. U savremenoj literaturi, struktura koja predstavlja particije naziva se position list index (PLI). Klasteri jedinstvene dužine isključuju se radi kompresije PLI-a, jer su to klasteri koji sadrže samo broj zapisa s jedinstvenom vrijednošću, koju je uvijek lako ustanoviti.
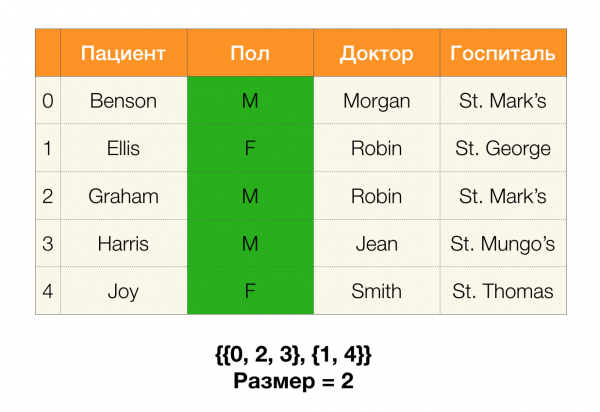
Razmotrimo primjer. Vratimo se na istu tabelu s pacijentima i izgradimo particije za kolone Pacijent i Rod (s lijeve strane se pojavila nova kolona, u kojoj su označeni brojevi redaka tabele):
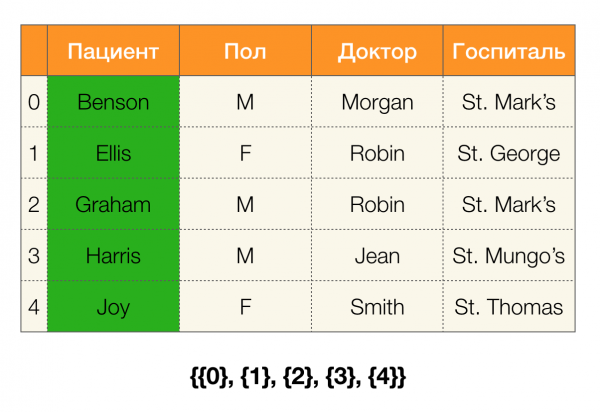
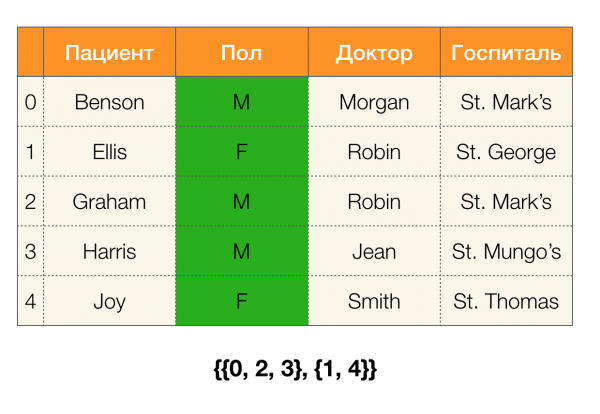
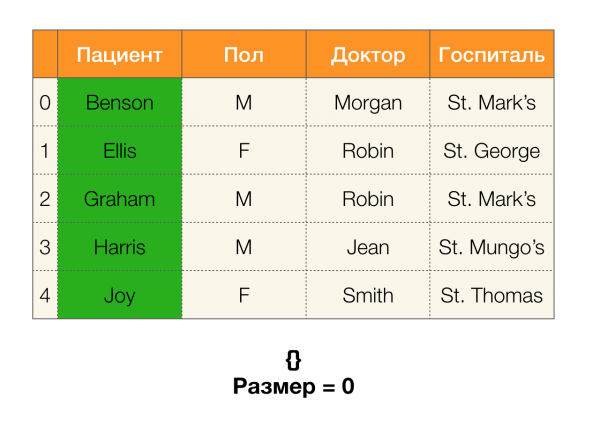
Pri tome će, prema definiciji, particija za kolonu Pacijent zapravo biti prazna, s obzirom da se pojedinačni klasteri isključuju iz particije.
Particije se mogu dobiti po nekoliko atributa. I za to postoje dva puta: proći kroz tabelu i izgraditi particiju odmah prema svim potrebnim atributima, ili je izraditi pomoću operacije presjeka particija po podskupu atributa. Algoritmi pretraživanja FZ koriste drugu opciju.
Jednostavnim riječima, da bi se, na primjer, dobila particija za kolone ABC, može se uzeti particija za AC i B (ili bilo koji drugi skup nepoklapanja podmnožaka) i međusobno ih križati. Operacija preklapanja dviju particija ističe klastere najveće duljine zajedničke za obje particije.
Hajde da razmotrimo primjer:
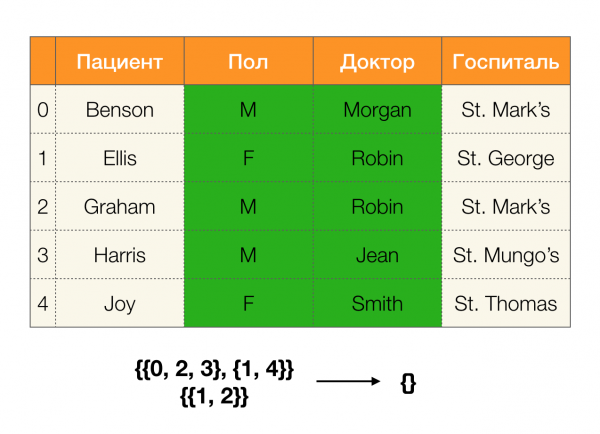
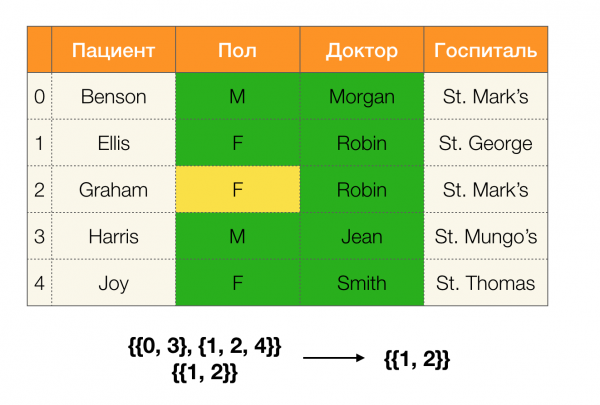
U prvom slučaju dobili smo praznu particiju. Ako pažljivo pogledamo tablicu, stvarno, ne postoje jednake vrijednosti prema dva atributa. Ako malo modificiramo tablicu (slučaj s desne strane), već ćemo dobiti neprazno preklapanje. U tom slučaju, redci 1 i 2 stvarno sadrže jednake vrijednosti prema atributima. Rod i Doktor.
Zatim će nam biti potrebno takvo poimanje kao veličina particije. Formalno:

Jednostavnije rečeno, veličina particije predstavlja broj klastera koji ulaze u particiju (ne zaboravimo, jedinični klasteri ne ulaze u particiju!):
Sada možemo odrediti jednu od ključnih lema koja za zadanih particija omogućava utvrđivanje, zadržava li se ovisnost ili ne:
Lema 1. Ovisnost A, B → C zadržava se onda i samo onda kada

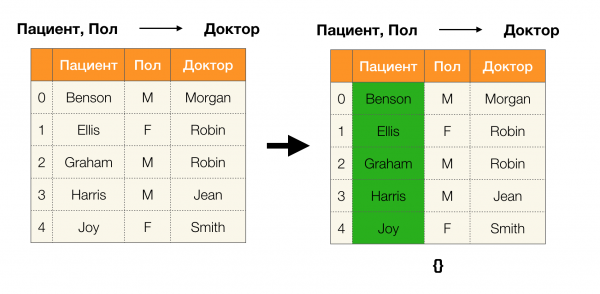
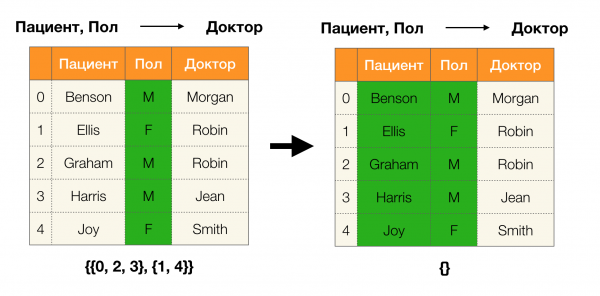
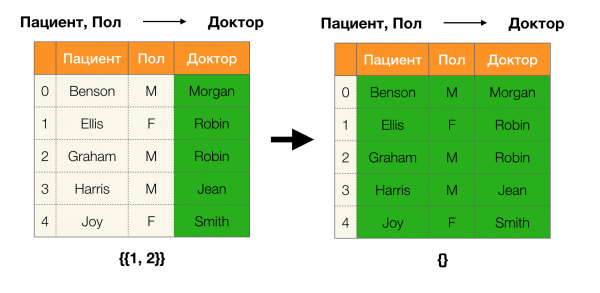
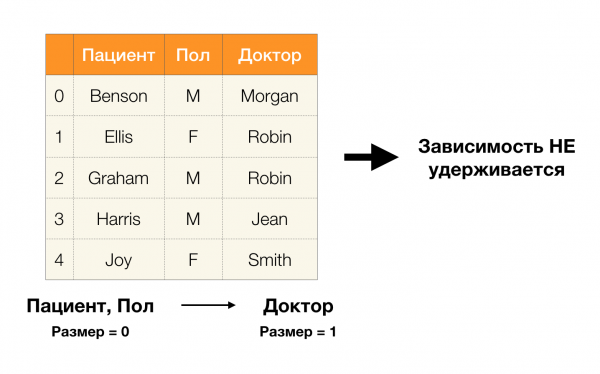
Prema lemi, za određivanje zadržava li se ovisnost, potrebno je izvršiti četiri koraka:
- Izračunati particiju za lijevu stranu ovisnosti
- Izračunati particiju za desnu stranu ovisnosti
- Izračunati produkt prvog i drugog koraka
- Usporediti veličine particija dobivenih na prvom i trećem koraku
Ispod je prikazan primjer provjere zadržava li se ovisnost prema ovoj lemi:
U ovom članku razmotrili smo takve pojmove kao funkcionalna ovisnost, približna funkcionalna ovisnost, razmotrili smo gdje se koriste, kao i koji algoritmi pretraživanja funkcionalnih ovisnosti postoje. Također smo detaljno obradili osnovne, ali važne pojmove, koji se aktivno koriste u modernim algoritmima pretraživanja funkcionalnih ovisnosti.
Linkovi na literaturu:
- Huhtala Y. i dr. TANE: Učinkovit algoritam za otkrivanje funkcionalnih i približnih ovisnosti // Računalni časopis. – 1999. – Vol. 42. – Br. 2. – Str. 100-111.
- Kruse S., Naumann F. Učinkovito otkrivanje približnih ovisnosti // Zbornik radova VLDB Endowments. – 2018. – Vol. 11. – Br. 7. – Str. 759-772.
- Papenbrock T., Naumann F. Hibridni pristup otkrivanju funkcionalnih ovisnosti // Zbornik radova 2016. međunarodne konferencije o upravljanju podacima. – ACM, 2016. – Str. 821-833.
- Papenbrock T. i dr. Otkrivanje funkcionalnih ovisnosti: Eksperimentalna evaluacija sedam algoritama // Zbornik radova VLDB Endowments. – 2015. – Vol. 8. – Br. 10. – Str. 1082-1093.
- Kumar A. i dr. Priključiti se ili ne?: Razmislite dvaput o priključcima prije odabira značajki // Zbornik radova 2016. međunarodne konferencije o upravljanju podacima. – ACM, 2016. – Str. 19-34.
- Abo Khamis M. i dr. Učenje unutar baze podataka s rijetkim tenzorima // Zbornik radova 37. ACM SIGMOD-SIGACT-SIGAI Simpozija o načelima sustava baza podataka. – ACM, 2018. – str. 325-340.
- Hellerstein J. M. i dr. MADlib analitička biblioteka: ili MAD vještine, SQL // Zbornik radova VLDB Endowmena. – 2012. – Vol. 5. – Broj 12. – str. 1700-1711.
- Qin C., Rusu F. Spekulativne aproksimacije za teraskalno distribuirano optimiziranje gradijentnog spuštanja // Zbornik radova Četvrte radionice o analitici podataka u oblaku. – ACM, 2015. – str. 1.
- Meng X. i dr. Mllib: Strojno učenje u apache spark // Časopis istraživanja strojnog učenja. – 2016. – Vol. 17. – Broj 1. – str. 1235-1241.
Autori članka: , istraživačica u , i , istraživačica u
Izvor: habr.com
