

Bok, Habr!
Pojesen prošle godine na Kaggleu održano je natjecanje u klasifikaciji ručno crtani slika Quick Draw Doodle Recognition, u kojem je između ostalog sudjelovao tim R stručnjaka u sastavu , i . Detaljno opisivati natjecanje nećemo, to je već učinjeno u .
S farmom medalja ovaj put nije uspjelo, ali stekli smo mnogo vrijednih iskustava, pa bismo htjeli zajednici ispričati o nekoliko najzanimljivijih i korisnih stvari na Kaggleu i u svakodnevnom radu. Među razmatranim temama: teški život bez OpenCV, parsiranje JSON-ova (na ovim primjerima razmatrane su integracije koda u C++ u skripte ili pakete u R putem Rcpp), parametarizacija skripti i dockerizacija konačnog rješenja. Sav kod iz poruke u upotrebljivom obliku dostupan je u .
Sadržaj:
1. Efikasno učitavanje podataka iz CSV u bazu MonetDB
Podaci u ovom natjecanju nisu pruženi u obliku gotovih slika, već u obliku 340 CSV datoteka (po jedna datoteka za svaku klasu), koje sadrže JSON-ove s koordinatama točaka. Povezujući te točke linijama, dobivamo konačnu sliku veličine 256x256 piksela. Također, za svaki unos navodi se oznaka je li slika ispravno prepoznata klasifikatorom korištenim u vrijeme prikupljanja skupa podataka, dvoznamenkasti kod zemlje prebivališta autora crteža, jedinstveni identifikator, oznaka vremena i naziv klase, koji se podudara s imenom datoteke. P pojednostavljena verzija izvora podataka teži 7.4 GB u arhivu i otprilike 20 GB nakon raspakiravanja, a potpuni podaci nakon raspakiravanja zauzimaju 240 GB. Organizatori su jamčili da obje verzije reproduciraju iste crteže, tj. puna verzija je suvišna. U svakom slučaju, pohrana 50 milijuna slika u slikovnim datotekama ili u obliku nizova odmah je proglašena nerentabilnom, i odlučili smo sve CSV datoteke iz arhiva train_simplified.zip smjestiti u bazu podataka s kasnijom generacijom slika potrebne veličine „u hodu“ za svaku seriju.
Kao RDBMS odabrana je dobro uspostavljena MonetDB, a točno implementacija za R u obliku paketa . Paket uključuje embedded verziju poslužitelja baze podataka i omogućava podizanje poslužitelja izravno iz R sesije te rad s njom. Kreiranje baze podataka i povezivanje s njom vrši se jednom naredbom:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Trebamo stvoriti dvije tablice: jednu za sve podatke, a drugu za informacije o učitanim datotekama (bit će korisna ako nešto pođe po zlu i proces se mora ponovo pokrenuti nakon učitavanja nekoliko datoteka):
Kreiranje tablica
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Najbrži način učitavanja podataka u bazu podataka bila je izravna kopija CSV datoteka putem SQL-a — naredba COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, gdje tablename je ime tablice i path je put do datoteke. Prilikom rada s arhivom otkriveno je da ugrađena implementacija unzip u R-u ne radi ispravno s nekim datotekama iz arhiva, pa smo koristili sustavni unzip (uz pomoć parametra getOption("unzip")).
Funkcija za zapis u bazu
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
U slučaju da je potrebno obraditi tablicu prije nego što se zapiše u bazu podataka, dovoljno je poslati funkciju u argument preprocess koja će obraditi podatke.
Kod za sekvencijalno učitavanje podataka u bazu:
Zapis podataka u bazu
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Vrijeme učitavanja podataka može varirati ovisno o brzinskim karakteristikama korištenog uređaja za pohranu. U našem slučaju, čitanje i pisanje unutar jednog SSD-a ili s USB sticka (izvorna datoteka) na SSD (baza podataka) traje manje od 10 minuta.
Još nekoliko sekundi potrebno je za kreiranje stupca s cjelobrojnim oznakama klase i stupca indeksa (ORDERED INDEX) s brojevima redaka, prema kojem će se vršiti odabir opažanja pri stvaranju batch-eva:
Kreiranje dodatnih stupaca i indeksa
poruka("Generiraj oznake")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

poruka("Generiraj redne brojeve")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Za rješavanje zadatka o formiranju serije "u hodu" morali smo postići maksimalnu brzinu izvlačenja nasumičnih redaka iz tablice doodles. Za to smo koristili 3 trikova. Prvi je bio smanjiti dimenzionalnost tipa u kojem se čuva ID promatranja. U izvornom skupu podataka za pohranu ID-a potreban je tip bigint, ali broj promatranja omogućava pohranu njihovih identifikatora, koji su jednaki rednom broju, u tip int. Pretraživanje pritom se odvija značajno brže. Drugi trik bilo je korištenje ORDERED INDEX — do ovog rješenja došli smo empirijski, isprobavajući sve dostupne . Treći je uključivao korištenje parametriziranih upita. Suština metode sastoji se u jednom izvođenju komande PREPARE uz kasnije korištenje pripremljenog izraza pri stvaranju niza identičnih upita, no u praksi je dobitak u usporedbi s jednostavnim SELECT bio na razini statističke pogreške.
Proces učitavanja podataka troši najviše 450 MB RAM-a. Drugim riječima, opisani pristup omogućava manipulaciju skupovima podataka težine u desecima gigabajta praktički na bilo kojem budžetskom hardveru, uključujući neka jednokontrolna računala, što je prilično impresivno.
Ostaje izvršiti mjerenja brzine ekstrakcije (nasumičnih) podataka i procijeniti skalabilnost prilikom odabira serija različitih veličina:
Benchmark baze podataka
library(ggplot2)

set.seed(0)
# Povezivanje s bazom podataka
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funkcija za pripremu upita na strani poslužitelja
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funkcija za dohvaćanje podataka
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Izvođenje mjerenja
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametri benchmarka
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("srednje vrijeme, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 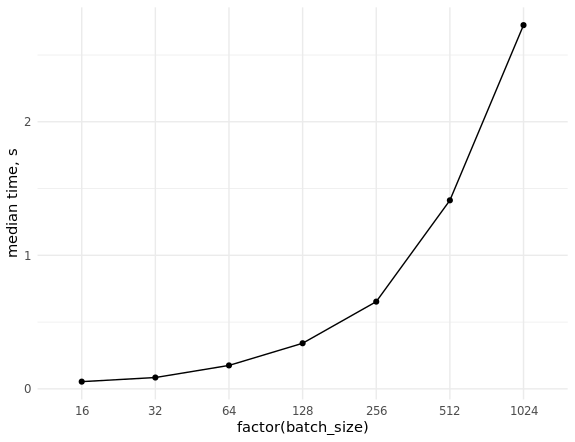
2. Priprema batch-ova
Cijeli proces pripreme batch-ova sastoji se od sljedećih faza:
- Parsiranje više JSON-ova koji sadrže vektore stringova s koordinatama točaka.
- Crtanje obojenih linija prema koordinatama točaka na slici odgovarajuće veličine (na primjer, 256×256 ili 128×128).
- Pretvaranje dobivenih slika u tenzor.
U okviru natjecanja među kernel-ima na Python-u, zadatak je dominantno rješen pomoću OpenCV. Jedan od najjednostavnijih i najočitijih analoga u R-u izgledat će na sljedeći način:
Implementacija pretvorbe JSON-a u tenzor u R-u
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsiranje JSON-a
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Brišemo privremenu datoteku na kraju funkcije
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Prazan graf
  plot.new()
  # Veličina prozora grafikona
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Boje linija
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Pretvaranje slike u trodimenzionalni niz
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Spajanje trodimenzionalnih nizova slika u četverodimenzionalni tenzor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Crtanje se obavlja standardnim sredstvima R-a, s pohranom u privremeni PNG koji se čuva u RAM-u (u Linuxu privremeni direktoriji R nalaze se u direktoriju /tmp, montiranom u RAM-u). Zatim se ta datoteka čita kao trodimenzionalni niz s brojevima u rasponu od 0 do 1. Ovo je važno, jer bi općenito prihvaćeniji BMP bio pročitan u raw-niz s hex-kodovima boja.
Testirajmo rezultat:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 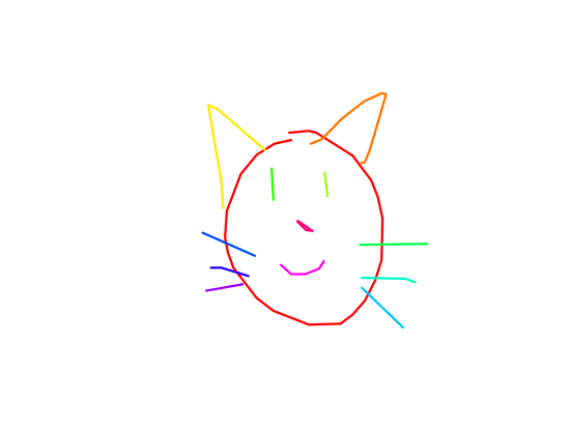
Sam batch će se formirati na sljedeći način:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Ova implementacija nam se činila neoptimalnom, jer formiranje velikih batch-eva traje nepristojno dugo, i odlučili smo se osloniti na iskustvo kolega koristeći moćnu biblioteku OpenCV. U to vrijeme nije bilo gotovog paketa za R (nema ga ni sada), stoga je napisana minimalna implementacija potrebne funkcionalnosti u C++ s integracijom u R kod pomoću Rcpp.
Za rješavanje zadatka korišteni su sljedeći paketi i biblioteke:
OpenCV za rad sa slikama i crtanje linija. Koristili smo prethodno instalirane sustavne biblioteke i zaglavlja, kao i dinamičko povezivanje.
xtensor za rad s višedimenzionalnim nizovima i tenzorima. Koristili smo zaglavlja uključena u istoimeni R paket. Biblioteka omogućuje rad s višedimenzionalnim nizovima, kako u rednom tako i u stupčastom redu.
ndjson za parsiranje JSON-a. Ova biblioteka se koristi u xtensor automatski ako je prisutna u projektu.
RcppThread za organizaciju višedretvene obrade vektora iz JSON-a. Koristili smo zaglavlja koja pruža ovaj paket. Od popularnijeg RcppParallel paket, između ostalog, razlikuje se po ugrađenom mehanizmu prekidanja petlje (interrupt).
Valja napomenuti da xtensor se pokazao kao pravo otkriće: osim što ima opsežnu funkcionalnost i visoke performanse, njegovi su programeri bili prilično odgovoreni i brzo i detaljno su odgovarali na postavljena pitanja. Uz njihovu pomoć, ostvarene su konverzije matrica OpenCV u tenzore xtensor, kao i način spajanja 3D tenzora slika u 4D tenzor ispravnih dimenzija (tj. batch).
Materijali za učenje Rcpp, xtensor i RcppThread
Za kompilaciju datoteka koje koriste sistemske datoteke i dinamičku vezu s instaliranim bibliotekama u sustavu, koristili smo mehanizam dodataka, realiziran u paketu Rcpp. Za automatsko pronalaženje putanja i zastavica koristili smo popularnu linux-utility pkg-config.
Implementacija Rcpp dodatka za korištenje biblioteke OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Moguća imena paketa
  pkg_config_name <- c("opencv", "opencv4")
  # Binarna datoteka alata pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Provjera dostupnosti alata u sustavu
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Provjera dostupnosti datoteke postavki OpenCV za pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Kao rezultat rada dodatka, tijekom kompilacije bit će umetnute sljedeće vrijednosti:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Kod implementacije parsiranja JSON-a i formiranja batcha za slanje u model prikazan je ispod spoiler-a. Prethodno dodajemo lokalni direktorij projekta za traženje zaglavlja datoteka (to je potrebno za ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementacija pretvorbe JSON-a u tenzor na C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Ovaj kod treba staviti u datoteku src/cv_xt.cpp i kompajlirati naredbom Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); također će biti potrebno nlohmann/json.hpp iz . Kod je podijeljen na nekoliko funkcija:
to_xt— templated funkcija za pretvorbu matrice slike (cv::Mat) u tenzorxt::xtensor;parse_json— funkcija koja parsira JSON-string, izvlači koordinate točaka, pakira ih u vektor;ocv_draw_lines— iz dobivenog vektora točaka crta raznobojne linije;process— kombinira gore opisane funkcije, kao i dodaje mogućnost skaliranja dobivene slike;cpp_process_json_str— omotač oko funkcijeprocess, koja izvozi rezultat u R-objekt (višedimenzionalni niz);cpp_process_json_vector— omotač oko funkcijecpp_process_json_str, koja omogućava obradu string vektora u višethread mode-u.
Za crtanje raznobojnih linija korištena je HSV boja model sa naknadnom konverzijom u RGB. Testirajmo rezultat:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 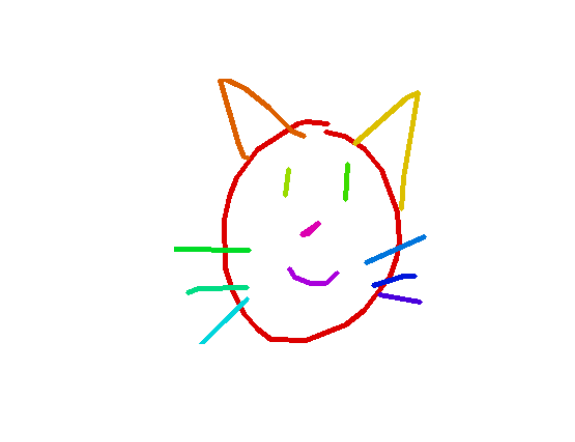
Poređenje brzine rada implementacija na R i C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parametri benchmarka
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Izvođenje mjerenja
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>         <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("medijan vrijeme, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 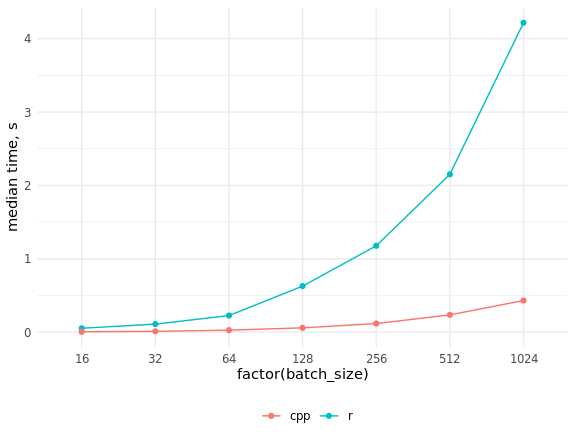
Kao što možemo vidjeti, povećanje brzine bilo je značajno, i nije moguće dostići C++ kod korištenjem paralelizacije R koda.
3. Iteratori za izvoz serija iz Baze podataka
R ima zasluženu reputaciju jezika za obradu podataka koji staju u RAM, dok je za Python karakteristična iterativna obrada podataka koja omogućuje jednostavno i opušteno provođenje out-of-core proračuna (proračuna koji koriste vanjsku memoriju). Klasičan i aktualan primjer takvih proračuna, relevantan za naš kontekst, su duboke neuronske mreže koje se treniraju metodom gradijentnog spuštanja s aproksimacijom gradijenta na svakom koraku prema maloj seriji opažanja ili mini-batchu.
Okviri za duboko učenje napisani u Pythonu imaju posebne klase koje implementiraju iteratore za podatke: tablice, slike u mapama, binarne formate itd. Može se koristiti gotove varijante ili pisati vlastiti za specifične zadatke. U R-u možemo iskoristiti sve mogućnosti Pythonove biblioteke keras s njegovim raznim backendovima pomoću istoimenog paketa, koji se, pak, koristi iznad paketa reticulate. Potonji zaslužuje poseban veći članak; ne samo da omogućuje pokretanje koda na Pythonu iz R-a, već i osigurava prijenos objekata između R i Python sesija, automatski obavljajući sve potrebne konverzije tipova.
Oslobodili smo se potrebe da pohranjujemo sve podatke u RAM zahvaljujući korištenju MonetDBLite, sav "neuronski" rad će obavljati izvorni kod na Pythonu, nama preostaje samo napisati iterator za podatke, budući da ne postoji gotov za takvu situaciju ni u R ni u Pythonu. Zahtjevi za njega su u biti samo dva: treba vraćati batch-eve u beskonačnom ciklusu i zadržati svoje stanje između iteracija (potonje se u R-u jednostavno ostvaruje pomoću zatvaranja). Prije je bilo potrebno izravno unutar iteratora pretvarati R nizove u numpy nizove, ali aktualna verzija paketa keras to radi sama.
Iterator za učiteljske i validacijske podatke ispao je sljedeći:
Iterator za učiteljske i validacijske podatke
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funkcija prima varijablu s povezivanjem na bazu podataka, brojeve korištenih redaka, broj klasa, veličinu batch-a, razmjer (scale = 1 odgovara crtanju slika 256x256 piksela, scale = 0.5 — 128x128 piksela), indikator boje (color = FALSE postavlja crtanje u nijansama sive, pri korištenju boja = TRUE svaki potez se crta novom bojom) i pokazatelj preprocesiranja za mreže, predtrenirane na imagenet-u. Posljednji je potreban za skaliranje vrijednosti piksela s intervala [0, 1] na interval [-1, 1], koji je korišten tijekom treninga isporučenih u sklopu keras modela.
Vanjska funkcija sadrži provjeru tipova argumenata, tablicu data.table s nasumično izmiješanim brojevima redaka iz samples_index i brojevima batch-ova, brojač i maksimalni broj batch-ova, kao i SQL izraz za izvoz podataka iz Baze podataka. Dodatno smo unutar odredili brzi ekvivalent funkcije keras::to_categorical(). Koristili smo gotovo sve podatke za obuku, ostavljajući pola posto za validaciju, pa su veličine epoha bile ograničene parametrima steps_per_epoch pri pozivu keras::fit_generator(), a uvjet if (i > max_i) aktivirao se samo za validacijski iterator.
Unutar funkcije se vrši odabir indeksa redaka za sljedeći batch, izvoz zapisa iz Baze podataka uz povećanje brojača batch-ova, parsiranje JSON-ova (funkcija cpp_process_json_vector(), napisana u C++) i stvaranje nizova koji odgovaraju slikama. Zatim se stvaraju one-hot vektori s oznakama klasa, nizovi s vrijednostima piksela i s oznakama spajaju u listu, koja je povratna vrijednost. Za ubrzanje rada korišteno je stvaranje indeksa u tablicama data.table i modifikacija po referenci — bez tih "trikova" paketa data.table bilo bi prilično teško zamisliti učinkovito rukovanje s nekim značajnim količinama podataka u R.
Rezultati mjerenja brzine rada na prijenosnom računalu Core i5 izgledaju ovako:
Benchmark iteratora
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indeksi za obučavanje
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indeksi za validaciju
val_ind <- ind[-train_ind]
rm(ind)
# Faktor skaliranja
scale <- 0.5

# Izvršavanje mjerenja
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Parametri benchmarka
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("medijan vremena, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 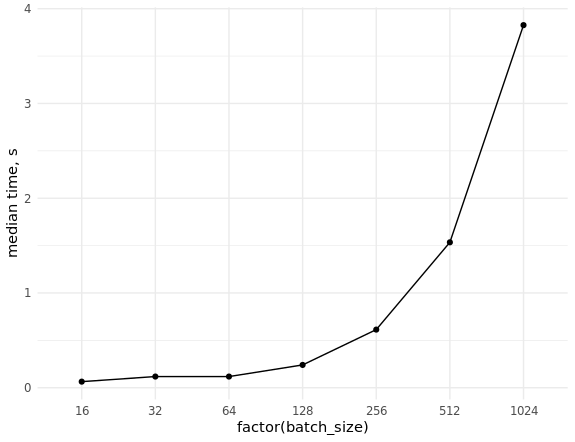
Ako imate dovoljno RAM-a, možete značajno ubrzati rad baze podataka transferom u taj RAM (za naš zadatak dovoljno je 32 GB). U Linuxu se po defaultu montira particija /dev/shm, koja zauzima do polovice kapaciteta RAM-a. Možete odrediti i više, uređujući /etc/fstab, kako bi izgledao zapis tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Obavezno restartajte i provjerite rezultat izvršavajući komandu df -h.
Iterators for test data are much simpler since the test dataset fits entirely in RAM:
Iterator for test data
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Odabir arhitekture modela
Prva od korištenih arhitektura bila je , čije su karakteristike obrađene u izvještaju. Ona dolazi u standardnoj instalaciji keras i, shodno tome, dostupna je u istoimenom paketu za R. Međutim, prilikom pokušaja korištenja s jednocanalnim slikama otkriveno je nešto neobično: ulazni tenzor mora uvijek imati dimenzije (batch, height, width, 3), što znači da broj kanala ne može biti promijenjen. U Pythonu takvog ograničenja nema, stoga smo požurili i napisali svoju implementaciju te arhitekture, slijedeći izvorni članak (bez dropout-a, koji postoji u Keras varijanti):
Arhitektura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Nedostaci ovog pristupa su očiti. Želimo testirati mnogo modela, a ne želimo svaki arhitekturu prepisivati ručno. Također, bili smo lišeni mogućnosti korištenja težina modela prethodno obučavanih na imagenet-u. Kao i obično, pomoglo je proučavanje dokumentacije. Funkcija get_config() omogućuje dobivanje opisa modela u obliku pogodnom za uređivanje (base_model_conf$layers — običan R-ov popis), a funkcija from_config() izvodi obrnutu transformaciju u modelski objekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Sada nije teško napisati univerzalnu funkciju za dobivanje bilo kojeg od modela koji su proizvedeni keras s unaprijed naučenim težinama iz imageneta ili bez njih:
Funkcija za učitavanje gotovih arhitektura
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Provjera argumenata
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Dobivanje objekta iz paketa keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Provjera postojanja objekta u paketu
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " not found.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Ako slika nije u boji, mijenjamo dimenzije ulaza
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Pri korištenju jednostrukih slika unaprijed naučene težine se ne koriste. To bi se moglo ispraviti: pomoću funkcije get_weights() dobiti težine modela u obliku popisa R-ovskih nizova, promijeniti dimenziju prvog elementa tog popisa (uzimajući neki jedan kanal boje ili prosječivši sve tri), a zatim ponovo učitati težine u model funkcijom set_weights(). Ovu funkcionalnost nismo dodali, budući da je u ovoj fazi već bilo jasno da je produktivnije raditi s obojenim slikama.
Većinu eksperimenata proveli smo koristeći mobilenet verzije 1 i 2, kao i resnet34. U ovom natjecanju dobro su se pokazale moderne arhitekture, poput SE-ResNeXt. Nažalost, nismo imali gotove implementacije, niti smo napisali svoje (ali ćemo obavezno napisati).
5. Parametrizacija skripti
Za praktičnost, sav kod za pokretanje učenja organiziran je u obliku jedne skripte, parametrizirane pomoću na sljedeći način:
doc <- '
Korištenje:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Opcije:
  -h --help                   Prikaži ovu poruku.
  -l --list-models            Prikaži dostupne modele.
  -m --model=          Ime modela neuronske mreže [default: mobilenet_v2].
  -b --batch-size=      Veličina serije [default: 32].
  -s --scale-factor=   Faktor skaliranja [default: 0.5].
  -c --color                  Koristi boje linija [default: FALSE].
  -d --db-dir=          Putanja do direktorija baze podataka [default: Sys.getenv("db_dir")].
  -r --validate-ratio= Omjer uzoraka za validaciju [default: 0.995].
  -n --n-gpu=         Broj GPU-a [default: 1].
'
args <- docopt::docopt(doc)
Pakets docopt predstavlja implementaciju za R. Njime se skripte pokreću jednostavnim naredbama poput Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db ili ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, ako je datoteka train_nn.R izvršna (ova naredba će pokrenuti učenje modela resnet50 na trobojnim slikama dimenzija 128x128 piksela, baza podataka mora biti u mapi /home/andrey/doodle_db). Na popis se mogu dodati brzina učenja, vrsta optimizatora i bilo koji drugi prilagodljivi parametri. Tijekom pripreme objave saznali smo da arhitektura mobilenet_v2 iz aktualne verzije keras u R-u se zbog neuzetih u obzir promjena u R-paketu — čekamo da to isprave.
Ovaj pristup omogućio je znatno ubrzanje eksperimenata s različitim modelima u usporedbi s tradicionalnijim pokretanjem skripti u RStudiju (kao moguću alternativu naglašavamo paket ). Ali glavna prednost leži u mogućnosti jednostavnog upravljanja pokretanjem skripti u Dockeru ili jednostavno na poslužitelju, bez potrebe za instalacijom RStudija.
6. Dockerizacija skripti
Koristili smo Docker s ciljem osiguravanja prenosivosti okruženja za učenje modela među članovima tima i za brzo implementiranje u oblaku. Upoznajte se s ovim relativno neobičnim alatom za programere u R-u putem serije objava ili putem .
Docker omogućuje stvaranje vlastitih slika od nule, kao i korištenje drugih slika kao osnove za izradu vlastitih. Nakon analize dostupnih opcija, zaključili smo da je instalacija NVIDIA upravljačkih programa, CUDA+cuDNN i Python biblioteka - prilično opsežan dio slike, te smo odlučili uzeti službenu sliku kao osnovu. tensorflow/tensorflow:1.12.0-gpu, dodajući potrebne R pakete.
Konačna Docker datoteka izgledala je ovako:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Za praktičnost, korišteni paketi su smješteni u varijable; veći dio napisanih skripti kopira se unutar kontejnera tijekom izrade. Također, promijenili smo ljusku naredbi na /bin/bash radi lakšeg korištenja sadržaja /etc/os-release. To je omogućilo izbjegavanje potrebe za navođenjem verzije OS-a u kodu.
Osim toga, napisan je mali bash skript koji omogućuje pokretanje kontejnera s raznim naredbama. Na primjer, to mogu biti skripte za treniranje neuronskih mreža, ranije smještene unutar kontejnera, ili ljuska za otklanjanje grešaka i praćenje rada kontejnera:
Skript za pokretanje kontejnera
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Ako se ova bash skripta pokrene bez parametara, unutar kontejnera će se pozvati skripta train_nn.R s podrazumevanim vrednostima; ako je prvi pozicioni argument "bash", kontejner će se pokrenuti u interaktivnom režimu sa komandnom ljuskom. U svim ostalim slučajevima dolazi do zamene pozicijskih argumenata: CMD="Rscript /app/train_nn.R $@".
Vredno je napomenuti da se direktorijumi sa izvorim podacima i bazom podataka, kao i direktorijum za čuvanje obučenih modela montiraju unutar kontejnera iz hostske sistema, što omogućava pristup rezultatima rada skripti bez suvišnih manipulacija.
7. Korišćenje više GPU-a u oblaku Google Cloud
Jedna od karakteristika takmičenja bili su veoma bučni podaci (vidi naslovnu sliku, posuđenu od @Leigh.plt iz ODS Slack-a). Borba sa tim pomaže korišćenju velikih batch-ova, i nakon eksperimenata na računaru sa 1 GPU odlučili smo se za obučavanje modela na više GPU-a u oblaku. Koristili smo Google Cloud () zbog širokog izbora dostupnih konfiguracija, prihvatljivih cena i poklon $300. Iz pohlepe smo naručili instance sa 4xV100 s SSD-om i mnogo RAM-a, i to se pokazalo kao velika greška. Takav uređaj brzo troši novac, a eksperimentisanje bez dobro razvijenog pipelina može vas upropastiti. Za obrazovne svrhe bolje je uzeti K80. Ali velika količina RAM-a se pokazala korisnom — cloud SSD nije impresionirao brzinom, pa smo bazu podataka pri svakom pokretanju instance prenosili na dev/shm.
Najveći interes ima kod koji je odgovoran za korišćenje više GPU-a. Prvo se model kreira na CPU koristeći menadžera konteksta, baš kao u Pythonu:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics = (top_3_categorical_accuracy,
    compile = FALSE
  )
})
Nakon toga, nekompajlirani (to je važno) model se kopira na zadati broj dostupnih GPU-a, i tek nakon toga se kompajlira:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Klasičan pristup sa zamrzavanjem svih slojeva, osim poslednjeg, obučavanjem poslednjeg sloja, odmrzavanjem i ponovnim obučavanjem celog modela za više GPU-a nije mogao da se realizuje.
Praćenje obuke je vršeno bez korišćenja tensorboard, ograničivši se na zapisivanje logova i čuvanje modela s informativnim imenima nakon svake epohe:
Kolbe
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Umjesto zaključka
Nekoliko problema s kojima smo se suočili, još nismo uspjeli riješiti:
- u keras nema gotove funkcije za automatsko pronalaženje optimalne brzine učenja (analog
lr_finderu biblioteci fast.ai); uz malo truda, moguće je portirati na R strane implementacije, na primjer, ; - kao posljedica prethodne točke, nije bilo moguće odabrati pravu brzinu učenja prilikom korištenja više GPU-a;
- nedostaju moderna arhitektura neuronskih mreža, posebno one unaprijed obučene na imagenetu;
- nema one cycle policy i diskriminativne stope učenja (cosine annealing po našem zahtjevu je bio , hvala ).
Što se korisnog uspjelo izvući iz ovog natjecanja:
- Na relativno slaboj opremi može se bez problema raditi s pristojnim (mnogo većim od veličine RAM-a) količinama podataka. Paket data.table štedi memoriju pomoću in-place modifikacije tablica, što omogućava izbjegavanje njihovog kopiranja, a uz pravilnu upotrebu njegovih mogućnosti gotovo uvijek pokazuje najveću brzinu među svim alatima za skriptne jezike koje poznajemo. Spremanje podataka u bazu podataka omogućava u mnogim slučajevima da uopće ne razmišljate o potrebi da stisnete cijeli skup podataka u RAM.
- Spore funkcije na R mogu se zamijeniti brzim na C++ pomoću paketa Rcpp. Ukoliko dodatno koristimo RcppThread ili RcppParallel, dobivamo cross-platformske višethreaded implementacije, stoga kod na razini R nije potrebno paralelizirati.
- Paket Rcpp može se koristiti bez ozbiljnog poznavanja C++, potrebne osnove su izložene . Header datoteke za nekoliko vrhunskih C biblioteka, poput xtensor , dostupne su na CRAN-u, dakle formira se infrastruktura za implementaciju projekata koji integriraju u R gotov visokoučinkovit C kod. Dodatna pogodnost — isticanje sintakse i statički analizator koda na C++ u RStudio.
- docopt omogućava pokretanje samostalnih skripti s parametrima. Ovo je praktično za korištenje na udaljenom serveru, uključujući pod dockerom. U RStudio nije praktično provoditi višesatne eksperimente s obukom neuronskih mreža, a ni sama instalacija IDE-a na serveru nije uvijek opravdana.
- Docker osigurava prenosivost koda i ponovljivost rezultata među programerima s različitim verzijama operativnih sustava i biblioteka, kao i jednostavnost pokretanja na poslužiteljima. Cijeli proces učenja može se pokrenuti s samo jednom naredbom.
- Google Cloud je pristupačan način za eksperimentiranje na skupom hardveru, ali je važno pažljivo odabrati konfiguracije.
- Mjerenje brzine rada pojedinih dijelova koda vrlo je korisno, osobito u kombinaciji R i C++, a s paketom bench — još i vrlo jednostavno.
Sve u svemu, ovo iskustvo bilo je vrlo korisno, a mi nastavljamo raditi na rješavanju nekih od spomenutih problema.
Izvor: habr.com
