

Kod programskih proizvoda za strojno učenje često je složen i prilično zbunjujuć. Otkrivanje i otklanjanje grešaka u njemu — zahtijevan je zadatak. Čak i najjednostavnije zahtijevaju ozbiljan pristup mrežnoj arhitekturi, inicijalizaciji težina, optimizaciji mreže. Mala greška može dovesti do neugodnih problema.
Ovaj članak posvećen je algoritmu za ispravljanje grešaka vaših neuronskih mreža.
Skillbox preporučuje: Praktični tečaj .
Podsjećamo: za sve čitatelje "Habra" — popust od 10 000 rubalja prilikom upisa na bilo koji tečaj Skillbox uz promo kod "Habr".
Algoritam se sastoji od pet koraka:
- jednostavni početak;
- potvrđivanje gubitaka;
- provjera privremenih rezultata i veza;
- dijagnostika parametara;
- kontrola rada.
Ako vam se nešto čini zanimljivijim od ostalog, možete odmah prijeći na te odjeljke.
Jednostavni početak
Teže je ispravljati neuronsku mrežu sa složenom arhitekturom, regularizacijom i planerom brzine učenja, nego običnu. Pomalo se zavaravamo, jer se sam korak za ispravak samo posredno odnosi, ali to je ipak važna preporuka.
Jednostavni početak sastoji se od stvaranja pojednostavljene modela i njezina učenja na jednom skupu (točki) podataka.
Prvo stvaramo pojednostavljeni model
Za brz početak stvorite malu mrežu s jednim skrivenim slojem i provjerite da sve radi ispravno. Zatim postupno komplicirajte model, provjeravajući svaki novi aspekt njegove strukture (dodatni sloj, parametar itd.), i idite dalje.
Obučavamo model na jednom skupu (točki) podataka
Kao brzu provjeru funkcionalnosti vašeg projekta možete koristiti jednu ili dvije točke podataka kako biste potvrdili funkcionira li sustav ispravno. Neuronska mreža bi trebala pokazati 100% točnost učenja i provjere. Ako to nije slučaj, ili je model previše mali, ili već imate grešku.
Čak i ako je sve u redu, pripremite model za prolazak jedne ili više epoha prije nego što idete dalje.
Procjena gubitaka
Procjena gubitaka je osnovni način za fokusiranje na performanse modela. Morate se pobrinuti da gubitak odgovara zadatku, a funkcije gubitka se procjenjuju prema ispravnoj skali. Ako koristite više od jednog tipa gubitka, provjerite jesu li svi istog reda i ispravno skalirani.
Važno je obratiti pažnju na početne gubitke. Provjerite koliko su stvarni rezultati blizu očekivanim, ako je model krenuo s nasumičnom pretpostavkom. U : „Provjerite dobivate li rezultate koje očekujete kada započnete s malim brojem parametara. Bolje je odmah provjeriti gubitak podataka (postavljanjem razine regularizacije na nulu). Na primjer, za CIFAR-10 s klasifikatorom Softmax očekujemo da će početni gubici biti 2.302, jer očekivana difuzna vjerojatnost iznosi 0,1 za svaku klasu (budući da postoji 10 klasa), a gubitak Softmax je negativna logaritamska vjerojatnost ispravne klase, kao –ln(0.1) = 2.302“.
Za binarni primjer, samo se provodi sličan izračun za svaku od klasa. Evo, na primjer, podaci: 20% 0 i 80% 1. Očekivani početni gubitak bit će do –0,2ln(0,5) –0,8ln(0,5) = 0,693147. Ako je rezultat veći od 1, to može ukazivati na to da težine neuronske mreže nisu pravilno uravnotežene ili da podaci nisu normalizirani.
Provjeravamo međurezultate i veze
Za debugiranje neuronske mreže potrebno je razumjeti dinamiku procesa unutar mreže i ulogu pojedinih međuslojnih slojeva, budući da su povezani. Evo tipičnih grešaka s kojima se možete susresti:
- pogrešni izrazi za ažuriranje gradijenata;
- ažuriranja težina se ne primjenjuju;
- nestajući ili eksplozivni gradijenti (exploding gradients).
Ako su vrijednosti gradijenata nulte, to znači da je brzina učenja u optimizatoru preniska ili da ste se suočili s pogrešnim izrazom za ažuriranje gradijenta.
Osim toga, potrebno je pratiti vrijednosti funkcija aktivacije, težina i ažuriranja svakog od slojeva. Na primjer, veličina ažuriranja parametara (težina i pomaka) .
Postoji fenomen poznat kao “Dying ReLU” ili , kada neuroni ReLU proizvode nulu nakon učenja velike negativne vrijednosti (bias) pomaka za svoje težine. Ovi neuroni se više nikada ne aktiviraju ni u jednom dijelu podataka.
Možete koristiti provjeru gradijenta za identifikaciju ovih grešaka aproksimacijom gradijenta koristeći numerički pristup. Ako je blizu izračunatim gradijentima, onda je povratno širenje pravilno реализовано. Da biste stvorili provjeru gradijenta, upoznajte se s ovim odličnim resursima iz CS231 i , kao i s Andrews Nga o ovoj temi.
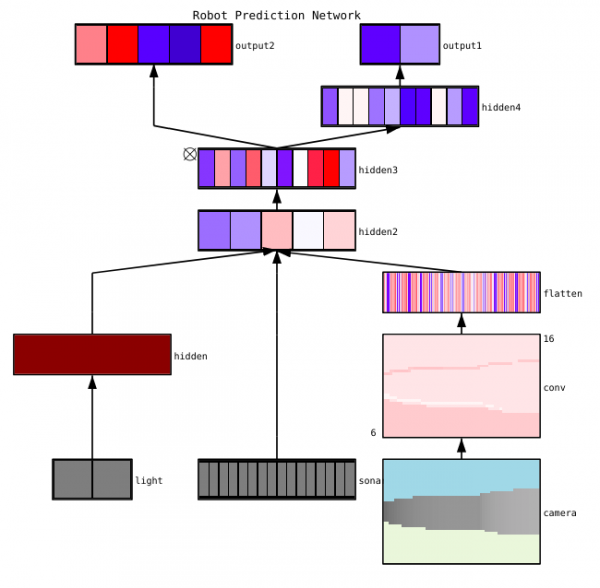
navodi tri glavne metode vizualizacije neuronske mreže:
- Preliminarne — jednostavne metode koje nam pokazuju opću strukturu obučene mreže. One uključuju prikaz oblika ili filtara pojedinačnih slojeva neuronske mreže i parametara u svakom sloju.
- Na temelju aktivacije. U njima dekodiramo aktivacije pojedinačnih neurona ili grupa neurona kako bismo razumjeli njihove funkcije.
- Na temelju gradijenata. Ove metode imaju tendenciju manipulirati gradijentima koji se formiraju iz unaprijednog i unazadnog prolaza tijekom obuke modela (uključujući karte važnosti i karte aktivacije klase).
Postoji nekoliko korisnih alata za vizualizaciju aktivacija i veza pojedinačnih slojeva, poput i .
Dijagnostika parametara
Neuronske mreže imaju brojne parametre koji međusobno djeluju, što otežava optimizaciju. U suštini, ovaj odjeljak predstavlja predmet aktivnih istraživanja stručnjaka, stoga bi sljedeći savjeti trebali biti smatrani samo kao preporuke, početne točke od kojih možete krenuti.
Veličina paketa (batch size) — potrebno je da veličina paketa bude dovoljno velika za dobivanje točnih procjena gradijenta pogreške, ali dovoljno mala da stohastički gradijentni spust (SGD) može organizirati vašu mrežu. Male veličine paketa dovest će do brze konvergencije zbog buke u procesu učenja i kasnije — do poteškoća u optimizaciji. Više o tome opisano je .
Brzina učenja — previše niska će dovesti do sporog konvergiranja ili rizika od zastoja u lokalnim minimumima. S druge strane, visoka brzina učenja izazvat će divergenciju optimizacije, jer riskirate 'preskočiti' duboki, ali uži dio funkcije gubitka. Pokušajte koristiti planiranje brzine kako biste je smanjili tijekom učenja neuronske mreže. U tečaju CS231n .
Ograničavanje gradijenta— ograničavanje gradijenata parametara tijekom unazadne propagacije na maksimalnu vrijednost ili graničnu normu. Korisno za rješavanje problema s eksplodirajućim gradijentima s kojima se možete susresti u trećem stavku.
Batch normalizacija — koristi se za normalizaciju ulaznih podataka svakog sloja, što pomaže u rješavanju problema unutarnjeg pomaka kovarijante. Ako koristite Dropout i Batch Normalization zajedno, .
Stohastički gradijentni spust (SGD) — postoji nekoliko vrsta SGD-a koji koriste impuls, adaptivne brzine učenja i Nesterov metod. Pri tome nijedna od njih nema očitu prednost ni u učinkovitosti učenja ni u generalizaciji ().
Regulacija — ključna je za izgradnju modela koji se može generalizirati, budući da dodaje kaznu za složenost modela ili ekstremne vrijednosti parametara. To je način smanjenja varijance modela bez značajnog povećanja njegove pristranosti. Više .
Da biste sami sve procijenili, morate isključiti regulaciju i samostalno provjeriti gradijent gubitka podataka.
Dropout — još jedna metoda organiziranja vaše mreže za sprječavanje preopterećenja. Tijekom učenja, dropout se provodi samo održavanjem aktivnosti neurona s određenom vjerojatnošću p (hiperparametar) ili postavljanjem na nulu u suprotnom slučaju. Kao rezultat, mreža mora koristiti različitu podskupinu parametara za svaku učionicu, što smanjuje promjene određenih parametara koji postaju dominantni.
Važno: ako koristite i dropout i batch normalizaciju, budite oprezni s redoslijedom ovih operacija ili čak s njihovom zajedničkom upotrebom. Sve to se još aktivno raspravlja i dopunjuje. Evo dvije važne rasprave o ovoj temi i .
Nadzor rada
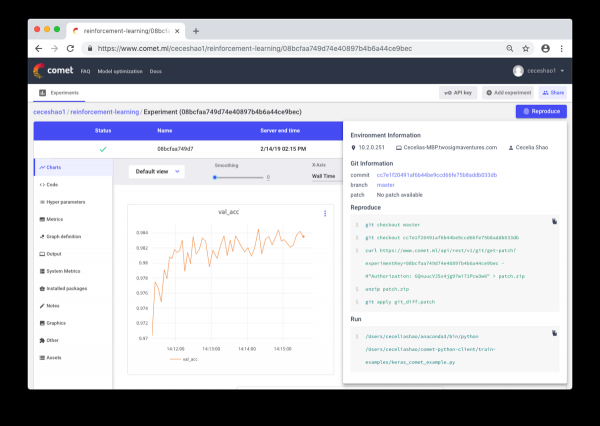
Radi se o dokumentiranju radnih procesa i eksperimenata. Ako ništa ne dokumentirate, lako možete zaboraviti, na primjer, koja se brzina učenja ili težina klasa koristi. Kontrolom možete besprijekorno pregledavati i reproducirati prethodne eksperimente. To omogućuje smanjenje broja dupliciranih eksperimenata.
Istina, ručno dokumentiranje može postati složen zadatak u slučaju velikog obima rada. Ovdje pomažu alati poput Comet.ml, koji automatski logiraju skupove podataka, izmjene koda, povijest eksperimenata i proizvode modele, uključujući ključne informacije o vašem modelu (hiperparametri, performanse modela i podaci o okruženju).
Neuralna mreža može biti prilično osjetljiva na male promjene, što može dovesti do pada performansi modela. Praćenje i dokumentiranje rada prvi su korak koji treba poduzeti za standardizaciju okruženja i modeliranje.
Nadam se da će ova objava poslužiti kao polazišna točka za debagiranje vaše neuronske mreže.
Skillbox preporučuje:
- Dvoipogodišnji praktični tečaj .
- Online tečaj .
- Praktični godišnji tečaj .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish