

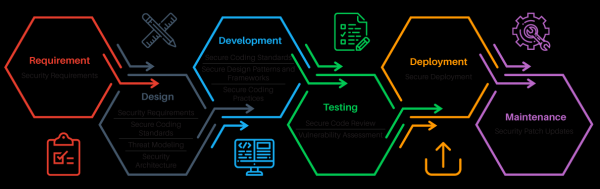
U okviru profesionalnih aktivnosti, programeri, pentesteri i stručnjaci za sigurnost se suočavaju s procesima poput upravljanja ranjivostima (VM) i (sigurnog) SDLC-a.
Iza ovih pojmova kriju se razni setovi praksi i korištenih alata, koji su isprepleteni, iako su njihovi korisnici različiti.
Tehnički napredak još uvijek nije dostigao točku u kojoj bi jedan alat mogao zamijeniti čovjeka u analizi sigurnosti infrastrukture i softvera.
Zanimljivo je razumjeti zašto je to tako i s kojim se problemima suočavaju.
Procesi
Proces upravljanja ranjivostima („Vulnerability Management“) namijenjen je kontinuiranom praćenju sigurnosti infrastrukture i upravljanju zakrpama.
Proces sigurnog SDLC-a („Secure SDLC“) namijenjen je podršci sigurnosti aplikacije tijekom razvoja i eksploatacije.
Sličan dio ovih procesa je proces procjene ranjivosti — skeniranja na ranjivosti.
Glavna razlika u skeniranju u okviru VM i SDLC-a je ta što je cilj u prvom slučaju otkriti poznate ranjivosti u trećem softveru ili u konfiguraciji. Na primjer, zastarjela verzija Windowsa ili zadnja community-string za SNMP.
U drugom slučaju, cilj je otkriti ranjivosti ne samo u vanjskim komponentama (ovisnostima), već prvenstveno u kodu novog proizvoda.
To uzrokuje razlike u alatima i pristupima. Po mom mišljenju, zadatak pronalaženja novih ranjivosti u aplikaciji značajno je zanimljiviji, jer se ne svodi samo na otisak verzija, prikupljanje bannera, pokušavanje lozinki itd.
Za kvalitetno automatizirano skeniranje ranjivosti aplikacija potrebni su algoritmi koji uzimaju u obzir semantiku aplikacije, njenu svrhu i specifične prijetnje.
Infrastrukturni skener se često može zamijeniti tajmerom, kako je to izrazio . Smisao je u tome da možete statistički smatrati svoju infrastrukturu ranjivom ako je niste ažurirali, recimo, mjesec dana.
Alati
Skeniranje, kao i analiza sigurnosti, može se provoditi kao crna kutija, tako i kao bijela kutija.
Crna kutija
Pri blackbox skeniranju alat treba biti sposoban raditi s uslugom putem istih sučelja koja koriste korisnici.
Skenirnici infrastrukture (Tenable Nessus, Qualys, MaxPatrol, Rapid7 Nexpose itd.) traže otvorene mrežne portove, prikupljaju „banere“, određuju verzije instaliranog softvera i traže u svojoj bazi podataka informacije o ranjivostima tih verzija. Također pokušavaju otkriti greške u konfiguraciji, kao što su zadani lozinke ili otvoreni pristup podacima, slabi SSL šifriranja itd.
Skenirnici web-aplikacija (Acunetix WVS, Netsparker, Burp Suite, OWASP ZAP itd.) također mogu odrediti poznate komponente i njihove verzije (na primjer, CMS, okvire, JS biblioteke). Glavni koraci skenera su crawling i fuzzing.
Tijekom crawlanja skener prikuplja informacije o postojećim sučeljima aplikacije, HTTP parametrima. Tijekom fuzzinga u sve otkrivene parametre unose se mutirani ili generirani podaci s ciljem izazivanja greške i otkrivanja ranjivosti.
Takvi skeneri aplikacija pripadaju klasama DAST i IAST — odnosno Dinamičko i Interaktivno testiranje sigurnosti aplikacija.
White Box
Pri whitebox skeniranju razlika je više.
U procesu VM skeniranja (Vulners, Incsecurity Couch, Vuls, Tenable Nessus itd.) skeneri često dobivaju pristup sustavima, provodeći autentificirano skeniranje. Tako skener može preuzeti instalirane verzije paketa i konfiguracijske parametre izravno iz sustava, ne nagađajući ih na temelju banera mrežnih usluga.
Skeniranje postaje preciznije i potpunije.
Ako govorimo o whitebox skeniranju (CheckMarx, HP Fortify, Coverity, RIPS, FindSecBugs itd.) aplikacija, obično se radi o statičkoj analizi koda i korištenju odgovarajućih alata klase SAST — Statčko testiranje sigurnosti aplikacija.
Problemi
Postoji mnogo problema sa skeniranjem! Većinu njih osobno susrećem tijekom pružanja usluge izgradnje procesa skeniranja i sigurne razvojne, kao i prilikom rada na analizi sigurnosti.
Izdvojit ću 3 glavne grupe problema koje potvrđuju razgovori s inženjerima i rukovoditeljima službi za IB u raznim kompanijama.
Problemi sa skeniranjem web-aplikacija
- Teškoće u implementaciji. Skeneri se moraju postaviti, konfigurirati i prilagoditi za svaku aplikaciju, odvojiti testno okruženje za skeniranje i implementirati u CI/CD proces kako bi to bilo učinkovito. Inače će to biti beskoristan formalni postupak koji će davati samo lažne signale.
- Trajanje skeniranja. Skeneri čak ni 2019. nisu dobro upravljali deduplifikacijom sučelja i mogu satima skenirati tisuću stranica s 10 parametara na svakoj, smatrajući ih različitim, iako za njih odgovara isti kod. Pri tome je potrebno brzo donijeti odluku o deployu u produkciju unutar razvojnog ciklusa.
- Osnovne preporuke. Skeneri daju dovoljno općenite preporuke, a ne može uvijek developer brzo razumjeti kako smanjiti razinu rizika, a najvažnije, treba li to učiniti odmah ili može malo pričekati.
- Destruktivni utjecaj na aplikaciju. Skeneri mogu izvesti DoS napad na aplikaciju, kao i stvoriti veliki broj entiteta ili promijeniti postojeće (na primjer, kreirati desetke tisuća komentara na blogu), tako da ne treba bez razmišljanja pokretati skeniranje u produkciji.
- Niska kvaliteta otkrivanja ranjivosti. Skeneri obično koriste fiksni skup korisnih opterećenja ('payloads') i mogu lako propustiti ranjivost koja ne odgovara poznatom scenariju ponašanja aplikacije.
- Nesporazum skenera o funkcijama aplikacije. Skeneri sami po sebi ne znaju što je 'internet-bankarstvo', 'plaćanje', 'komentar'. Za njih postoje samo linkovi i parametri, tako da ogroman spektar mogućih ranjivosti poslovne logike ostaje potpuno nezaštićen, ne shvaćaju kako izvršiti dvostruku naplatu, vidjeti tuđe podatke po ID-u ili manipulisati saldom kroz zaokruživanje.
- Nesporazum skenera o semantici stranica. Skeneri ne znaju čitati FAQ, ne prepoznaju captcha, sami po sebi ne mogu shvatiti kako se registrirati, i da se treba ponovno prijaviti, da se ne smije kliknuti 'odjava', i kako treba potpisivati zahtjeve prilikom promjene vrijednosti parametara. Kao rezultat, veliki dio aplikacije može potpuno ostati neistražen.
Problemi skeniranja izvornog koda.
- Lažni signali. Statička analiza je složen posao koji često zahtijeva mnoštvo kompromisa. Često se mora žrtvovati točnost, a čak i skupi enterprise skeneri generiraju ogromne količine lažnih pozitivnih rezultata.
- Teškoće u implementaciji. Kako bi se povećala točnost i cjelovitost statičke analize, potrebno je nadograditi pravila skeniranja, a pisanje tih pravila može biti previše zahtjevno. Ponekad je lakše pronaći sva mjesta u kodu s određenim greškama i ispraviti ih nego pisati pravilo za detekciju takvih slučajeva.
- Nedostatak podrške za ovisnosti. Veliki projekti ovise o velikom broju biblioteka i frameworka koji proširuju mogućnosti programskog jezika. Ako u bazi znanja skenera nema informacija o opasnim mjestima ('sinks') u tim frameworkima, to postaje slijepa točka, a skener jednostavno neće moći razumjeti kod.
- Trajanje skeniranja. Traženje ranjivosti u kodu je složen zadatak, čak i u terminima algoritama. Stoga proces može trajati duže i zahtijevati značajne računalne resurse.
- Low coverage. Unatoč potrošnji resursa i dugotrajnosti skeniranja, programeri SAST alata često se moraju odlučiti za kompromis i ne analizirati sve stanje u kojem se program može nalaziti.
- Reproducibility of findings. Upućivanje na određenu liniju i stog poziva koji dovodi do ranjivosti je izvrsno, ali često skener ne daje dovoljno informacija kako bi se vanjski provjerila prisutnost ranjivosti. Naime, nedostatak može biti i u mrtvom kodu, koji napadač ne može doseći.
Problemi skeniranja infrastrukture.
- Nedovoljna inventarizacija. U velikim infrastrukturnim postavkama, posebno geografskim podijeljenim, često je najteže shvatiti koji se hostovi trebaju skenirati. Drugim riječima, zadatak skeniranja usko je povezan s upravljanjem imovinom.
- Loša priorizacija. Mrežni skeneri često generiraju mnogo rezultata s nedostacima koji se u praksi ne koriste, ali formalno je razina njihovog rizika visoka. Potrošač dobiva izvještaj koji je teško interpretirati i nije jasno što treba prvo ispraviti.
- Osnovne preporuke. U bazi znanja skenera često se nalazi samo vrlo općenita informacija o ranjivosti i načinima njenog ispravljanja, pa će administratori morati zavrnuti rukave i potražiti informacije na Googleu. Situacija je malo bolja sa whitebox skenerima koji mogu dati konkretne naredbe za ispravke.
- Ručni rad. U infrastrukturi može biti mnogo čvorova, a time i potencijalno mnogo nedostataka čije izvještaje je potrebno ručno analizirati pri svakoj iteraciji.
- Loša pokrivenost. Kvaliteta skeniranja infrastrukture izravno ovisi o opsegu baze znanja o ranjivostima i verzijama softvera. Ipak, , čak i kod lidera tržišta, baza znanja nije sveobuhvatna, a u bazama besplatnih rješenja ima mnogo informacija koje nedostaju liderima.
- Problemi s patchevima. Najčešće, patchiranje ranjivosti u infrastrukturi podrazumijeva ažuriranje paketa ili promjenu konfiguracijske datoteke. Veliki problem ovdje je to što se sustav, posebno legacy, može ponašati nepredvidivo kao posljedica ažuriranja. U suštini, bit će potrebno provesti integracijska testiranja na aktivnoj infrastrukturi u produkciji.
Pristupi
Što učiniti?
Detaljnije o primjerima i o tome kako se boriti s mnogim od navedenih problema, govorit ću u sljedećim dijelovima, a za sada ću navesti glavne pravce u kojima se može djelovati:
- Agregacija različitih alata za skeniranje. Pravilnim korištenjem više skenera moguće je značajno povećati bazu znanja i kvalitetu detektiranja. Možete pronaći čak i više ranjivosti nego što bi pojedinačno svi skeneri mogli otkriti, dok je moguće točnije ocijeniti razinu rizika i dati više preporuka.
- Integracija SAST i DAST. Moguće je povećati pokrivenost DAST-a i točnost SAST-a razmjenom informacija između njih. Iz izvora se mogu dobiti informacije o postojećim rutama, a uz pomoć DAST-a može se provjeriti je li ranjivost vidljiva izvan.
- Strojno učenje™. Godine 2015. ja (i ) o primjeni statistike kako bih skenerima dao intuiciju hakera i ubrzao ih. To je definitivno poticaj za razvoj automatske analize sigurnosti u budućnosti.
- Integracija IAST s automatiziranim testovima i OpenAPI. U okviru CI/CD pipeline-a moguće je kreirati proces skeniranja koristeći alate koji funkcionišu kao HTTP proxy i funkcionalne testove koji rade preko HTTP-a. Testovi i OpenAPI/Swagger ugovori će pružiti skeneru nedostajuće informacije o tokovima podataka, omogućujući skeniranje aplikacije u različitim stanjima.
- Ispravno konfiguriranje. Za svaku aplikaciju i infrastrukturu potrebno je kreirati odgovarajući profil skeniranja koji uzima u obzir broj i karakter korisničkih sučelja, korištene tehnologije.
- Prilagodba skenera. Često je nemoguće skenirati aplikaciju bez prilagodbe skenera. Primer — platni prolaz, gde svaki zahtev mora biti potpisan. Bez pisanja konektora za protokol prolaza, skeneri će bezrazložno slati zahteve sa pogrešnim potpisom. Takođe je potrebno pisati specijalizovane skenerе za određene vrste nedostataka, kao što su
- Upravljanje rizikom. Korišćenje različitih skenera i integracija sa spoljnim sistemima, kao što su Asset Management i Threat Management, omogućit će korišćenje mnogo parametara za procenu nivoa rizika, tako da uprava može dobiti adekvatnu sliku o trenutnom stanju bezbednosti razvoja ili infrastrukture.
Pratite nas i hajde da obrnemo skeniranje ranjivosti!
Izvor: habr.com
