

Érdekes, hogy a nyílt modellek szöveges promptokká történő átalakításáért felelős Stability AI által fejlesztett és tanított kiadási történetek hasonlítanak a Microsoft operációs rendszereinek, mint a sikeres XP, a problémás Vista, a csodás "hét", és a terméketlen Windows 8 egymást követő felszállásaira és bukásaira. A Stable Diffusion kezdetben nem túl vonzó, de a lelkesedők által fokozatosan fejlesztett 1.5 verzióját követte a nyilvánvalóan sikertelen SD 2.0 — sikertelen, mivel egy ilyen típusú modellhez szokatlan OpenCLIP kódolót tartalmazott, a . Az ilyen típusú kiválasztás során nemcsak a nem megfelelő (NSFW) vizuális referenciákat szűrték ki, hanem népszerű művészek, például a hírhedt Greg Rutkowski műveit is. Ez utóbbi végleg feldühítette a lelkesedőket: míg az SD 1.5 esetében a legjobb eredményeket a legegyszerűbb stílusokra vonatkozó promptok — "epikus középkori fantázia táj, Greg Rutkowski stílusában" — adták, és az eredményt lenyűgözőnek találták, az SD 2.0 már nem "felismerte" a legismertebb illusztrátorok neveit, akiknek a szerzői jogai a létrehozott művekre továbbra is érvényesek, és akik nem voltak hajlandók ezeket a műveket az AI tanításához biztosítani. A kívánt leírásához több szót kellett használni, és a túl hosszú promptokkal a modell rosszul boldogult.
Leültünk - felálltunk, leültünk - felálltunk
A módosított kódolóval (a szöveges jelzések digitális tokenné alakító eszköz, amivel a modell közvetlenül dolgozik) a névre ruházott stílusok alkalmazásának lehetetlensége egyszerűen elvette az lelkesedés motivációját ahhoz, hogy a rajongók saját erejükből tovább fejlesszék a „második verziót”. Valóban: párhuzamosan kellett foglalkozniuk azzal, hogyan is lehet a már bevált jelzéskészítési technikát az új kódolóhoz igazítani, és tovább képezniük a modellt az olyan képek és témák felismerésére, melyekkel a kezdeti tréning során nem ismertették meg, - pedig a „második verzió” által generált képek nem garantálták a lényeges eltérést a „második verziótól”. Igen, a SD 1.5-nél megszokott 512×512 pixel méret minőségi ugrást tett a 768×768-ba, de addigra a közösség már széles körben használta az upscalereket, outpaintere-ket és számos egyéb eszközt a végső kép méretének növelésére, így a SD 2.0 lényegében észrevétlenül eltelt. SDXL (az OpenAI által kifejlesztett és például a DALL-E projektben alkalmazott) - ennek is nyílt a kódja, de az adatbázis, amelyen tréningezve lett, , sajátos. Ezen kívül a „Oversize” standard vászonmérete 1024×1024-re nőtt, plusz megjelent egy sor újabb fejlesztés - így a lelkesedők örömmel kezdtek újra dolgozni rajta. Jelenleg a SDXL-t (és a nemrégiben megjelent változatait, amelyek kevésbé igényesek a gépi teljesítményre, mint például és ) biztosan a legnépszerűbb nyílt forráskódú AI-kép-generátorral lehet számon tartani. Miközben a SD 1.5 hévvel támogató hívei érvelnek amellett, hogy az olyan legfontosabb eszközök, mint a ControlNet, a SDXL-ben .
És most, 2024. június 12-től, amikor a modell kódjának a „vad természetbe” bocsátása, amely lehetővé teszi a helyi generálásokat, bekövetkezett, el kellett érkeznie a „nyílt” SD 3 verzió idejének - ha pontosabban fogalmazunk, akkor (SD3M vagy SD3 2B) 2 milliárd működő paraméterrel. Zárójelben emlékeztetünk, hogy ez a szám az összes perceptron belépési súlyainak összegének felel meg a modellen. Még korábban, áprilisban a Stability AI finomította és kereskedelmi használatra ajánlotta a 8 millió paraméterű , ami SD3 8B néven ismert. Az SDXL 1.0, emlékezzünk, – , azonban a fejlesztők szerint az SD3M . Azt állították, hogy a "túlméretezett" igényeinél alacsonyabb videomemória mellett még az egyszerűbb promptokra is új szintű fotorealisztikus képeket kellene adnia. A "hármas" előnyei között említették a "példa nélküli tipográfiai minőséget a generált képek szövegében", a "promptok mélyebb megértését három kódoló egyesült erőfeszítései révén" és a "hatékony utóképezési készséget még korlátozott adatmintákon is".
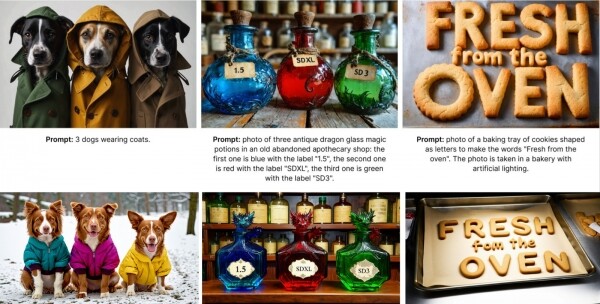
Nyilvánvalóan feltételezték, hogy az új, régóta várt játékszer birtokába került lelkes közösség ugyanazzal a lelkesedéssel fogja finomítani, mint annak idején a "másfél" és a "túlméretezett" modelleket. Azonban az elején minden másként alakult: az SD3M azonnal mélyen csalódást okozott A Stable Diffusion korábbi, nyílt forráskódú alkotásai (pontosabban a szabadon letölthető, helyben futtatható neurális hálózati súlyok) – mint például az SDXL – tipikus generatív modellekkel jártak,
CreativeML Open RAIL++-M Licenc az olyan jellemzőkkel, mint a „határozatlan, globális, nem kizárólagos, ingyenes, javadalmazás nélküli, visszavonhatatlan szerzői jogi licenc a további anyagok reprodukálására, előkészítésére, nyilvános bemutatására, nyilvános előadására, allicencálására és terjesztésére, mind a modell, mind a belőle származó anyagok esetében”. A „Hármas” kétféle licencelést kínál: — olyan nagyon megeresztett megfogalmazásokkal, mint hogy „A Stability AI nem kizárólagos, globális, nem átruházható, allicencálásra nem jogosult, visszavonható, javadalmazás nélküli és korlátozott szellemi tulajdon licencet biztosít önnek” — és .
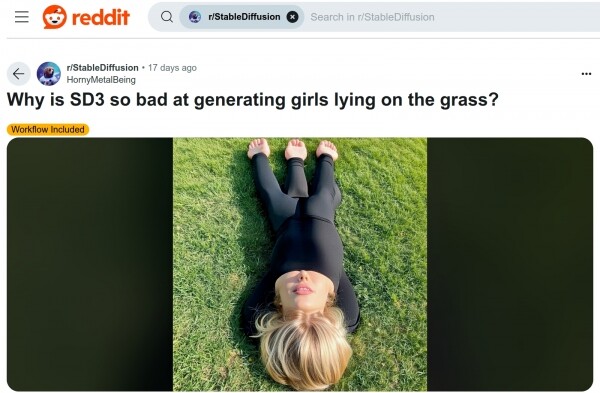
A fű nem hoz jót
Rövid időn belül a közösség arra a véleményre jutott, hogy . Valójában bojkottot hirdettek a fejlesztőcéggel szemben, nem akarva időt és energiát pazarolni a nyilvánvalóan nyers és ferde modell további tréningjére — tudván, hogy a Stability AI bármikor, bármilyen apró kénye kedvéből visszavonhatja a korábban egy adott lelkesedésű felhasználónak kiadott licencet, aki ezt a további tréninget végzi. A licencszerződés úgy van megfogalmazva, hogy a jogi ismeretekkel nem rendelkező olvasókban az az érzés alakuljon ki, mintha a SD3M kereskedelmi felhasználási engedélyének visszavonásával az egykori jogosult kénytelen lenne eltávolítani minden általa létrehozott származékot a neki licencelt szellemi tulajdonból, beleértve az általa finomított modelleket (LoRA, szöveges inverziók, egész ellenőrzési pontok) és azok származékait (idézet: „A Megállapodás megszüntetése után törölnie kell és meg kell szüntetnie bármilyen Szoftvertermék vagy Származékos Munka használatát”) — tehát más emberek munkáit, akik ezeket a származékos modelleket használták saját munkájuk kiindulópontjaként; mindezt senki által nem finanszírozva, tiszta lelkesedéssel végzett munkaként.
Néhány nappal azután, hogy a felháborodás hulláma elérte a stratoszféra magasságait, megjelentek már szakmai jogászok által érkező jelentések, A visszajelzés, amely megtiltja a további használatot, valójában csak néhány zárt forráskódú segédtermékre vonatkozik, amelyeket a Stability AI átad a kereskedelmi felhasználónak (például a SD3M továbbképzésének felgyorsítására és optimalizálására), - de a cég eddig nem nyújtott végső magyarázatot ezzel kapcsolatban. A cég hármasának nyilvánosságra kerülése óta eltelt három hét (a cikk írásának idején) csendje sokkal inkább rontja a fejlesztő hírnevét, mint a fű – a műalkotásaiból generált lányok.
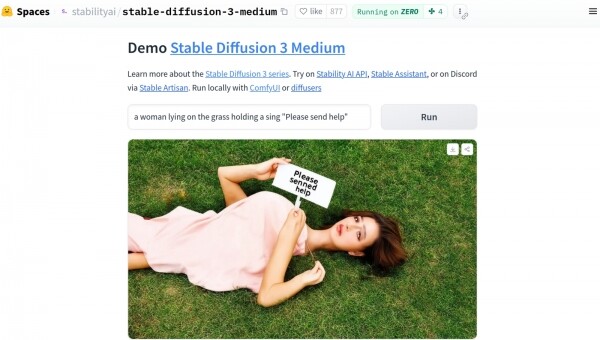
A hírhedt fű pedig, amely néhány óra leforgása alatt mémmé vált, , majd szinte minden, a témában releváns weboldalon megjelent, kiderült, hogy ha a javaslatban olyan kifejezést szerepeltetnek, mint „egy lány fekszik a fűben”, az nem csupán hallucinációkat eredményez a „hármasban”, hanem rémálomszerű szörnyetegeket is, amelyeket betegek – orvosi értelemben – fantáziái alkottak, a testborzalomra specializálódott művészek és filmesek. Arra kérünk, hogy ha számít a józan eszed és az életed, kerüld el az ilyesmit, és ne próbálj meg hasonló kifejezést beírni a képek keresőablakába a biztonsági szűrő kikapcsolásával. Ugyanakkor a „hármas” magabiztos négyes plusszal teljesít a státuszban álló – és valamivel kevésbé ülő – emberek esetében, és néha a portrék is tökéletesek; legalábbis nem rosszabbak, mint az alapmodell SDXL 1.0 esetében, a probléma itt a horizontális emberi testpozícióval kapcsolatos belső tabu.
Emad Mostaque, a Stability AI alapítója és korábbi (2024 márciusáig) vezetője megjegyzése szerint, aki távozott a cégtől, hogy , a SD3M-en végzett brutális erőszak közvetlenül a korlátozott non-profit felhasználására készült súlyainak megnyitása előtt történt (emlékeztetőül, az API a nagyobb SD3 8B modell online generálásához, de súlyait még mindig titokban tartják) a jelenlegi vezetőség biztonság iránti törekvésének következménye történt, , amelyeket már idén márciusban fogalmaztak meg, mint . A politikának megfelelően, a generatív SD3M modell alkalmazásával a felhasználók nem végezhetnek, népszerűsíthetnek, elősegíthetnek, megkönnyíthetnek, bátoríthatnak, tervezhetnek, uszíthatnak vagy hozzájárulhatnak a további erőszakhoz, terrorizmushoz vagy gyűlöletkeltő tartalom létrehozásához, amely diszkrét csoportokat fenyeget vagy diszkrét csoportokkal szemben képez előítéleteket (legyen szó akár nemről, etnikai hovatartozásról, szexuális identitásról vagy orientációról, vallásról vagy másról) - ezért semmiféle pandaábrázolás nincs, amely az anyaméhében harcolna őrült sárkányokkal! Csak és kizárólag mókás kalapokat viselő cicák, aranyos kutyák kedves kabátokban, rejtélyes tartalmú palackok és frissen sült sütemények!
Technikailag beszélve, lehet, hogy a modell kiürítése azt jelentette, hogy a tréningadatokból egyszerűen kizárták a fekvő emberek képeit és más olyan képeket, amelyek valamilyen módon obszcén értelmezést sugalltak, - ezért a »három« egyszerűen »nem érti« a »feküdni« szót. Vagy pedig a frissített SD3 architektúra lehetővé tette, hogy elég magabiztosan azonosítsák a neuronhálózaton lévő súlyokat, amelyek aktiválódnak „nem biztonságos” képek generálása során - és ezeket a súlyokat közvetlenül a kiadás előtt szelektíven nullázták, ami „kényszerített hallucinációt” eredményezett. Valószínűleg, : a kódoló helyesen fordítja a szöveget tokenekké, de a „biztonságos” latens térben ezek a tokenek már semmire sem mutatnak — és ezért az eredményül kapott pixelek lényegében csak úgy elhelyezkednek a képen, ahogy lehet.
Figyelembe véve az API elérhetőségét a teljes, de zárt SD3 8B modellhez már hónapok óta, és a Stability AI médiaigazgatóinak forró biztosítékait arról, hogy a „kompakt” 2B , az AI-rajzolás lelkes hívei rendkívül örömmel fogadták a SD3M súlyainak nyilvános kiadását június 12-én: . Jelenleg még mindig elérhetjük, bár kissé körülményesebben, mint az SDXL és SD 1.5 checkpointok esetén. A szokásos út a Civitai weboldal meglátogatása, ahonnan a legtöbb modellt regisztráció nélkül tölthetjük le, de június 17-től egészen a cikkverzió leadásáig a weboldal ezen a modellel foglalkozó oldala . Az ok egyetlen: a SD3M kereskedelmi licenc annyira zavaros nyelven van megfogalmazva, hogy még a Civitai jogászai is szünetet tartottak a további alapos tanulmányozására. Hiszen ha egy lelkes amatőr a saját PC-jén LoRA-t treníroz a 'trióra', és azt közzéteszi a Civitain, de a Stability AI hirtelen úgy dönt, hogy az eredmény nem megfelelő, és visszavonja az érintett illető engedélyét, akkor mi történik a hosztoló oldallal? Hiszen nemcsak checkpointokat, segédprogramokat és modelleket tárol, hanem lehetőséget is biztosít a látogatók számára a felhő alapú képgenerálásra, a LoRA, szöveges inverziók és egyéb dolgok trenírozására. Szóval, amíg a bíróság és az ügy folyik, a modell fájljait és a hozzájuk tartozó három szöveges tokenizáló csak .
Kezdjük is
Igaz, van egy kis árnyalat: a letöltési linkekhez való hozzáféréshez be kell jelentkeznünk a weboldalon, majd meg kell erősítenünk, hogy elfogadtuk az említett, korábban drákói licencszerződést - viszont ez a folyamat ingyenes és Oroszországból is teljesen elérhető. Összesen négy saját modell (models) és négy szöveges tokenizáló (encoders) közül lehet választani, valamint három referencia segédprogramot a ComfyUI munkakörnyezetében való végrehajtáshoz, :
modellek:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
kódolók:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
segédprogramok:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
A jelen „Műhely” keretein belül a sd3_medium.safetensors (4,2 GB) alapmodellre, három kódolóra — clip_g.safetensors (1,3 GB), clip_l.safetensors (234 MB) és t5xxl_fp8_e4m3fn.safetensors (4,7 GB) — valamint a sd3_medium_example_workflow_multi_prompt.json ciklusdiagramjára korlátozódunk. A lényeg, hogy a tesztgépünkön, emlékeztetőül, egy 8 GB-os videómemóriával rendelkező GeForce GTX 1070 videokártya van, amely nem tudja elhelyezni a nagyobb modelleket az összes beépített átalakítóval együtt. Az SD 1.5 és SDXL alapú ellenőrzőpontoknál a kódolók alapértelmezés szerint az alapfájlba vannak beépítve, de ebben az esetben ezekből az átalakítókból nem kettő, hanem három van, összesen több mint 6 GB, így önmagában a modellel együtt már meghaladja a 10 GB-ot; és ha figyelembe vesszük a 16 bites T5XXL kódoló változatot, akkor már egy még teljesítményesebb videokártya szükséges. Abban az esetben, amikor a videomemóriába előbb a szövegből tokent képező átalakítókat töltjük be, majd a következő lépésben a modellel, amely ezekkel a tokent képez, már egy 6 GB-os grafikus kártyával is képesek vagyunk boldogulni. E szempontból a moduláris „hármas” határozottan nyer a tipikus SDXL-ellenőrzőponttal szemben, amely 5-7 GB-ra van tervezve.
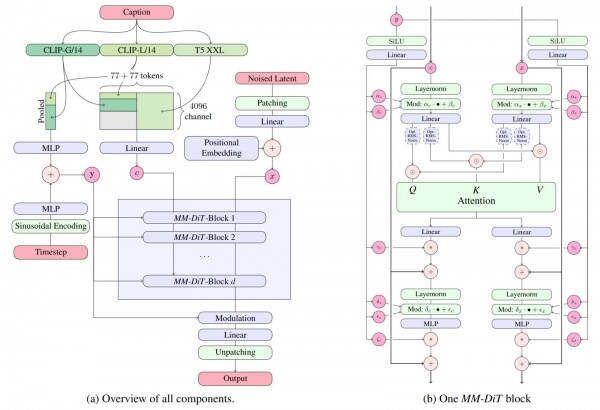
Az SD3M egy multimodális difúziós transzformátorok alapú modell () — így lényegesen eltér a Stability AI korábbi fejlesztéseitől (és nemcsak tőlük), amelyek az A „Műhely” nem a különbségek mélyreható tanulmányozásának helyszíne az AI-alapú képgenerálás különböző megközelítései között; annyit csak mondhatunk, hogy , lehetővé téve, hogy nagyobb számú tokent kezeljen (ami viszont lehetővé teszi az operátor számára, hogy meglehetősen terjedelmes szöveges utasításokat fogalmazzon meg, és a rendszernek — elég pontosan kövesse azokat), valamint jobb minőségű képeket eredményez. A teljes méretű SD3 8B képes 4 Mpixel (2048×2048 pixel) vásznon képeket generálni, valamint olyan területeken, mint a szöveg reprodukálása a képen, az elkészült kép textuális utasításhoz való pontos illeszkedése és az általános vizuális esztétika. A szöveg vektortokenné való átalakítása itt három kódolóval történik ( és egy T5-XXL — a „T5” pedig ) — és, egyébként, nem kötelesek egy és ugyanazon utasítást használni.
De elég az előszóból: térjünk rá a „Műhely” témájára — a képgenerálásra az SD3M modell alapján. Ehhez, mint már említettük, a ComfyUI munkakörnyezetet használjuk, amelyet . Hangsúlyozzuk, hogy ez a verzió csak NVIDIA grafikus kártyákon, vagy közvetlenül AMD vagy Intel CPU-n működik (ami természetesen sokkal lassabb lesz): az AMD videokártya tulajdonosoknak rocm és pytorch csomagok formájában, amelyeket a pip letöltő menedzser segítségével telepíthetünk.
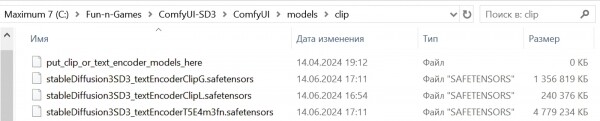
A munkakörnyezet telepítésének befejezése után a korábban letöltött .safetensors fájlokat a következő mappákba kell helyezni: az modellek a ComfyUImodelscheckpoints könyvtárba, a szöveget tokenekké alakító eszközök a ComfyUImodelsclip mappába. És — indulhat a munka!
Itt az ideje, hogy felgyorsuljunk
Érdemes megjegyezni, hogy az AUTOMATIC1111, amely a korábbi „Műhelyek” olvasói számára jól ismert AI-képgeneráló munkakörnyezet, június végére szintén , de a ComfyUI esetében a legteljesebb a támogatás az új modellhez. Nem meglepő — hiszen a közelmúltig a „tészta szörny” alkotója, akit a közösség ComfyAnonimous néven ismer, vagy egyszerűen csak Comfy, , ahol többek között a saját fejlesztőik által használt belső vállalati munkakörnyezet kialakításán dolgozott. Ahogy később látni fogjuk, a legújabb ComfyUI verzió valóban bizonyítja, hogy a fejlesztője rendelkezik bizonyos belső információkkal arról, hogyan van felépítve és működik ez a vitatott modell — olyan információkkal, amelyekkel más, a Stable Diffusion 3 Medium helyi végrehajtására készült munkakörnyezetek készítői érthető okokból nem büszkélkedhetnek.
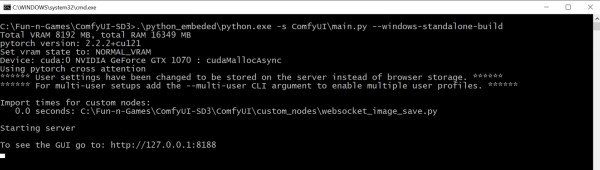
A ComfyUI telepítése Windowsra egyszerű, a hordozható (portable) verzióval: miután letöltöttük a megfelelő ZIP-archívumot Csak ki kell csomagolni egy tetszőleges mappába; természetesen ajánlott SSD-alapú logikai meghajtóra tenni, nem pedig HDD-re, mert a tároló és a memória közötti csere figyelembe veszi a létrejövő betöltési-kiürítési ciklusokat, még egyetlen kép generálásához is (a közegnek először a videó RAM-ba be kell helyeznie a szöveg tokenekké alakító eszközöket, majd ki kell törölnie a videó memóriát és be kell töltenie magát az SD3M-t), ami annál inkább számottevő, minél kevesebb videómemóriával rendelkezik a számítógép. Egyébként a hordozható telepítés teljes függetlensége is előnyös: semmi — a logikai lemezen lévő szabad hely mennyisége kivételével — nem akadályozza meg, hogy helyben annyi példányt futtassunk a ComfyUI-ból, amennyit csak akarunk, hogy szabadon kísérletezhessünk különböző kiegészítőkkel, anélkül, hogy attól félnénk, hogy elrontjuk a már optimalizált és tökéletesen működő rendszert.
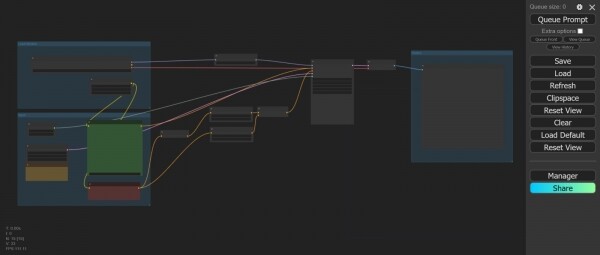
Miután megbizonyosodtunk arról, hogy az SD3M fő modellfájlja, a szöveget tokenekké alakító beépített kódolók nélkül (a stableDiffusion3SD3_sd3Medium.safetensors fájl, 4,2 GB) a checkpoints almappába van helyezve (a mi teszttelepítésünknél a teljes útvonal: C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), és mindhárom kódolómodell (a stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors és stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors fájlok; 1,3 GB, 234 MB és 4,7 GB egyenként) a clip almappában (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip) található, elindíthatjuk a munkakörnyezeti fájlt a run_nvidia_gpu.bat duplakattintásával a gyökérmappában (a mi esetünkben: C:Fun-n-GamesComfyUI-SD3). A szerver elindítása után a Windows parancssori ablakában a böngésző automatikusan (ahogy a BAT-fájl beállításai előírják) megnyit egy új lapot, amely elérhető a 127.0.0.1/8188 címen, ahol a webes felület található. (bár csak az első megközelítésben) "tésztaszörny".
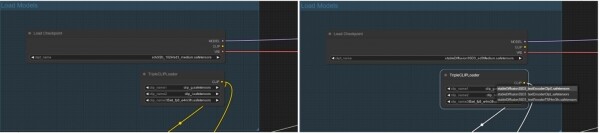
Alapvetően, ha egy modernebb NVIDIA grafikus kártya áll rendelkezésre (RTX generáció, nem GTX, még ha csak 6 GB videómemóriával is), azonnal betölthetjük a ComfyAnonimous által készített referencia munkafolyamatot, amelyről már korábban szó volt — az comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json fájlt, amely több prompt beviteli ablakot tartalmaz, egyet mindhárom kódolóhoz — és dolgozhatunk vele. Igaz, először négy fájlnévnek (a betöltési csomópontokban) meg kell felelnie a meglévőknek. A referencia munkafolyamat szerzője nyilvánvalóan a saját munkahelyén (a Stability AI-nál, ahogyan már említettük) az elérhető helyi fájlokkal dolgozott, amelyek kicsit más néven szerepeltek, így ha megnyomjuk a "Queue Prompt" gombot a ComfyUI spártai felületén a munkafolyamat betöltése után, a munkakörnyezet hibajelzést fog adni.
Háromsoros mező az AI-generáláshoz
Ezt egyébként nem nehéz orvosolni: sokkal aggasztóbb az a tény, hogy a rendelkezésre álló, már megkopott GTX 1070 szörnyen lassan dolgozza fel az SD3M-et — a kép generálása 27-30 másodpercet vesz igénybe minden iterációnál, és figyelembe véve, hogy a referencia munkafolyamat "Steps" paramétere 28-ra van állítva, indokolatlanul sok időt igényel. Ezért végezzünk el egy kis optimalizálást — használjuk a Python venv modulját (), amely többek között a generatív AI modellek munkájának felgyorsítására hivatott. A ComfyUI hordozható verziójának csomagjában nem szerepel, , amelyek végső soron egy teljes Python környezet telepítésére redukálódnak a helyi PC-n — és a szükséges modul aktiválására már ebből a környezetből.
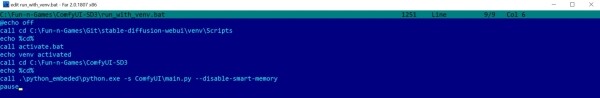
Bízunk benne, hogy az olvasóink, akik követik a "Műhelyeinket", már rendelkeznek aktív AUTOMATIC1111 telepítéssel a gépeiken. Ebben az esetben minden sokkal egyszerűbb: a venv modul már telepítve van, és amit tenni kell a ComfyUI munkakörnyezet indításakor, az az, . Először is, le kell állítani a szervert, áttérve az ablakára, és megnyomva a «Ctrl» + «C» billentyűkombinációt, majd bevezetve az «y» megerősítéshez; ezt követően másolja a run_nvidia_gpu.bat nevű BAT fájlt egy új fájlba, mondjuk run_with_venv.bat néven. Az eredeti indítófájl meglehetősen tömör – egyszerűen meghívja a portabilisan telepített változatot a Pythonból a —windows-standalone-build paraméterrel:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
Ez a paraméter önmagában nem túl egyértelmű – azt jelenti, hogy vannak bizonyos optimalizálások, amelyek valószínűleg a frissebb NVIDIA grafikus kártyákra lettek optimalizálva, és ezért ronthatják azok életét, akik továbbra is hűségesek maradnak a tiszteletre méltó GTX-eikhez. Emiatt eltávolítjuk a —windows-standalone-build paramétert a parancssorból, és lemondunk egy másik divatos optimalizálásról – az alapértelmezés szerint aktív „intelligens memória menedzser”-ről, a smart memoryról, amely , anélkül, hogy azt kiürítené. Ez valóban felgyorsítja az AI képek rajzolását, de ezzel együtt egydimenziós rendszerré változtatja a mi morálisan elavult számítógépünket – sem internetböngészés, sem játék, sem akár dokumentumokkal és e-mailekkel való párhuzamos munka a munkahelyi környezet aktivitása mellett már lehetetlenné válik. Tehát azok számára, akik nem rendelkeznek külön számítógéppel az AI-művészetekhez, a legoptimálisabbnak egy ilyen BAT fájl tűnik a ComfyUI indításához (nem csupán a SD3M képek generálásának céljából, mindjárt – a SDXL is teljesen megfelelő):
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv aktiválva
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Itt feltételezzük, hogy a ComfyUI hordozható telepítése a C:Fun-n-GamesComfyUI-SD3 mappában található, és az AUTOMATIC1111 előzőleg a C:Fun-n-GamesGitstable-diffusion-webui mappában van telepítve. A számos „echo” csak vizuális ellenőrzés céljából szükséges, hogy lássuk, hogy a könyvtárváltás normálisan zajlik, és a szükséges parancsok végrehajtódnak – miután mindenki hibátlanul működik, ezeket el lehet távolítani a BAT fájlból.
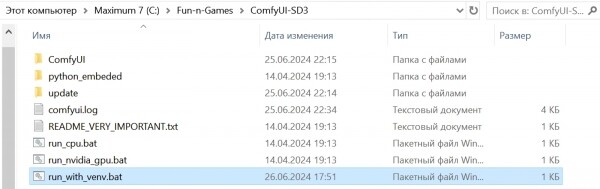
Ismét elindítjuk a munkaterületet, ezúttal kétszer kattintva a run_with_venv.bat fájlra. Mivel korábban csak bezártuk a szervert, és a webes felületet nem érintettük, a megfelelő fülön még mindig látható annak a ComfyUI névjegy diagramnak a tervezése, amelyben a modellnevek módosítva lettek. Figyeljünk a jobb oldalára: ott található a „Preview Image” csomópont, amely nem menti a kész képet a lemezre, csupán megjeleníti azt. Ha minden alkalommal a diagramot futtatjuk egyetlen kép generálására, vizuálisan értékeljük azt, módosítunk a paramétereken, és újra futtatjuk — ez egy teljesen működőképes változat: a tetsző képet mindig elmenthetjük kétszer kattintva rá jobb gombbal. De ha a munkaterületen számos generálást hajtunk végre egymás után, jobb, ha az eredmények automatikusan felhalmozódnak a tartós memóriában (alapértelmezett a ComfyUIoutput könyvtárban).
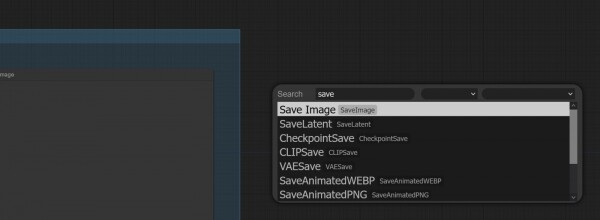
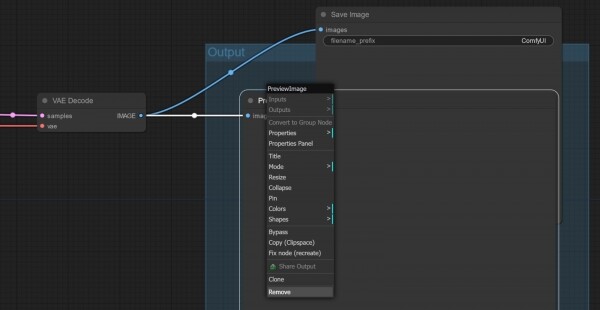
Ezért célszerű azonnal átállítani a „Preview Image” csomópontot „Save Image” csomópontra. Ehhez kétszer kattintunk a diagram bármely üres részére — megnyílik a csomópontválasztó ablak keresősorral. Ebbe a keresősorba kezdjük el beírni a „Save…” szót — és szinte azonnal látni fogjuk a keresett nevet. Ezután csak rá kell kattintanunk, és az újonnan megjelenő csomópont bemeneti kapcsolatát csatlakoztatnunk kell a „VAE Decode” csomópont „IMAGE” kimenetéhez, ahová eredetileg a „Preview Image” van csatlakoztatva. A „Preview Image” csomópot pedig később eltávolíthatjuk — egyszerűen ki kell jelölnünk, kattintva a címére, és megnyomni a „Del” gombot a billentyűzeten.
Most pedig elérkezett az idő, hogy végrehajtsuk a ComfyAnonimous által szerkesztett névjegy diagramot (a mi szerény módosításainkkal). Így néz ki:
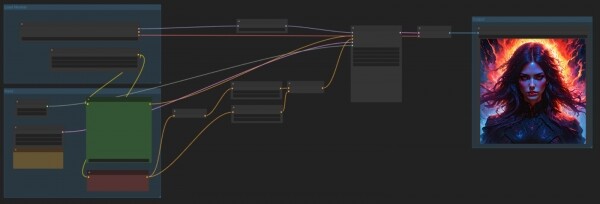
Nagyon lenyűgöző kép, még hangulata is van — és nem mondanád, hogy azt ugyanazzal a modellel hozták létre, amelynek az instrukciója kifejezetten embereket ábrázol a fűben. Eközben a rendszer meglehetősen élénken működik — körülbelül 5-6 másodperc iterációnként, egy 1 megapixeles képnél GTX 1070-en, ami tisztességes teljesítménynek számít. Összehasonlításképpen: ugyanaz a PC, ugyanazzal a ComfyUI-val és ugyanazzal a BAT-fájlal hasonló méretű SDXL képeket generál, körülbelül 6-7 másodpercet töltve el minden iteráción, így a „hármas” számítógép kevésbé igényesnek tekinthető az AI-generálásra használt hardver szempontjából.
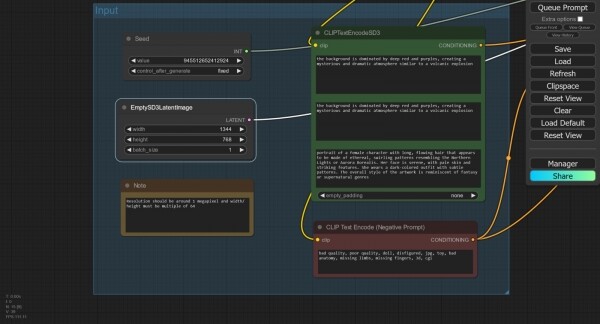
Mostjuk te a vászon méreteit. Az „EmptySD3LatentImage” csomópont közelében található egy „üres” (értsd: semmilyen oldalhoz sincs csatlakoztatva) referenciacsomópont, a „Note”, amely fontos emlékeztetőt tartalmaz: az SD3M esetében a kép teljes területének körülbelül 1 MPix-nek kell lennie, amiből kiindulva kell kiválasztani a téglalap alakú vászon oldalainak méreteit. Ekkor 1344×768-ra állítjuk ezeket, ami körülbelül 1,03 MPix-et ad ki.
Figyeljük meg: fent található a „Seed” csomópont, ahol a magot magát állították be, jelen esetben „945512652412924”, és meg van határozva, hogy a generálás után nem változhat (a „fixed” paraméter).
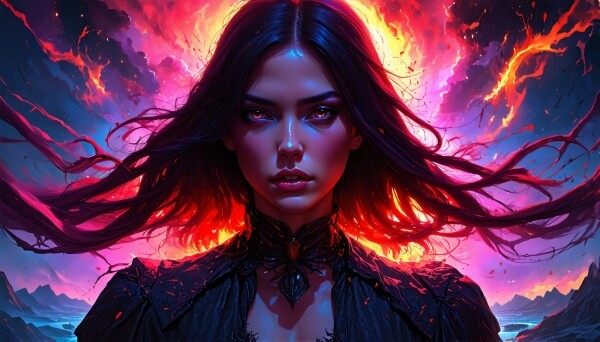
Ugyanezt a ciklust végezzük el az előző maggal, de már a téglalap alakú vászonon. Azonnal észrevehető, hogy az összesített végrehajtási idő rövidebb, bár a rajzolási sebesség változatlan maradt – kevesebb mint 6 másodperc iterációnként. Ez logikus: mivel a szöveges útmutatók nem változtak, ezért nem szükséges az encoder(t) újra betölteni. A kimeneti kép, nyilvánvalóan, kissé eltér az első, négyzet alakútól, de nem lényegesen - az általános kompozíció, ahogy vártuk, megmaradt.
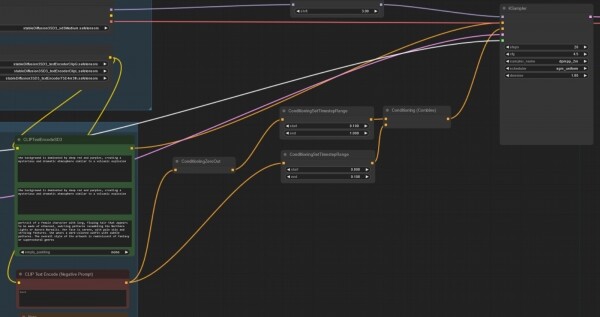
Most figyeljünk a „CLIPTextEncodeSD3” és a „CLIP Text Encode (Negative Prompt)” csomópontokra. Az első azzal tűnik ki, hogy három bemeneti mezőt tartalmaz; ha eltávolítjuk a szöveget, láthatóvá válnak a jelzések arról, hogy melyik enkódereknek szólnak - felülről lefelé: CLIP G, CLIP L és T5XXL. Korábban ilyen csomópontok nem voltak a ComfyUI-ban, érthető okokból. Az alap ciklus grafikon ismétlődő, rövid útmutatókat tartalmaz az első két szöveges mezőhöz (a CLIP G és CLIP L átalakítókhoz), és sokkal terjedelmesebbet a harmadikhoz - T5XXL. Nyilvánvaló, hogy ezeknek a mezőknek a tartalmával széles határok között játszhatunk, és maga a szövegvariációk hatása a végső kép létrehozására nem trivális, de rendkívül vonzó feladat. Mindazonáltal, az ezt követően érthető okokból nem fogunk most ezzel mélyen foglalkozni.
A "CLIP Text Encode (Negative Prompt)" node has nothing special, but consider the complex journey from it to the corresponding input "conditioning" of the main "KSampler" node! This path splits, with one branch (the upper one in this case) indicating that starting from 10% of the generation steps until completion, the system will not take the negative prompt into account at all (the passage through the "ConditioningZeroOut" node effectively means resetting the condition). Meanwhile, the second branch passes the negative prompt (also conditionally at half weight) for further processing unchanged — but only for the first 10% of the total number of generation steps.
A hazy distance
Once again: the first 10%, i.e., 3 out of 28 assigned in this case, the negative prompt is passed to the "KSampler" node, which is responsible for generating the image in latent space (into pixel space, i.e., into a comprehensible human image, the output of which is translated by the next node, "VAE Decoder"), in a normal way: the upper branch (with condition reset) is inactive, only the lower one is working. The remaining 90% of the steps (25 out of 28 in our case) the negative prompt does not work at all: the upper conditions transfer branch is active — with their reset, — while the movement along the lower is blocked by the threshold parameter of the corresponding "ConditioningSetTimestepRange" node. Now it is clear why a number of reviewers claim that , — the effect of them (if we consider this very base cycle diagram and assume that similar rules apply on sites with online generation based on the SD3 Medium model) is minimal.
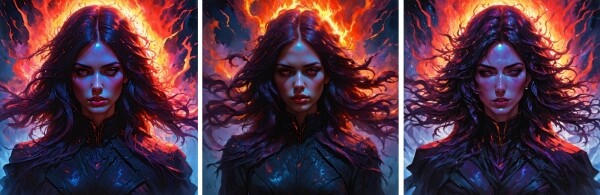
Mégiscsak létezik: ha egyszerűen közvetlenül összekapcsoljuk a „CLIP Text Encode (Negative Prompt)” csomópont kimenetét a megfelelő „KSampler” bemenettel (vagy ha az összes köztes csomópontot az úton „átugorható”-ként, „Bypass”-ként jelöljük meg, ami ugyanazt az eredményt adja), a végső kép minősége érzékelhetően romlik. Ezt egyébként lehet úgy is értelmezni, mint a SD3M „nem megformáltságának” részben bizonyítékát, mivel a negatív prompt erejét és jelentőségét a fejlesztőknek szigorúan véve még a modell súlyainak nyilvánosságra hozatala előtt kellett volna tudniuk beállítani. Két ügyesen megfogalmazott feltétel a negatív prompt alkalmazására — egyfajta javítás, és ebben az értelemben a Stability AI marketing részlege által terjesztett elvárásokat, teljesen indokoltnak tűnnek.
A SD3M-hez kapcsolódó hivatalos útmutató hiánya oda vezetett, hogy már keringenek a hírek a hálózaton, miszerint ezt a modellt Ez természetesen nem igaz, de mindenesetre ezeket a promptokat pontosan másképp kell alkalmazni, . Különösen az entuziazták komolyan állítják, hogy a negatív mezőkhöz minél több részletes leírás hozzáadása, ami a lehető legtöbb sértő dolgot tartalmazza (igen-igen, a régi jó „nsfw, nude” nem elég — komolyan meg kell feszíteni a fantáziát) akár a hírhedt lány számára, aki a fűben fekszik. Hogy ez így van-e vagy sem — azt figyelmes ellenőrzés nélkül nem lehet kideríteni (ráadásul nem biztos, hogy a weboldalunk tetején elhelyezett „18+” címkézés megments minket az átkozott erkölcs védelmezőinek kereseteitől, ha megkockáztatjuk, hogy közzétegyük az entuziazták által összeállított „csoda-promptot” — bármennyire is angolul van). Ez a mulatságos helyzet emlékeztet az mivel éppen azért, mert ezek részletes leírásokat tartalmaztak arról, hogy mit és hogyan ne tegyenek a jó keresztények, — legalább fragmentumai érkeztek el hozzánk a nem keresztény Rusi hitvilágáról és szokásairól.
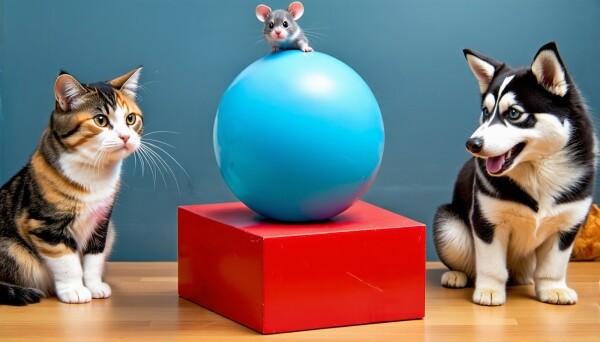
Most már, remélhetőleg, világosabbá vált, miért tűnik értelmetlen időt és energiát fecsérelni a SD3M további tanulmányozására ezen a ponton. Valóban van miről beszélni és mit felfedezni: elég szigorúan ajánlott generálási paraméterek a "KSampler" csomópontban (CFG — 4,5-5,0; lépések száma — körülbelül 28; samplerek/szerverek párosítása — kizárólag dpmpp_2m/sgm_uniform, különben a kiadott minőség észrevehetően csökken); és a szubjektív generálási minőség rendkívül jelentős eltérése azonos kezdőparaméterek mellett, de különböző kiindulópontokkal; és a híres „fűben fekvés átkának” megszüntetése (amire már ); és annak tisztázása, hogy pontosan mely generálási paraméterekre hat az a három szöveget tokenekké alakító átalakító — és hogyan, ezekkel operálva, elérni az igazi mesterművek létrehozását a vizuális AI terén (ha ezt a "hármassal" egyáltalán lehetséges).
Főleg, hogy Emad Mostak márciusi és ComfyAnonymous júniusi elbocsátása, , — nem az egyetlen kellemetlenség, amely a Stability AI-t érte. A Reuters jelentése szerint, a The Informationra hivatkozva, ez a brit startup szó szerint nemrégiben (a cikk írásának időpontjában) ismételten , aki Prem Akkaraju lett, a neves globális IT-befektetők egyik képviselője — amely csoport pedig komoly készpénzösszeget hajlandó befektetni a cégbe (). A Stability AI helyzete, mint üzleti struktúra, ma nyíltan instabil; sok csalódott — és ilyen helyzetben nehéz várni a cégtől a nyilvánvaló hibák alapos javítását.
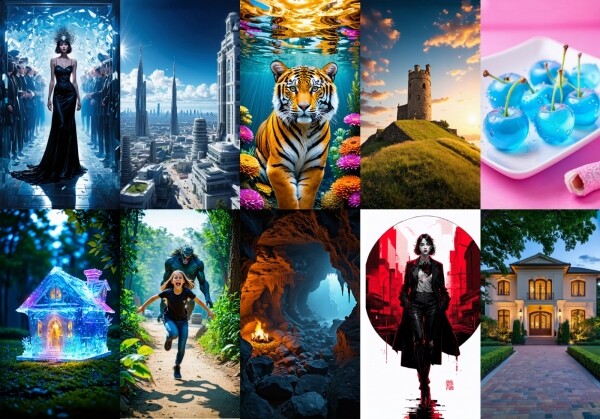
A poorly thought-out licensing policy unfortunately prevents the community from independently refining SD3M as it was with SD 1.5 and SDXL. At the very least, derivative checkpoints and tools like LoRA for the last two models will certainly remain accessible for local execution, even when (and if) Stability AI completes its journey as a commercial entity. Immediately following the resounding failure of the 'trio', voices in support of creating a non-commercial project for developing a generative model for transforming text into images based on crowdfunding have become increasingly common on specialized forums, and to date, this movement is beginning to take shape under the name . Ready to actively join this project are already Invoke (one of the platforms for online AI generation, aimed at professional studios), Comfy Org (a team that supports and develops ComfyUI), Civitai (which needs no introduction), and the team behind LAION (the annotated image database on which such models are primarily trained).
So in the near future, new releases of the 'Workshop' will most likely focus on working with those models for which the community has already created a wide range of enhancements and additional tools — for the 'one-and-a-half' and 'Oversize'. Perhaps the time for the triumph of SD3M will still come — but today it’s hard to even guess when exactly. Meanwhile, those interested can download the archive with the SD3M generations mentioned in this article (the cyclegrams are integrated directly into the PNG files; just drag the image onto the ComfyUI workspace from the Windows Explorer to reproduce the entire generation order and parameters) . Perhaps one of our readers will discover an optimal way to distribute text across the three prompt fields before the regulars on Reddit and Hugging Face, for example?
Témához kapcsolódó anyagok:
.
.
.
.
.
Forrás: 3dnews.ru
