

A Mozilla beszédészlelési eszközkészletet fejleszt a Whisperfile révén, amely magában foglal egy független, nagy teljesítményű megvalósítást a Whisper gépi tanulási modell számára, amelyet az OpenAI szervezet fejlesztett és tett közzé. Az eszközkészlet a whisper.cpp alapján készült, amely a Whisper modell C/C++-os megvalósítása, Georgi Gerganov (a llama.cpp szerzője) által készítve. A kód C++ nyelven íródott és MIT licenc alatt terjesztik.
A Whisperfile a Mozilla Ocho csapata által fejlesztett, és kiegészíti a llamafile projektet, amely általános futtatható fájlok létrehozására szolgál a nagy nyelvi gépi tanulási modellek (LLM) futtatásához. A llamafile-hoz hasonlóan a whisperfile projekt lehetővé teszi, hogy egy gépi tanulási modell paraméterfájljából, GGUF formátumban, egy futtatható fájl jöjjön létre, amely különböző operációs rendszereken futtatható AMD64 és ARM64 architektúrájú hardvereken. A lefordított kód kapcsolatba léphet a Cosmopolitan szabványos C könyvtárral, amely lehetővé teszi alkalmazásgyűjtemények létrehozását Linux, FreeBSD, macOS, OpenBSD, NetBSD és Windows rendszerekre.
A futtatható fájl indításakor bemeneti paraméterként egy hangfájlt kell megadni wav, mp3, ogg vagy flac formátumban, és a kimenetként a felismert szöveget tárolja el. Gyakorlatilag a projekt olyan feladatokra alkalmazható, mint a videókhoz tartozó feliratozás, a hang- és videohívások naplózása, rögzített hanganyagok szöveggé alakítása, valamint a hangalapú bevitel szervezése. A Whisperfile segítségével ezek a feladatok helyi rendszerben, külső szolgáltatások igénybevétele nélkül oldhatók meg.
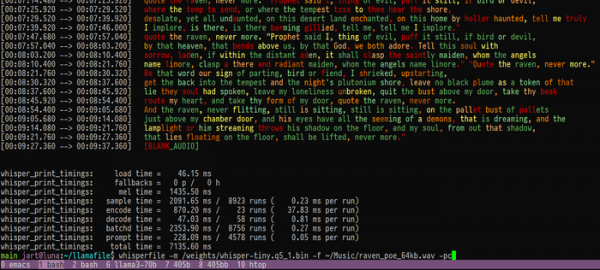
Továbbá támogatja a HTTP-szerver szerepét, amely a beszédészlelést kezelő kéréseket fogad a Web API-n keresztül. A modell hatékonyabb működése érdekében GPU-k és AVX utasítások is felhasználhatók. Az eszközkészlet a felismert szavakat a meghatározásuk pontossága alapján képes színkódolni a megbízhatósági mutatók megjelenítésével.
A Whisper modell 680 ezer órányi beszédadatokon lett betanítva, amelyek különböző témaköröket és nyelveket ölelnek fel (2/3 angol nyelvű adatok). A modell jól teljesít az akcentussal rendelkező beszéd felismerésében, azonosítja a technikai zsargont, támogatja a nyelv automatikus azonosítását, és képes működni háttérzaj mellett. Angol nyelvű beszéd esetén a rendszer megbízhatósága és pontos felismerése közel áll az emberi felismeréshez. A beszéd írásbeli átkonvertálása mellett a modell fordításra is alkalmas más nyelvekre.
Forrás: opennet.ru
