

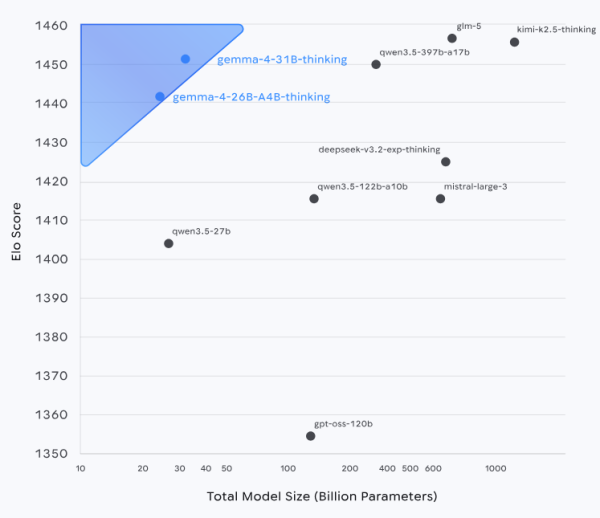
A Google új nagy nyelvi modellek családját, a Gemini 3 technológián alapuló Gemma 4-et tette közzé. A Gemma 4 az Apache licenc alatt érhető el 2,3, 4,5, 25,2 és 30,7 milliárd paraméteres változatokban (E2B, E4B, 31B és 26B A4B). Az E2B és E4B változatok alkalmasak mobil eszközök, IoT rendszerek és Raspberry Pi alaplapok használatára, míg a többi változat munkaállomások és fogyasztói GPU-kkal rendelkező rendszerek alkalmazására megfelelő. A modell által figyelembe vett kontextus mérete 128 ezer token az E2B és E4B modellek esetében, míg 256 ezer token a 31B és 26B A4B modellek esetében.
A modellek többnyelvűek és multimodálisak: alapból 35 nyelvet támogatnak (a képzés során több mint 140 nyelvet használtak), és bemenetként szöveget és képeket képesek feldolgozni (az E2B és E4B modellek emellett a hang feldolgozását is támogatják). A 26B A4B modell a MoE (Mixture-of-Experts) architektúrára épül, amely a modellt egy sor szakértői hálózatra osztja (válasz generálásakor csak 3,8 milliárd paraméter használható, de a sebesség lényegesen magasabb, mint a klasszikus nagy modellek esetében), míg a többi változat klasszikus monolitikus architektúrát alkalmaz.
A modellek képesek érvelni és testreszabható gondolkodási módokat támogatni, rendszerszerepet (System Role) használnak az utasítások (szabályok, korlátozások) külön feldolgozására az adatoktól. A modellek használhatók kódírásra, képeken objektumok azonosítására, videók képkockánkénti elemzésére, dokumentumok és PDF-ek feldolgozására, nyomtatott és kézírásos szöveg optikai azonosítására (OCR), beszédfelismerésre és nyelvek közötti fordításra. Autonóm ügynökként is használhatóak, amelyek különböző eszközökkel és API-kkal lépnek interakcióba.
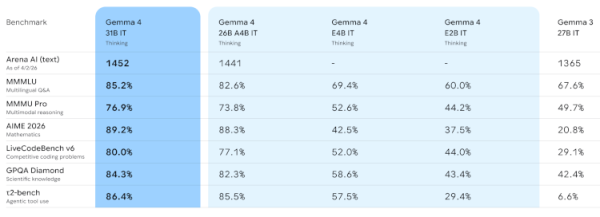
A Gemma 4 modellek a legtöbb tesztben lényegesen felülmúlták a 27 milliárd paraméteres Gemma 3 modellt. A Gemma 4 használata támogatott a LiteRT-LM, vLLM, llama.cpp, MLX, Ollama, NVIDIA NIM és NeMo, LM Studio, Unsloth, SGLang, Cactus, Basetan, MaxText, Tunix és Keras eszközökkel és könyvtárakkal.
Forrás: opennet.ru
