

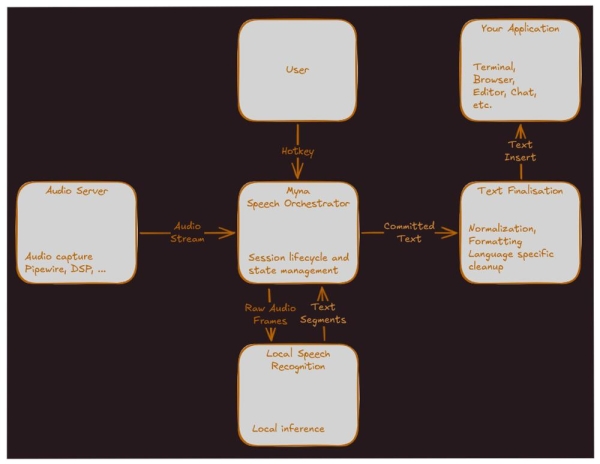
A Canonical bemutatta a projektet Myna — egy új beszédről szövegre átalakító rendszert az Ubuntu Desktop számára. A projekt célja a beépített diktálás: a felhasználó megnyom egy gyorsgombot, beszél, és a felismert szöveg megjelenik az aktív alkalmazásban. A bejelentésben hangsúlyozzák, hogy a Myna-nak természetes részének kell lennie az Ubuntu asztalának, ugyanakkor figyelembe kell vennie a felhasználói adatvédelmet. A hír közzétételének időpontjában a támogatott bemeneti nyelvek listáját nem tették közzé.
A projekt első célja — Ubuntu 26.10. Ezen a lépésen a Canonical nem próbál teljes értékű hangasszisztenst vagy asztalirányító rendszert létrehozni. A fejlesztők szándékosan korlátozták az első verzió terjedelmét az alapvető, megbízható diktálásra: megnyomni a billentyűkombinációt, mondani a szöveget és megkapni az eredményt a jelenlegi beviteli mezőben. Az első ellenőrizhető környezet az Ubuntu Desktop Waylanden a GNOME-mal, de az architektúrát elég nyitottan tervezik hagyni a jövőbeli más környezetek támogatására.
A Myna helyi beszédfelismerésre lett tervezve. A szükséges modellek telepítése után internetkapcsolatra nincs szükség a diktáláshoz, a mikrofont csak a felhasználó kifejezett aktiválása után lehet használni, az audio a memóriában kerül feldolgozásra, majd eldobásra kerül, és a felvételek nem kerülnek külső szolgáltatásokhoz. A projekt specifikációjában azt is megjegyzik, hogy a megoldás alapértelmezés szerint el kell kerülnie az audio mentését, és nem szabad észrevétlenül átváltania felhőszolgáltatásra.
A Myna kódja és dokumentációja közzétételre került a Canonical tárolójában a GitHub. A projektet könnyű beszédről szövegre alkalmazásként írják le az Ubuntu Desktop számára, és GPL-3.0 licenc alatt terjesztik. A projekt azonban korai szakaszban van: a tárolóban még nincsenek közzétett kiadások, és az architekturális specifikáció javasolt státuszt kapott.
A Myna főbb funkciói és jellemzői
Push-to-talk diktálás. A felhasználó lenyomva tartja a testreszabható gyorsbillentyűt, beszél, és a rendszer beilleszti a felismert szöveget a kiválasztott beviteli mezőbe. A diktálás a billentyű felengedésével zárul.
Helyi beszédfelismerés. A felismerés a felhasználó gépén történik a helyi kiértékelő rendszeren keresztül. Ez csökkenti a felhőre való támaszkodást, és lehetővé teszi az offline működést a modellek telepítése után.
Privát audiofeldolgozás. A mikrofon csak a felhasználói diktálási munkamenet során aktiválódik. Az audio alapértelmezés szerint nem kerül rögzítésre a lemezen, egy korlátozott memória-büfé használatos, amely a munkamenet végén törlődik.
Aktivitási állapotjelző. Rögzítés és átírás során a felhasználónak egyértelmű állapotjelzőt kell látnia. A specifikáció a Recording, Transcribing, Finalizing és Error állapotokat említi.
Csak stabil szöveg beszúrása. Az első megvalósítás során a közbenső felismerési hipotéziseket nem szabad közvetlenül az alkalmazásba behelyezni. Csak a megerősített végső szöveg kerül a célszövegmezőbe.
A szöveg utófeldolgozása. A nyers átirat normalizáláson, írásjelek elhelyezésén, nagybetűsítésen, formázáson és a szóbeli formák írottá alakításán mehet keresztül, például "twenty two" → "22".
A diktálás nyelvének kiválasztása. A rendszernek támogatnia kell a testreszabható diktálási nyelvet, alapértelmezés szerint a felhasználói felület nyelvére építve, ha hozzáférhető egy megfelelő modell.
Modell minőségi profilok. A specifikáció különböző modellprofilokat tartalmaz: egy könnyű változat alacsonyabb erőforrás-felhasználással, egy kiegyensúlyozott alapértelmezett profil és egy magasabb minőségű, de nehezebb változat.
Biztonságos munka a szövegbeviteli fókusz mellett. A beillesztési cél kezdéskor kerül kijelölésre a munkamenetben. Ha a fókusz az ablakon belül megváltozik diktálás közben, a rendszer nem küldheti ki halkan a szöveget egy másik alkalmazásba.
Zárolás védett mezőkben. A diktálásnak zárolva kell lennie jelszómezőkben, hitelesítési ablakokban és más védett helyeken, ha az alkalmazás vagy a toolkit lehetővé teszi ennek az észlelését.
Integráció a Wayland/GNOME-mal. Az első verzió Wayland-ra és GNOME-ra van optimalizálva. A kezdeti szövegbeillesztéshez az IBus-t használják, a jövőben pedig egy natívabb Wayland-irányt terveznek az input-method/text-input protokollokon keresztül.
Felhasználói beállítások. A tervezett beállítási felületen a STT be-/kikapcsolása, a gyorsbillentyű, a diktálás nyelve, a mikrofon, a modellprofil, az utófeldolgozási beállítások és az aktivitási állapotjelző kiválasztása szerepel.
Az első iterációban a projekten kívül marad a kulcsszó alapú felébresztés, a folyamatos háttérhallgatás, a felhő alapú hangfelismerés, a hangalapú asszisztens, a hangparancsok, a munkaasztal kezelése, a beszédfordítás, a beszélő azonosítása, a nyelv automatikus észlelése és a diktálási előzmények. Más szavakkal, a Canonical nem az “AI-asszisztenssel” kezdi, hanem egy sokkal földhözragadtabb funkcióval: a helyi hangalapú szövegbevitel lehetőségével a szokásos Ubuntu alkalmazásokban.
Forrás: linux.org.ru
