

Bevezetés
Ebben a cikkben a híres Huffman-algoritmusról fogok beszélni, valamint annak alkalmazásáról az adatok tömörítésében.
Ennek eredményeként írni fogunk egy egyszerű archiváló programot. Erről már volt , de gyakorlati megvalósítás nélkül. A jelenlegi bejegyzés elméleti anyagát az iskolai informatika órákból és Robert Lafore "Adatszerkezetek és algoritmusok Java nyelven" című könyvéből vettük. Nos, mindenki, aki érdeklődik, kattintson ide!
Néhány gondolat
Egy szokásos szövegfájlban egy karakter 8 biten (ASCII kódolás) vagy 16 biten (Unicode kódolás) kódolva van. Ezért ezúttal az ASCII kódolást fogjuk figyelembe venni. Például vegyünk egy s1 = "SUSIE SAYS IT IS EASYn" stringet. Összesen 22 karakter van a stringben, természetesen beleértve a szóközöket és az új sorra váltó karaktert — ‘n’. A fájl, amely ezt a stringet tartalmazza, 22*8 = 176 bit méretű lesz. Azonnal felmerül a kérdés: ésszerű-e mind a 8 bitet használni 1 karakter kódolására? Hiszen nem használjuk az ASCII kódolás összes karakterét. Még ha használnánk is, ésszerűbb lenne a leggyakoribb betűnek — S — a lehető legrövidebb kódot adni, míg a legritkább betűnek — T-nek (vagy U-nak, vagy ‘n’-nek) — hosszabb kódot adni. A Huffman-algoritmus lényege éppen ez: meg kell találni az optimális kódolási lehetőséget, amely a fájl méretét minimalizálja. Teljesen normális, hogy különböző karakterek kódhossza eltérő — ez alapján épül fel az algoritmus.
Kódolás
Miért ne lehetne a ‘S’ karakternek például 1 bit hosszúságú kódot adni: 0 vagy 1? Legyen ez 1. Ezután a második leggyakoribb karakternek — ‘ ‘(szóköz) — adjunk 0-t. Képzelje el, hogy elkezdte dekódolni üzenetét — az s1 kódolt stringet — és látja, hogy a kód 1-gyel kezdődik. Na és mit csináljon: ez S karakter, vagy egy másik karakter, például A? Ezért van egy fontos szabály:
Egyetlen kód sem lehet más kód prefixe
Ez a szabály kulcsfontosságú az algoritmusban. Ezért a kód létrehozása a karakterek gyakorisági táblázatával kezdődik, amely megmutatja minden karakter előfordulási gyakoriságát (a megjelenések számát):
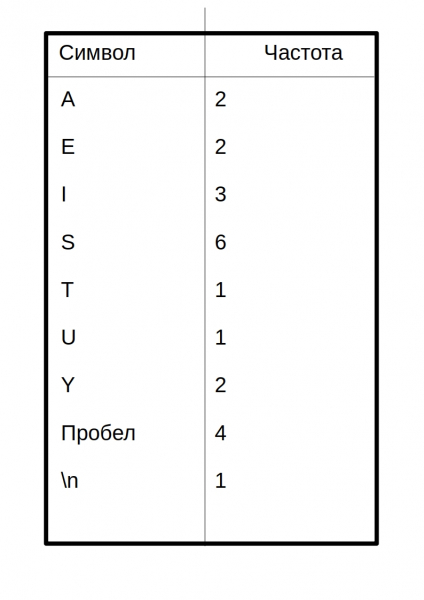 A leggyakoribb karaktereket a lehető legkevesebb bit számban kell kódolni. Például bemutatok egy lehetséges kódok táblázatot:
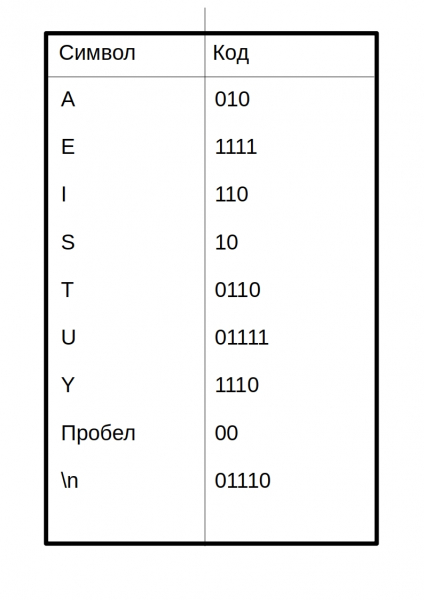 Így a kódolt üzenet így fog kinézni:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Minden karakter kódját szóközzel elválasztottam. A tömörített fájlban ez valójában nem így lesz!
Felmerül a kérdés: hogyan találta ki ez a srác a kódot a kódok táblázatának létrehozásához? Erről lesz szó az alábbiakban.
Huffman-fa felépítése
Itt jönnek a segítségünkre a bináris keresőfák. Ne aggódjon, itt a keresési, beszúrási és törlési módszerekre nincs szükség. Íme a fa struktúrája Java-ban:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Ez nem a teljes kód, a teljes kód lentebb található.
Itt van maga az algoritmus a fa felépítéséhez:
- Hozzon létre egy Node objektumot minden karakterhez az üzenetből (s1 sztring). Ebben az esetben 9 csomópont lesz (Node objektumok). Minden csomópont két adatmezőből áll: karakter és frekvencia
- Hozzon létre egy Fa (BinaryTree) objektumot minden Node csomópont számára. A csomópont lesz a fa gyökere.
- Illessze be ezeket a fákat a prioritási sorba. Minél kisebb a frekvencia, annál nagyobb a prioritás. Így a kinyerés során mindig a legkisebb frekvenciájú fához jön a választás.
Ezután folyamatosan a következőt kell végrehajtani:
- Kinyerni két fát a prioritási sorból és a leszármazottjaivá tenni egy új csomópontnak (az éppen létrehozott csomópontnak, amelynek nincs betűje). Az új csomópont frekvenciája a két leszármazott fa frekvenciáinak összege.
- Ebből a csomópontból fa készítése a megadott csomópont gyökerével. Ezt a fát vissza kell illeszteni a prioritási sorba. (Mivel a fának új frekvenciája van, valószínűleg új helyet fog kapni a sorban)
- Folytassa az 1. és 2. lépések végrehajtását, amíg a sorban csak egy fa marad - a Huffman-fa
Vizsgáljuk meg ezt az algoritmust az s1 sztring alapján:
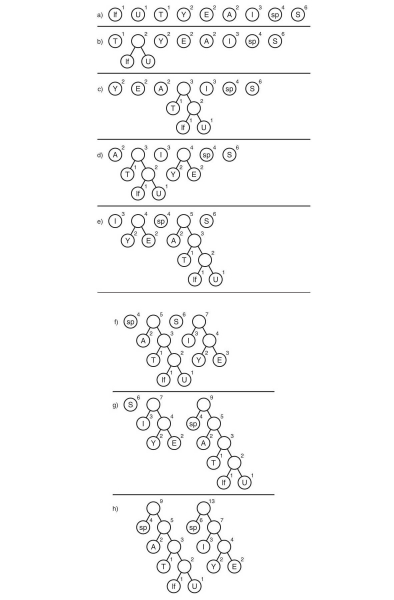
Itt a »lf« (sorvége) jelzi az új sorra való átállást, a »sp« (szóköz) pedig a szóközt jelenti.
Mi jön ezután?
Megkaptuk a Huffman fát. Rendben van. És mit kezdjünk vele? Még ingyen sem kérik el. Ezután nyomon kell követni az összes lehetséges utat a gyökértől a fa leveleihez. Azt fogjuk feltételezni, hogy a bal utódhoz vezető élt 0-val, a jobb utódhoz vezetőt pedig 1-gyel jelöljük. Szigorúan véve, ezekben a jelölésekben a karakter kódja a fa gyökerétől a levelet tartalmazó levélhez vezető út.
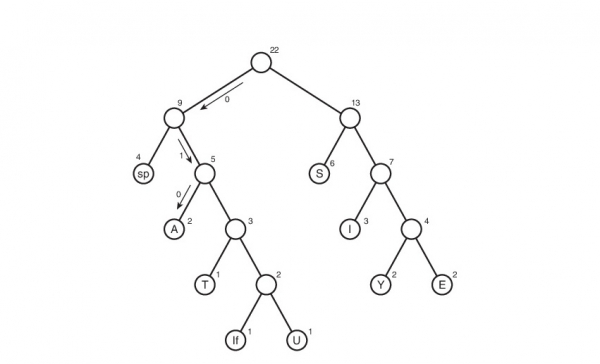
Így alakult ki a kódok táblázata. Észrevehetjük, hogy ha megvizsgáljuk ezt a táblázatot, levonhatjuk a következtetést minden egyes karakter «súlyáról» — ez a kódjának hossza. Így tömörített formában az eredeti fájl súlya: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bit. Eleinte 176 bit volt. Következésképpen 176/65 = 2,7-szer csökkentettük! De ez utópia. Ilyen arány valószínűleg nem fog előállni. Miért? Erről lesz szó később.
Dekódolás
Nos, talán a legegyszerűbb feladat maradt — a dekódolás. Azt hiszem, sokan közülük rájöttek, hogy nem lehet egyszerűen létrehozni egy tömörített fájlt anélkül, hogy bármilyen nyomot hagynánk arról, hogyan kódoltuk — nem tudjuk dekódolni! Igen, nehéz volt ezt elfogadni, de létre kell hoznunk egy text fájlt table.txt a tömörítési táblázattal:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
A táblázat rögzítése a ‘karakter’«karakter kódja» formátumban. Miért 01110 karakter nélkül? Valójában van egy karaktere, csak a Java eszközök, amelyeket használtam a fájlba való kiíráskor, a sortörést – ‘n’ — konvertálják sorvágásra (bárhogy is tűnik ez bolondnak). Így az üres sor a fent a 01110 kódhoz tartozó karaktere. A 00 kódhoz a szóköz a sor elején a karakter. Azonnal elmondom, hogy ennek a tárolási módnak annyi, hogy ez a módszer a legkevésbé gazdaságos. De könnyen érthető és megvalósítható. Szívesen várom javaslataikat a hozzászólásokban az optimalizálással kapcsolatban.
Ezzel a táblázattal nagyon egyszerű a dekódolás. Emlékezzünk, milyen szabályt követtünk a kódolás létrehozásakor:
Egyetlen kód sem lehet másik kód előtagja
Itt játszik könnyítő szerepet. Folyamatosan olvassuk bitről bitre, és amint az így kapott d sztring, amely az olvasott bitekből áll, megegyezik a karakterhez tartozó kódolással, azonnal tudjuk, hogy a karaktert kódoltuk (és csak azt!). Ezután a karaktert rögzítjük a dekódoló sztringbe (amely a dekódolt üzenetet tartalmazza), nullázzuk az d sztringet, és tovább olvassuk a tömörített fájlt.
Megvalósítás
Elérkezett az idő, hogy végigjárjuk a kódom, és írjunk egy tömörítőt. Hívjuk ezt Compressor-nak.
Kezdjük az elején. Először írjuk meg a Node osztályt:
public class Node {
    private int frequence; // frekvencia
    private char letter; // betű
    private Node leftChild; // bal gyermek
    private Node rightChild; // jobb gyermek


    public Node(char letter, int frequence) { // a konstruktor
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} // a névtelen csomópontokhoz való konstruktor túlterhelése (lásd fent a Huffman-fa építésének részében)
    public void addChild(Node newNode) { // gyermek hozzáadása
        if (leftChild == null) // ha a bal üres => a jobb is üres => a balhoz adjuk hozzá
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) // a bal gyermek lesz a kisebb frekvenciájú
                rightChild = newNode; // az lesz, akinél kisebb a frekvencia
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); // összesített frekvencia
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { // levél ellenőrzése
        return leftChild == null && rightChild == null;
    }
}
Most a fára:
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Prioritási sor:
import java.util.ArrayList; // igen, a sor lista alapú lesz

class PriorityQueue {
    private ArrayList data; // a sor listája
    private int nElems; // az elemek száma a sorban

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // beszúrás
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { // ha a beszúrandó fa frekvenciája kisebb
                    data.add(i, newTree); // mint a jelenlegié, akkor jobbra tolva beszúrjuk
                    break; // majd a jelenlegi helyére tesszük az új fát
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // az elemek számát növeljük 1-el
    }

    public BinaryTree remove() { // eltávolítás a sorból
        BinaryTree tmp = data.get(0); // másoljuk az eltávolítandó elemet
        data.remove(0); // tulajdonképpen eltávolítjuk
        nElems--; // csökkentjük az elemek számát 1-el
        return tmp; // visszaadjuk az eltávolított elemet (a legkisebb frekvenciájú elemet)
    }
}
A Huffman-fát létrehozó osztály:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // a kódoló táblázat hossza
    private String myString; // üzenet
    private BinaryTree huffmanTree; // Huffman fa
    private int[] freqArray; // frekvencia táblázat
    private String[] encodingArray; // kódoló táblázat


    // ----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    // --------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    // ------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // az algoritmus fent van leírva
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // ha a karakter létezik a stringben
                Node newNode = new Node((char) i, freqArray[i]); // Node-ot kell létrehozni
                BinaryTree newTree = new BinaryTree(newNode); // és a Node-hoz BinaryTree-t
                pq.insert(newTree); // beszúrás a sorba
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // az első fa eltávolítása a sorból.

            try {
                BinaryTree tree2 = pq.remove(); // a második fa eltávolítása a sorból

                Node newNode = new Node(); // új Node létrehozása
                newNode.addChild(tree1.getRoot()); // az eltávolított fák leszármazottaiként való hozzáadása
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode));
            } catch (IndexOutOfBoundsException e) { // egy fa maradt a sorban
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    // -------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // a kódoló táblázat kitöltése
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // a hibakereséshez
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Kódoló táblázat====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    // -----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Osztály, amely kódol vagy dekódol:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // táblázat hossza
    private HuffmanTree mainHuffmanTree; // Huffman-fa (csak tömörítéshez használva)
    private String myString; // eredeti üzenet
    private int[] freqArray; // frekvencia-tábla
    private String[] encodingArray; // kódolási tábla
    private double ratio; // tömörítési arány

    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // tömörítéshez
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // kinyeréshez;

    // ---------------------------------------tömörítés-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // közbülső szöveg (hozzáadott nullák nélkül)
        // System.out.println("=============================Tömörítés=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // nullákat kell hozzáadni a végéhez (lehet 1, nincs különbség)
        byte counter = 0; // a végéhez hozzáadott nullák száma (byte elég: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta; counter++) { // delta - a hozzáadott nullák száma
            intermidiate += "0";
        }

        // a hozzáadott nullák számát összekapcsolni a bináris ábrázolásával és a közbülső szöveggel
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // idealizált arány
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // idealizált arány számítása
        double sumA = 0, sumB = 0; // A - az eredeti összeg
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // végső tömörítés
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
            compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------tömörítés vége----------------------------------------------------------------
    // ------------------------------------------------------------kinyerés-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // a hozzáadott nullák számának megkapása
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, mivel az első byte a hozzáadott nullák számát tartalmazza
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // ha egyezik
                    decompressed += (char) j; // akkor hozzáadjuk az elemet
                    current = ""; // és nullázzuk a jelenlegi szöveget
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char) i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }

    public void displayEncodingArray() { // a hibakereséshez
        System.out.println("======================Kódolási tábla====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
            System.out.print((char) i + " ");
            System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Osztály, amely megkönnyíti a fájlba írást:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Érvénytelen útvonal, vagy az a fájl nem létezik!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Osztály, amely megkönnyíti a fájlból való olvasást:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // ha a fájl véget ért
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
Nos, és a fő osztály:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try {\/\/megadjuk a parancssori argumentumokkal a műveletet
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            \t\t&& (args[2].equals("--table") || args[2].equals("-t"))) {
            \textract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Érvénytelen argumentumok formátuma");
            System.out.println("Olvassa el a Readme.txt fájlt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List<String> stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Érvénytelen útvonal, vagy a fájl nem létezik!");
            return;
        } catch (MalformedInputException e) {
        \tSystem.out.println("A fájl aktuális kódolása nem támogatott");
        \treturn;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        \tfo.writeBytes(operator.getBytedMsg());
        }
        \/\/kódolási táblázat fájl létrehozása:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        \tfo.writeString(operator.getEncodingTable());
        }

        System.out.println("A tömörített fájl útvonala: " + compressedFile.getAbsolutePath());
        System.out.println("A kódolási táblázat útvonala " + table.getAbsolutePath());
        System.out.println("A fájl táblázat nélkül nem lesz kinyerhető!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) \/ (double) 100;\/\/ideális arány
        double realRatio = Math.round((double) inputFile.length()
        \t\t\/ ((double) compressedFile.length() + (double) table.length()) * 100) \/ (double)100;\/\/valós arány

        System.out.println("Az ideális tömörítési arány: " + idealRatio);
        System.out.println("A kódolási táblázat figyelembevételével a tömörítési arány: " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        \t tableFile = new File(tablePath),
        \t extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        \/\/tömörített fájl beolvasása
        \/\/!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!ellenőrizze itt:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        \tbyte b;
        \twhile (true) {
        \t\tb = fi.readByte();\/\/a metódus EOFException-t ad vissza
        \t\tcompressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        \t}
        } catch (EOFException e) {
        \t\n        }

        \/\/--------------------

        \/\/kódolási táblázat beolvasása:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        \tfi.readLine();\/\/a első üres sor átugrása
        \tencodingArray[(byte)'n'] = fi.readLine();\/\/a 'n' kód beolvasása
        \twhile (true) {
        \t\tString s = fi.readLine();
        \t\tif (s == null)
        \t\t\tthrow new EOFException();
        \t\tencodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());        \t\t\n        \t}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        \/\/kibővítés:
\t\ttry (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
\t\t\tfo.writeString(operator.extract(compressed, encodingArray));
\t\t}
\t\t
\t\tSystem.out.println("A kibővített fájl útvonala " + extractedFile.getAbsolutePath());
    }
}
A readme.txt file with instructions must be written by you 🙂
Zárás
I guess that's all I wanted to say. If you have anything to say about my incompetence in code improvements, algorithms, or any optimization, feel free to write. If I missed something in my explanation, let me know as well. I would be glad to hear from you in the comments!
P.S.
Yes, yes, I'm still here, because I haven't forgotten about the coefficient. For the string s1, the encoding table is 48 bytes — much larger than the original file, and don’t forget about the added zeros (the number of added zeros is 7) => the compression ratio will be less than one: 176/(65 + 48*8 + 7)=0.38. If you noticed this too, then good on you. Yes, this implementation will be extremely inefficient for small files. But what happens with large files? The file sizes greatly exceed the size of the encoding table. It is here that the algorithm works as intended! For example, for the compressor gives a real (non-idealized) ratio of 1.46 — almost one and a half times! And yes, it was assumed that the file would be in English.
Forrás: habr.com
