

Üdvözlünk mindenkit, megosztjuk veletek a "Virtuális fájlrendszerek Linuxban: mire valóak és hogyan működnek?" című publikáció második részét. Az első részt itt olvashatjátok . Emlékeztetjük, hogy ez a publikációs sor egy új kurzus beindításához kapcsolódik , amely hamarosan elindul.
Hogyan figyelhetjük meg a VFS-t eBPF és bcc eszközökkel
A legjobb módja, hogy megértsük, hogyan dolgozik a kernel a fájlokkal sysfs – ha gyakorlatban is látjuk ezt, és a legkönnyebb megfigyelni az ARM64-et, ha eBPF-t használunk. Az eBPF (Berkeley Packet Filter rövidítése) egy virtuális gépből áll, amelyet a , amelyhez a jogosultsággal rendelkező felhasználók hozzáférhetnek (query) a parancssorból. A kernel forráskódja tájékoztatja az olvasót arról, hogy mit tud tenni a kernel; az eBPF eszközök futtatása egy terhelt rendszerben megmutatja, hogy valójában mit csinál a kernel.
Szerencsére az eBPF használata elég egyszerű az elérhető eszközök segítségével, amelyek a közös disztribúció részeként érhetők el és részletesen dokumentáltak . Az eszközök bcc Python script-ek, kis C kódrészletekkel, ami azt jelenti, hogy bárki, aki ismeri mindkét nyelvet, könnyen módosíthatja őket. A bcc/tools 80 Python scriptet tartalmaz, ami azt jelenti, hogy nagy valószínűséggel a fejlesztő vagy rendszergazda talál magának megfelelő megoldást a feladatára.
Ahhoz, hogy legalább egy felszínes betekintést nyerjünk arról, hogy a VFS milyen munkát végez a futó rendszeren, próbáljuk ki vfscount vagy vfsstat. Ez megmutatja, például, hogy a vfs_open() és barátai hívásai szó szerint minden másodpercben történnek. vfsstat.py
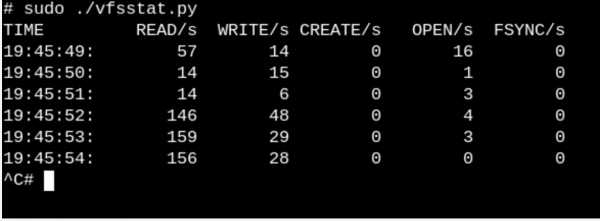
egy Python script, C kód beillesztésekkel, ami egyszerűen megszámolja a VFS funkciók hívásait.Nézzünk meg egy egyszerűbb példát, és figyeljük meg, mi történik, amikor USB flash meghajtót csatlakoztatunk a számítógéphez, és azt a rendszer észleli.
Az eBPF segítségével megnézhetjük, mi történik,
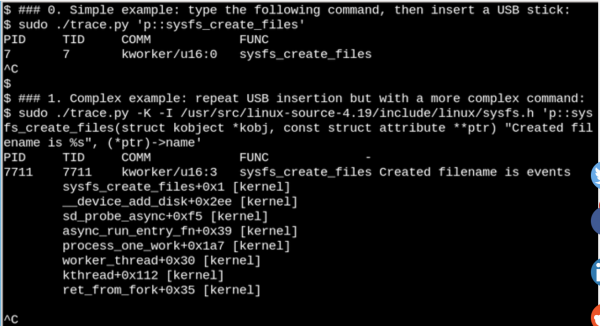
, amikor USB flash meghajtót csatlakoztatunk. Itt egy egyszerű és egy bonyolult példa látható.
/sysA fent bemutatott példa szerint
trace.py bcc továbbképzési támogatásért sysfs_create_files() parancs fut.Látjuk, hogy parancs fut. a kworker szálon keresztül indult, válaszul arra, hogy a flash meghajtót csatlakoztatták, de milyen fájl jött létre e közben? A második példa megmutatja az eBPF teljes erejét. Itt потока в ответ на то, что флешка была вставлена, но какой файл при этом создался? Второй пример показывает всю мощь eBPF. Здесь üzenetet ad ki, amikor a kimeneti nyomvonalat ad vissza (kernel backtrace) (-K opció) és a létrehozott fájl nevét parancs fut.. Az egysoros megjegyzések – egy C kód, amely tartalmaz egy könnyen felismerhető formátumot, amelyet a Python szkript biztosít, amely elindítja az LLVM-t just-in-time fordító. Ezt a sort lefordítja és végrehajtja a virtuális gépen a kernel belsejében. A funkcja teljes szignatúrája sysfs_create_files () meg kell, hogy reprodukálják a második parancsban, hogy a formátum hivatkozhasson az egyik paraméterre. A C kód ezen a részén lévő hibák nyilvánvaló C fordítói hibákhoz vezetnek. Például, ha a -l paraméter hiányzik, akkor a következő hibaüzenetet fogja kapni: „BFP szöveg lefordítási hiba.” Azok a fejlesztők, akik ismerik a C-t és a Python-t, az eszközöket bcc egyszerűnek találják a bővítéshez és módosításhoz.
Amikor a USB meghajtót csatlakoztatják, a kernel nyomvonal megmutatja, hogy a PID 7711 az a szál szálon keresztül indult, válaszul arra, hogy a flash meghajtót csatlakoztatták, de milyen fájl jött létre e közben? A második példa megmutatja az eBPF teljes erejét. Itt, amely létrehozta a fájlt „events” be. sysfs. Ennek megfelelően, a hívás a sysfs_remove_files() megmutatja, hogy a meghajtó eltávolítása a fájl eltávolítását eredményezte events, ami megfelel a hivatkozások számának általános fogalmának. Eközben a sysfs_create_link () eBPF-vel a USB meghajtó csatlakoztatásakor azt mutatja, hogy legalább 48 szimbolikus hivatkozás lett létrehozva.
Mi tehát az események fájl jelentősége? A felhasználásával keresve , kiderül, hogy ez a hívás a következőt indítja el: disk_add_events (), és vagy "media_change", vagy "eject_request" íródhat a események fájlba. Itt a kernel blokk rétege értesíti a userspace-t a „lemez” megjelenéséről és eltávolításáról. Figyelje meg, mennyire tájékoztató ez a kutatási módszer a USB meghajtó csatlakoztatása példájaként, szemben azzal, hogy csak az forráskódokból próbálják kideríteni, hogyan működik minden.
Az csak olvasható gyökér fájlrendszerek lehetővé teszik a beépített eszközöket
Természetesen senki sem kapcsolja ki a szerverét vagy a számítógépét azzal, hogy kihúzza a dugót a konnektorból. De miért? Azért, mert a fizikai tárolóeszközökön lévő csatlakoztatott fájlrendszerek késleltetett írásokat tartalmazhatnak, és az állapotuk rögzítésére szolgáló adatszerkezetek nem szinkronizálódhatnak a tárolás rögzítéseivel. Amikor ez megtörténik, a rendszertulajdonosok a következő indításra várnak, hogy elindítsák a fsck fájlrendszer-helyreállító programot, és a legrosszabb esetben adatokat veszthetnek.
Mindazonáltal mindannyian tudjuk, hogy sok IoT-eszköz, valamint route-erek, termosztátok és járművek most már Linux alatt működnek. Ezeknek az eszközöknek gyakorlatilag nincs felhasználói felületük, és nincs lehetőség a 'tisztán' való kikapcsolásukra. Képzelje el, hogy egy lemerült akkumulátorral indítja el az autót, amikor az irányító eszköz áramellátása folyton ugrál felfelé és lefelé. Hogyan lehetséges, hogy a rendszer hosszú fsckbeindítás nélkül elindul, amikor a motor végre működésbe lép? A válasz egyszerű. Az beágyazott eszközök a gyökér fájlrendszerre (rövidítve ro-rootfs (read-only root filesystem).
ro-rootfs Számos előnyük van, amelyek kevésbé nyilvánvalóak, mint a hamisítatlanság. Az egyik előnye, hogy a rosszindulatú szoftverek nem tudnak írni a /usr vagy /lib, ha egyetlen Linux folyamat sem tud oda írni. Egy másik előny az, hogy a nagymértékben változatlan fájlrendszer kulcsszerepet játszik a távoli eszközök terepi támogatásában, mivel a segédszemélyzet helyi rendszereket használ, amelyek névlegesen azonosak a helyszíni rendszerekkel. Talán a legfontosabb (de legszofisztikáltabb) előny az, hogy a ro-rootfs arra kényszeríti a fejlesztőket, hogy döntsék el, milyen rendszerobjektumok maradnak változatlanok, már a rendszer tervezési szakaszában. A ro-rootfs-lel való munka kényelmetlen és fájdalmas lehet, ahogy az gyakran előfordul a programozási nyelvek const változóival, de az előnyök könnyen megérik a további költségeket.
Módszer kidolgozása squashfs A csak olvasásra állapot némi plusz erőfeszítést igényel az beágyazott rendszerek fejlesztőitől, és itt jön be a VFS. A Linux megköveteli, hogy a fájlok a /var írásra elérhetők legyenek, sőt, sok népszerű alkalmazás, amely beágyazott rendszerekben fut, meg fog próbálni konfigurációs dot-fájlokat be. $HOMElétrehozni. Egyik megoldás az otthoni könyvtárban található konfigurációs fájlok számára általában az, hogy előre generálják és összefoglalják őket, squashfs. A /var az egyik lehetséges megközelítés az, hogy egy külön felosztáson írásra elérhetővé tesszük, míg maga a / csak olvasásra van csatolva. Egy másik népszerű alternatíva a kötött vagy átfedési csatolások (bind or overlay mounts) alkalmazása.
A kapcsolódó és rétegelt csatlakozások, használatuk a konténerekben
Parancs végrehajtása man mount – a legjobb módja annak, hogy megismerkedjünk a kapcsolódó és rétegelt csatlakozásokkal, amelyek lehetővé teszik a fejlesztők és rendszergazdák számára, hogy egy fájlrendszert egy útvonalon létrehozzanak, majd azt más alkalmazások számára biztosítsák. Beágyazott rendszerek esetén ez lehetőséget jelent az adatok tárolására /var olvasásra írásvédett flash meghajtón, de a csatlakozási vagy rétegelt csatlakozási útból tmpfs be. /var a rendszer indításakor lehetővé teszi az alkalmazások számára, hogy oda jegyzeteket írjanak (scrawl). A következő bekapcsoláskor a módosítások /var elvesznek. A rétegelt csatlakozás egy egyesítést teremt a tmpfs és az alapparmány fájlrendszer között, és lehetővé teszi a meglévő fájlok látszólagos módosításait ro-tootf míg a kapcsolódó csatlakozás új üres tmpfs mappákat láthatóvá tehet mint írásra elérhetőeket a ro-rootfs útvonalakon. Míg overlayfs az a megfelelő (proper) típusa a fájlrendszernek, a kapcsolódó csatlakozás a .
A rétegelt és kapcsolódó csatlakozás leírásának alapján senki sem lepődik meg, hogy a aktívan használják őket. Nézzük meg, mi történik, amikor használjuk konténer indításához a mountsnoop tól bcc.
Hívás a system-nspawn a konténer indításánál mountsnoop.py.
Nézzük meg, hogy sikerült:
Indítás mountsnoop a konténer „betöltése” során azt mutatja, hogy a konténer futási környezete erősen függ a kapcsolódó csatlakozástól (Csak a hosszú kimenet eleje jelenik meg).
Itt systemd-nspawn a kiválasztott fájlokat a procfs és sysfs gazda rendszerben a konténerbe mint útvonalként. squashfs. A MS_BIND zászló, amely a kapcsolódó csatlakozást beállítja, más egyéb zászlók a csatlakoztatott rendszerben meghatározzák a kapcsolatot a gazda névtér és a konténer közötti változások között. Például a kapcsolódó csatlakozás elengedheti a változásokat /proc és /sys a konténerbe, vagy elrejtheti azokat a hívástól függően.
Zárás
A Linux belső működésének megértése lehetetlennak tűnhet, mivel magának a kernelnek hatalmas mennyiségű kódja van, figyelmen kívül hagyva a Linux felhasználói tér alkalmazásait és a C nyelvű könyvtárak rendszerhívásainak interfészeit. glibc-t. Az egyik módja a fejlődés elérésének az, hogy elolvassuk a kernel egyik alrendszerének forráskódját, különös figyelmet fordítva a felhasználói térbe irányuló rendszerhívások és fejlécek megértésére, valamint a kernel fő belső interfészeire, például a táblázatra. file_operations. A fájlműveletek a „minden fájl” elvet képviselik, ezért a kezelésük különösen élvezetes. A kernel forrásfájljai C nyelven a legfelső szinten találhatóak. fs/ a virtuális fájlrendszerek megvalósítását kínálják, amelyek egy burkoló réteg, amely széleskörű és viszonylag egyszerű kompatibilitást biztosít a népszerű fájlrendszerek és tárolóeszközök között. A Linux névterekkel való összekapcsolás és az elhelyezés varázslata a VFS, amely lehetővé teszi a konténerek és az írásvédett gyökér fájlrendszerek létrehozását. A forráskód tanulmányozásával, az eBPF kernel eszközzel és annak interfészével bcc
a kernel kutatását könnyebbé teszik, mint valaha.
Barátok, írjátok meg, hasznos volt-e számotokra ez a cikk? Talán van valami megjegyzésetek vagy észrevételetek? Akiket érdekel a „Linux Rendszergazda” kurzus, azokat várjuk , amely április 18-án kerül megrendezésre.
Forrás: habr.com
