

Általában Nginx működésének nyomon követésére és elemzésére kereskedelmi termékeket vagy kész open-source alternatívákat használnak, mint például a Prometheus + Grafana. Ez egy jó megoldás a nyomon követéshez vagy valós idejű elemzéshez, de nem túl kényelmes a történeti analízishez. Bármely népszerű forráson az nginx naplókból származó adatok mennyisége gyorsan nő, és nagy adathalmazon történő elemzéshez érdemes valami specializáltabbat használni.
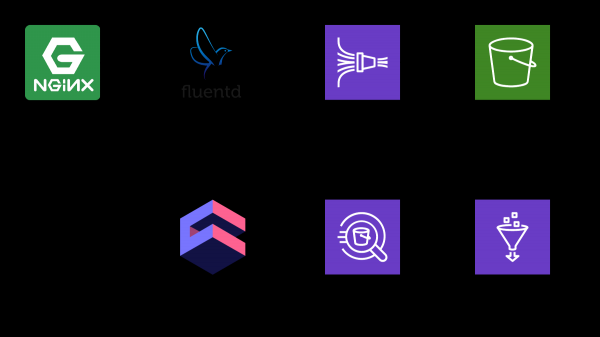
Ebben a cikkben bemutatom, hogyan lehet használni a naplók elemzésére, Nginx példáján keresztül, és megmutatom, hogyan lehet az adatokat elemezve analitikai műszerfalat készíteni az open-source cube.js keretrendszer használatával. Íme a megoldás teljes architektúrája:
Összefoglalva;
.
Az információk gyűjtéséhez használjuk , a feldolgozásához pedig és , a tároláshoz pedig . Ezzel a kombinációval nemcsak az nginx naplókat, hanem más eseményeket és más szolgáltatások naplóit is tárolhatjuk. Néhány részt helyettesíthet más, a saját technológiai stackedhez megfelelő elemekkel, például naplózhatsz közvetlenül a kinesisbe az nginxből, átugorva a fluentd-t, vagy használhatod a logstash-t ehhez.
Nginx naplók gyűjtése
Alapértelmezés szerint az Nginx naplók így néznek ki:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Ezeket ki lehet elemezni, de sokkal egyszerűbb megváltoztatni az Nginx konfigurációját, hogy JSON formátumban adja a naplókat:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 tárolásra
A naplók tárolásához az S3-at fogjuk használni. Ez lehetővé teszi a naplók egy helyen való tárolását és elemzését, mivel az Athena közvetlenül tud dolgozni az S3-ban lévő adatokkal. A cikk további részében bemutatom, hogyan kell megfelelően tárolni és feldolgozni a naplókat, de először szükségünk van egy tiszta S3 bucketre, amelyben más nem lesz tárolva. Érdemes előre gondolkodni, hogy melyik régióban hozod létre a bucketet, mivel az Athena nem áll rendelkezésre minden régióban.
Létrehozunk egy sémát az Athena konzolban
Létrehozunk egy táblázatot az Athena-ban a naplók számára. Erre szükség van íráshoz és olvasáshoz, ha Kinesis Firehose-t szeretne használni. Nyissa meg az Athena konzolt, és hozzon létre egy táblázatot:
SQL a táblázat létrehozásához
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Létrehozunk Kinesis Firehose Streamet
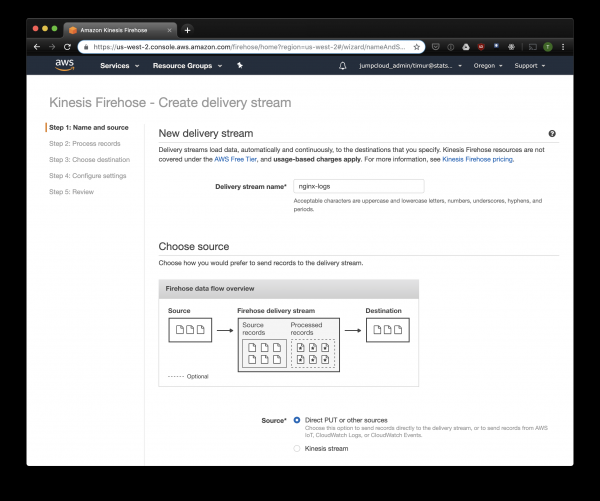
A Kinesis Firehose adatokat fog rögzíteni az Nginx-től S3-ba választott formátumban, az év/hónap/nap/óra formátumban csoportosítva. Ez hasznos lesz az adatok olvasásakor. Természetesen közvetlenül is írhat S3-ba fluentd-ből, de ebben az esetben JSON-t kell írnia, ami nem hatékony a fájlok nagy mérete miatt. Továbbá, ha PrestoDB-t vagy Athena-t használ, a JSON a leglassabb adatformátum. Nyissa meg a Kinesis Firehose konzolt, kattintson a „Create delivery stream” gombra, és válassza a „direct PUT” lehetőséget a „delivery” mezőben:
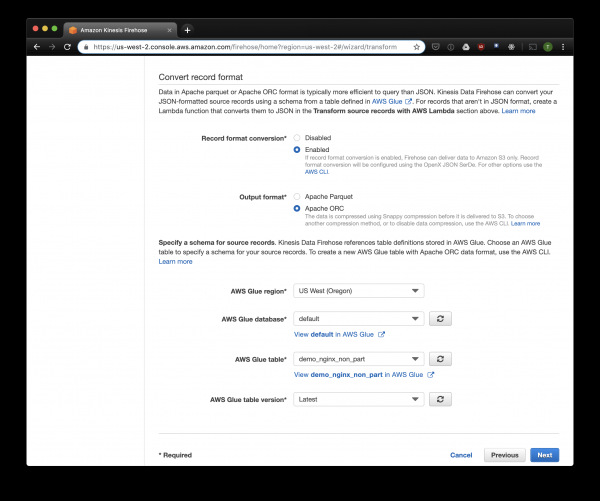
A következő fülön válassza a „Record format conversion” — „Enabled” lehetőséget, és válassza az „Apache ORC” formátumot az íráshoz. Egyes kutatások szerint , ez az optimális formátum a PrestoDB és az Athena számára. A sémaként a fent létrehozott táblázatot adjuk meg. Ne feledje, hogy a Kinesis S3 helyét bármire megadhatja, a táblázatból csak a séma kerül felhasználásra. De ha más S3 helyet ad meg, akkor ezeket a bejegyzéseket nem tudja elolvasni a táblázatból.
Válassza az S3-at a tároláshoz, és a korábban létrehozott vödröt. Az Aws Glue Crawler, amiről később beszélek, nem tud kezelni prefixeket az S3 vödörben, így fontos, hogy azt üresen hagyja.
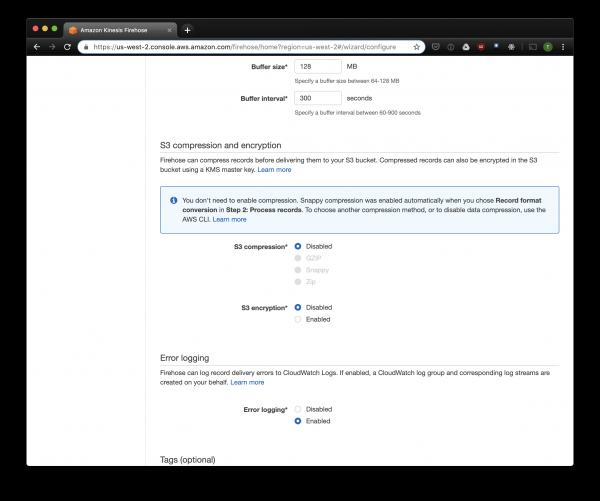
A többi opciót az Ön terhelésének megfelelően módosíthatja, én általában az alapértelmezetteket használom. Ne feledje, hogy az S3 tömörítés nem elérhető, de az ORC alapértelmezett tömörítést alkalmaz.
Fluentd
Most, hogy beállítottuk a naplók tárolását és lekérését, be kell állítanunk az elküldést. Azt fogjuk használni , mert szeretem a Ruby-t, de használhatja a Logstash-t vagy közvetlenül elküldheti a naplókat a Kinesis-be. A Fluentd szervert több módon is elindíthatja, én a dockerről fogok beszélni, mert ez egyszerű és kényelmes.
Először is szükségünk van egy fluent.conf konfigurációs fájlra. Hozza létre ezt és adja hozzá a forrást:
forward
port 24224
bind 0.0.0.0
Most már elindíthatjuk a Fluentd szervert. Ha részletesebb konfigurációra van szüksége, itt talál egy részletes útmutatót, beleértve azt is, hogyan készíthet saját képet.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Ez a konfiguráció az alábbi útvonalat használja /fluentd/log a naplók gyorsítótárazására a küldés előtt. E nélkül is elboldogulhat, de újraindításkor elveszítheti az összes kemény munkával gyorsítótárazott adatot. A port is szabadon választható, a 24224 a Fluentd alapértelmezett portja.
Most, hogy elindítottuk a Fluentd-t, küldhetjük oda az Nginx naplókat. Általában Docker konténerben futtatjuk az Nginx-t, és ebben az esetben a Docker rendelkezik egy natív naplókezelő driverről Fluentd-hez:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Ha az Nginx-t másképp futtatja, használhatja a naplófájlokat, Fluentd-ben van .
Adjuk hozzá a Fluent konfigurációhoz a fenti naplók parszolását:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
És küldjük a naplókat a Kinesis-be, használva a :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Ha minden helyesen van beállítva, akkor egy idő után (alapértelmezés szerint a Kinesis 10 percenként rögzíti az érkezett adatokat) látnia kell a naplófájlokat az S3-ban. A Kinesis Firehose "monitoring" menüjében láthatja, mennyi adat került rögzítésre az S3-ba, valamint az esetleges hibákat. Ne felejtse el megadni a Kinesis szerepének írási jogosultságát az S3 vödörhez. Ha a Kinesis nem tudott valamit parszolni, akkor az azonos vödörbe helyezi el a hibákat.
Most már megnézhetjük az adatokat az Athena-ban. Nézzük meg a legfrissebb lekérdezéseket, amelyekre hibákat adtunk át:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Minden rekord átvizsgálása minden lekérdezéskor
Most a naplóink feldolgozásra kerültek és az S3-ba ORC formátumban, tömörítve kerültek elhelyezésre és készen állnak az elemzésre. A Kinesis Firehose még könyvtárakba is rendezte őket óránként. Azonban amíg a táblázat nem particionált, az Athena minden lekérdezéskor az összes időre vonatkozó adatot betölti, kivételes esetektől eltekintve. Ez két okból is nagy probléma:
- Az adatmennyiség folyamatosan nő, lelassítva a lekérdezéseket;
- Az Athena díjait a lekérdezéskor átvizsgált adatmennyiség alapján számítják, legalább 10 MB-ot kérnek minden lekérdezésért.
A probléma megoldásához az AWS Glue Crawleert használjuk, amely átvizsgálja az S3 adatokat, és információt ír a particionálásról a Glue Metastore-ba. Ez lehetővé teszi, hogy a particionálásokat szűrőként használjuk az Athena lekérdezéseiben, és így csak azokat a könyvtárakat vizsgálja át, amelyeket a lekérdezésben megadtunk.
Amazon Glue Crawler beállítása
Az Amazon Glue Crawler az összes adatot átvizsgálja az S3 vödörben, és particionálással ellátott táblákat hoz létre. Hozzon létre Glue Crawleert az AWS Glue konzolból, és adja hozzá azt a vödröt, ahol az adatokat tárolja. Egy crawleert több vödrhöz is használhat, ekkor a megadott adatbázisban olyan táblákat hoz létre, amelyek nevei megegyeznek a vödrök neveivel. Ha folyamatosan használni kívánja ezeket az adatokat, ne felejtse el beállítani a Crawler futásának ütemezését az igényei szerint. Mi egyetlen crawleert használunk az összes táblához, amely minden órában fut.
Particionált táblák
Az első crawler futás után a beállításokban megadott adatbázisban tábláknak kell megjelennie minden átvizsgált vödör esetében. Nyissa meg az Athena konzolt, és keressen egy Nginx naplókkal rendelkező táblát. Próbáljunk meg valamit olvasni:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Ez a lekérdezés minden olyan rekordot kiválaszt, amely 2019. április 8-án, reggel 6 és 7 óra között készült. De mennyivel hatékonyabb ez, mint egyszerűen olvasni egy nem particionált táblából? Nézzük meg, és válasszuk ki ugyanazokat a rekordokat, időbélyeg alapján szűrve:
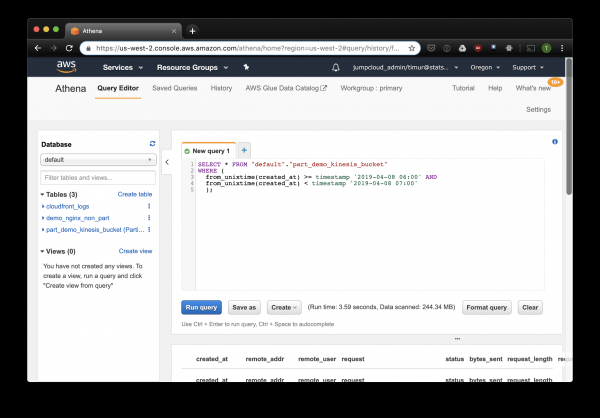
3,59 másodperc és 244,34 megabájt adat egy hétnyi naplóval rendelkező adatállományra vonatkoztatva. Próbáljunk szűrőt alkalmazni a particionálásokra:
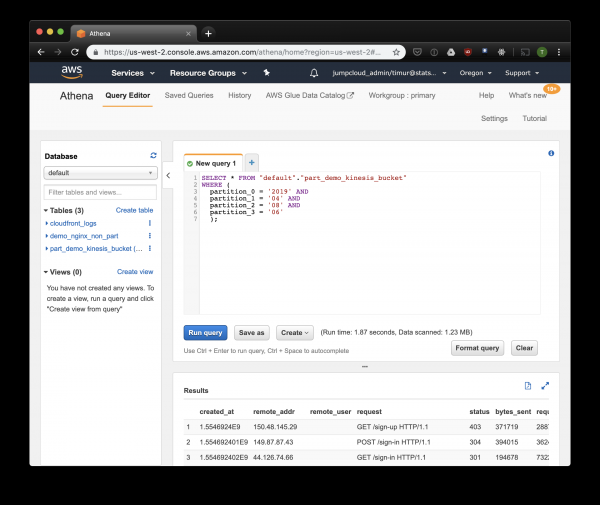
Kicsit gyorsabb, de ami a legfontosabb — mindössze 1,23 megabájt adat! Ez sokkal olcsóbb lenne, ha nem lenne a lekérdezési árban szereplő minimális 10 megabájt. De még így is sokkal jobban megéri, és nagyobb adatállományok esetén a különbség még figyelemreméltóbb lesz.
Собираем дэшборд с помощью Cube.js
A dashboard elkészítéséhez az Cube.js analitikai keretrendszert használjuk. Számos funkcióval rendelkezik, de minket két dolog érdekel: a particionálások automatikus szűrésének lehetősége és az adatok előaggregálása. Adatsémát használ, , amelyet Javascript nyelven írtak, hogy SQL-t generáljon és végrehajtsa a lekérdezést az adatbázisra. Csak annyit kell megadnunk, hogy hogyan használjuk a szűrőt az adatsémában.
Hozzunk létre egy új Cube.js alkalmazást. Mivel már az AWS stack-et használjuk, logikus a Lambda használata a telepítéshez. Használhatja az express sablont a generáláshoz, ha a Cube.js backendjét a Heroku-n vagy Docker-en tervezi hosztolni. A dokumentáció más módokat is ismertet. .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
A Cube.js-ben az adatbázishoz való hozzáférés beállításához környezeti változókat használnak. A generátor létrehoz egy .env fájlt, amelyben megadhatja kulcsait .
Most szükségünk van , amelyben megadjuk, hogy pontosan hogyan tárolják a naplóinkat. Itt lehet megadni, hogy hogyan számoljuk a metrikákat a műszerfalakhoz.
A könyvtárban schema, hozzon létre egy fájlt Logs.js. Íme egy példa az nginx adatmodelljére:
A modell kódja
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Igen`
        }],
        else: { label: `Nem` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Itt a változót használjuk , hogy generáljunk egy SQL lekérdezést partíciós szűrővel.
Emellett beállítjuk a metrikákat és paramétereket, amelyeket meg szeretnénk jeleníteni a műszerfalon, valamint megadjuk a pre-aggregációkat. A Cube.js további táblákat fog létrehozni pre-aggregált adatokkal, és automatikusan frissíteni fogja az adatokat a beérkezésük során. Ez nemcsak a lekérdezések gyorsítását teszi lehetővé, hanem csökkenti az Athena használatának költségeit is.
Ezt az információt a séma fájlba illesztjük:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
Azt jelezzük a modellben, hogy szükséges a metrikákhoz használt adatok pre-aggregálása, és havi partícionálást kell alkalmazni. jelentősen felgyorsíthatja az adatok gyűjtését és frissítését.
Most már összegyűjthetjük a műszerfalat!
A Cube.js háttere biztosítja és a legnépszerűbb frontend keretrendszerekhez való klienskönyvtárakat. A dásbórd összegyűjtéséhez a React kliens változatát fogjuk használni. A Cube.js csak adatokat biztosít, így szükségünk lesz egy vizualizáló könyvtárra — nekem tetszik a , de bármelyik másikat is használhatod.
A Cube.js szerver JSON formátumban fogadja a kéréseket { "measures": ["Logs.errorCount"], "timeDimensions": [ { "dimension": "Logs.createdAt", "dateRange": ["2019-01-01", "2019-01-07"], "granularity": "day" } ] }
Telepítsük a Cube.js klienst és a React komponenst az NPM-en keresztül:$ npm i --save @cubejs-client/core @cubejs-client/react
Importáljuk acubejs QueryRenderer és , hogy ki tudjuk nyerni az adatokat, és összegyűjtjük a dásbórdot:A dásbórd kódja
import React from 'react'; import { LineChart, Line, XAxis, YAxis } from 'recharts'; import cubejs from '@cubejs-client/core'; import { QueryRenderer } from '@cubejs-client/react';const cubejsApi = cubejs( 'YOUR-CUBEJS-API-TOKEN', { apiUrl: 'http://localhost:4000/cubejs-api/v1' }, );export default () => { return ( { if (!resultSet) { return 'Betöltés...'; }return ( ); }} /> ) }
A dásbórd forrásai elérhetőek aCodeSandbox .
Forrás: habr.com
