

A SciPy (kiejtve: száj-páj) egy alkalmazott matematikai eljárások csomagja, amely a Python Numpy kiterjesztésére épül. A SciPy segítségével a Python interaktív ülése olyan teljes értékű adatelőkészítési és bonyolult rendszerek prototípus-készítési környezetté válik, mint a MATLAB, IDL, Octave, R-Lab és SciLab. Ma röviden szeretném bemutatni, hogyan lehet néhány ismert optimalizálási algoritmust alkalmazni a scipy.optimize csomagban. Részletes és aktuális útmutatót a funkciók használatáról mindig a help() parancs segítségével vagy a Shift+Tab billentyűkombinációval kaphatunk.
Bevezetés
Annak érdekében, hogy megkíméljem magam és az olvasókat a források keresésétől és olvasásától, a módszerek leírásaira mutató hivatkozások jellemzően a Wikipédiára fognak mutatni. Általában ez az információ elegendő a módszerek általános megértéséhez és a használati körülményeikhez. A matematikai módszerek lényegének megértéséhez az alább mellékelt hivatkozásokon keresztül elérhető, hitelesebb publikációkhoz mehetünk, amelyeket minden cikk végén vagy a kedvenc keresőmotorunkban találhatunk.
Tehát a scipy.optimize modul az alábbi eljárások megvalósítását tartalmazza:
- Feltételes és feltétel nélküli minimalizálás skaláris többváltozós funkciók esetében (minim) különböző algoritmusok segítségével (Nelder-Mead simplex, BFGS, Newton-féle konjugált gradiens, és )
- Globális optimalizálás (például: , )
- Maradékok minimalizálása (least_squares) és a nemlineáris MNK (curve_fit) görbeillesztési algoritmusai
- Egyszeri változós skaláris funkciók minimalizálása (minim_scalar) és gyökök keresése (root_scalar)
- Többdimenziós egyenletrendszerek megoldói (root) különböző algoritmusokkal (hibrid Powell, vagy nagyszabású módszerek, mint például ).
Ebben a cikkben csak a lista első pontját vesszük szemügyre.
Feltétel nélküli minimalizálás skaláris többváltozós funkciók
A scipy.optimize csomag minim függvénye egy általános interfészt biztosít a skaláris többváltozós funkciók feltételes és feltétel nélküli minimalizálásának megoldására. Annak bemutatására, hogyan működik, szükségünk lesz egy megfelelő többváltozós függvényre, amelyet különböző módon fogunk minimalizálni.
Ezekhez a célokhoz tökéletesen megfelel a Rosenbrock-függvény N változón, amelynek alakja:

Bár a Rosenbrock-függvény és a Jacobian és Hessian mátrixai (első és második derivált) már definiálva vannak a scipy.optimize csomagban, határozzuk meg saját magunk.
import numpy as np

def rosen(x):
    """A Rosenbrock-függvény"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Az áttekinthetőség kedvéért 3D-ben ábrázoljuk a Rosenbrock-függvény értékeit két változóból.
Kód az ábrázoláshoz
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Beállítjuk a 3D grafikont
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Megadjuk a nézö szöget
ax.view_init(45, 30)

# Létrehozzuk az adatokat a grafikához
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Kirajzoljuk a felületet
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
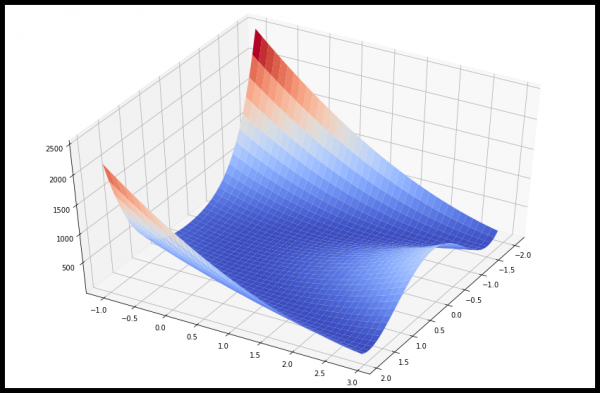
Tudva, hogy a minimum értéke 0, amikor  , tekintsük meg, hogyan lehet meghatározni a Rosenbrock-függvény minimumát a különböző scipy.optimize eljárások segítségével.
Nelder-Mead simplex módszer
Legyen egy kezdeti pont x0 az 5 dimenziós térben. Keressük meg a Rosenbrock-függvény legközelebbi minimum pontját az algoritmus segítségével (az algoritmus a method paraméter értékeként van megadva):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalizálás sikeresen befejeződött.
Aktuális függvényérték: 0.000000
Iterációk: 339
Függvényértékelések: 571
[1. 1. 1. 1. 1.]A simplex módszer a legegyszerűbb módja egy jól definiált és viszonylag sima függvény minimumra csökkentésének. Nem igényli a függvény deriváltainak kiszámítását, elegendő csak az értékeit megadni. A Nelder-Mead módszer jó választás egyszerű optimalizálási feladatokhoz. Azonban, mivel nem használ gradiensbecsléseket, a minimum megtalálásához több időre lehet szükség.
Powell-módszer
Egy másik optimalizáló algoritmus, amely csak a függvények értékeit számítja ki, a Ahhoz, hogy használni tudjuk, be kell állítani a method = 'powell' értéket a minimizáló függvényben.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalizálás sikeresen befejeződött.
Aktuális függvényérték: 0.000000
Iterációk: 19
Függvényértékelések: 1622
[1. 1. 1. 1. 1.]Broyden-Fletcher-Goldfarb-Shanno (BFGS) algoritmus
A megoldásra való gyorsabb konvergencia érdekében eljárás a célfüggvény gradiensét használja. A gradiens megadható egy függvény formájában, vagy első rendű differenciálással kiszámítható. Mindenesetre a BFGS módszer általában kevesebb függvényhívást igényel, mint a szimplex módszer.
Keressük meg a Rosenbrock-függvény analitikus deriváltját:


Ez a kifejezés minden változó deriváljára érvényes, kivéve az elsőt és az utolsót, amelyek a következőképpen határozhatók meg:


Nézzük meg a Python függvényt, amely kiszámítja ezt a gradienst:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: - 2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm-xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1-xm)
    der [0] = -400 * x [0] * (x [1] -x [0] ** 2) - 2 * (1-x [0])
    der [-1] = 200 * (x [-1] -x [-2] ** 2)
    return der
A gradiens számító függvényt a jac paraméter értékeként adjuk meg a minimizáló függvényben, az alábbiak szerint.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Az optimalizálás sikeresen befejeződött.
Jelenlegi függvényérték: 0.000000
Iterációk: 25
Függvényértékelések: 30
Gradiensértékelések: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]A párhuzamos gradiens algoritmus (Newton-módszer)
SHA-1 a Newton-módszer módosított változata.
A Newton-módszer a függvény lokális környezetében másodfokú polinommal közelít.

ahol  a második deriváltak mátrixa (Hesse-mátrix, hesszian).
Ha a hesszian pozitív definit, akkor e függvény lokális minimumát a kvadratikus forma nullára állításával találhatjuk meg. Az eredmény egy kifejezés lesz:

A fordított hesszián a párhuzamos gradiens módszerrel számítható ki. Az alábbiakban bemutatjuk ezt a módszert a Rosenbrock-függvény minimalizálására. A Newton-CG módszer használatához meg kell adni egy függvényt, amely kiszámítja a hessziánt.
A Rosenbrock-függvény hessziánja analitikus formában a következő:


ahol  és
 , meghatározza a mátrixot
 .
A mátrix többi nemnulla eleme a következő:


Például az öt dimenziós térben N = 5, a Rosenbrock-függvény Hesse-mátrixa sávos formájú:

A kód, amely kiszámítja ezt a hessziánt, valamint a Rosenbrock-függvény minimalizálására szolgáló kód a párhuzamos gradiens módszer (Newton) segítségével:
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Az optimalizálás sikeresen befejeződött.
Aktuális függvényérték: 0.000000
Iterációk száma: 24
Függvényértékelések: 33
Grádiensértékelések: 56
Hessián-értékelések: 24
[1. 1. 1. 0.99999999 0.99999999]Példa a hesszián szorzatának és egy tetszőleges vektornak a meghatározására
Valódi feladatok esetén a Hess-mátrix teljes számítása és tárolása jelentős idő- és memóriaforrást igényelhet. Valójában azonban nincs szükség a Hess-mátrix megadására, mivel a minimalizálási eljáráshoz csak egy vektorra van szükség, amely a hesszián és egy másik tetszőleges vektor szorzataként áll elő. Így számítási szempontból sokkal előnyösebb, ha azonnal egy olyan függvényt határozunk meg, amely visszaadja a hesszián és a tetszőleges vektor szorzatának eredményét.
Tekintsük a hess függvényt, amely a minimalizálandó vektort veszi első argumentumként, a tetszőleges vektort pedig második argumentumként (a minimalizálandó függvény további argumentumai mellett). A Rosenbrock-függvény hessziánjának tetszőleges vektorral való szorzásának kiszámítása nem túl bonyolult. Ha p — tetszőleges vektor, akkor a szorzat  a következőképpen néz ki:

A hess és tetszőleges vektor szorzatát kiszámító függvényt az hessp argumentum értékeként adjuk meg a minimize függvényhez:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Az optimalizálás sikeresen befejeződött.
         Aktuális függvényérték: 0.000000
         Iterációk száma: 24
         Függvényértékelések: 33
         Grádiensértékelések: 56
         Hessián-értékelések: 66
A bizalmi zóna (trust region) módszere a párhuzamos gradiens (Newton) algoritmusokhoz
A Hess-mátrix gyenge kondicionáltsága és a hibás keresési irányok azt eredményezhetik, hogy a Newton-féle párhuzamos gradiens algoritmus nem hatékony. Ilyen esetekben előnyben részesítjük (trust-region) a Newton-féle párhuzamos gradienshez.
Példa a Hess-mátrix meghatározására:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Az optimalizálás sikeresen befejeződött.
Jelenlegi függvényérték: 0.000000
Iterációk: 20
Függvényértékelések: 21
Gradiensértékelések: 20
Hesszián értékelések: 19
[1. 1. 1. 1. 1.]Példa a hesszián és egy tetszőleges vektor szorzataként:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Az optimalizálás sikeresen befejeződött.
Jelenlegi függvényérték: 0.000000
Iterációk: 20
Függvényértékelések: 21
Gradiensértékelések: 20
Hesszián értékelések: 0
[1. 1. 1. 1. 1.]Krylov-típusú módszerek
A trust-ncg módszerhez hasonlóan a Krylov-típusú módszerek is jól alkalmazhatók nagyszabású problémák megoldására, mivel csak mátrix-vektor szorzatokat használnak. Ezek lényege, hogy a problémát a Krylov-tér által korlátozott bizalmi tartományban oldják meg. Határozatlan problémák esetén érdemes ezt a módszert alkalmazni, mivel a nemlineáris iterációk száma kevesebb, így kevesebb mátrix-vektor szorzatra van szükség egy alsófeladat esetén a trust-ncg-hez képest. Ezenkívül a kvadratikus alsófeladat megoldása pontosabb, mint a trust-ncg módszerrel.
Példa a Hess-mátrix meghatározására:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Az optimalizálás sikeresen befejeződött.
         Jelenlegi függvényérték: 0.000000
         Iterációk: 19
         Függvényértékelések: 20
         Gradiensértékelések: 20
         Hesszián értékelések: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Példa a hesszián és egy tetszőleges vektor szorzataként:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Az optimalizálás sikeresen befejeződött.
         Jelenlegi függvényérték: 0.000000
         Iterációk: 19
         Függvényértékelések: 20
         Gradiensértékelések: 20
         Hesszián értékelések: 0

print(res.x)

    [1. 1. 1. 1. 1.]
A bizalmi tartományban történő közelítő megoldás algoritmusa
Minden módszer (Newton-CG, trust-ncg és trust-krylov) jól illeszkedik a nagyszabású problémákhoz (ezrekből álló változóval). Ez azért van, mert az alapjául szolgáló konjugált gradiens algoritmus lehetővé teszi a hesszián közelítő inverzének meghatározását. A megoldás iteratívan található meg, anélkül hogy a hessziánt explicit módon bontanák le. Mivel csak a hesszián és egy tetszőleges vektor szorzataként szükséges meghatározni a függvényt, ez az algoritmus különösen jól működik ritka (sávos diagonális) mátrixokkal. Ez alacsony memóriaigényt és jelentős időmegtakarítást biztosít.
A közepes méretű feladatokban a tárolási és Hessian faktorálási költségek nem döntő fontosságúak. Ez azt jelenti, hogy a megoldás kevesebb iterációval érhető el, ha a bizalmi tartomány alfeladatait szinte pontosan oldjuk meg. Ehhez néhány nemlineáris egyenletet iteratívan oldanak meg minden kvadratikus alfeladatnál. Ezen megoldás általában 3 vagy 4 Cholesky-felbontást igényel a Hessian mátrixból. Ennek eredményeként a módszer kevesebb iterációval konvergál, és kevesebb célfüggvény-kiszámítást igényel, mint más megvalósított bizalmi tartomány módszerek. Ez az algoritmus csak a teljes Hessian mátrix meghatározását igényli, és nem támogatja a Hessian és egy tetszőleges vektor szorzatának felhasználását.
Példa a Rosenbrock-függvény minimalizálására:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Az optimalizálás sikeresen befejeződött.
Jelenlegi függvény érték: 0.000000
Iterációk száma: 13
Függvényértékelések: 14
Gradiensevaluációk: 13
Hessian értékelések: 14
array([1., 1., 1., 1., 1.])Ezen a ponton talán megállunk. A következő cikkben megpróbálom elmondani a legérdekesebb dolgokat a feltételes minimalizálásról, a minimalizálás alkalmazásáról az apják megoldási problémáiban, az egyváltozós függvények minimalizálásáról, tetszőleges minimalizálókról és a rendszer egyenleteinek gyökeinek kereséséről a scipy.optimize csomag segítségével.
Forrás:
Forrás: habr.com
