

Ebben a cikkben arról beszélünk, hogy miért és hogyan fejlesztettük ki – egy mechanizmus, amely információt továbbít az ügyfélalkalmazások és az 1C:Enterprise szerverek között – a feladat megfogalmazásától a rendszerarchitektúra és a megvalósítás részleteinek átgondolásáig.
Az Interakciós Rendszer (továbbiakban – IR) egy elosztott, hibatűrő üzenetváltó rendszer, amely garantálja az üzenetek kézbesítését. Az IR-t egy magasan terhelt szolgáltatásként tervezték, amely széleskörű skálázhatósággal rendelkezik, elérhető online szolgáltatásként (az 1C cég kínálja), és mint forgalmazott termék, amely saját szerverhardveren is telepíthető.
Az IR elosztott tárolót és keresőrendszert használ. Ezenkívül beszélni fogunk a Javáról és arról, hogyan skálázzuk vízszintesen a PostgreSQL-t.
Lépjünk át a kitűzött feladatra: írjunk egy XDP mechanizmust SYN cookie-kkal.
Hogy érthető legyen, miért készítettük az Interakciós Rendszert, mesélek egy kicsit arról, hogyan zajlik az üzleti alkalmazások fejlesztése az 1C-nél.
Elsőként egy kicsit magunkról, azok számára, akik még nem tudják, mivel foglalkozunk:) Mi készítjük az „1C:Enterprise” technológiai platformot. A platform tartalmazza az üzleti alkalmazások fejlesztési eszközét, valamint egy runtime-ot, amely lehetővé teszi az üzleti alkalmazások működését cross-platform környezetben.
Klient-szerver fejlesztési paradigma
Az „1C:Enterprise” keretében készült üzleti alkalmazások háromszintű architektúrában működnek: „DBMS – alkalmazás szerver – kliens”. Az 1C , futtatható az alkalmazás szerveren vagy a kliensen. Az összes alkalmazási objektummal (könyvtárak, dokumentumok stb.) való munka, valamint az adatbázis olvasása és írása kizárólag a szerveren történik. A űrlapok és a parancssori interfész funkcionalitása szintén a szerveren valósul meg. A kliensen az űrlapok lekérése, megnyitása és megjelenítése, a felhasználóval való „kommunikáció” (figyelmeztetések, kérdések…), a gyors reakciót igénylő kisebb számítások (például az ár mennyiséggel való szorzása), a helyi fájlok kezelése és a hardverrel való munka történik.
Az alkalmazáskód eljárásainak és funkcióinak fejlécében egyértelműen meg kell határozni, hogy hol fog végrehajtódni a kód – a &OnClient / &OnServer (&AtClient / &AtServer az angol nyelvű változatban) direktívák segítségével. Az 1C fejlesztői most javítani fogják ezt, mondván, hogy a direktívák valójában , de ez most számunkra nem lényeges.
A kliens kódja meg tudja hívni a szerver kódját, de a szerver kódja nem tudja hívni a kliens kódját. Ez egy alapvető korlátozás, amelyet számos okból vezettünk be. Különösen azért, mert a szerver kódját úgy kell megírni, hogy bárhonnan egyformán fusson – akár a kliensről, akár a szerverről hívják. Ha a szerver kódját egy másik szerver kódja hívja, a kliens mint olyan hiányzik. Továbbá, a szerver kód végrehajtása során a kliens, amelyik hívta, leállhat, és így már nem lesz senki, akit a szerver hívhatna.

A gombnyomás kezelését végző kód: a kliensről a szerver procedural hívása működik, de a szerverről a kliens procedural hívása nem.
Ez azt jelenti, hogy ha a szervertől valamilyen üzenetet szeretnénk átadni a kliensalkalmazásnak, például arról, hogy befejeződött egy "hosszú távú" beszámoló készítése, és megtekinthető – ilyen mód nincs. Kényszerülünk trükkökre, például, hogy a kliens kódja időnként lekérdezze a szervert. De ez a megközelítés felesleges hívásokkal terheli a rendszert, és egyáltalán nem tűnik elegánsnak.
Emellett szükség van például arra, hogy egy bejövő telefonszól: -ről értesítse a kliensalkalmazást, hogy a hívó szám alapján megtalálja a hívó partnerét az adatbázisban, és megjelenítse a felhasználó számára a hívó partner adatait. Vagy például, hogy a raktárba érkező rendelésről értesítse a kliensalkalmazást a megrendelőt. Összességében rengeteg olyan eset van, amikor hasznos lenne egy ilyen mechanizmus.
Lényegében a feladat
Egy üzenetküldő mechanizmust létrehozni. Gyors, megbízható, garantált kézbesítéssel, rugalmas üzenetkeresési lehetőséggel. A mechanizmus alapján megvalósítani egy messenger-t (üzenetek, videohívások), amely belsőleg működik az 1C alkalmazásokon belül.
Horizontálisan skálázható rendszert tervezni. A növekvő terhelésnek a csomópontok számának növelésével kell megoldódnia.
Megvalósítás
A szerveroldali megoldásunkat nem közvetlenül az 1C:Enterprise platformba integráltuk, hanem külön termékként valósítottuk meg, amelynek API-ját az 1C alkalmazási megoldások kódjából lehet hívni. Ezt számos ok miatt tettük, a legfőbb ok az volt, hogy lehetővé tegyük az üzenetek cseréjét különböző 1C alkalmazások között (például a Kereskedelmi Menedzsment és a Számvitel között). Különböző 1C alkalmazások különböző verziókon, különböző szervereken stb. működhetnek. Ilyen körülmények között a szerveroldali megoldás külön termékként való megvalósítása, ami „külön” található az 1C telepítésektől, optimális megoldás.
Tehát úgy döntöttünk, hogy a szerveroldali megoldást külön termékként készítjük el. A kisvállalkozásoknak azt javasoljuk, hogy használják az általunk a felhőnkben telepített szerveroldali megoldást (wss://1cdialog.com), hogy elkerüljék a helyi telepítéssel és beállítással járó költségeket. A nagyobb ügyfelek viszont célszerűnek találhatják saját szerveroldali megoldásuk telepítését a saját infrastruktúrájukon. Hasonló megközelítést alkalmaztunk a felhőalapú SaaS termékünkben. – ez egy forgalmazott termék, amelyet a klienseknél is telepítenek, és a felhőnkben is üzemel. .
Az alkalmazás
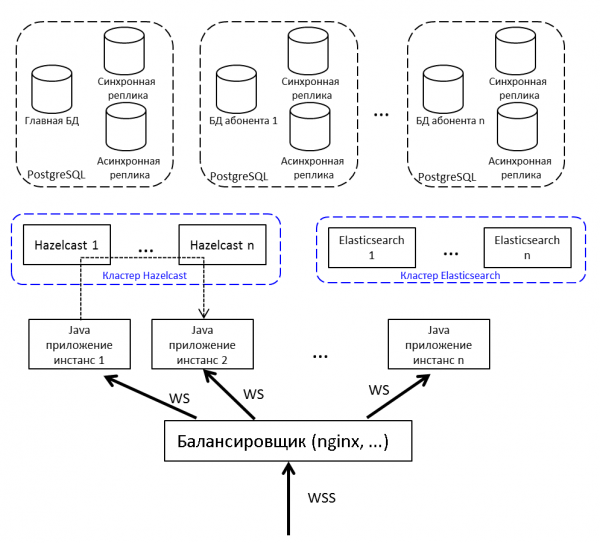
A terhelés elosztása és a hibatűrés érdekében nem egy Java alkalmazást telepítünk, hanem többet, és elhelyezünk eléjük egy terheléselosztót. Ha üzenetet kell átadnunk egy csomópontból a másikba, a publish/subscribe megoldást használjuk a Hazelcast-ban.
A kliens kommunikációja a szerverrel websocketen keresztül történik. Ez jól illeszkedik a valós idejű rendszerekhez.
Elosztott gyorsítótár
A Redis, Hazelcast és Ehcache között választottunk. 2015 van. A Redis csak most adta ki az új klasztert (túl új, félelmetes), van Sentinel sok korlátozással. Az Ehcache nem tud klaszterben működni (ez a funkció később jelent meg). Úgy döntöttünk, hogy kipróbáljuk a Hazelcast 3.4-et.
A Hazelcast „do-it-yourself” klaszterezésre képes. Egycsomópontos módban nem sok haszna van, és csak gyorsítótárként használható – nem képes adatokat lemezre menteni, ha elveszítjük az egyetlen csomópontot, elveszítjük az adatokat. Több Hazelcast-ot telepítünk, közöttük kritikus adatokat mentünk. A gyorsítótárat nem mentjük – azt nem sajnáljuk.
Számunkra a Hazelcast jelentése:
- Felhasználói munkamenetek tárolása. Minden alkalommal, amikor az adatbázisban kellene keresni a munkamenetet, az túl hosszú időt vesz igénybe, ezért minden munkamenetet a Hazelcast-ba helyezünk.
- Cache. Ha felhasználói profilt keresel – ellenőrizd a cache-ben. Írtál egy új üzenetet – tedd a cache-be.
- Alkalmazáspéldányok közötti kommunikációs topikok. A csomópont eseményt generál és elhelyezi azt a Hazelcast topikban. Az alkalmazás többi csomópontja, amelyek feliratkoztak erre a topikra, megkapják és feldolgozzák az eseményeket.
- Klsterzárak. Például létrehozunk egy beszélgetést egyedi kulccsal (singleton beszélgetés az 1C adatbázis keretein belül):
conversationKeyChecker.check("BEMBOLVÁNY");

      doInClusterLock("BEMBOLVÁNY", () -> {

          conversationKeyChecker.check("BEMBOLVÁNY");

          createChannel("BEMBOLVÁNY");
      });
Ellenőriztük, hogy a csatorna nem létezik. Zárat vettünk, újra ellenőriztük, létrehoztuk. Ha a zárlat felvétele után nem ellenőrizzük, akkor fennáll annak a lehetősége, hogy egy másik szál is ellenőrizte és most próbál létrehozni ugyanazt a beszélgetést – és az már létezik. A zárolást synchronizált módon vagy sima java Lock-kal nem lehet végezni. Az adatbázison keresztül – lassú, és a database-ot kár lenne így használni, a Hazelcast-on keresztül – éppen ez a megoldás.
Válasszuk ki az adatbázis-kezelő rendszert.
Nagy és sikeres tapasztalatunk van a PostgreSQL-lal való munkában és az e rendszer fejlesztőivel való együttműködésben.
A PostgreSQL klasztereknél nem egyszerű – van , , , de alapvetően nem noSQL, amely eleve skálázható. A noSQL rendszert fő tárolóhelynek nem tartottuk megfelelőnek, elegendő volt, hogy a Hazelcast-ot választottuk, amellyel előtte nem dolgoztunk.
Ha skálázni kell a relációs adatbázist – akkor . Ahogy tudod, shardingnál az adatbázist különböző részekre bontjuk, hogy mindegyiket külön szerverre lehessen elhelyezni.
A sharding első megoldása lehetővé tette, hogy az alkalmazásunk minden tábláját különböző arányokban különböző szerverekre osszuk. Sok üzenet az A szerveren – kérlek, mozgassuk át a tábla egy részét a B szerverre. Ez a megoldás egyértelműen a korai optimalizálásról árulkodott, ezért úgy döntöttünk, hogy a multi-tenant megközelítéssel korlátozódunk.
A multi-tenant-ról olvashatsz például a .
A Szerver Környezetben léteznek alkalmazás és előfizető fogalmak. Az alkalmazás egy konkrét üzleti alkalmazás telepítése, például ERP vagy Könyvelés, saját felhasználókkal és üzleti adatokkal. Az előfizető az a szervezet vagy magánszemély, akinek nevében az alkalmazás regisztrálva van a Szerver Környezeten. Az előfizetőnek lehet több regisztrált alkalmazása, és ezek az alkalmazások üzeneteket is küldhetnek egymás között. Az előfizető lett a bérlő a rendszerünkben. Több előfizető üzenetei egy fizikai adatbázison belül lehetnek; ha látjuk, hogy egy előfizető sok forgalmat generál, átkerül egy külön fizikai adatbázisba (vagy akár egy külön DB szerverre).
Van egy fő DB-nk, ahol a routing táblázatot tároljuk, amely az összes előfizető adatbázis helyéről tartalmaz információt.
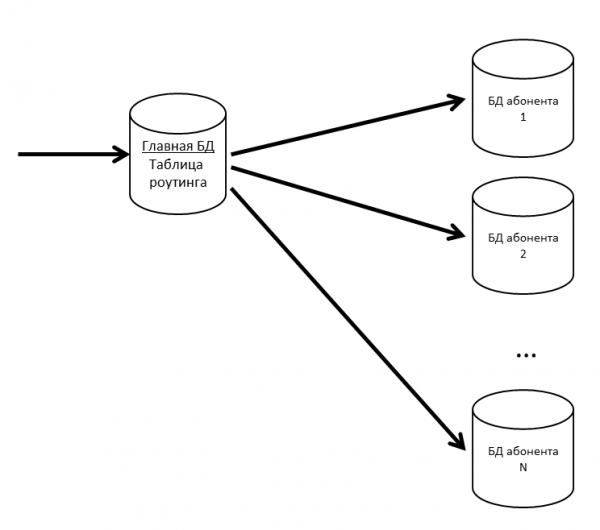
Annak érdekében, hogy a fő DB ne legyen szűk keresztmetszet, a routing táblázatot (és más gyakran használt adatokat) cachen tartjuk.
Ha az előfizető DB elkezd lassulni, belsőleg particionálni fogjuk. Más projektekben nagy táblák particionálásához használjuk .
Mivel rossz elveszíteni a felhasználói üzeneteket, fenntartjuk az adatbázisainkat replikák formájában. A szinkron és aszinkron replikák kombinációja segít abban az esetben, ha az alapadatbázis elveszne. Üzenetvesztés csak akkor következik be, ha az alapadatbázis és a szinkron replikája egyidejűleg meghibásodik.
Ha a szinkron replika elveszik, az aszinkron replika szinkronreplikává válik.
Ha az alapadatbázis elveszik, a szinkron replika lesz az alapadatbázis, az aszinkron replika pedig szinkron replikává válik.
Elasticsearch a kereséshez
Mivel a Szerver Környezet egy üzenetküldő is, gyors, kényelmes és rugalmas keresés szükséges, figyelembe véve a morfológiát és a pontatlan egyezéseket. Úgy döntöttünk, hogy nem találjuk fel újra a kereket, és a nyílt forráskódú Elasticsearch keresőrendszert használjuk, amelyet a könyvtár alapján készítettek. Az Elasticsearch-t is klaszterben telepítjük (master - data - data), hogy kizárjuk a problémákat az alkalmazáscsomópontok meghibásodása esetén.
A github-on találtunk Az Elasticsearch használatával. Az Elasticsearch indexben a szavak gyökereit (amelyeket a bővítmény határoz meg) és N-grammokat tárolunk. Ahogy a felhasználó beírja a keresett szöveget, mi keresünk az N-grammok között. Amikor az 'szövegek' szót mentjük el az indexbe, az a következő N-grammokra bontható:
[te, tek, teks, szöveg, szövegek, ek, eks, eksz, ekszt, ksz, kst, kst, szt, sztk, te],
A 'szöveg' szó gyökere is mentésre kerül. Ez a megközelítés lehetővé teszi, hogy a szót keresni tudjuk a kezdetén, közepén és végén is.
Áttekintés
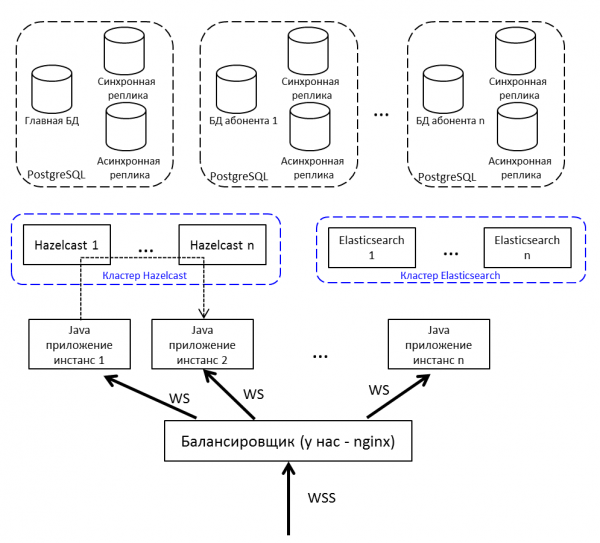
A cikk elejéről készült kép ismétlése, de már magyarázatokkal:
- Az internetre kihelyezett terheléselosztó; nálunk – nginx, de lehet bármilyen.
- A Java-alkalmazások példányai a Hazelcast-en keresztül kommunikálnak egymással.
- Websocket kezeléséhez .
- A Java-alkalmazás Java 8-ban íródott, bundlekből áll. Tervezettek – a migráció Java 10-re és modulokra való áttérés.
Fejlesztés és tesztelés
A rendszerünk fejlesztése és tesztelése során érdekes sajátosságokkal találkoztunk a használt termékekkel kapcsolatban.
Terheléses tesztelés és memóriaszivárgások
Minden egyes kiadás előzménye a terheléses tesztelés. Ezt sikeresen teljesítettük, amikor:
- A teszt több napon át futott és nem volt leállás
- A válaszidő a kulcsfontosságú műveleteknél nem haladta meg a kényelmes határt
- A korábbi verzióhoz képesti teljesítményromlás nem haladta meg a 10%-ot
A tesztadatbázist kitöltjük adatokkal – ehhez a gyártási szerverről információt szerzünk a legaktívabb előfizetőről, az ő számait öt személlyel megszorozzuk (üzenetek, viták, felhasználók száma), és így tesztelünk.
A rendszer interakciós terheléses tesztelését három konfigurációban végezzük:
- Stresszteszt
- Csak kapcsolatok
- Előfizetők regisztrálása
A stresszteszt során több száz szálat indítunk, amelyek folyamatosan terhelik a rendszert: üzeneteket írnak, vitákat hoznak létre, üzenetek listáját kérik le. Imitáljuk a normál felhasználók tevékenységeit (lekérni a nem olvasott üzeneteimet, írni valakinek) és a programozási megoldásokat (csomagot átadni más konfigurációnak, értesítést feldolgozni).
Például ez így néz ki a stresszteszt egy része:
- A rendszerbe belép a felhasználó
- Lekéri a nem olvasott vitáit
- 50% valószínűséggel olvas üzeneteket
- 50% valószínűséggel küld üzeneteket
- Ezután a felhasználó:
- 20%-os valószínűséggel új beszélgetést indít
- Véletlenszerűen kiválaszt bármelyik beszélgetéséből
- Belép
- Üzeneteket, felhasználói profilokat kérdez le
- Öt üzenetet küld véletlenszerű felhasználóknak ebből a beszélgetésből
- Kilep a beszélgetésből
- Ismétli meg 20 alkalommal
- Kijelentkezik, majd visszatér a szkript elejére
- A rendszerbe belép egy csevegőbot (a megoldások kódjából szimulálja az üzenetváltást)
- 50%-os valószínűséggel új csatornát hoz létre az adatok cseréjéhez (különleges beszélgetés)
- 50%-os valószínűséggel üzenetet ír bármelyik létező csatornára
A „Csak csatlakozások” forgatókönyv nem véletlenül jött létre. Olyan helyzet adódhat, hogy a felhasználók csatlakoztatták a rendszert, de még nem aktiválódtak. Minden felhasználó reggel 09:00-kor bekapcsolja a számítógépét, csatlakozik a szerverhez, és csendben marad. Ezek a felhasználók veszélyesek, sokan vannak – a csomagjaik csak PING/PONG-ot tartalmaznak, de a kapcsolatot a szerverrel fenntartják (nem tudják megszüntetni – hátha jön új üzenet). A teszt reprodukálja azt a helyzetet, amikor fél óra alatt sok ilyen felhasználó próbál bejelentkezni a rendszerbe. Ez hasonlít a stresszteszthez, de a fókusza kifejezetten az első belépésen van – hogy ne legyen visszautasítás (az ember nem használja a rendszert, de máris leválik – nehéz valami rosszabbat kitalálni).
Az előfizetők regisztrációs forgatókönyve az első indítással kezdődik. Végeztünk stressztesztet, és biztosak voltunk abban, hogy a levelezésnél a rendszer nem lassul. De elkezdtek jönni a felhasználók, és elkezdett leállni a regisztráció a várakozás miatt. A regisztráció során azt használtuk , amely a rendszer entrópiájára van kötve. A szerver nem tudott elegendő entrópiát felhalmozni, és új SecureRandom igénylésekor több tíz másodpercig lefagyott. Számos megoldás létezik a helyzetre, például: áttérni egy kevésbé biztonságos /dev/urandom-ra, egy külön alaplap beszerzése, amely generálja az entrópiát, véletlenszerű számokat előre generálni és a medencében tárolni. Ideiglenesen megszüntettük a problémát a medencével, de azóta külön tesztet futtatunk az új előfizetők regisztrálására.
Feszültségforrásként . A webes socketekkel nem tud dolgozni, szükség van egy pluginra. Az első találatok a „jmeter websocket” keresés eredményei között , amelyek ajánlják .
Ezzel kezdtük el.
Majdnem azonnal a komoly tesztelés megkezdése után felfedeztük, hogy a JMeter-ben memória szivárgások léptek fel.
A plugin egy külön történet, 176 csillaggal 132 forkja van a github-on. Az író 2015 óta nem commitál bele (mi 2015-ben szereztük be, akkor ez nem keltett gyanút), több github issue van a memória szivárgásokkal kapcsolatban, 7 megoldatlan pull request.
Ha úgy dönt, hogy terhelési tesztet végez ezzel a plugin-nal, figyeljen a következő megbeszélésekre:
- Többszálú környezetben egy normál LinkedList-et használtunk, így kaptuk meg futtatás közben. Ez vagy a ConcurrentLinkedDeque-ra való áttéréssel, vagy synchronized blokkokkal megoldható. Mi az első lehetőséget választottuk ().
- Memória szivárgás, a leválasztásnál az összeköttetés információi nem törlődnek ().
- Streaming módban (amikor a webszerver nem záródik le a mintavétel végén, hanem folytatva van a tervben) nem működnek a Response mintázatok ().
Ez azok közé tartozik, amik a github-on találhatók. Amit tettünk:
- Elvettük (@elyrank) – ez megoldotta az 1 és 3 problémáit
- Megoldottuk a 2. problémát
- Frissítettük a jetty-t 9.2.14-ről 9.3.12-re
- SimpleDateFormat-ot ThreadLocal-ba csomagoltuk; a SimpleDateFormat nem szálbiztos, ami NPE-hez vezetett futás közben
- Egy másik memória szivárgást is megszüntettünk (a leválasztáskor nem záródott le helyesen az összeköttetés)
És még mindig szivárog!
A memória már nem egy nap alatt fogyott el, hanem kettő alatt. Teljesen elmaradt az idő, úgy döntöttünk, kevesebb szálat indítunk, de négy ügynökön. Ennek legalább egy hétig elegendőnek kellett lennie.
Két nap telt el...
Most a Hazelcast-nál kezdett el fogyni a memória. A naplóban látszott, hogy néhány nap tesztelés után a Hazelcast elkezdett panaszkodni a memóriahiányra, és egy idő után a klaszter szétesett, és a csomópontok egyesével kezdtek el pusztulni. Csatlakoztattuk a JVisualVM-t a hazelcast-hoz, és láttuk a 'felfelé menő fát' – rendszeresen hívta a GC-t, de semmiképpen sem tudta felszabadítani a memóriát.
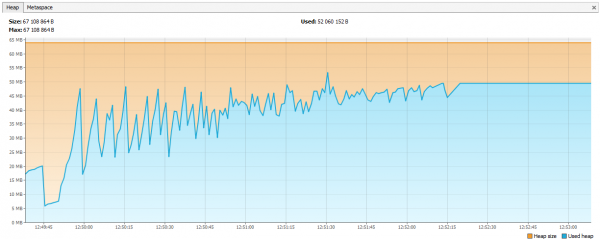
Kiderült, hogy a hazelcast 3.4-ben a map / multiMap (map.destroy()) törlésekor a memória nem szabadul fel teljesen:
Most ez a hiba a 3.5-ös verzióban javítva lett, de akkor ez probléma volt. Új multiMap-okat hoztunk létre dinamikus nevekkel és töröltük a saját logikánk szerint. A kód körülbelül így nézett ki:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Hívás:
service.join(auth1, "ÚJ_ÜZENETEK_A_VITA_BEN_UUID1");
service.join(auth2, "ÚJ_ÜZENETEK_A_VITA_BEN_UUID1");
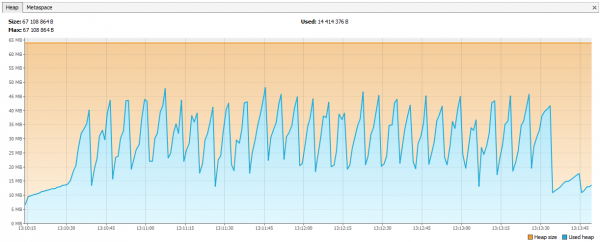
A multiMap minden előfizetéshez létrejött és eltávolították, amikor már nem volt szükség. Úgy döntöttünk, hogy létrehozunk egy Map-et, ahol a kulcs az előfizetés neve, az értékek pedig a munkamenetek azonosítói (amelyek segítségével később azonosíthatjuk a felhasználókat, ha szükséges).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
A grafikonok kiigazították magukat.
Mit tanultunk még a terheléses tesztelésről
- A JSR223-at groovy nyelven kell írni, és a fordítási gyorsítótárat be kell kapcsolni – ez jelentősen gyorsabb. .
- A Jmeter-Plugins grafikonjai könnyebben érthetők, mint a standard grafikonok. .
A Hazelcast-tal kapcsolatos tapasztalatunk
A Hazelcast új termék volt számunkra, az 3.4.1-es verzióval kezdtük, a termelési szerverünkön jelenleg a 3.9.2-es verzió van (a cikk írásának időpontjában a legújabb verzió a Hazelcast-ból 3.10).
ID generálás
Keztünk az egész számú azonosítókkal. Képzeljük el, hogy szükségünk van egy Long típusú azonosítóra egy új entitáshoz. Az adatbázisban lévő szekvencia nem megfelelő, mivel a táblák részt vesznek a shardelésben – így előfordulhat, hogy az üzenet ID=1 az adatbázis1-ben és az üzenet ID=1 az adatbázis2-ben található, ezt az Elasticsearch nem tudja kezelni, a Hazelcast sem, de a legrosszabb az, hogy ha össze kívánja vonni az adatokat a két adatbázisban (például úgy döntve, hogy egy adatbázis elegendő az ilyen előfizetők számára). Létrehozhatunk a Hazelcast-ban több AtomicLong-t és ott tárolhatjuk a számlálót, akkor az új ID megszerzésének teljesítménye – incrementAndGet plusz a kérés ideje a Hazelcast-ban. De a Hazelcast-ban van valami optimalizáltabb – FlakeIdGenerator. Minden ügyfél, amikor kapcsolatba lép, egy ID tartományt kap, például az első - 1-től 10 000-ig, a második - 10 001-től 20 000-ig, és így tovább. Most az ügyfél önállóan tud új azonosítókat kiadni, amíg a tartománya el nem fogy. Gyorsan működik, de az alkalmazás (és a Hazelcast ügyfél) újraindításakor új sorozat kezdődik – erről adódnak a hiányok stb. Ráadásul a fejlesztők számára nem túl világos, miért az azonosítók egész számúak, de olyan nagy eltéréseket mutatnak. Mindent mérlegeltünk és áttértünk az UUID-kra.
Egyébként azok számára, akik a Twitterhez hasonlóan szeretnének működni, létezik a Snowcast könyvtár – ez a Snowflake megvalósítása a Hazelcast felett. Meg lehet nézni itt:
De mi még nem jutottunk el odáig.
TransactionalMap.replace
Még egy meglepetés: a TransactionalMap.replace nem működik. Itt egy teszt:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Várt: newValue
Valóság: oldValue
Kénytelen voltam saját replace-t írni, a getForUpdate használatával:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Érték cseréje tranzakcionális térképen");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Érték cseréje nem tranzakcionális térképen");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Ne csak a hagyományos adatstruktúrákat, hanem azok tranzakcionális változatait is teszteljétek. Előfordulhat, hogy az IMap működik, de a TransactionalMap már nem.
Új JAR beillesztése leállás nélkül
Először úgy döntöttünk, hogy a saját osztályainkat tároljuk a Hazelcastban. Például van egy Application osztályunk, amit el szeretnénk menteni és olvasni. Mentés:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Olvasás:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Minden működik. Aztán úgy döntöttünk, hogy indexet építünk a Hazelcastban, hogy azon keresztül keresni tudjunk:
map.addIndex("subscriberId", false);És egy új entitás írásakor ClassNotFoundException-t kezdtünk kapni. A Hazelcast megpróbálta frissíteni az indexet, de semmit sem tudott a saját osztályunkról, és azt akarta, hogy adjunk neki JAR-t ezzel az osztállyal. Megtettük, működött, de új probléma merült fel: hogyan frissíthetem a JAR-t a klaszter teljes leállítása nélkül? A Hazelcast nem veszi észre az új JAR-t a csomópontfrissítés során. Ekkor arra jutottunk, hogy simán megélhetünk indexkeresés nélkül. Hiszen ha a Hazelcastot kulcs-érték tárolóként használjuk, akkor minden működni fog? Nem egészen. Itt újra eltérő viselkedés van az IMap és a TransactionalMap között. Míg az IMap-et nem zavarja, a TransactionalMap hibát dob.
IMap. 5000 objektumot rögzítünk, olvasunk. Minden a vártak szerint alakul.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
De a tranzakcióban nem működik, ClassNotFoundException-t kapunk:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
A 3.8-ban megjelent a User Class Deployment mechanizmusa. Kinevezhet egy fő csomópontot, és frissítheti a JAR fájlt rajta.
Most teljesen megváltoztattuk a megközelítést: saját magunk sorosítunk JSON-ra, és tárolunk Hazelcast-ban. A Hazelcast-nak nem szükséges ismernie osztályaink struktúráját, mi pedig frissíthetünk leállás nélkül. A domain objektumok verziózását az alkalmazás kezeli. Különböző verziójú alkalmazások futhatnak egyidejűleg, és előfordulhat, hogy az új alkalmazás új mezőkkel írja az objektumokat, míg a régi még nem ismeri ezeket a mezőket. Ugyanakkor az új alkalmazás olvassa a régi alkalmazás által írt objektumokat, amelyekben nincsenek új mezők. Az ilyen helyzeteket az alkalmazáson belül kezeljük, de egyszerűség kedvéért nem változtatjuk és nem távolítjuk el a mezőket, csak bővítjük az osztályokat új mezők hozzáadásával.
Hogyan biztosítjuk a magas teljesítményt
Négy hozzáférés a Hazelcast-hoz – jó, kettő az adatbázishoz – rossz
A gyorsítótárból való adatlekérés mindig jobb, mint az adatbázisból, de nem akarjuk tárolni a felhasználatlan rekordokat sem. A gyorsítótárazásról szóló döntést a fejlesztés utolsó szakaszára halasztjuk. Amikor az új funkciót leprogramoztuk, aktiváljuk a PostgreSQL-ben az összes lekérdezés naplózását (log_min_duration_statement = 0) és 20 percre terheléses tesztet futtatunk. A begyűjtött naplókból a pgFouine és a pgBadger típusú eszközök analitikai jelentéseket tudnak készíteni. A jelentésekben elsősorban a lassú és gyakori lekérdezéseket keressük. A lassú lekérdezésekhez végrehajtási tervet (EXPLAIN) készítünk, és értékeljük, hogy fel lehet-e gyorsítani azokat. A gyakori lekérdezések ugyanazon bemeneti adatokkal jól tárolódnak a gyorsítótárban. A lekérdezéseket „lapos” formában próbáljuk tartani, egy lekérdezésben egy táblát kezelve.
Működtetés
A SV online szolgáltatásként 2017 tavaszán indult el, míg mint külön termék 2017 novemberében jelent meg (akkor még bétaverzióban).
Több mint egy évnyi üzemeltetés során komoly problémák nem merültek fel az online SV szolgáltatás működésében. Az online szolgáltatást nyomon követjük a , amelyből gyűjtünk és telepítünk. .
A SV szerver disztribúciója natív csomagok formájában érkezik: RPM, DEB, MSI. Ezen kívül Windowsra egyetlen EXE formájában biztosítunk egy telepítőt, amely a szervert, a Hazelcast-ot és az Elasticsearch-t egy gépre telepíti. Eleinte ezt a telepítési verziót „bemutatónak” neveztük, de most már világos, hogy ez a legnépszerűbb telepítési lehetőség.
Forrás: habr.com
