

Javaslom, hogy ismerkedjenek meg Alekszandr Szigacsov előadásának átírásával az Inventos-tól: „A fejlesztési és tesztelési folyamat Docker + Gitlab CI használatával”
Akik most kezdik bevezetni a Docker + Gitlab CI alapú fejlesztési és tesztelési folyamatot, gyakran tesznek fel alapvető kérdéseket. Hol kezdjem? Hogyan szervezzem meg? Hogyan teszteljek?
Ez az előadás azért jó, mert strukturáltan beszél a Docker és Gitlab CI használatával végzett fejlesztés és tesztelés folyamatáról. Az előadás 2017-ből származik. Úgy gondolom, hogy ebből az előadásból meg lehet szerezni az alapokat, a metodológiát, az ötletet és a tapasztalatokat.
Akiket érdekel, azokat kérem, hogy tartsanak velem.
A nevem Alekszandr Szigacsov. Az Inventos cégnél dolgozom. Elmondom a Dockerral kapcsolatos tapasztalataimat és arról, hogy hogyan kezdjük el fokozatosan bevezetni a projektekben.
Az előadás témája: A fejlesztési folyamat Docker és Gitlab CI használatával.
Ez a második előadásom a Docker témájában. Az első előadás idején a Docker-t csak a fejlesztők gépein használtuk különböző fejlesztési fázisokban. Körülbelül 2-3 ember használta a Dockert. Fokozatosan tapasztalatot gyűjtöttünk és kicsit előrébb jutottunk. Link az első .
Miről lesz szó ebben az előadásban? Megosztjuk a tapasztalatainkat arról, milyen nehézségeket tapasztaltunk, és hogyan oldottuk meg a problémákat. Nem minden esetben volt szép, de lehetővé tette a továbblépést.
A mottónk: dockerizálj mindent, amihez csak hozzáférünk.
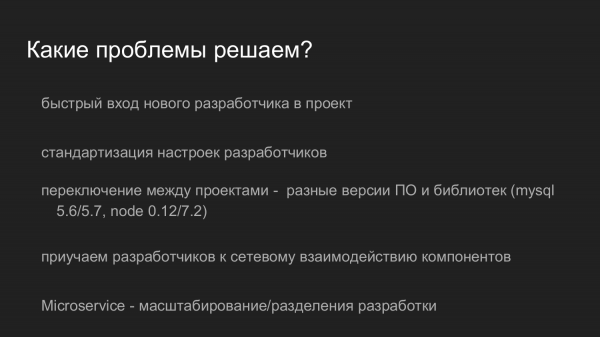
Milyen problémákat oldunk meg?
Amikor a cégnél több csapat van, a programozó megosztott erőforrás. Vannak fázisok, amikor a programozót kiszakítják egy projektből és átadják egy másik projekthez egy ideig.
Ahhoz, hogy a programozó gyorsan belemélyedhessen, szüksége van a projekt forráskódjának letöltésére és annyira gyorsan el kell indítania egy környezetet, amely lehetővé teszi a feladatok megoldását.
Általában, ha nulláról indulunk, a projektben kevés dokumentáció áll rendelkezésre. Az információ, hogy hogyan kell beállítani, csak a régi munkatársak tudásához tartozik. A munkatársak önállóan állítják be a munkakörnyezetüket egy-két nap alatt. Ennek felgyorsítására a Dockert alkalmaztuk.
A következő ok a fejlesztési beállítások szabványosítása. Tapasztalataim szerint a fejlesztők mindig kezdeményeznek. Minden ötödik esetben egy egyedi domain kerül bevezetésre, például vasya.dev. Mellette ül a szomszéd Petya, akinek petya.dev a domainje. Ők egy weboldalt vagy a rendszer valamelyik komponensét fejlesztik, ezt a domainnevet használva.
Amikor a rendszer növekszik, és ezek a domainnevek elkezdenek bekerülni a konfigurációkba, akkor konfliktus lép fel a fejlesztési környezetek között, és a weboldal útvonala átíródik.
Ugyanez történik az adatbázis-beállításokkal is. Valaki nem törődik a biztonsággal, és üres root jelszóval dolgozik. Van, akinek a MySQL telepítésekor jelszót követelt, és a jelszó egy volt: 123. Gyakran előfordul, hogy az adatbázis konfigurációja folyamatosan változott a fejlesztői commitok függvényében. Valaki javította, valaki nem javította a konfigurációt. Volt, hogy kicsit eltávolítottunk egy teszt konfigurációt, .gitignore és minden fejlesztőnek telepítenie kellett az adatbázist. Ez bonyolította a folyamat kezdetét. Ezen kívül emlékezni kell az adatbázisra is. Az adatbázist inicializálni kell, jelszót kell megadni, felhasználót kell létrehozni, táblát kell létrehozni és így tovább.
Egy másik probléma a különböző könyvtárverziók. Gyakran előfordul, hogy a fejlesztő különböző projekteken dolgozik. Van egy Legacy projekt, amelyet öt évvel ezelőtt kezdtünk (2017-től – a szerk. megj.). Az induláskor a MySQL 5.5-tel indultunk. Vannak modern projektek is, ahol már próbálunk bevezetni modernebb MySQL verziókat, például 5.7 vagy újabbakat (2017-ben – a szerk. megj.).
Aki a MySQL-lal dolgozik, tudja, hogy ezek a könyvtárak függőségeket vonnak maguk után. Meglehetősen problémás együtt futtatni 2 adatbázist. Legalábbis régi klienseket nehézkes csatlakoztatni egy új adatbázishoz. Ez viszont több problémát okoz.
A következő probléma az, hogy amikor a fejlesztő a helyi gépén dolgozik, helyi erőforrásokat, helyi fájlokat és helyi RAM-ot használ. Minden interakció a feladatok megoldása során azzal a feltételezéssel történik, hogy ez egy gépen működik. Például, ha a Production környezetünkben 3 backend szerverünk van, és a fejlesztő a fájlokat a gyökérkönyvtárba menti, ahonnan az nginx a fájlokat válaszokhoz veszi. Amikor az ilyen kód bekerül a Productionba, kiderül, hogy a fájl csak az egyik 3 szerveren található.
Jelenleg a mikroszolgáltatások irányzata fejlődik. Amikor a nagy alkalmazásainkat kisebb, egymással kölcsönhatásban álló komponensekre bontjuk. Ez lehetővé teszi, hogy a konkrét feladathoz válasszunk technológiákat. Ezzel lehetőség nyílik a munka és a felelősség megosztására a fejlesztők között.
A frontend fejlesztő, aki JS-ben fejleszt, gyakorlatilag nem befolyásolja a backend-et. A backend fejlesztő ezzel szemben Ruby on Rails-t fejleszt, és nem zavarja a frontend-et. Az interakció API-n keresztül történik.
Bónusként a Docker segítségével sikerült hasznosítani az erőforrásokat a Staging környezetben. Minden projekt a saját specifikációja miatt külön beállításokat igényelt. Fizikailag ki kellett különíteni vagy akár egy virtuális szervert létrehozni és külön beállítani, vagy megosztani egy változó környezetet, így a projektek a könyvtárak verziójától függően befolyásolhatták egymást.
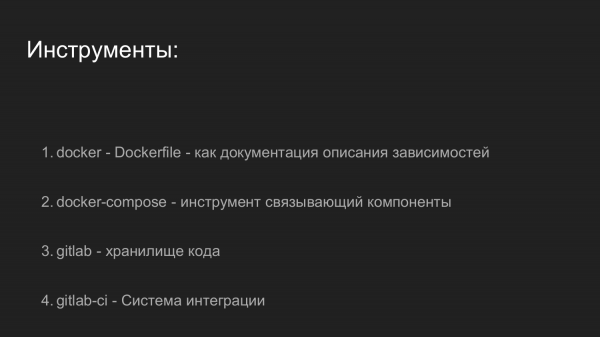
Eszközök. Mit használunk?
- Magát a Dockert. A Dockerfile a megfelelő alkalmazás függőségeit írja le.
- A Docker-compose egy összekötő, amely több Docker alkalmazásunkat egyesíti.
- A GitLab-ot a forráskód tárolására használjuk.
- A GitLab-CI-t a rendszerintegrációra használjuk.
A beszámoló két részből áll.
Az első rész arról fog szólni, hogyan indítottuk el a Dockert a fejlesztők gépein.
A második rész arról fog szólni, hogyan lépünk kapcsolatba a GitLabbal, hogyan futtatjuk a teszteket és hogyan telepítjük a Stagingre.
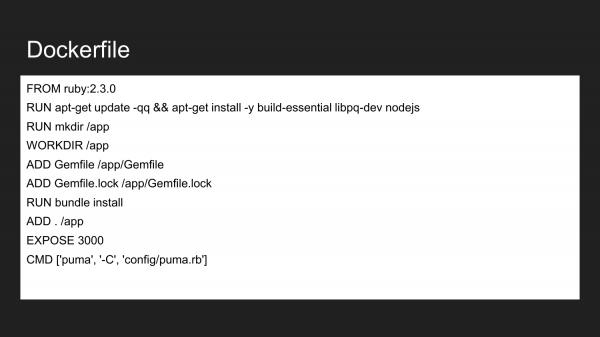
A Docker egy olyan technológia, amely lehetővé teszi (declaratív megközelítést használva) a szükséges komponensek leírását. Ez egy példa Dockerfile-ra. Itt bejelentjük, hogy az hivatalos Ruby:2.3.0 Docker kép öröklődése alatt állunk. Ez tartalmazza a 2.3-as verziójú Ruby-t. Telepítjük a szükséges build könyvtárakat és a NodeJS-t. Leírjuk, hogy létrehozunk egy könyvtárat. /app. A munkakönyvtárnak az app könyvtárát jelöljük ki. Ebbe a könyvtárba helyezzük el a szükséges minimális Gemfile-t és Gemfile.lock-ot. Ezután végrehajtjuk a projektek összeállítását, amelyek telepítik ezt a függőségképző képet. Megadjuk, hogy a konténer készen áll a 3000-es külső porton való hallgatásra. Az utolsó parancs az, amely közvetlenül elindítja az alkalmazásunkat. Ha végrehajtjuk a projekt indítási parancsát, az alkalmazás megpróbál elindulni, és végrehajtja a megadott parancsot.
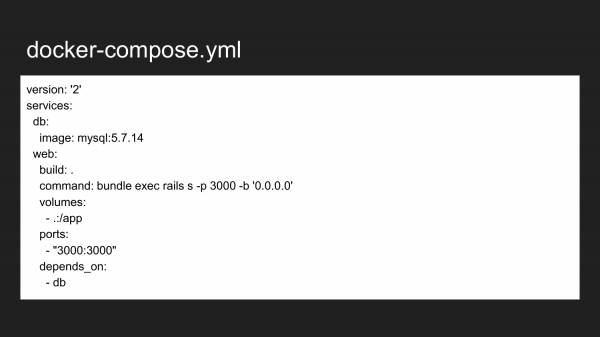
Ez egy minimális példa a docker-compose fájlra. Ebben az esetben bemutatjuk, hogy mi történik két konténer közötti kapcsolat során. Ez közvetlenül a databázis szolgáltatás és a web szolgáltatás között van. Webalkalmazásaink többségében szükség van egy backend-re az adatok tárolásához, például egy adatbázisra. Mivel MySQL-t használunk, ezért a példa MySQL-ra vonatkozik – de semmi sem akadályozza meg, hogy más adatbázist használjunk (PostgreSQL, Redis).
Az 5.7.14-es MySQL képet változtatás nélkül vesszük az hivatalos forrásból a Docker hub-on. A webalkalmazásunkért felelős képet a jelenlegi könyvtárból állítjuk össze. Az első indítás során ez a kép összeállítja számunkra a képet. Ezt követően pedig futtatja a parancsot, amelyet itt hajtunk végre. Ha visszamegyünk, láthatjuk, hogy a Puma által definiált indító parancs volt. A Puma egy Ruby nyelven írt szolgáltatás. A második esetben felülírjuk. Ez a parancs tetszőleges lehet a szükségleteink vagy feladataink függvényében.
Ezen kívül leírjuk, hogy át kell irányítani a portot a fejlesztői gépünkön 3000-ről a konténer 3000-es portjára. Ezt automatikusan végzi az iptables és a Docker által beépített mechanizmus.
A fejlesztő ugyanúgy, mint korábban, bármely elérhető IP-címre hivatkozhat, például a 127.0.0.1 helyi címére vagy a gép külső IP-címére.
Az utolsó sor azt jelzi, hogy a web konténer függ a db konténertől. Amikor elindítjuk a web konténert, a docker-compose először elindítja az adatbázist. Az adatbázis indítása után (valójában – a konténer indítása után! Az adatbázissal való készenlétet ez nem garantálja) fogja elindítani az alkalmazásunkat, a backendünket.
Ez lehetővé teszi a hibák elkerülését, amikor az adatbázis nincs elindítva, és erőforrásokat takarít meg, amikor leállítjuk az adatbázis konténert, ezzel felszabadítva az erőforrásokat más projektek számára.
Milyen előnyökkel jár a Dockerizált adatbázisok használata a projektben? Minden fejlesztőnél rögzítjük a MySQL verziót. Ez segít elkerülni bizonyos hibákat, amelyek felmerülhetnek, ha eltérnek a verziók, amikor a szintaxis, konfiguráció vagy alapértelmezett beállítások megváltoznak. Így közös hostname-t, login-t és jelszót tudunk megadni az adatbázis számára. Eltávolodunk a korábbi config fájlok kabosztáról és névütközéseiről.
Lehetőségünk van egy optimalizált konfigurációt használni a fejlesztői környezethez, amely eltér az alapértelmezettől. A MySQL alapértelmezés szerint gyenge gépekre van optimalizálva, így a teljesítménye dobozból kiemelve nagyon alacsony.
A Docker lehetővé teszi a szükséges verziójú Python, Ruby, NodeJS és PHP értelmezők használatát. Megszabadulunk a verziókezelők használatának szükségességétől. Korábban RPM csomagot használtunk Ruby esetében, amely lehetővé tette a verziók projekt szerinti változtatását. Emellett a Docker konténer segít a kód zökkenőmentes migrálásában és verziózásában együtt a függőségekkel. Nincs problémánk a verziók és az értelmező megértésével sem. A verzió frissítéséhez le kell állítani a régi konténert és új konténert kell felállítani. Ha valami rosszul sül el, vissza tudjuk állítani a régi konténert.
A konténerek a kép létrehozása után a fejlesztői és a produkciós környezetben is megegyeznek. Ez különösen fontos a nagy telepítések esetén.
 A frontendhez JavaScriptet és NodeJS-t használunk.
Jelenleg az utolsó projektünk ReacJS-en alapul. A fejlesztő minden konténert elindított és hot-reload használatával dolgozott.
Ezután elindul a JavaScript összeszerelésének feladata, és az elkészült statikus kód nginx-en keresztül kerül átadva, így spórolunk az erőforrásokkal.
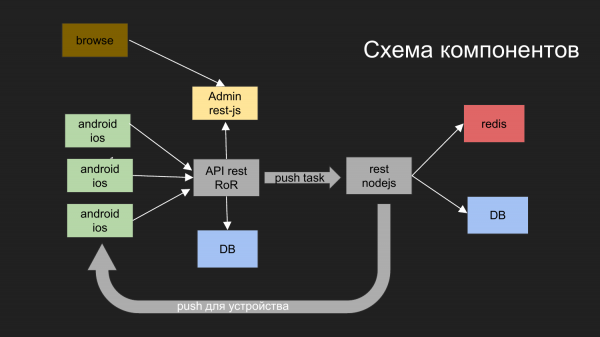
Itt bemutattam legújabb projektünk vázlatát.
Milyen feladatokat oldottunk meg? Szükségünk volt egy rendszer kiépítésére, amely mobil eszközökkel kommunikál. Ezek az eszközök adatokat kapnak. Az egyik lehetőség értesítések küldése ezekre az eszközökre.
Mit tettünk ezért?
Az alkalmazást a következő komponensekre osztottuk: adminisztrátori rész JavaScript-en, backend, amely Ruby on Rails-en keresztül REST interfészen működik. A backend kommunikál az adatbázissal. Az eredmény, amelyet generálunk, visszakerül az ügyfélhez. Az admin felület a backend-del és az adatbázissal REST interfészen keresztül kommunikál.
Emellett szükségünk volt Push értesítések küldésére is. Korábban egy projektünk volt, amelyben megvalósítottuk a mechanizmust, amely felelős az értesítések kézbesítéséért mobilplatformokra.
Kifejlesztettünk egy sémát: a böngésző operátora interakcióba lép az admin felülettel, az admin felület pedig kommunikál a háttérszolgáltatással, amely feladatként kapja, hogy Push értesítéseket kell küldenie.
A Push értesítések egy másik komponenssel lépnek interakcióba, amely NodeJS alapú.
Sorok épülnek fel, majd ez követi a saját mechanizmusán az értesítések küldését.
Itt két adatbázis van ábrázolva. Jelenleg a Docker segítségével két független adatbázist használunk, amelyek nincsenek összekapcsolva. Annyiban, hogy közös virtuális hálózattal rendelkeznek, míg a fizikai adatok a fejlesztő gépének különböző könyvtáraiban találhatók.
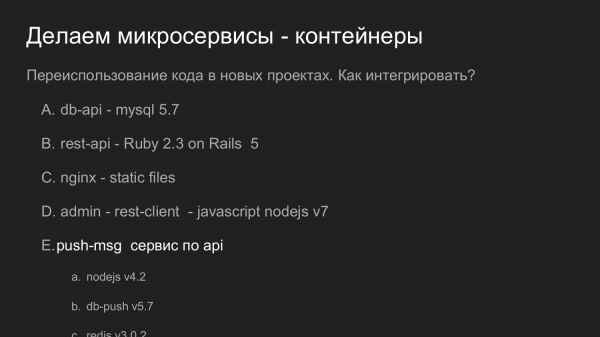
Ugyanez, de számokban. Itt fontos a kód újrahasználata.
Ha korábban a kód újrahasználatáról beszéltünk könyvtárakként, akkor ebben a példában a Push értesítésekért felelős szolgáltatásunk teljes szerverként újrahasználható. API-t biztosít. Ezzel már a mi új fejlesztésünk lép interakcióba.
Akkoriban a NodeJS 4-es verzióját használtuk. Jelenleg (2017-ben — szerk. megj.) az új fejlesztésekben a NodeJS 7-es verzióját alkalmazzuk. Nincs probléma a legújabb komponensekben új könyvtárverziók használatával.
Szükség esetén elvégezhető a refaktorálás, és a Push értesítések szolgáltatásának NodeJS verziója frissíthető.
Ha meg tudjuk őrizni az API kompatibilitását, akkor azt más projekteknél, amelyeket korábban használtunk, helyettesíthetnénk.
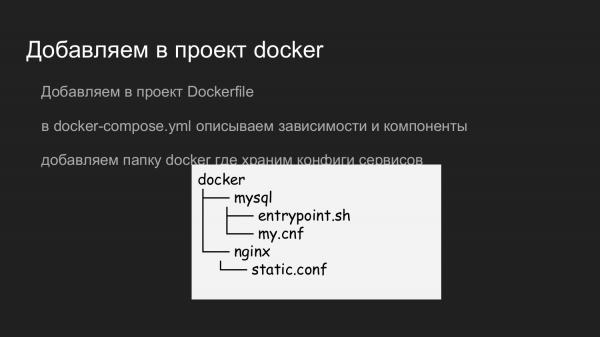
Mi szükséges a Docker hozzáadásához? Hozzáadunk egy Dockerfile-t a repónkhoz, amely leírja a szükséges függőségeket. Ebben a példában a komponenseket logika alapján bontottuk le. Ez egy minimális csomag a backend fejlesztőknek.
Új projekt indításakor Dockerfile-t készítünk, amelyben leírjuk a szükséges ökoszisztémát (Python, Ruby, NodeJS). A docker-compose-ban leírjuk a szükséges függőséget — az adatbázist. Megadjuk, hogy egy ilyen-olyan verziójú adatbázisra van szükség, az adatok ott meg ott tárolva.
Statikus tartalom szolgáltatásához külön harmadik konténert használunk nginx-sel. Lehetőség van képek feltöltésére. A backend a képeket egy előre elkészített kötetbe helyezi, ami szintén csatlakoztatva van az nginx konténerhez, amely a statikus tartalmat szolgáltatja.
A nginx és mysql konfigurációk tárolásához létrehoztunk egy Docker mappát, ahol a szükséges konfigurációkat tároljuk. Amikor a fejlesztő git clone parancsot futtat a tárolóból, egy már készen álló projektet kap a helyi fejlesztéshez. Így nem merül fel kérdés, hogy melyik portot vagy milyen beállításokat kell alkalmazni.
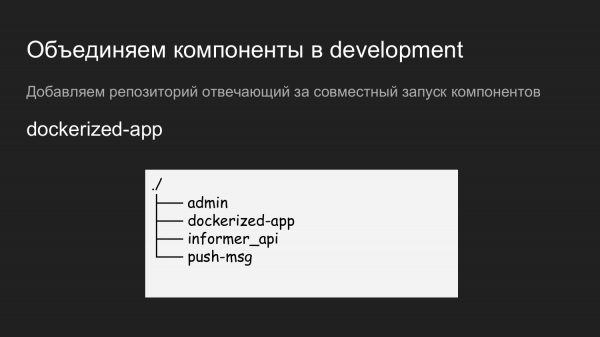
Ezután van néhány összetevőnk: admin, inform-API, push-értesítések.
Ahhoz, hogy mindezt elindítsuk, létrehoztunk egy másik tárolót, amelyet dockerized-app-nak neveztünk el. Jelenleg több tárolót használunk minden egyes összetevő számára. Ezek logikailag eltérnek — a GitLab-ban mappaként jelennek meg, míg a fejlesztő gépén a konkrét projekthez tartozó mappa. Egy szinttel lejjebb találhatóak azok az összetevők, amelyek össze fognak kapcsolódni.
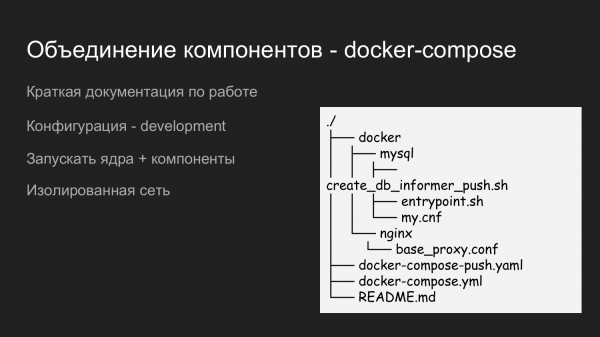
Ez a dockerized-app tartalmának példája. Ide is kivettük a Docker mappát, amely tartalmazza a konfigurációkat, amelyek szükségesek az összes komponens közötti interakcióhoz. Van egy README.md fájl is, amely röviden leírja, hogyan lehet elindítani a projektet.
Itt két docker-compose fájlt alkalmaztunk. Ezt azért tettük, hogy lehetőségünk legyen lépcsőzetesen indítani. Amikor a fejlesztő a maggal dolgozik, nincs szüksége push-értesítésekre, ezért egyszerűen csak a docker-compose fájlt indítja el, ezzel erőforrást spórolva.
Ha szükség van push-értesítések integrációjára, akkor elindul a docker-compose.yaml és a docker-compose-push.yaml.
Mivel a docker-compose.yaml és a docker-compose-push.yaml mappában helyezkedik el, így automatikusan létrejön egy egységes virtuális hálózat.
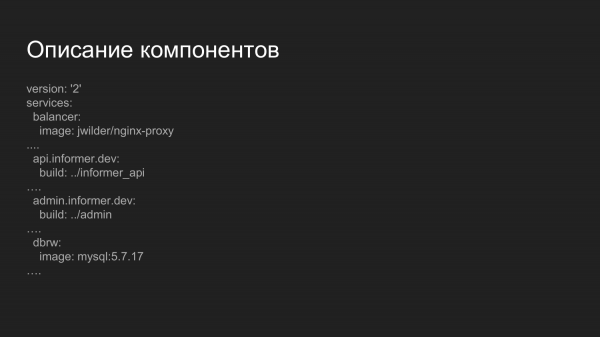
Az összetevők leírása. Ez egy kiterjedtebb fájl, amely az összetevők összeállításáért felelős. Mi a figyelemre méltó itt? Bevezetjük a terheléselosztó komponenst.
Ez egy kész Docker-kép, amely tartalmazza az nginx-t és azt az alkalmazást, amely a Docker socketen hallgat. Dinamikusan, a konténerek be- és kikapcsolásával regenerálja az nginx konfigurációt. Az összetevőkkel való kommunikációt harmadik szintű domainnevek alapján valósítjuk meg.
Fejlesztési környezetben a .dev domaineket használjuk — api.informer.dev. A .dev domain alatti alkalmazások elérhetők a fejlesztő helyi gépén.
Ezután átadjuk a konfigurációkat minden projekthez, és az összes projekt egyszerre kerül indításra.
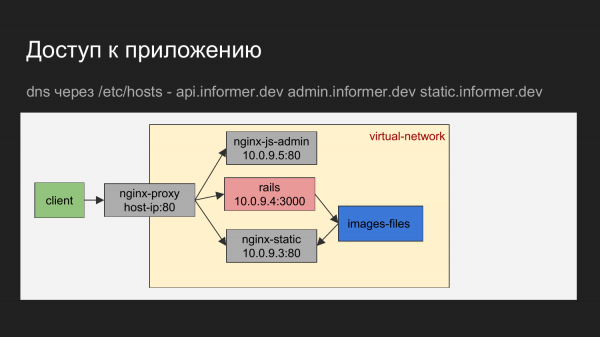
Ha grafikus ábrázolásban gondolkodunk, az ügyfél a böngészőnk vagy valamilyen eszköz, amivel a balancer felé irányítjuk a kéréseinket.
A balancer a domain név alapján határozza meg, melyik konténerhez kell fordulni.
Ez lehet az nginx, amely a JS admin felületet adja. Ez lehet az nginx, amely az API-t adja, vagy akár statikus fájlokat, amelyeket az nginx képformátumban ad át.
A diagramon látható, hogy a konténerek egy virtuális hálózatba vannak összekapcsolva, és egy proxy mögött rejtőznek.
A fejlesztői gépen közvetlenül elérhetjük a konténert az IP cím ismeretében, de ezt alapvetően nem alkalmazzuk. Közvetlen kapcsolat szükségessége gyakorlatilag nem merül fel.
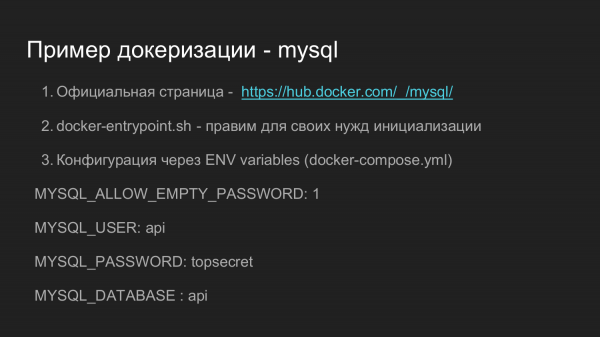
Milyen példát nézzek meg, hogy dockerizálhassam az alkalmazásomat? Véleményem szerint egy jó példa a MySQL hivatalos docker képe.
Ez eléggé bonyolult. Sok verziója van. De a funkcionalitása lehetővé teszi sok igény kielégítését, amely felmerülhet a további fejlesztés során. Ha időt szánsz arra, hogy megértsd, hogyan működik minden, akkor szerintem a saját bevezetésben nem lesznek problémáid.
A hub.docker.com oldalon általában találhatók linkek a github.com-ra, ahol a nyers adatokat találod, amelyekből saját magad gyűjtheted össze a képet.
A továbbiakban ebben a tárolóban található a docker-endpoint.sh szkript, amely a kezdeti inicializációért és az alkalmazás elindításának további feldolgozásáért felelős.
Ebben a példában a környezeti változók segítségével történő konfigurálás lehetősége is megtalálható. Az egyedi konténer indításakor vagy a docker-compose segítségével meghatározhatjuk, hogy üres jelszót akarunk beállítani a dockerhez a root felhasználónál a MySQL-nál, vagy bármilyen másik jelszót, amit szeretnénk.
Van lehetőség véletlenszerű jelszó létrehozására. Megmondjuk, hogy felhasználóra van szükség, szükséges beállítani a felhasználó jelszavát, és szükséges adatbázist létrehozni.
A projektjeinkben kissé egységesítettük a Dockerfile-t, amely az inicializálásért felelős. Itt a saját igényeinkhez igazítottuk, hogy egyszerűen a felhasználói jogok kiterjesztését végezzük el, amit az alkalmazás használ. Ez lehetővé tette, hogy egyszerűen hozzunk létre adatbázist az alkalmazás konzoljából. A Ruby alkalmazásokban van parancs az adatbázisok létrehozására, módosítására és törlésére.
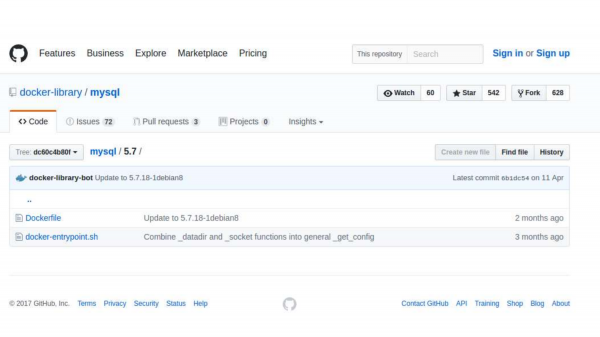
Ez a példa arra, hogyan néz ki egy konkrét verzió MySQL a github.com-on. A Dockerfile megnyitható, és megnézhető, hogyan történik a telepítés.
A docker-endpoint.sh script is responsible for the entry point. Some preparatory actions are required during the initial setup, and all these actions are precisely included in the initialization script.
Let's move on to the second part.
For storing the source codes, we have transitioned to gitlab. It's a powerful system that has a visual interface.
One of the components of Gitlab is Gitlab CI. It allows you to describe the sequence of commands that will be used to organize the code delivery system or run automated tests.
Report on Gitlab CI 2 — a report from the Ruby Russia club — it's quite detailed and may interest you.
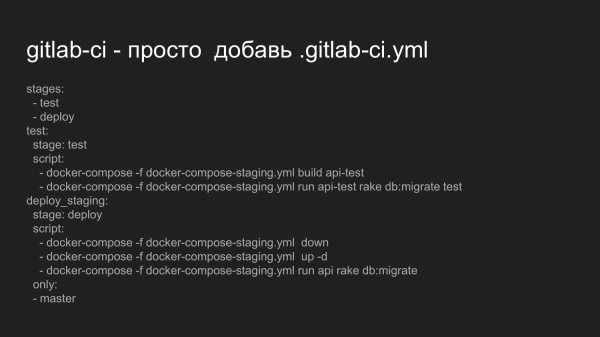
Now we will look at what is required to activate Gitlab CI. To launch Gitlab CI, we simply need to place a .gitlab-ci.yml file in the root of the project.
Here we describe what we want to execute in a sequence of states, such as tests and deployment.
We run scripts that directly call the docker-compose build of our application. This is an example of the backend.
Next, we indicate that it's necessary to run the migrations to change the database and execute the tests.
If the scripts execute correctly and do not return an error code, then the system moves on to the second stage of deployment.
The deployment stage is currently implemented for staging. We haven't organized a zero-downtime restart.
We forcibly shut down all containers and then bring all containers back up, rebuilt from the first stage during testing.
We run the migrations for the current variable environment that were written by the developers.
There is a note that this should only be applied to the master branch.
Changes in other branches do not execute.
There is an opportunity to organize rollouts by branches.
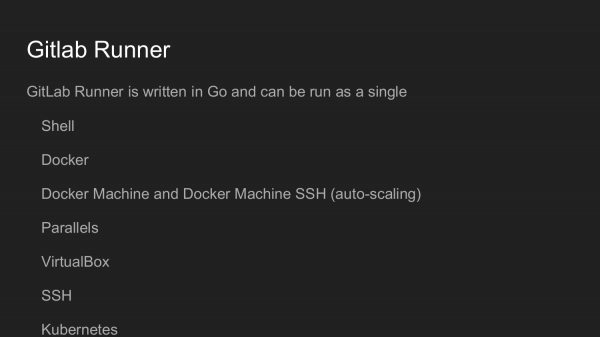
To organize this further, we need to install Gitlab Runner.
This utility is written in Golang. It is a single file as commonly practiced in the Golang world, requiring no dependencies.
When starting, we register the Gitlab Runner.
We obtain a key in the Gitlab web interface.
Then we call the initialization command in the command line.
We configure the Gitlab Runner in dialog mode (Shell, Docker, VirtualBox, SSH).
The code on Gitlab Runner will execute on each commit depending on the setup of .gitlab-ci.yml.
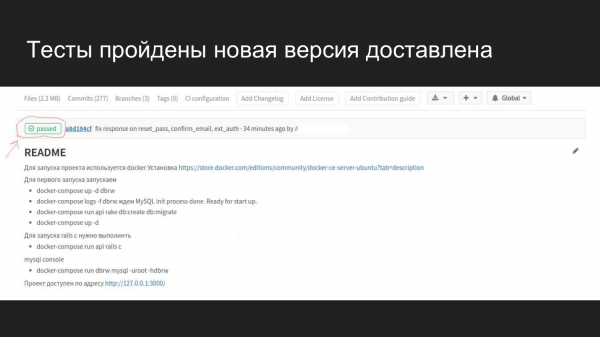
Hogyan néz ki a Gitlab webes felületén. Miután csatlakoztattuk a Gitlab CI-t, megjelenik egy jelző, amely megmutatja, hogy a jelenlegi állapotban hol tart a build.
Azt látjuk, hogy 4 perce történt egy commit, amely átesett minden teszten, és nem okozott problémát.
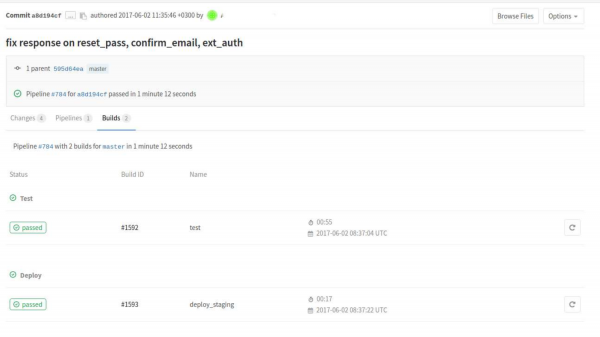
Részletesebben megnézhetjük a build állapotokat. Itt látjuk, hogy már két állapot lépett életbe. A tesztelési állapot és a staging környezetbe való deploy állapot.
Ha rákattintunk egy konkrét buildre, ott látni fogjuk a parancsok konzol kimenetét, amelyek a .gitlab-ci.yml szerint futottak.
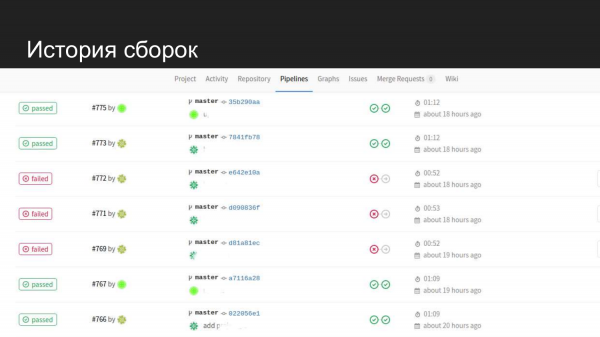
Így néz ki a termékünk története. Látjuk, hogy voltak sikeres próbálkozások. Amikor a tesztek nem sikerülnek, a következő lépésre nem lép tovább, és a kód a staging-en nem frissül.
Milyen feladatokat oldottunk meg a staging környezetben, amikor bevezettük a dockert? A rendszerünk komponensekből áll, és szükségünk volt arra, hogy csak azokat a komponenseket indítsuk újra, amelyeket frissítettek a repóban, nem pedig az egész rendszert.
Ehhez szét kellett válogatnunk mindent külön mappákba.
Miután ezt megcsináltuk, problémát okozott, hogy a Docker-compose minden mappához saját hálózati teret hoz létre, így nem látják a szomszédos komponenseket.
Ennek megkerülésére manuálisan létrehoztunk egy hálózatot a Dockerben. A Docker-compose-ban beírtuk, hogy ehhez a projekthez ezt a hálózatot használja.
Így minden komponens, amely ezzel a hálózattal indul, látja a rendszer más részein található komponenseket.
A következő probléma a staging több projektre való felosztása.
Mivel ez jól néz ki és maximálisan közel áll a production-höz, célszerű a 80-as vagy 443-as portot használni, amelyet a WEB-en világszerte használnak.

Hogyan oldottuk meg ezt? Egy Gitlab Runner-t rendeltünk a nagyobb projektekhez.
A Gitlab lehetővé teszi, hogy több elosztott Gitlab Runner-t indítsunk, amelyek egyszerűen felváltva, kaotikus sorrendben veszik fel a feladatokat és futtatják őket.
Hogy elkerüljük a káoszt, korlátoztuk a projektjeink csoportját egy Gitlab Runner-re, amely a mi mennyiségünkkel gond nélkül megbirkózik.
Külön szkriptbe szerveztük az nginx-proxyt, és abban meghatároztuk a projektek hálózatait.
A projektünknek egy hálózata van, míg a terheléselosztónak több hálózata van a projektek nevei szerint. Ez domainnevek alapján tovább tudja proxyzni.
A domain query comes in on port 80 and is routed to a group of containers that serve this domain.
What other problems were there? The default is that all containers run as the root user. This root is not the same as the root of the system host.
However, if you log into the container, it will be root, and the file we create in this container gets root permissions.
If a developer logged into the container and executed commands that generate files, then exited the container, they will have a file in their working directory that they cannot access.
How can this be resolved? We can add users who will be in the container.
What problems arose when we added the user?
When creating a user, we often have mismatched group IDs (UID) and user IDs (GID).
To resolve this issue, we use users with ID 1000 in the container.
In our case, this coincided with the fact that practically all developers use Ubuntu OS. And on Ubuntu OS, the first user has ID 1000.
What are our plans?
Re-read the Docker documentation. The project is actively evolving, and the documentation is changing. Information obtained two to three months ago is gradually becoming outdated.
Some of the problems we addressed may already be solved by standard means.
We really want to move forward and get directly to orchestration.
One example is the built-in Docker mechanism called Docker Swarm, which is available out of the box. We want to launch something in production based on Docker Swarm technology.
Container generation complicates working with logs. Currently, the logs are isolated. They are scattered across containers. One of the tasks is to provide easy access to logs through a web interface.
Forrás: habr.com
