

Ezt a cikket a statikus elemzésről szóló számos anyag ihlette, amelyek egyre gyakrabban tűnnek fel. Először is, ez a , amely aktívan reklámozza magát a Habr-on a hibák áttekintésein keresztül, amelyeket az ő eszközük fedezett fel nyílt forráskódú projektekben. Nemrég a PVS-studio , és természetesen az IntelliJ IDEA fejlesztői, akinek beépített elemzője valószínűleg a legfejlettebb a Java számára, .
Az ilyen áttekintések olvasásakor olyan érzésünk van, mintha egy varázslatos főzet volna: csak nyomj meg egy gombot, és itt van — a hibák listája a szemed előtt. Úgy tűnik, hogy ahogy az elemzők fejlettebbé válnak, egyre több hibát találnak automatikusan, és azok a termékek, amelyeket ezek a robotok átvizsgálnak, egyre jobbak lesznek, anélkül, hogy bármilyen erőfeszítést tennénk.
De varázslatos főzetek nem léteznek. Szeretnék beszélni arról, amiről általában nem beszélnek az olyan bejegyzésekben, mint a "mit képes felfedezni a robotunk": mit nem tudnak az elemzők, mi a valódi szerepük és helyük a szoftver szállítási folyamatában, és hogyan kell őket helyesen bevezetni.
Egy példát említenék (forrás: ).
) Amit a statikus elemzők sosem fognak tudni
Mi az, a gyakorlatban, az forráskód elemzés? Adunk bemenetként egyes forrásokat, és a kimenetként rövid időn belül (sokkal rövidebb idő alatt, mint a tesztek futtatása) információkat kapunk a rendszerünkről. Az alapvető és matematikailag elkerülhetetlen korlátozás az, hogy így csak egy meglehetősen szűk információkört tudunk megszerezni.
A legismertebb példa egy olyan problémára, amelyet nem lehet statikus elemzés segítségével megoldani — : ez egy tétel, amely bebizonyítja, hogy lehetetlen egy általános algoritmust kidolgozni, amely a program forráskódja alapján meghatározza, hogy az végtelen ciklusba kerül-e vagy véges időn belül befejeződik. E tétel kiterjesztése a A definíciója annak, hogy egy tetszőleges program képes-e kiszámítani egy tetszőleges nem triviális tulajdonságú számítási funkciót, algoritmikusan nem megoldható feladat. Például lehetetlen írni egy elemzőt, amely meg tudja határozni bármilyen forrással, hogy a vizsgált program egy algoritmus implementációja, amely például egy egész szám négyzetre emelését végzi.
Ezért a statikus elemzők funkcionalitása megkérdőjelezhetetlen korlátokkal rendelkezik. A statikus elemző soha nem tudja minden esetben meghatározni az olyan dolgokat, mint például a "null pointer exception" fellépése azokon a nyelveken, amelyek megengedik a null értéket, vagy minden esetben az "attribute not found" előfordulását olyan dinamikusan típusos nyelveknél. Amit a legfejlettebb statikus elemző tud tenni, az az, hogy kiemeli az olyan speciális eseteket, amelyek száma a lehetséges problémákhoz képest az Ön forráskódjában, nem túlzó módon, egy csepp a tengerben.
A statikus elemzés nem hibakeresés.
Az eddigiekből a következő következtetés vonható le: a statikus elemzés nem eszköz a program hibáinak csökkentésére. Merem állítani: amikor először alkalmazzák a projektjében, érdekes helyeket talál a kódban, de valószínűleg nem fogja észlelni a programja működésére hatással lévő hibákat.
Az elemzők által automatikusan felfedezett hibák példái lenyűgözőek, de ne feledjük, hogy ezek a példák nagy kódbázisok széles körű átvizsgálása révén kerültek elő. Ugyanezen elv alapján a hackerek, akik képesek több egyszerű jelszót megpróbálni sok fióknál, végül megtalálják azokat a fiókokat, ahol egyszerű jelszó található.
Jelenti ez, hogy a statikus elemzést nem szabad alkalmazni? Természetesen nem! Ugyanazon okból, amiért minden új jelszót érdemes leellenőrizni a "kevésbé biztonságos" jelszavak fekete listáján.
A statikus elemzés több, mint hibakeresés.
Valójában a megoldható elemzési feladatok sokkal szélesebb körűek. Az általános statikus elemzés bármilyen forráskód-ellenőrzés, amelyet a futtatás előtt végeznek. Íme néhány dolog, amit tenni lehet:
- A kódolás stílusának ellenőrzése tág értelemben. Ide tartozik a formázás ellenőrzése, valamint a felesleges zárójelek használatának keresése, küszöbértékek beállítása olyan metrikákra, mint a sorok száma vagy a módszer ciklomatikus bonyolultsága, és így tovább — minden, ami potenciálisan megnehezíti a kód olvashatóságát és karbantartását. Java esetében ilyen eszköz a Checkstyle, Pythonban pedig a flake8. Az ilyen típusú programokat általában "lintereknek" hívják.
- Nemcsak a végrehajtható kód analízisnek van alávetve. Az erőforrásfájlok, mint a JSON, YAML, XML, .properties automatikusan validálhatók (és kell is!), hiszen jobb tudni, hogy egy páratlan idézőjel miatt megsérült a JSON struktúrája, mint amikor a tesztek futása vagy a futásidő során derül ki. Vannak megfelelő eszközök: például , .
- A fordítás (vagy a dinamikus programozási nyelvek esetén parse-olás) szintén a statikus analízis egy formája. Általában a fordítók figyelmeztetéseket adhatnak, amelyek a forráskód minőségi problémáira utalnak, és ezeket nem szabad figyelmen kívül hagyni.
- Néha a fordítás nem csupán a végrehajtható kód fordítása. Például, ha a dokumentációs formátumod , akkor amikor azt HTML/PDF formátumba alakítod, az AsciiDoctor feldolgozó () figyelmeztetéseket adhat, például megsértett belső linkekről. Ez jelentős ok arra, hogy ne fogadjuk el a dokumentációs módosításokat tartalmazó Pull Requestet.
- A helyesírás-ellenőrzés is a statikus analízis egy formája. Az eszköz képes ellenőrizni a helyesírást nemcsak a dokumentációban, hanem a programok forráskódjaiban (kommentek és literálok) is, különböző programozási nyelveken, így például C/C++, Java és Python nyelveken. Egy felhasználói felületen vagy a dokumentációban elkövetett helyesírási hiba szintén hiba!
- A konfigurációs tesztek (hogy mit jelentenek, lásd és jelentések), bár a pytest típusú moduláris tesztek futási környezetében hajtják végre őket, valójában a statikus analízis egy formájának számítanak, mivel nem hajtják végre a forráskódokat a futásuk során.
Ahogy látjuk, a hibák keresése a listában a legkevésbé fontos szerepet játszik, míg minden egyéb ingyenes open source eszközök használatával elérhető.
Milyen típusú statikus elemzéseket érdemes alkalmazni a projektjében? Természetesen mindet, minél több, annál jobb! A lényeg, hogy ezt helyesen vezessük be, erről lesz szó a következőkben.
A szállítási csővezeték mint többlépcsős szűrő és a statikus elemzés mint az első lépcső
A folyamatos integráció klasszikus metaforája a csővezeték, amelyen keresztül a változtatások áramlanak — a forráskód változtatásától a termelési környezetbe történő kiadásig. A csővezeték standard szakaszainak sorrendje a következőképpen néz ki:
- statisztikai elemzés
- fordítás
- modul tesztek
- integrációs tesztek
- UI tesztek
- kézi ellenőrzés
Az N-edik szakaszban elutasított változások nem továbbíthatók az N+1 szakaszra.
Miért így, és nem másképp? Azokban a szakaszokban, amelyek a teszteléshez kapcsolódnak, a tesztelők széles körben ismert tesztelési piramisról értesülnek.
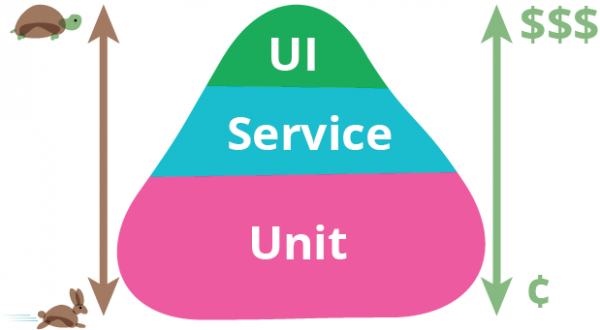
Teszt piramis. Forrás: Martin Fowler.
A piramis alsó részén találhatók azok a tesztek, amelyeket könnyebb írni, gyorsabban futnak, és nem hajlamosak a hamis riasztásokra. Ezért ezekből kell több, nagyobb kódot kell lefedniük, és először kell őket végrehajtani. A piramis felső részén éppen ellenkező a helyzet, ezért az integrációs és UI tesztek számát minimálisra kell csökkenteni. Az ember ebben a láncban a legdrágább, leglassabb és legmegbízhatatlanabb erőforrás, ezért a legvégére került, és csak akkor végez munkát, ha az előző szakaszok nem találtak hibát. Azonban ugyanezek az elvek érvényesek a teszteléssel közvetlenül nem kapcsolatos szakaszokban is!
Szeretnék egy analógiát javasolni, amely egy többlépcsős vízszűrő rendszert ábrázol. A bemeneten szennyezett víz (hibás változtatások) érkezik, a kimeneten pedig tiszta vizet kell kapnunk, amelyből minden nem kívánt szennyeződést kiszűrünk.
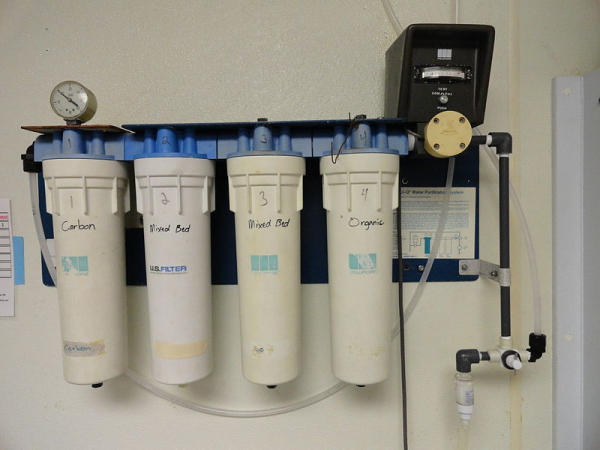
Többlépcsős szűrő. Forrás:
Ahogy ismert, a tisztító szűrőket úgy tervezik, hogy minden következő fokozat képes legyen egyre finomabb szennyeződések kiszűrésére. A durvább tisztítással foglalkozó fokozatok nagyobb áteresztőképességgel és alacsonyabb költséggel rendelkeznek. Analógiánkban ez azt jelenti, hogy a belépési minőségi kapuk nagyobb teljesítményt mutatnak, kevesebb erőfeszítést igényelnek az indításhoz, és maguk is kevésbé igényesek a működés során — és pontosan ilyen sorrendben vannak felépítve. A statikus elemzés szerepe, amelyről most már tudjuk, hogy csak a legdurvább hibákat képes kiszűrni — ez az „iszapfogó” rács szerepe a szűrők sorozatának elején.
A statikus elemzés önmagában nem javítja a végtermék minőségét, akárcsak az „iszapfogó” nem teszi ivóvízzé a vizet. Mégis, a többi elemközli összefüggésben nyilvánvaló a jelentősége. Bár a többlépcsős szűrőben a kimeneti fokozatok potenciálisan képesek ugyanezek elfogására, egyértelmű, hogy milyen következményekkel jár, ha csupán a finom szűrés lépéseire támaszkodunk, a belépési fokozatok nélkül.
Az „iszapfogó” célja, hogy tehermentesítse a következő lépcsőket a nagyon durva hibák kiszűrésétől. Például legalább annyira, hogy a kódellenőrzést végző személynek nem szabadna az elformázatlan kóddal és a megállapított kódolási normák (mint a felesleges zárójelek vagy túl mély ágazások) megsértésével foglalkoznia. Az olyan hibáknak, mint az NPE, egységtesztekkel kellene kiszűrődnie, de ha a teszt előtt az elemző már figyelmeztet minket arra, hogy hiba fog bekövetkezni — ez jelentősen felgyorsítja a javítást.
Gondolom, most már világos, miért nem javítja a termék minőségét a statikus elemzés, ha alkalomszerűen alkalmazzák, és miért kellene folyamatosan használni a durva hibákkal kapcsolatos módosítások kiszűrésére. A kérdés, hogy a statikus elemző alkalmazása javítja-e a termék minőségét, körülbelül egyenlő azzal a kérdéssel, hogy „javulnak-e a víz ivási tulajdonságai, ha egy piszkos víztározóból áttereljük egy szűrőn?”
Bevezetés egy örökölt projekthez
Fontos gyakorlati kérdés: hogyan lehet a statikus elemzést beépíteni a folyamatos integráció folyamatába, mint "minőségi kaput"? Az automatikus teszteknél minden egyértelmű: van egy tesztsorozat, amelynél bármilyen hiba elegendő ahhoz, hogy azt mondjuk, a build nem teljesítette a minőségi kaput. Az ilyen módon a statikus elemzés eredményeivel kapcsolatos kapu beállítása azonban megbukik: a legacy kódon annyi figyelmeztetés van, hogy azt teljesen figyelmen kívül hagyni nem lehet, de a termék szállítását sem lehet csak azért leállítani, mert figyelmeztetések vannak az elemzőben.
Mivel először alkalmazva bármely projektben az elemző óriási mennyiségű figyelmeztetést ad ki, amelyek túlnyomó többsége nem kapcsolódik a termék megfelelő működéséhez. Az összes megjegyzést egyszerre javítani nem lehet, és sok esetben nem is szükséges. Végső soron tudjuk, hogy a termékünk összességében működik, és a statikus elemzés bevezetése előtt is!
Ennek eredményeként sokan az epizodikus statikus elemzés használatára korlátozódnak, vagy csak információs módban használják, amikor a build során egyszerűen kiadnak egy jelentést az elemzőtől. Ez egyenértékű a teljes elemzés hiányával, mert ha már annyi figyelmeztetésünk van, akkor egy új (bármennyire is komoly) figyelmeztetés a kód módosításakor észrevétlen marad.
Az alábbi módszerek ismertek a minőségi kapuk bevezetésére:
- Az összes figyelmeztetés vagy a figyelmeztetések száma és a kód sorainak száma közötti arány limitjének beállítása. Ez rosszul működik, mivel az ilyen kapu szabadon engedi a változásokat új hibákkal, amíg a limitet nem lépik át.
- A régi figyelmeztetések kódba történő megszorítása, a figyelmeztetések figyelmen kívül hagyása egy adott pillanatban, és az új figyelmeztetések megjelenésekor a build visszautasítása. Ezt a funkciót a PVS-studio és néhány online forrás, például a Codacy kínálja. Nem dolgoztam a PVS-studio-val, ami a Codacy-t illeti, a fő problémájuk abban rejlik, hogy nehezen megállapítható, mi tekinthető 'régi' és mi 'új' hibának — ez egy meglehetősen bonyolult és nem mindig jól működő algoritmus, különösen akkor, ha a fájlok jelentősen módosulnak vagy átnevezésre kerülnek. Az emlékemben a Codacy képes volt kihagyni az új figyelmeztetéseket a pull requestekben, ugyanakkor nem engedte át a pull requestet a kód ezen változásainak figyelmen kívül hagyása miatt.
- Szerintem a leghatékonyabb megoldás az, ami a könyvben szerepel. A 'hálózati' módszer ('ratcheting'). A fő ötlet az, hogy minden kiadás sajátossága a statikus elemzés által talált figyelmeztetések mennyisége, és csak olyan változtatások engedhetők meg, amelyek nem növelik a figyelmeztetések összegét.
Hálózati
Ez így működik:
- A kezdeti lépésben a kiadás metadatumaiban rögzítjük a kódban található figyelmeztetések számát, amelyeket az elemzők találnak. Így, amikor a fő branchet építjük, nem egyszerűen '7.0.2 kiadás', hanem '7.0.2 kiadás, amely 100500 Checkstyle figyelmeztetést tartalmaz' kerül feljegyzésre. Ha fejlett repo menedzsert használ, például az Artifactory-t, könnyen megőrzi a kiadásához tartozó ilyen metadatokat.
- Mostantól minden pull request buildelése összehasonlítja a keletkező figyelmeztetések számát a jelenlegi kiadásban található mennyiséggel. Ha a PR ezen szám növekedéséhez vezet, a kód nem megy át a statikus elemzési minőségi kapun. Ha a figyelmeztetések száma csökken vagy változatlan marad — akkor átmegy.
- A következő kiadásnál a számított figyelmeztetések száma ismét feljegyzésre kerül a kiadás metadatumaiban.
Így, fokozatosan, de folyamatosan (mint egy ratchet működésekor), a figyelmeztetések száma a nullához fog közelíteni. Persze a rendszert meg lehet trükközni, ha új figyelmeztetést adunk hozzá, de kijavítunk egy régit. Ez rendben van, mert hosszú távon eredményt ad: a figyelmeztetéseket általában nem egyesével, hanem egy adott típusú csoportban javítják, és az összes könnyen kijavítható figyelmeztetés viszonylag gyorsan eltűnik.
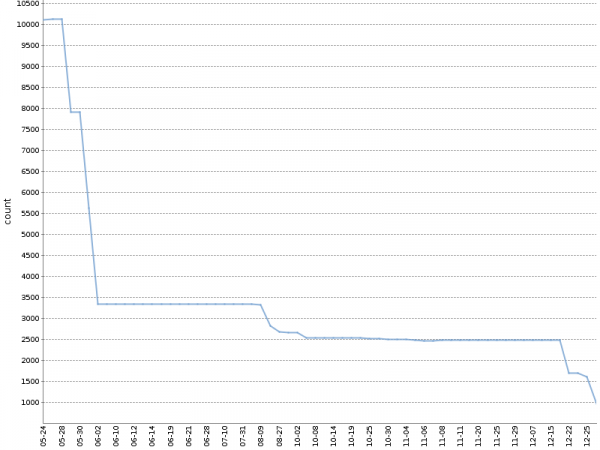
Ez a grafikon azt mutatja, hogy mennyi Checkstyle figyelmeztetés volt fél év alatt egy ilyen „ratchet” működésekor A figyelmeztetések száma egy nagyságrenddel csökkent, és ez természetes módon történt, párhuzamosan a termék fejlesztésével!
Én egy módosított verziót alkalmazok ebből a módszerből, amely külön számolja a figyelmeztetéseket a projekt moduljainak és elemző eszközeinek bontásában, a kialakuló YAML fájl metainformációval a buildről körülbelül így néz ki:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
Bármely fejlett CI-rendszerben a „ratchet” bármely statikus elemző eszközre megvalósítható, anélkül, hogy pluginokra vagy külső eszközökre lenne szükség. Minden elemző a saját jelentését adja egyszerű szöveges vagy XML formátumban, ami könnyen elemezhető. Csak a szükséges logikát kell beírni a CI-scriptbe. Megnézheti, hogyan valósítottuk meg ezt az open source projektjeinkben a Jenkins és Artifactory alapjain. vagy . Mindkét példa a : metódus countWarnings() a szokásos módon számolja a Checkstyle és Spotbugs által generált xml-címkéket a fájlokban, míg a compareWarningMaps() valósítja meg azt a bizonyos ratchet-et, amely hibaüzenetet ad, ha a figyelmeztetések száma bármelyik kategóriában növekszik.
Érdekes megvalósítási lehetőség a „hamisítvány” elemzésére a kommentek, szöveges literalok és dokumentáció helyesírásának ellenőrzésére az aspell segítségével. Mint tudjuk, helyesírás-ellenőrzés során nem minden ismeretlen szó, ami a standard szótárban nem szerepel, hibás; ezek felvehetők a felhasználói szótárba. Ha a felhasználói szótár a projekt forráskódjának részévé válik, akkor a helyesírási minőségi kapu a következőképpen fogalmazható meg: az aspell végrehajtása a standard és a felhasználói szótárral. nem találni helyesírási hibákat.
A verzióelemző rögzítésének fontossága
Összefoglalva meg kell jegyezni, hogy bármilyen módon is építi be az elemzést a szállítási folyamatába, a verzióelemzőt rögzítenie kell. Ha megengedjük a verzióelemző önálló frissítését, akkor a következő pull request összeállításakor új hibák „bukkanhatnak fel”, amelyek nem kapcsolódnak a kód változásaihoz, hanem ahhoz, hogy az új elemző egyszerűen képes több hibát találni — ez pedig megnehezíti a pull requestek átvételének folyamatát. Az elemző frissítése tudatos lépés kell, hogy legyen. Egyébként az összes építőelem verziójának szigorú rögzítése általában szükséges követelmény, és külön beszélgetés témája.
Következtetések
- A statikus elemzés nem fog hibákat találni, és nem javítja a terméke minőségét egyetlen alkalmazás eredményeként. Csak a folyamatos alkalmazásának van pozitív hatása a minőségre a szállítási folyamat során.
- A hibák keresése egyáltalán nem a legfőbb célja az elemzésnek; a hasznos funkciók többsége elérhető opensource eszközökben.
- Alkalmazza a statikus analízis eredményein alapuló minőségi kapukat a szállítási folyamat legelső szakaszában, használja a „hamisítványt” a legacy kódra.
Hivatkozások
- előadás a különböző kód-elemzési módszerekről (nemcsak statikus!)
Forrás: habr.com
