

A RabbitMQ egy Erlang nyelven írt üzenetbróker, amely lehetővé teszi a hibatűrő klaszterek létrehozását, teljes adatreplikációval több csomóponton, ahol minden csomópont képes olvasási és írási kérések kiszolgálására. Számos Kubernetes klasztert üzemeltetve a gyakorlatban, nagy számú RabbitMQ telepítést támogatunk, és szembesültünk a szükséggel, hogy adatokat migráljunk az egyik klaszterből a másikba leállás nélkül.
Ez a művelet legalább két esetben volt szükséges:
- Adatok átvitele egy RabbitMQ klaszterből, amely nem Kubernetes környezetben van, egy új, 'kubernetesesített' (azaz K8s podokban működő) klaszterbe.
- RabbitMQ migrációja Kubernetesen belül egyik namespace-ből a másikba (például, ha a határok névtereken keresztül vannak elhatárolva, akkor az infrastruktúra átviteléhez az egyik határból a másikba).
A cikkben javasolt recept olyan helyzetekre irányul (de nem korlátozódik ezekre), ahol van egy régi RabbitMQ klaszter (például 3 csomópontból álló), amely már K8s alatt van, vagy régi szervereken működik. Ezzel egy Kubernetesen telepített alkalmazás dolgozik (jelenleg ott vagy a jövőben):
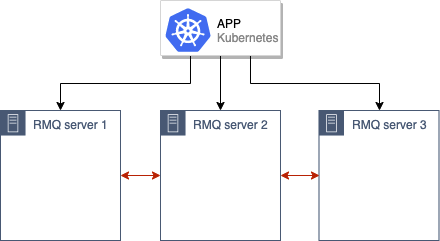
… és előttünk áll a feladat, hogy ezt migráljuk az új produkciós környezetbe Kubernetes alatt.
Először az általános megközelítést írjuk le a migrációhoz, majd ezt követően a technikai részletek a megvalósításáról.
A migrációs algoritmus
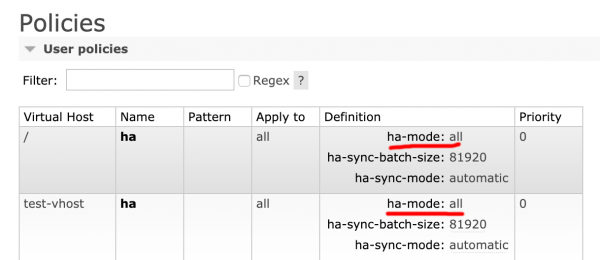
Az első, előzetes lépés bármely cselekedet előtt — ellenőrizni, hogy a régi RabbitMQ telepítésen a magas rendelkezésre állás üzemmód be van kapcsolva (). Az ok nyilvánvaló — nem akarunk elveszíteni adatokat. Ezt az ellenőrzést a RabbitMQ adminisztrátori felületén tehetjük meg, az Admin → Policies fül alatt megbizonyosodva arról, hogy az érték be van állítva ha-mode: all:
A következő lépés — új RabbitMQ klaszter indítása K8s podokban (ebben az esetben, például, 3 csomópontból álló, de a számuk más is lehet).
Ezután összekapcsoljuk a régi és az új RabbitMQ klasztert, így egy egyesített klasztert kapunk (6 csomópontból álló):
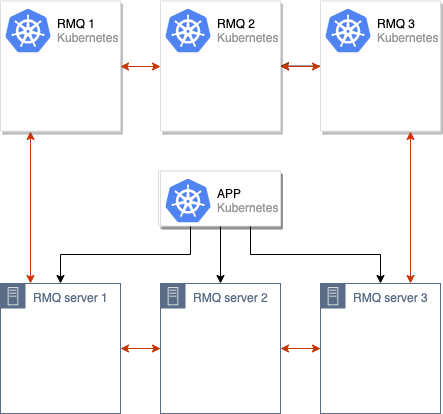
Megkezdődik az adatok szinkronizálása a régi és az új RabbitMQ klaszterek között. Miután minden adat szinkronizálva lett az összes csomóponton a klaszterben, átkapcsolhatjuk az alkalmazást az új klaszter használatára:
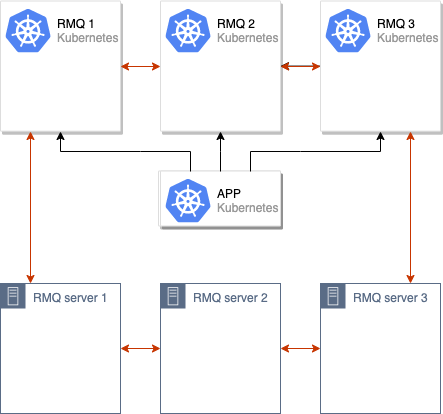
Ezek után elegendő, ha eltávolítjuk a régi csomópontokat a RabbitMQ klaszterből, és a költözést befejezettnek nyilváníthatjuk:
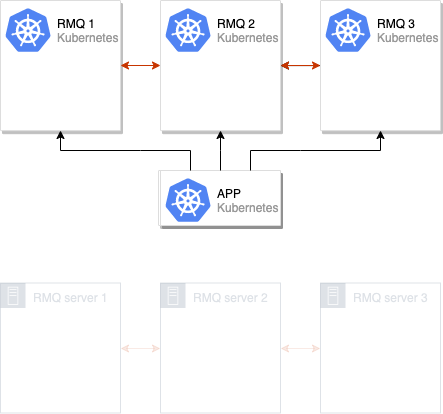
Ezt a sémát többször is alkalmaztuk a production környezetünkben. Azonban a saját kényelmünk érdekében megvalósítottuk egy speciális rendszer keretein belül, amely standard RMQ konfigurációkat terjeszt Kubernetes klaszterek tömegein. (azoknak, akiket érdekel: a szól, amiről nemrégiben )Alább különálló utasításokat mutatunk be, amelyeket mindenki alkalmazhat a saját telepítésein, hogy kipróbálja a javasolt megoldást a gyakorlatban.
Próbáljuk ki a gyakorlatban.
Követelmények
A követelmények nagyon egyszerűek:
- Kubernetes klaszter (a minikube is megfelelő);
- RabbitMQ klaszter (telepíthető bare metal-on is, vagy hagyományos Kubernetes klaszterként az hivatalos Helm-chartból).
A lent leírt példa kedvéért RMQ-t telepítettem Kubernetes-be, és elneveztem rmq-old.
A környezet előkészítése
1. Letöltjük a Helm-chartot, és egy kicsit módosítjuk:
helm fetch --untar stable/rabbitmq-ha A kényelem kedvéért beállítjuk a jelszót, ErlangCookie és készítünk egy politikát ha-all, hogy alapértelmezettként a sorok szinkronizálódjanak az RMQ klaszter minden csomópontja között:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Telepítjük a chartot:
helm install . --name rmq-old --namespace rmq-old3. Belépünk a RabbitMQ admin felületére, létrehozunk egy új sort, és hozzáadunk néhány üzenetet. Ezek szükségesek lesznek ahhoz, hogy a migráció után megbizonyosodjunk arról, hogy minden adat megmaradt és nem vesztettünk el semmit:

A tesztkörnyezet készen áll: van egy 'régi' RabbitMQ-nk az adatokkal, amelyeket át kell vinni.
RabbitMQ klaszter migrálása
1. Először telepítjük az új RabbitMQ-t a egy barátommal névtérben, ugyanazzal ErlangCookie és a felhasználó jelszavával. Ehhez hajtsuk végre a fent leírt műveleteket, és módosítsuk az RMQ telepítés végső parancsát a következőre:
helm install . --name rmq-new --namespace rmq-new2. Most szükség van arra, hogy összekapcsoljuk az új klasztert a régivel. Ehhez belépünk az egyes pod-okba új RabbitMQ és végrehajtjuk a parancsokat:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
Az OLD_RMQ változó tartalmazza egy régi RMQ klaszter csomópontnak a címét. Ezek a parancsok leállítják a jelenlegi csomópontot
az RMQ klaszterből, csatlakoztatják a régi klaszterhez, és újraindítják. új 3. A 6 csomópontból álló RMQ klaszter kész:
3. Az 6 csomópontos RMQ klaszter készen áll:
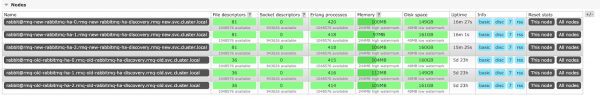
Várni kell, amíg az üzenetek szinkronizálódnak az összes csomópont között. Nem nehéz kitalálni, hogy az üzenetek szinkronizálásának ideje a használt hardver teljesítményétől és az üzenetek számától függ. A leírt forgatókönyvben mindössze 10 üzenetről van szó, ezért az adatok azonnal szinkronizálódtak, de elegendő számú üzenet esetén a szinkronizálás órákig is tarthat.
Tehát a szinkronizálás státusza:

Itt +5 azt jelenti, hogy az üzenetek már még 5 csomóponton vannak (azon kívül, amely a mezőben van Node). Így a szinkronizálás sikeresen lezajlott.
4. Csak annyit kell tenni, hogy az alkalmazásban az RMQ címét az új klaszterre állítjuk (a konkrét lépések itt a használt technológiai stacktől és az alkalmazás egyéb sajátosságaitól függnek), majd búcsút mondhatunk a réginek.
Az utolsó művelethez (azaz már a jelenlegi környezet parancsai után az alkalmazás új klaszterre váltásához) lépjünk be minden csomópontba RMQ klaszter csomópontnak a címét. a klaszterből, és hajtsuk végre a parancsokat:
rabbitmqctl stop_app
rabbitmqctl reset
A klaszter "elfelejtette" a régi csomópontokat: eltávolíthatjuk a régi RMQ-t, amivel a költözés befejeződik.
Megjegyzés: Ha RMQ-t tanúsítványokkal használ, akkor lényegében semmi nem változik — a költözési folyamat pontosan ugyanúgy fog zajlani.
Következtetések
A leírt séma gyakorlatilag minden esetben alkalmazható, amikor a RabbitMQ-t kell áthelyeznünk vagy egyszerűen új klaszterre kell költöznünk.
A mi esetünkben csak egyszer akadtak nehézségeink, amikor az RMQ-t több helyről hívták meg, és nem volt módunk az összes helyen megváltoztatni az RMQ címét az újára. Ilyenkor új RMQ-t indítottunk ugyanabban a névtérben, azonos címkékkel, hogy beleessen a már meglévő szolgáltatásokba és Ingress-ekbe, a pod indításakor pedig manuálisan manipuláltuk a címkéket, először eltávolítva azokat, hogy a üres RMQ-ra ne érkezzenek kérések, majd a szinkronizálás után visszaadva őket.
Ugyanezt a stratégiát alkalmaztuk, amikor a RabbitMQ-t új verzióra frissítettük módosított konfigurációval — minden problémamentesen működött.
P.S.
E téma logikai folytatásaként cikkeket készítünk a MongoDB-ről (migrálás egy fizikai szerverről Kubernetesbe) és a MySQL-ről (hogyan készítjük elő ezt az adatbázis-kezelőt Kubernetesben). Ezek a következő hónapokban fognak megjelenni.
P.P.S.
Olvasson további információkat a blogunkban:
- «»;
- «».
Forrás: habr.com
