

A MAX Data össze fog olvadni az Optane DC-vel, hogy hatékonyan működjön a mesterséges intelligencia és a gépi tanulás rendszereivel.
Fotó — — Unsplash
A a MIT Sloan Management Review és a The Boston Consulting Group kutatásai szerint a három ezer megkérdezett vezető 85%-a úgy véli, hogy a mesterséges intelligenciát használó rendszerek versenyelőnyhöz juttatják a vállalatokat. Azonban ezt a gyakorlatban mindössze 39% próbálta megvalósítani.
A helyzet egyik oka az, hogy az adatok hatékony kezelése és a gépi tanulási feladatokhoz szükséges kapacitások optimalizálása nem könnyű feladat. Az IDC , amely szerint a megoldást egy új, tartós memórián (Persistent Memory, PMEM) alapuló technológia jelentheti.
Ezt a technológiát a NetApp és az Intel javasolják, a NetApp Memory Accelerated (MAX) Data-t és az Intel Optane DC Persistent Memory-t, hogy egy helyi adatokat tároló terméket fejlesszenek ki, amely nem volatilis memórián alapul.
Hogyan működik ez
A MAX Data egy szervertechnológia, amely növeli az alkalmazások teljesítményét a PMEM vagy DRAM használatával, de nem igényel szoftverarchitektúra átalakítást.
Ez az automatizált több szintű tárolás elvén működik, amely az adatok használati gyakorisága alapján osztja fel a tárolási szinteket és eszközöket - a „hideg” adatokhoz olcsóbb tárolókat használ, míg a gyakran használt adatok „karnyújtásnyira” állnak a Persistent Memory-n belül, ami minimalizálja a késleltetést az ilyen adatokkal való munka során.
Az 1.1-es verzió DRAM-ot és Mindkét megoldásnak megvannak a hátrányai - a relatív hatékonyságcsökkenés és a memória magas költsége - az Optane DCPMM-hez képest. A késleltetés összehasonlító értékelését bemutató diagram található (4. oldal).
Technológia és és a blokk- vagy fájlrendszerek szemantikájának kezelésére. Az adatok védelmét és visszaállítását tárolási szinten a MAX Snap és a MAX Recovery megoldások valósítják meg. Ezek a technológiák szeptemberi pillanatfelvételeket, a SnapMirror eszközt és más védelmi mechanizmusokat alkalmaznak az ONTAP-ban.
A megvalósítás sémája a következőképpen néz ki:
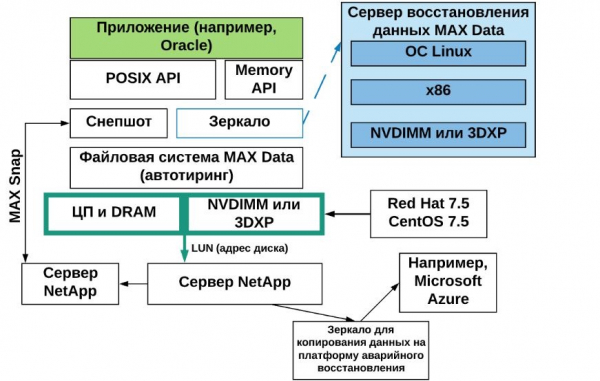
A diagramon a PMEM még nem látható, de a fejlesztők ígérik, hogy az év végéig támogatást adnak ennek a memóriafajtának. Jelenleg a Max Data DRAM-mal és DIMM-mel működik.
A megoldás potenciálja
Az IDC , hogy a következő években a MAX Data-hoz hasonló fejlesztések növekedni fognak, mivel a vállalati adatok mennyisége folyamatosan nő, míg a cégek kapacitásai nem elegendőek azok hatékony feldolgozásához. A technológia használható egy skálázható felhő környezetben és erőforrás-igényes feladatok, például a mélytanulás szempontjából. Alkalmazzák kereskedési platformokon, IT biztonsági rendszerekben és bármilyen más szoftvertermékben, ahol állandó és gyors hozzáférés szükséges nagy adatmennyiségekhez.
Van egy valószínűség arra, hogy a technológia nem azonnal terjed el a piacon. Ahogy korábban említettük, világszerte csak a cégek egyharmada dolgozik valamilyen mesterséges intelligenciával. Ebből a szempontból a MAX Data megjelenését sokan korainak tarthatják, és a figyelmüket egy elérhetőbb infrastruktúrára összpontosítják, amely lehetővé teszi a jelenlegi feladatok megoldását.
Más anyagaink az IT-infrastruktúráról:
Forrás: habr.com
