

A DevOps meghatározása nagyon bonyolult, ezért minden alkalommal újra kell indítanunk a vitát erről. Csak a Habr-on ezer publikáció jelent meg a témában. De ha ezt olvasod, akkor bizonyára tudod, mi az a DevOps. Mert én nem tudom. Helló, a nevem Alexandr Titov (@), és egyszerűen csak beszélgetni fogunk a DevOps-ról, és megosztom veletek a tapasztalataimat.
Hosszú ideig azon gondolkodtam, hogyan tehetném hasznossá a történetemet, ezért sok kérdést fogok feltenni — azokat, amiket magamnak teszek fel, és azokat, amiket a cégünk ügyfeleinek. Ezekre a kérdésekre válaszolva jobban megérthetjük a dolgokat. Elmondom, miért van szükség DevOps-ra a saját nézőpontomból, hogy mit jelent ez, újfent az én álláspontom szerint, és hogyan érthetjük meg, hogy a DevOps felé haladunk, újra az én szemszögemből. Az utolsó pont kérdések formájában fog megjelenni. Ha magamnak válaszolok rájuk, akkor megértem, hogy a céged közelít a DevOps-hoz vagy valami probléma van vele.
Egyszer egy időben a fúziók és felvásárlások hullámain kavargattam. Először dolgoztam egy kis startupnál, a Qik-nál, majd egy nagyobb cég, a Skype vásárolta meg, amit aztán egy még nagyobb cég, a Microsoft. Ebben a pillanatban lett világos számomra, hogyan alakul át a DevOps-ra vonatkozó elképzelés különböző méretű cégeknél. Ezután már a piac szempontjából szerettem volna ránézni a DevOps-ra, ezért kollégáimmal megalapítottuk az Express 42-t. Már 6 éve hajózunk vele a piacon.
Mindezeken túl én vagyok a DevOps Moscow közösség egyik szervezője és a DevOps Days 2017 szervezője, de 2018-ban nem voltam szervező. Az Express 42 számos céggel dolgozik. Ott növeljük a DevOps-t, figyeljük, hogyan zajlik, következtetéseket vonunk le, elemzünk, és megosztjuk a következtetéseinket mindenkivel, oktatjuk az embereket DevOps gyakorlatokban. Szóval minden lehetséges módon növeljük ebben az értelemben a tapasztalatunkat és szakértelmünket.
Miért DevOps
Az első kérdés, ami mindenkit mindenkor foglalkoztat - miért? Sokan úgy vélik, hogy a DevOps csupán automatizálás vagy hasonló dolog, ami már minden cégnél ott van.
— Volt Continuous Integration - ez azt jelenti, hogy már volt DevOps, és miért van szükség erre az egész marhaságra? Ott a határon szórakoznak, minket pedig a munka zavar!
Kilenc éves közösségi és módszertani fejlődés után már világos, hogy ez nem csupán marketingcélokat szolgál, viszont még mindig nem teljesen egyértelmű, hogy mire van szükség. Mint minden eszköznek és folyamatnak, a DevOps-nak is konkrét céljai vannak, amelyeket végül elér.
Mindez a világnak a változásaival összefügg. A vállalatok eltávolodnak a vállalati megközelítésektől, amikor a cégek az álmuk felé haladnak, ahogy a mi pétervári klasszikusunk énekelte, A pontból B pontba egy meghatározott stratégia mentén, amelyhez előre megtervezett struktúrát állítottak fel.
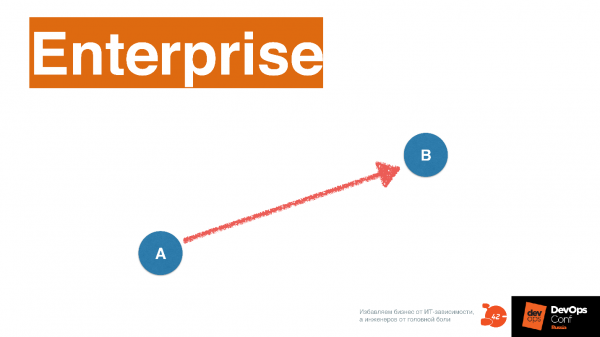
Alapvetően az IT-nak is ezt a megközelítést kell tükröznie. Az IT-t kizárólag a folyamatok automatizálására használják.
Az automatizálás nem változik gyakran, mert amikor egy cég megszokott ösvényén halad — mit is lehetne változtatni? Ha működik, ne nyúlj hozzá. Most a világban a megközelítések változnak, és az, amit Agile-nek nevezünk, azt mondja, hogy az B pont végső célja nem mindig látható.
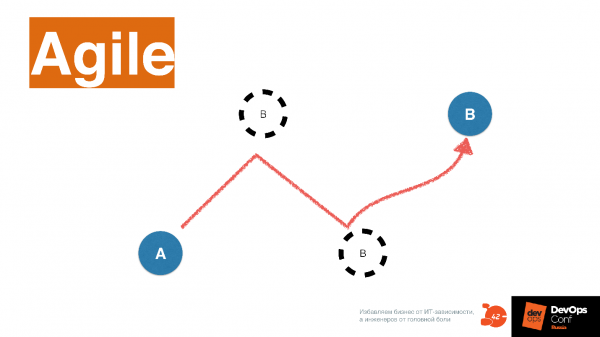
Amikor a vállalat a piacon mozog, és kapcsolatban áll az ügyféllel — folyamatosan kutatja a piacot és megváltoztatja a végső B pontot. Ráadásul minél gyakrabban változtat a cég az irányán, annál sikeresebb lesz, mert több piaci rést választ ki.
Egy érdekes stratégiai példát mutat be egy cég, amiről nemrég értesültem. A One Box Shave egy féléves ciklusú, borotvák és borotválkozási kiegészítők előfizetéses szolgáltatása. Képesek testre szabni a "dobozukat" a különböző ügyfelek számára. Ezt egy bizonyos szoftver végzi, amely ezután megrendelést küld egy koreai gyárnak, amely a terméket gyártja.
Ezt a terméket az Unilever vásárolta meg 1 milliárd dollárért. Jelenleg a Gillette-tel versenyez, és jelentős vásárlói részesedést szerzett az amerikai piacon. A One Box Shave így fogalmaz:
— Négy pengét? Komolyan? Miért van szüksége erre — ez egyáltalán nem javítja a borotválkozás minőségét. Egy különlegesen kiválasztott krém, illat és egy jó minőségű borotva két pengével sokkal több problémát megold, mint ezek a hülye négyélű Gillette pengék! Hamarosan már tízig jutunk?
Így változik a világ. Az Unilever azt állítja, hogy van egy menő IT-rendszerük, amely lehetővé teszi ezt. Az eredmény egy olyan koncepció, Time-to-market, amiről már sokan beszéltek.
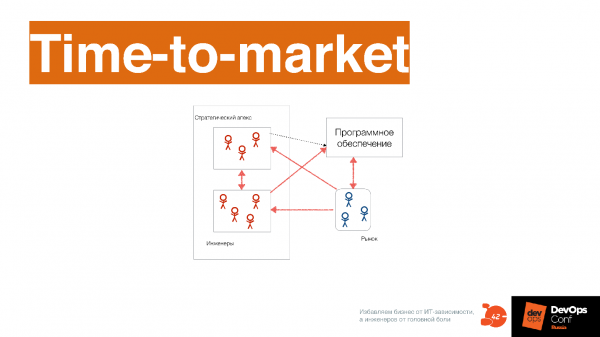
A Time-to-market lényege nem abban rejlik, hogy milyen gyakran telepítünk. Gyakran lehet telepíteni, de a kiadási ciklusok hossza hosszú lehet. Ha három hónapos kiadási ciklusokat egymásra helyezünk egy hét csúszással, úgy tűnik, hogy a cég heti rendszerességgel telepít. Az ötlettől a végső megvalósításig 3 hónap telik el.
A Time-to-market az idő minimalizálásáról szól az ötlettől a végső megvalósításig.
Ebben az esetben a szoftver lép kapcsolatba a piaccal. Például a One Box Shave weboldala kapcsolódik a vásárlóhoz. Nincs értékesítőjük – csak egy weboldal, ahol a látogató rákattint és megjegyzéseket hagy. Ennek megfelelően folyamatosan frissíteni kell az oldalt az új információkkal, a vásárlói kérések szerint. Például Dél-Koreában nem úgy borotválkoznak, mint Oroszországban, és ők nem fenyőillatot, hanem például vaníliás sárgarépát kedvelnek.
Mivel gyorsan kell változtatnunk a weboldal tartalmán, a szoftverfejlesztés jelentősen átalakul. A szoftveren keresztül kell információt szereznünk arról, mit akar az ügyfél. Korábban ezt valahogy kerüljük meg, például üzleti menedzsmenten keresztül. Aztán terveztünk, követelményeket határoztunk meg az IT-rendszerben, és minden nagyszerű volt. Most már másképp van – a szoftvert mindenki tervezi, aki részt vesz a folyamatban, beleértve a mérnököket is, mert ők a műszaki jellemzők alapján tudják, hogyan működik a piac, és megosztják a vállalattal a saját meglátásaikat.
Például a Qik cégnél hirtelen megtudtuk, hogy az emberek nagyon szeretik a kontaktlisták feltöltését a szerverre, és adtak nekünk egy alkalmazást. Eredetileg nem gondoltunk erre. Klasszikus cégnél mindenki azt mondaná, hogy ez egy hiba, mert a specifikációban nincs benne, hogy ennek jól kell működnie, és egyébként is, kézivezérléssel lett megvalósítva, kikapcsolták volna a funkciót, és azt mondták volna: "Ez senkinek sem szükséges, a legfontosabb, hogy a fő funkció működik." De egy technológiai cég lehetőséget lát ebben, és elkezdi módosítani a szoftvert ennek megfelelően.
1968-ban Melvin Conway, a jövőbelátó srác, megfogalmazta a következő elképzelést.
A szervezet, amely rendszert hoz létre, korlátozva van a tervezés által, amely másolja a kommunikációs struktúrát ebben a szervezetben.
Ha részletesebben megvizsgáljuk, más típusú rendszerek előállításához szükség van egy másfajta kommunikációs struktúrára is a cégen belül. Ha a kommunikációs struktúra felső hierarchikus, az nem engedi meg, hogy olyan rendszereket készítsenek, amelyek nagyon magas Time-to-market mutatót biztosítanak.
Olvasd el lehetővé teszi . Fontos a DevOps kultúrájának vagy filozófiájának megértéséhez, mivel az egyetlen alapvető dolog, ami megváltozik a DevOps-ban, az éppen a kommunikációs struktúra a csapatok között..
A folyamat szempontjából eddig a DevOps-ig minden lépés: elemzés, fejlesztés, tesztelés, üzemeltetés, lineárisan zajlott.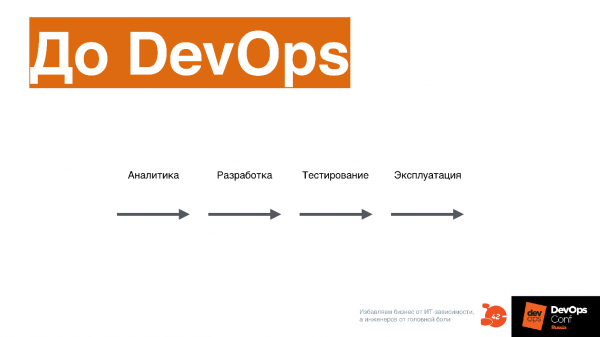
DevOps esetében mindezek a folyamatok párhuzamosan futnak.
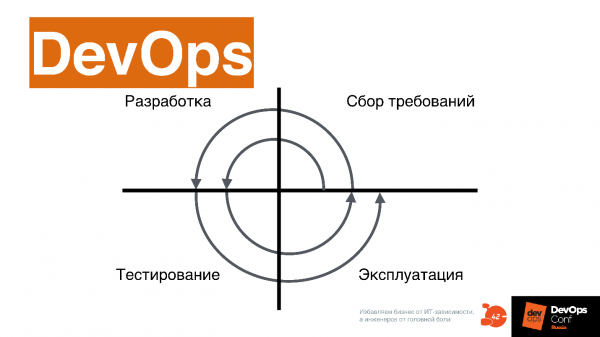
A Time-to-market csak így teljesíthető. Azok számára, akik a régi folyamatban dolgoztak, ez kissé űrinek tűnik, és egyébként sem túl jó.
Tehát miért van szükség DevOps-ra?
Digitális termékek fejlesztéséhez. Ha a cégednek nincs digitális terméke, a DevOps nem szükséges - ez nagyon fontos.
A DevOps áthidalja a szoftverfejlesztés lineáris folyamatának sebességi korlátait.. Itt minden folyamat párhuzamosan zajlik.
Növekszik a komplexitás. Amikor a DevOps evangelistái azt mondják, hogy vele könnyebb lesz szoftvert kiadni - ez butaság.
A DevOps-szal minden csak bonyolultabbá válik.
A konferencián az Avito standján meg lehetett nézni, milyen az, amikor Docker konténert telepíteni - elképzelhetetlen feladat. A komplexitás elérhetetlenné válik, egyszerre sok labdával kell zsonglőrködni.
A DevOps teljesen megváltoztatja a folyamatot és a cégen belüli szervezetet — pontosabban nem a DevOps, hanem a digitális termék változtatja meg. Ahhoz, hogy elérjük a DevOps-ot, ezt a folyamatot teljesen meg kell változtatni.
Kérdések a szakembernek
És nálatok mi a helyzet? Kérdések, amelyeket feltehetsz magadnak, miközben a cégnél dolgozol és fejlődsz szakemberként.
Van stratégiátok a digitális termék létrehozására? Ha van - már jól álltok. Ez azt jelenti, hogy a céged a DevOps felé halad.
A céged már létrehoz digitális terméket? Ez azt jelenti, hogy már egy lépéssel magasabbra léphetsz, érdekesebb feladatokkal foglalkozhatsz - a DevOps szempontjából újra csak. Ezt a nézőpontot hangsúlyozom.
A céged a digitális terméket kínáló piac egyik vezetője? Spotify, Yandex, Uber – olyan vállalatok, amelyek jelenleg a technológiai fejlődés csúcsán állnak.
Tedd fel ezeket a kérdéseket magadnak, és ha minden válasz negatív, akkor lehet, hogy nem is kellene DevOps-szal foglalkoznod ennél a cégnél. Ha viszont téged tényleg érdekel a DevOps, lehet, hogy… érdemes lenne egy másik céghez átmenni? Ha a céged a DevOps irányába szeretne haladni, de minden kérdésre 'Nem' választ adtál, akkor olyan, mint ez a csodálatos orrszarvú, aki sosem fog megváltozni.
Szervezet
Ahogy már mondtam, Conway törvénye szerint a cég szervezete megváltozik. Kezdem azzal, hogy mi gátolja a DevOps behatolását a cégbe a szervezeti szempontból.
A 'kolod' problémája
Az angol 'Silo' itt oroszul 'kolod'-ra lett fordítva. Ennek a problémának a lényege az, hogy nincs információcsere a csapatok között. Minden csapat saját szakértelmét mélyíti, anélkül, hogy közös térképet építene, amely alapján tájékozódhatnának.
Ez valamelyest hasonlít ahhoz, mint amikor valaki most érkezett Moszkvába, és még nem tud tájékozódni a metró térképe alapján. A moszkvaiak általában tökéletesen ismerik a környéküket, de egész Moszkvában a metró térképe alapján tájékozódnak. Amikor először érkezel Moszkvába, még nincs meg ez a készséged, és egyszerűen dezorientált vagy.
A DevOps azt javasolja, hogy átlépjük ezt a dezorientációs pillanatot, és minden részleg együtt építse meg a közös együttműködési térképet.
Ennek két tényezője van.
A vállalati irányítási rendszer következménye. Ez különböző hierarchikus 'kolod'-okból épül fel. Például vannak bizonyos KPI-k a vállalatokban, amelyek fenntartják ezt a rendszert. Másrészt, gátolja az a gondolkodásmód is, amely megnehezíti, hogy az ember túllépjen a saját szakértelmén és orientálódjon az egész rendszerben. Ez egyszerűen kényelmetlen. Képzeld el, hogy Bangkokban vagy egy repülőtéren – ott nem könnyű tájékozódni. A DevOps-ban is nehéz tájékozódni, ezért az emberek azt mondják, hogy szükség van egy idegenvezetőre, hogy eljussanak oda.
De a legfontosabb az, hogy a 'kolodok' problémája az engineer számára, aki átitatódott a DevOps szellemével, olvasott Fowlert és sok más könyvet, abban nyilvánul meg, hogy a 'kolodok' nem engedik, hogy 'nyilvánvaló' dolgokat tegyenek. Gyakran összegyűlünk a DevOps Moszkva után, beszélgetünk egymással, és az emberek panaszkodnak:
Csak CI-t szerettünk volna elindítani, de úgy tűnik, a menedzsmentnek ez nem szükséges.
Ez pontosan abból adódik, hogy CI és Folyamatos Szállítási folyamat sok különböző szakértelem határán állnak. Ha nem léped át a 'kút' problémát szervezeti szinten, nem fogsz tudni előrébb lépni, bármit is csinálsz, és bármennyire is szomorú ez.
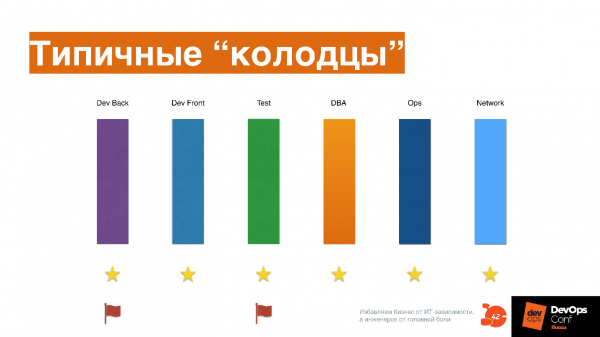
A folyamat minden résztvevője a cégnél: backend és frontend fejlesztők, tesztelés, DBA, üzemeltetés, hálózat, mind a saját irányukba dolgozik, de senkinek nincs átfogó térképe, kivéve a menedzsert, aki valahogy felügyeli őket és a 'oszd meg és uralkodj' módszert alkalmazza.
Az emberek valamilyen csillagokért vagy zászlókért küzdenek, mindenki a saját szakértelmébe ástuk magunkat.
Végül, amikor az a feladat, hogy mindezt összekapcsoljuk egy közös pipelinné, és a csillagokért és zászlókért már nem kell harcolni, felmerül a kérdés - mit is kellene tenni egyáltalán? Valahogy meg kellene állapodni, de ezt hogyan tegyük, azt az iskolában senki nem tanította nekünk. Még az iskolából megtanultuk: nyolcadik osztály - wow! - a hetedik osztályhoz képest! Itt is ugyanez van.
A cégedben is így van?
Ennek ellenőrzéséhez feltehetsz magadnak a következő kérdéseket.
Használják-e a csapatok a közös eszközöket, hozzájárulnak-e ezeknek a közös eszközöknek a módosításához?
Mennyire gyakran alakulnak át a csapatok - az egyes szakemberek egyik csapatból egy másik csapatba átkerülnek? A DevOps környezetben ez normálissá válik, mert néha az ember egyszerűen nem érti, hogy egy másik szakmai terület mivel foglalkozik. Átkerül egy másik osztályba, ott két hétig dolgozik, hogy létrehozza magának a tájékozódási és együttműködési térképet.
Lehet-e létrehozni egy változáskezelési bizottságot, és valamit megváltoztatni? Vagy ehhez a legfelső vezetés erős kezére és utasítására van szükség? Nemrégiben írtam a Facebookra, hogy egy kevésbé ismert bank hogyan vezeti be az eszközöket utasításokkal: írtak egy utasítást, egy évig vezetik be, figyelik, mi történik. Ez természetesen hosszú és szomorú.
Mennyire fontos a menedzserek számára, hogy személyes teljesítményeket érjenek el a vállalat teljesítményeinek figyelembevétele nélkül?
Ha ezekre a kérdésekre válaszolsz, világossá válik, hogy van-e ilyen problémád a cégednél.
Infrastruktúra mint kód
Miután ezt a problémát megoldották, az első fontos gyakorlat, amely nélkül nehezen lehet előrehaladni a DevOps-ban, az infrastruktúra mint kód.
A legtöbben az infrastruktúrát mint kódot úgy értelmezik:
— Automatikus mindent bash-en, megpakoljuk szkriptekkel, hogy az adminoknak kevesebb kézi munkájuk legyen!
De nem így van.
Az infrastruktúra mint kód azt jelenti, hogy az IT-rendszert, amellyel dolgozik, kódként kell leírni, hogy folyamatosan értsék az állapotát.
Más csapatokkal együtt létrehoz egy térképet kódként, ami mindenki számára érthető, amire lehet orientálódni, navigálni. Teljesen mindegy, hogy ezt mivel csinálja – Chef, Ansible, Salt, vagy YAML fájlokat használ Kubernetes-ben – nem számít.
A konferencián egy kolléga a 2GIS-től mesélt arról, hogyan készítettek egy belső megoldást Kubernetes-re, amely leírja az egyes rendszerek felépítését. Ahhoz, hogy 500 rendszert leírjanak, külön eszközre volt szükségük, amely generálja ezt a leírást. Amikor ez a leírás megvan, mindenki össze tudja vetni a másikkal, figyelni tudja a változásokat, hogy hogyan lehet azt módosítani és javítani, mi hiányzik belőle.
Azt hiszem, az egyes bash-szkriptek általában nem adnak ilyen megértést. Az egyik olyan cégnél, ahol dolgoztam, még a 'write only' szkript név is létezett – amikor a szkript már meg van írva, de már nem lehet elolvasni. Gondolom, ez Önnek is ismerős.
Az infrastruktúra mint kód – ez kod, amely leírja az infrastruktúra aktuális állapotát. Ezt a kódot számos termék-, infrastruktúra- és szolgáltatócsapat közösen szerkeszti, és ami a legfontosabb, mindenkinek értenie kell, hogy ez a kód hogyan működik egyáltalán.
A kódot a legjobb kódolási gyakorlatok szerint kezelik: közös fejlesztés, kód-ellenőrzés, XP-programozás, tesztelés, pull requestek, CI az infrastruktúra kódjához – mindez hasznos és alkalmazható.
A kód közös nyelvvé válik minden mérnök számára.
Az infrastruktúra kódjában a változtatás nem vesz igénybe sok időt. Igen, az infrastruktúra kódjában is lehet technikai adósság. Általában a csapatok másfél év után találkoznak vele, miután elkezdték bevezetni az 'infrastruktúra mint kód' koncepciót, egy halom szkripttel vagy akár Ansible-lal, amit spagetti kódnak írnak, és még bash-szkripteket is dobnak a tűzbe!
Fontos: ha még nem próbáltad ki ezt a vacakot, tudd, hogy Az Ansible nem bash! Gondosan olvasd el a dokumentációt, tanulmányozd, mit írnak erről egyáltalán.
Az infrastruktúra mint kód egy rétegzett megközelítés az infrastruktúra kódjában.
A cégünknél 3 alapvető réteget emelünk ki, amelyek nagyon érthetőek és egyszerűek, de lehetnek többek is. Megnézheted az infrastruktúrád kódját, és elmondhatod, hogy van-e ez a feltétel nálad vagy sem. Ha nincsenek kiemelt rétegek, akkor érdemes időt szánni arra, hogy kicsit refaktoráljunk.
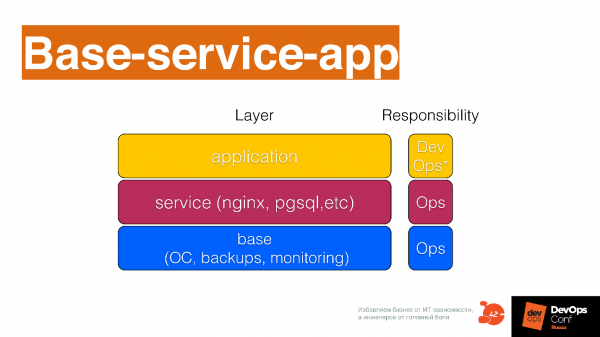
Alapréteg — ez az operációs rendszer konfigurálása, a biztonsági mentések és más alacsony szintű dolgok, például, hogy hogyan telepítjük a Kubernetes-t alap szinten.
Szolgáltatási réteg — ezek azok a szolgáltatások, melyeket a fejlesztőknek nyújtasz: naplózás mint szolgáltatás, monitoring mint szolgáltatás, adatbázis mint szolgáltatás, terheléselosztó mint szolgáltatás, üzenetsor mint szolgáltatás, folyamatos szállítás mint szolgáltatás — rengeteg szolgáltatás, amelyeket különböző csapatok kínálhatnak a fejlesztéshez. Ez mind leírandó külön modulokban a konfigurációs menedzsment rendszeredben.
Réteg, ahol az alkalmazások készülnek és van egy leírás arról, hogyan fognak települni a két korábbi réteg fölé.
Ellenőrző kérdések
Van-e a cégednek közös infrastruktúra tárolója? Ellenőrzöd-e a technikai adósságot az infrastruktúrában? Használod-e a fejlesztési gyakorlatokat az infrastruktúra tárolóban? Rétegezve van-e az infrastruktúrád? Ellenőrizheted az alap-szolgáltatás-ALKALMAZÁS terveket. Mennyire nehéz módosítani?
Ha találkoztál azzal, hogy a módosítások másfél napig tartottak, az azt jelenti, hogy technikai adósságod van, és foglalkoznod kell vele. Éppen rábukkantál a technikai adósság csapdáira az infrastruktúra kódban. Sok olyan történetet ismerünk, amikor ahhoz, hogy megváltoztassunk egy CCTL-t, az infrastruktúra kódjának felét kellett újraírnunk, mert a kreativitás és a minden automatizálására való vágy oda vezetett, hogy mindenhol eldugult, minden kéz eltűnt, és szükséges a refaktorálás.
Folyamatos szállítás
Összevetjük a debitet a kredittel. Először is megjelenik az infrastruktúra leírása, amely elég alapvető lehet. Nem szükséges mindent részletesen leírni, de valamilyen alapvető leírásra szükség van ahhoz, hogy ezzel dolgozhass. Különben nem világos, hogy mire építhetjük a folyamatos szállítást. Mindezek a gyakorlatok egyszerre bontakoznak ki, amikor a DevOps-ra jutunk, de mindenképpen a meglévő dolgok megértésével kell kezdeni, és hogy hogyan lehet ezeket kezelni. Ez pontosan az infrastruktúra mint kód gyakorlata.
Miután világossá vált, hogy mit is van, és hogyan kell azt kezelni, elkezded kitalálni, hogyan lehet a fejlesztő kódját a lehető leggyorsabban a termelésbe juttatni. Ezt közösen kell megtervezni a fejlesztővel - emlékezzünk a „kút” problémájára, tehát nem különálló emberek kitalálják ezt, hanem csapatban.
Amikor mi Iván Jevtuhovics-sal láttuk az első könyvet Jez Hambl jó és a szerzők csoportja „Folyamatos Szállítás”, amely 2009-ben jelent meg, sokáig gondolkodtunk, hogyan fordítsuk le a címét oroszra. Azt akartuk fordítani, hogy „Folyamatosan szállítani”, de sajnos „Folyamatos Szállítás”-ra fordítottuk. Úgy érzem, hogy a mi címünkben van valami oroszos, lendületes.
Folyamatosan szállítani - ez annyit jelent,
A kód, amely a termékek tárolójában található, mindig készen áll a termelésbe való kiadásra. Lehet, hogy nem kerül kiadásra, de mindig kész arra. Ennek megfelelően mindig úgy írsz kódot, hogy egy nehezen megmagyarázható érzés ott van a farokcsigolyád alatt. Ez gyakran előjön, amikor az infrastruktúra kódját kiadod. Ennek az aggodalomnak valamilyen szinten jelen kell lennie - ez olyan agyi folyamatokat indít el, amelyek lehetővé teszik, hogy kicsit másképp írják a kódot. Ezt a fejlesztés belső szabályaiban rögzíteni kell.
A folyamatos szállításhoz szükséges egy olyan artefaktum formátum, amely áthalad az infrastruktúra platformján. Ha különböző formátumú „életmérgezéssel” dobálsz az infrastruktúra platformra, akkor az nem egységes, nehezen karbantartható lesz, és technikai adósság problémák merülnek fel. Az artefaktum formátumát egységesíteni szükséges - ez is közös feladat: mindenkinek össze kell ülnie, átgondolnia, és meg kell terveznie ezt a formátumot.
Az artefakt folyamatosan fejlődik és változik a termelési környezethez, miközben végighalad a szállítási folyamaton. Amikor az artefakt halad a folyamatban, folyamatosan találkozik különféle kellemetlen dolgokkal, amelyek hasonlítanak arra, amivel az artefakt találkozik, amikor a termelésbe kerül. Ha a klasszikus fejlesztésben ezt a rendszergazda végzi, aki a kiadást lebonyolítja, akkor a DevOps folyamatban ez folyamatosan történik: itt egyes tesztekkel megforgatták, itt - egy Kubernetes klaszterbe dobták, ami nagyjából hasonlít a termeléshez, itt hirtelen terheléses tesztelést indítottak.
Ez valamelyest emlékeztet a Pac-Man játékra - az artefakt valamilyen történeten megy keresztül. Fontos ellenőrizni, hogy a kód valóban átmegy-e a történeten, és hogy az valahogyan kapcsolódik-e a termeléshez. A termelési történeteket be lehet vonni a Folyamatos Kiszállítási folyamatba: úgy kezdődött, hogy amikor valami leállt, akkor programozzuk ezt a forgatókönyvet be a rendszerbe. Minden alkalommal a kód is át fog menni ezen a forgatókönyvön, és legközelebb nem fogsz találkozni ezzel a problémával. Sokkal korábban fogsz tudomást szerezni róla, mint hogy az eljusson a kliensedhez.
Különböző telepítési stratégiák. Például AB-tesztelést vagy kanárideployt használsz, hogy különböző módon "taperd" a kódot különböző felhasználóknál, és információt kapj arról, hogyan működik a kód, sokkal korábban, mint amikor 100 millió felhasználóhoz eljut.
A "Folyamatos szállítás" így néz ki.
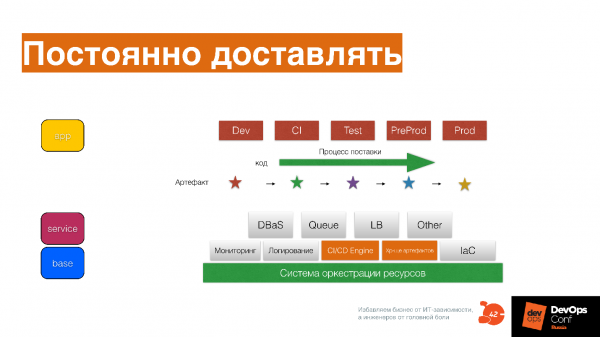
A Dev, CI, Teszt, PreProd, Prod szállítási folyamat nem külön környezet, hanem stációk vagy állomások, amelyek mentén az artefaktod halad.
Ha van egy infrastruktúrakódod, amely mint Base Service APP van leírva, akkor ez segít ne felejtsd el az összes forgatókönyvet, és ezeket is kód formájában rögzíteni az artefakt számára, előmozdítani az artefaktot és változtatni rajta a folyamat során.
Ellenőrző kérdések
A funkció leírásától a termelésbe való kiadásig 95%-ban kevesebb mint egy hét? Minden egyes szakaszban javul az artefakt minősége? Van története, amelyen áthalad? Használod a különböző telepítési stratégiákat?
Ha minden válasz igen, akkor igazán menő vagy! Írd le a válaszaidat a kommentekben - örömmel veszem őket.)
Visszajelzés
Ez a legnehezebb gyakorlat az összes közül. A DevOpsConf konferencián egy kollégám az Infobiptól, beszélve róla, kicsit zavarban volt a szavakkal, mert ez valóban egy nagyon bonyolult gyakorlat arról, hogy mindent monitorozni kell!
Például, réges-régen, amikor a Qik-nál dolgoztam és rájöttünk, hogy mindent monitorozni kell. Ezt megtettük, és a Zabbix-ban megjelent 150 000 folyamatosan monitorozott elem. Ez félelmetes volt, a műszaki igazgató az ujjával tekerte a templomát:
— Fiúk, miért kínozzátok a szervert érthetetlen módon?
De aztán történt egy eset, ami megmutatta, hogy ez valóban egy nagyon jó stratégia.
Folyamatosan elkezdett összeomlani az egyik szolgáltatás. Kezdetben nem omlott össze, ami érdekes, mert a kód nem változott, mivel ez egy alap broker volt, amiben gyakorlatilag nem volt üzleti funkció – csak üzeneteket küldött különböző szolgáltatások között. A szolgáltatás 4 hónapig nem változott, és hirtelen elkezdett összeomlani "Segmentation fault" hibával.
Sokkban voltunk, megnyitottuk a grafikonjainkat a Zabbixban, és kiderült, hogy másfél héttel ezelőtt jelentősen megváltozott a kérések viselkedése abban az API-szolgáltatásban, amely ezt a brokert használja. Aztán megnéztük, hogy megváltozott egy bizonyos típusú üzenet küldésének a gyakorisága. Kiderült, hogy ez android kliens volt. Megkérdeztük:
— Fiúk, mi történt veletek másfél héttel ezelőtt?
A válaszban egy érdekes történetet hallottunk arról, hogy átírták a UI-t. Aligha mondaná valaki azonnal, hogy megváltoztatta a HTTP könyvtárat. Az android klienseknek ez olyan, mint a szappan cseréje a fürdőszobában – egyszerűen nem emlékeznek rá. Végül, 40 perc beszélgetés után kiderült, hogy tényleg megváltoztatták a HTTP könyvtárat, és a default időtartamok is megváltoztak. Ez ahhoz vezetett, hogy megváltozott a forgalom viselkedése az API szerveren, ami a brokerben belső versenyt gerjesztett, és elkezdett összeomlani.
Mély monitorozás nélkül ezt egyáltalán lehetetlen lenne felfedezni.. Ha a szervezetben van még egy „kút” probléma, amikor mindenki egymásra mutogat, ez éveken át tarthat. Csak újraindítja a szervert, mert lehetetlen megoldani a problémát. Amikor figyeli, nyomon követi és rögzíti az összes eseményt, ami Önnel történik, és a monitorozást tesztelésként használja – kódot ír és rögtön megadja, hogyan lehet monitorozni, szintén kód formájában (már van nálunk infrastruktúra mint kód), minden világossá válik. Még az ilyen bonyolult problémák is könnyen nyomon követhetők.
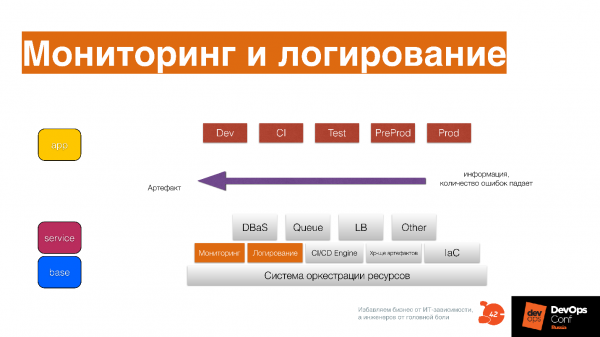
Gyűjtse össze az összes információt arról, hogy mi történik az artemban a szállítási folyamat minden szakaszában – ne a termelésben.
Töltse fel a monitorozást a CI-be, és ott már láthatók lesznek bizonyos alap dolgok. Később ezeket a Testben, a PredProd-ban és a terheléses tesztelés során is látni fogja. Gyűjtse az információkat minden szakaszban, ráadásul ne csak a metrikákat, statisztikákat, hanem a naplókat is: hogyan történt az alkalmazás kiadása, anomáliák – mindent gyűjtsön.
Ellenkező esetben nehéz lesz eligibilálni. Már mondtam, hogy a DevOps egy nagyobb komplexitás. Ehhez a komplexitáshoz normális analitikára van szükség..
Önkontroll kérdések
A monitorozása és naplózása fejlesztési eszköz az Ön számára? Az Ön fejlesztői, és Ön is, amikor kódot ír, gondol arra, hogy hogyan lehet monitorozni?
Tudomást szerez a problémákról az ügyfelektől? Jobban megérti az ügyfelet a monitorozás és naplózás alapján? Jobban megérti a rendszert a monitorozásból és a naplózásból? Megváltoztatja a rendszert csak azért, mert látta, hogy a trend a rendszeren növekszik, és belátja, hogy még 3 hét, és minden el fog veszni?
Amikor megvan ezek a három komponens, akkor gondolkodhat azon, hogy milyen infrastrukturális platformja van a cégnek.
Infrastrukturális platform
Nem arról van szó, hogy ez egy különféle, elszigetelt eszközökből álló készlet, amely minden cégnél megtalálható.
Az infrastrukturális platform lényeg az, hogy minden csapat használja ezeket az eszközöket és közösen fejleszti őket.
Nyilvánvaló, hogy vannak különálló csapatok, amelyek felelősek az infrastrukturális platform egyes részeinek fejlesztéséért. De ez mellett minden mérnök felelősséget visel az infrastrukturális platform fejlesztéséért, működőképességéért és népszerűsítéséért. Belső szinten közös eszközzé válik.
Minden csapat az infrastruktúra platform fejlesztésén dolgozik, és gyengéden bánik vele, mint a saját IDE-jével. Az IDE-jében különböző bővítményeket telepít, hogy minden szép és gyors legyen, és beállítja a gyorsgombokat. Amikor megnyitja a Sublime-ot, Atomot vagy Visual Studio Code-ot, a kódhibák záporoztak Önre, és érzi, hogy gyakorlatilag lehetetlen dolgozni, azonnal szomorú lesz, és rohan, hogy megjavítsa az IDE-jét.
Ugyanígy járjon el az infrastruktúra platformjával is. Ha úgy érzi, hogy valami nem stimmel vele, nyújtson be egy kérelmet, ha nem tudja maga megjavítani. Ha viszont valami egyszerű, javítsa meg önállóan, küldje el a pull requestet - a fiúk megvizsgálják, és hozzáadják. Ez egy kicsit más megközelítés a fejlesztőknél a mérnöki eszköztárban.
Az infrastruktúra platform biztosítja az artefaktumok átadását a fejlesztéstől az ügyfélhez folyamatosan növekvő minőség mellett. Az IP-ben egy sor történet programozva van, ami a kódot előállítja. Az évek során rengeteg ilyen történet gyűlik össze, egy részük egyedi, és csak önre vonatkozik - ezeket nem lehet rákeresni.
Ezen a ponton az infrastruktúra platformja a versenyelőnyévé válik, mert benne van, ami a versenytárs eszközében nincs. Minél mélyebb az IP-je, annál nagyobb a versenyelőnye a Time-to-market szempontjából. Itt felmerül a vendor lock problémája: külső platformot vehet igénybe, de ha más tapasztalatát használja, nem fogja látni, mennyire releváns az ön számára. Igen, nem minden cég tud Amazon-szerű platformot építeni. Ez egy bonyolult határvonal, ahol a cég tapasztalata a piaci helyzetéhez releváns, és nem szabad a vendor lock-ba belemenni. Ezen is érdemes elgondolkodni.
Séma
Ez az infrastruktúra platform alaprajza, amely segít Önnek beállítani az összes gyakorlatot és folyamatot a DevOps-ügynökségben.
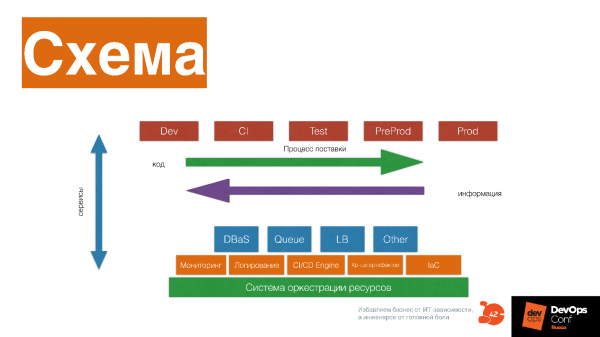
Nézzük meg, miből áll.
Az erőforrások orkestrációs rendszere, amely CPU-t, memóriát és lemezt biztosít az alkalmazásoknak és más szolgáltatásoknak. E fölött alacsony szintű szolgáltatások: monitorozási, naplózási, CI/CD motor, artefaktumtároló, infrastruktúraként kód rendszerek.
Magasabb szintű szolgáltatások: adatbázis, mint szolgáltatás, üzenetsor, mint szolgáltatás, Load Balance mint szolgáltatás, képek átméretezése mint szolgáltatás, Big Data gyár mint szolgáltatás. Erre épül, egy pipeline, amely állandóan módosított kódot szállít ügyfelei számára.
Információt kap arról, hogy szoftvere hogyan működik az ügyfélnél, módosítja, újra szállítja ezt a kódot, információt kap - és így folyamatosan fejleszti mind az infrastruktúra platformot, mind a szoftverét.
A diagramon a delivery pipeline számos szakaszból áll. Ez az alapvető séma, amely példaként szerepel - nem szükséges pontosan így megismételni. A szakaszok a szolgáltatásokkal kommunikálnak, mint szolgáltatások - minden platformépítő elem saját történetét hordozza: hogyan osztják ki az erőforrásokat, hogyan indítják el az alkalmazást, hogyan működik az erőforrásokkal, hogyan figyelik, hogyan változik.
Fontos megérteni, hogy a platform minden része saját történettel bír, és meg kell kérdezni magunktól - milyen történetet hordoz ez az elem, talán érdemes lenne kidobni és helyettesíteni egy külső szolgáltatással. Például, helyettesíthetnénk-e az elemet az Okmeter-rel? Lehetséges, hogy a srácok ezt a szakértelmet sokkal jobban feljlesztették, mint mi. De lehet, hogy nem - lehet, hogy van egyedülálló szakértelmünk, és be kell állítanunk a Prometheus-t, és ezt tovább kell fejlesztenünk.
Platform létrehozása
Ez egy összetett kommunikációs folyamat. Amikor megvannak az alapgyakorlatok, kommunikációt indít el különböző mérnökök és szakértők között, akik követelményeket és standardokat alakítanak ki, és folyamatosan alkalmazzák ezeket a különböző eszközökre és megközelítésekre. Itt a DevOps kultúra a kulcsszó.
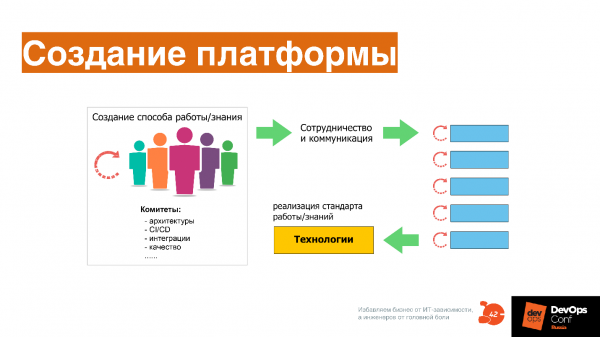
A kultúrával kapcsolatos dolgok nagyon egyszerűek - ez az együttműködés és a kommunikáció, vagyis a vágy, hogy közösen dolgozzunk, a vágy, hogy egyetlen eszközt együtt birtokoljunk. Itt nincs semmi űrtechnika - minden nagyon egyszerű, banális. Például, mindannyian lakóhelyen élünk, és fenntartjuk annak tisztaságát - ez a kultúra egy szintje.
De mi a helyzet veletek?
Újra kérdések, amelyeket feltehetsz magadnak.
Külön van-e az infrastruktúra platform? Ki felel érte a fejlődésért? Érted a saját infrastruktúra platformod versenyelőnyeit?
Ezeket a kérdéseket folyamatosan fel kell tennünk magunknak. Ha valamit külső szolgáltatásokra lehet bízni – mindenképpen érdemes, ha pedig a külső szolgáltatás megakadályozza a mozgásunkat, akkor belső rendszert kell építenünk.
Tehát, DevOps…
… ez egy bonyolult rendszer, aminek a következőkből kell állnia:
- Digitális termék.
- Üzleti modulok, amelyek ezt a digitális terméket fejlesztik.
- Termékcsapatok, akik kódot írnak.
- A Folyamatos Kiadás gyakorlatai.
- Platform mint szolgáltatás.
- Infrastruktúra mint szolgáltatás.
- Infrastruktúra mint kód.
- Különböző gyakorlatok, amelyek a megbízhatóság fenntartását szolgálják, beágyazva a DevOpsba.
- Visszajelzési gyakorlat, amely mindezt leírja.
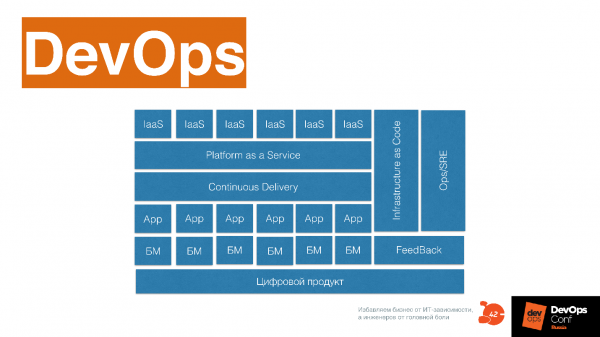
Ezt a sémát használhatja, kiemelve benne azt, ami már a vállalatánál létezik valamilyen formában: ez fejlődött, vagy még fejleszteni kell.
Már csak néhány héten belül megrendezésre kerül . a RIT++ keretein belül. Jöjjön el a konferenciára, ahol sok érdekes előadással várjuk az önkontrollról, az infrastruktúráról mint kódról és a DevOps-transzformációról. , az utolsó árhatár május 20.
Forrás: habr.com
