

A serverless nem azt jelenti, hogy fizikailag nincsenek szerverek. Ez nem a konténerek 'gyilkosa' és nem egy epizodikus trend. Ez egy új megközelítés a felhőbeli rendszerek építésére. A mai cikkben érinteni fogjuk a serverless alkalmazások architektúráját, megnézzük, milyen szerepet játszik a serverless szolgáltatás szolgáltatója és az open-source projektek. Végül a serverless alkalmazásával kapcsolatos kérdésekkel fogunk foglalkozni.
Szeretnék írni egy alkalmazás szerveroldali részét (akár egy online boltét). Ez lehet csevegő, tartalomközzétételi szolgáltatás vagy terheléselosztó. Bárhogy is legyen, rengeteg fejfájással jár: fel kell készíteni az infrastruktúrát, meg kell határozni az alkalmazás függőségeit, és el kell gondolkodni a gazdagép operációs rendszere miatt. Aztán frissítenem kell néhány apró komponenst, amelyek nincsenek hatással a többi monolitikus rész működésére. És ne feledkezzünk meg a terhelés alatti skálázásról sem.
Mi lenne, ha éterikus konténereket használnánk, amelyekben a szükséges függőségek már telepítve vannak, és a konténerek elszigeteltek egymástól és a gazdagéptől? A monolitot mikroszolgáltatásokra bontanánk, amelyeket függetlenül lehet frissíteni és skálázni. Ha a kódot egy ilyen konténerbe helyezem, bármilyen infrastruktúrán futtathatom. Máris jobb.
De mi van akkor, ha nem akarok konténereket beállítani? Nem akarok a alkalmazás skálázásával foglalkozni. Nem akarok fizetni az üresen futó konténerekért, amikor a szolgáltatás terhelése minimális. Csak kódot szeretnék írni. Összpontosítani az üzleti logikára és a termékeket villámgyorsan a piacra hozni.
Ezek a gondolatok vezettek a serverless számításhoz. A serverless ezen esetben azt jelenti, hogy nem azok a szerverek hiányoznak, hanem a fejfájás az infrastruktúra kezelésével kapcsolatban.
Az ötlet az, hogy az alkalmazás logikáját független funkciókká bontjuk. Ezek eseményalapú struktúrával rendelkeznek. Minden egyes funkció egy "mikrofeladatot" hajt végre. Amit a fejlesztőtől kérünk, hogy töltsön fel funkciókat a felhőszolgáltató által biztosított konzolra, és kapcsolja össze azokat az eseménysorozatokkal. A kód kérésre fog futni egy automatikusan előkészített konténerben, és csak a futtatás idejéért fogok fizetni.
Nézzük meg, hogyan fog most kinézni az alkalmazás fejlesztési folyamata.
A fejlesztő szempontjából
Korábban a webáruház alkalmazásáról kezdtünk beszélni. A hagyományos megközelítésben a rendszer fő logikáját egy monolitikus alkalmazás hajtja végre. A szerver az alkalmazással folyamatosan fut, még akkor is, ha nincs terhelés.
Ahhoz, hogy átváltsunk a serverless-re, a monolitikus alkalmazást mikroszolgáltatásokra bontjuk. Minden egyes funkcióhoz saját funkciót írunk. A funkciók egymástól függetlenek és nem tárolják az állapotot (stateless). Még az is lehetséges, hogy különböző nyelveken íródjanak. Ha az egyik "leesik", az alkalmazás nem áll le teljesen. Az alkalmazás architektúrája így fog kinézni:
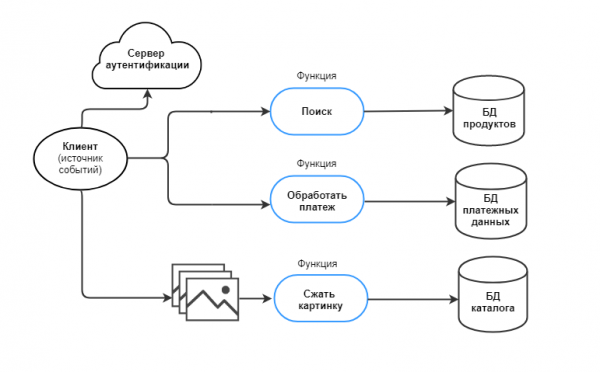
A funkciókra való felosztás a Serverless esetében hasonló a mikroszervizekhez. Azonban a mikroszerviz több feladatot is el tud látni, míg egy funkciónak ideálisan egyetlen feladatot kellene megoldania. Tegyük fel, hogy a feladat a statisztika gyűjtése és a felhasználó kérésére történő megjelenítése. A mikroszervizes megközelítésben ezt egy szolgáltatás látja el, amelynek két belépési pontja van: az írásra és az olvasásra. Bérmentes számítások esetén ez két külön funkció, amelyek nincsenek összekapcsolva. A fejlesztő számítási erőforrásokat takarít meg, ha például a statisztika gyakrabban frissül, mint ahogy az letöltésre kerül.
A Serverless-funcióknak rövid időtartamon belül kell végrehajtódniuk (timeout), amelyet a szolgáltató határoz meg. Például az AWS esetében a timeout 15 perc. Ezért a hosszú élettartamú funkciókat (long-lived) módosítani kell a követelményeknek megfelelően – ez a Serverless különbözik más, manapság népszerű technológiáktól (tartályok és Platform as a Service).
Minden funkciónak eseményt rendelünk. Az esemény egy trigger a cselekvéshez:
Esemény
A tevékenység, amelyet a funkció végrehajt
A tárolóba feltöltöttük a termék képét
A képet tömöríteni és feltölteni a könyvtárba
Az adatbázisban frissült a fizikai bolt címe
Új helyszín betöltése a térképekbe
A vásárló kifizeti a terméket
A kifizetés feldolgozásának elindítása
Események lehetnek HTTP-kérések, folyamatos adatok, üzenetsorok és így tovább. Az események forrásai az adatok változása vagy megjelenése. Ezenkívül a funkciókat időzített indítással is lehet futtatni.
Az architektúrát kidolgoztuk, és az alkalmazás szinte serverless lett. Most továbblépünk a szolgáltatóhoz.
A szolgáltató oldaláról
A serverless számításokat általában felhőszolgáltatók kínálják. Különböző neveken ismertek: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
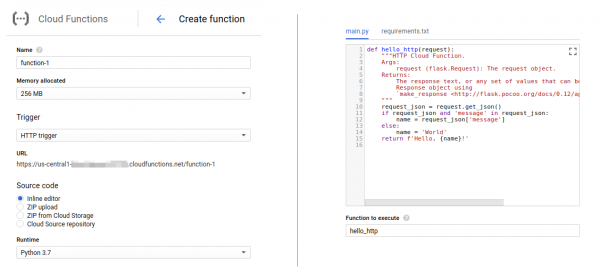
A szolgáltatást a szolgáltató konzolján vagy a felhasználói fiókon keresztül fogjuk használni. A funkciók kódját az alábbi módszerek valamelyikével lehet feltölteni:
- kódot írni a beépített szerkesztőkben a webkonzolon keresztül,
- archív fájl feltöltése a kóddal,
- nyilvános vagy privát git-repozitóriumokkal dolgozni.
Itt állítjuk be az eseményeket, amelyek meghívják a funkciót. Különböző szolgáltatóknál az események készlete eltérhet.
A szolgáltató építette fel és automatizálta a Function as a Service (FaaS) rendszert a saját infrastruktúráján:
- A funkciókód a szolgáltató oldalán található tárolóba kerül.
- Amikor esemény történik, a szerveren automatikusan elindulnak az előkészített környezettel rendelkező konténerek. Minden funkciópéldány saját elszigetelt konténerével rendelkezik.
- A tárolóból a funkció átköltözik a konténerbe, kiszámítódik, majd visszaadja az eredményt.
- A párhuzamos események száma növekszik — ezzel párhuzamosan a konténerek száma is. A rendszer automatikusan méreteződik. Ha a felhasználók nem hívják meg a funkciót, az inaktív marad.
- A szolgáltató beállítja a konténerek tétlenségi idejét — ha ezen az időn belül a funkciók nem jelennek meg a konténerben, az megsemmisül.
Így kapjuk meg a Serverlesst "dobozból". Az szolgáltatásért a pay-as-you-go modell szerint fogunk fizetni, és csak azokért a funkciókért, amelyeket használnak, és csak annyi időért, ameddig használták őket.
A fejlesztők megismertetésére a szolgáltatók legfeljebb 12 hónapos ingyenes tesztelést ajánlanak, de korlátozzák az összes számítási időt, a havi kérések számát, a pénzeszközöket vagy a felhasznált teljesítményt.
A szolgáltatóval való együttműködés fő előnye, hogy nem kell aggódnunk az infrastruktúra (szerverek, virtuális gépek, konténerek) miatt. A szolgáltató a FaaS-t saját fejlesztésein, valamint open-source eszközök segítségével is megvalósíthatja. Ezekről fogunk beszélni a következőkben.
Az open source szempontjából
Az utóbbi pár évben az open-source közösség aktívan dolgozik a Serverless eszközökön. Különösen a legnagyobb piaci szereplők is hozzájárulnak a serverless platformok fejlődéséhez:
- Google ajánlja a fejlesztőknek a saját open-source eszközét — . A fejlesztésében részt vett az IBM, a RedHat, a Pivotal és a SAP;
- IBM dolgoztak a Serverless-platformon , amely később az Apache Foundation projektjévé vált;
- Microsoft részben nyilvánosságra hozták a platform kódját .
Fejlesztések folynak a serverless keretrendszerek irányába is. és előre előkészített Kubernetes klasztereken belül telepítve vannak, mind Kubernetes, mind Docker Swarm működik. A keretrendszer egyfajta vezérlőként működik - kérésre elkészíti a végrehajtási környezetet a klaszterben, aztán ott indítja el a funkciót.
A keretrendszerek teret adnak az eszköz konfigurálására a saját igényeik szerint. Így a Kubeless-ben a fejlesztő beállíthatja a funkció végrehajtási időtúllépését (alapértelmezett érték - 180 másodperc). A Fission megpróbálja megoldani a hideg indítás problémáját, és azt javasolja, hogy néhány konténert folyamatosan működtessenek (bár ez erőforrások üresjárati költségeit vonja maga után). Az OpenFaaS pedig színes kínálatot nyújt a különböző triggerekkel: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs és mások.
A kezdéshez szükséges útmutatókat a keretrendszerek hivatalos dokumentációjában találhatók. A használatukhoz némileg több készség szükséges, mint a szolgáltatónál - legalábbis képesnek kell lennünk a Kubernetes klaszter parancssori indítására. Maximálisan más open-source eszközök (például a Kafka üzenetsor-kezelő) integrálására is szükség lehet.
Függetlenül attól, hogy milyen módszerrel dolgozunk a Serverless-szel - akár szolgáltatáson keresztül, akár open-source segítségével - egy sor előny és hátrány áll rendelkezésünkre a Serverless megközelítésnél.
Az előnyök és hátrányok szempontjából
A Serverless kiterjeszti a konténer alapú infrastruktúra és a mikroszolgáltatás-elv gondolatait, amely lehetővé teszi a csapatok számára, hogy több nyelvben dolgozzanak, anélkül, hogy egyetlen platformra köteleznék el magukat. A rendszer felépítése egyszerűsödik, és a hibák javítása is könnyebbé válik. A mikroszolgáltatás-architektúra lehetővé teszi az új funkciók gyorsabb hozzáadását a rendszerhez, mint egy monolitikus alkalmazás esetén.
A Serverless még tovább csökkenti a fejlesztési időt, lehetővé téve a fejlesztő számára, hogy kizárólag az alkalmazás üzleti logikájára és a kód írására összpontosítson. Ennek következményeként csökken a fejlesztések piacra kerülésének ideje.
Bónuszként automatikus skálázást kapunk a terhelés alatt, és csak a felhasznált erőforrásokért fizetünk, és csak akkor, amikor azokat használják.
Mint minden technológia, a Serverless-nek is vannak hátrányai.
Például egy ilyen hátrány lehet a hideg indítási idő (átlagosan akár 1 másodperc olyan nyelveknél, mint a JavaScript, Python, Go, Java, Ruby).
Egyrészt a hideg indítás ideje több változótól függ: a funkció írásához használt nyelvtől, a könyvtárak számától, a kód mennyiségétől, sőt az extra erőforrásokkal való kommunikációtól (például adatbázisok vagy azonosító szerverek). Mivel a fejlesztő ezeket a változókat kezeli, képes csökkenteni a start időt. Másrészről viszont a fejlesztő nem tudja befolyásolni a konténer indításának idejét – ez teljes mértékben a szolgáltatótól függ.
A hideg indítás meleg indítássá válhat, amikor a funkció újrahasznál egy előző esemény által indított konténert. Ez a helyzet három esetben fordulhat elő:
- ha az ügyfelek gyakran használják a szolgáltatást, és nő a funkcióra tett kérelmek száma;
- ha a szolgáltató, platform vagy keretrendszer lehetővé teszi, hogy a konténerek egy része folyamatosan futva maradjon;
- ha a fejlesztő időzítő alapján indít funkciókat (például három percenként).
Sok alkalmazás számára a hideg indítás nem probléma. Itt a szolgáltatás típusa és céljai a mérvadók. Egy másodperces késlekedés nem mindig kritikus egy üzleti alkalmazás számára, de orvosi szolgáltatások esetén kritikus lehet. Valószínű, hogy ebben az esetben a serverless megközelítés már nem lesz alkalmazható.
A Serverless következő hátránya a funkció rövid élettartama (timeout), amely alatt a funkciónak végre kell hajtódnia.
Ha azonban hosszú életű feladatokkal kell foglalkoznunk, hibrid architektúrát használhatunk – a Serverless-t egy másik technológiával kombinálva.
Nem minden rendszer képes a Serverless séma szerint működni.
Néhány alkalmazás továbbra is tárolja az adatokat és az állapotokat a végrehajtás során. Néhány architektúra monolitikus marad, míg néhány funkció hosszú életű lesz. Azonban (ahogy egykor a felhőtechnológiák, majd a konténerek), a Serverless egy nagy jövővel rendelkező technológia.
Ebben a fényben szeretném simán átvezetni a Serverless megközelítés alkalmazásának kérdéséhez.
Az alkalmazás szempontjából
2018-ban a Serverless használatának aránya . Azok között a cégek között, akik már bevezették a technológiát a szolgáltatásaikban, olyan piaci óriások szerepelnek, mint a Twitter, a PayPal, a Netflix, a T-Mobile és a Coca-Cola. Fontos megérteni, hogy a Serverless nem csodaszer, hanem egy eszköz egy bizonyos problémakör megoldására:
- Csökkenteni az erőforrások tétlenségét. Nem szükséges folyamatosan futtatni a virtuális gépet olyan szolgáltatásokhoz, amelyekre ritkán van szükség.
- Az adatokat "azonnal" feldolgozni. Képeket tömöríteni, háttérkivágást végezni, videók kódolását megváltoztatni, IoT érzékelőkkel dolgozni, matematikai műveleteket végrehajtani.
- "Összekapcsolni" más szolgáltatásokat. Git-repozitórium belső programokkal, Slack chatbot Jira és naptárral.
- Terheléselosztás. Itt részletesebben megállunk.
Tegyük fel, van egy szolgáltatás, amelyre 50 ember jön. Ehhez egy gyenge hardverrel rendelkező virtuális gép tartozik. Időnként a szolgáltatásra nehezedő terhelés többszörösére nő. Ekkor a gyenge hardver nem tud megbirkózni.
A rendszerbe be lehet kapcsolni egy terheléselosztót, amely a terhelést mondjuk három virtuális gépre osztja el. Ezen a ponton nem tudjuk pontosan előre jelezni a terhelést, ezért egy bizonyos mennyiségű erőforrást "tartalékolunk". És ezért túl sokat fizetünk az üresjáratért.
Ilyen helyzetben a rendszert egy hibrid megközelítéssel optimalizálhatjuk: a terheléselosztó mögött egy virtuális gépet hagyunk, és linket helyezünk el Serverless Endpoint funkciókkal. Ha a terhelés meghaladja a küszöböt, a terheléselosztó elindítja a funkciók példányait, amelyek átveszik a kérdések egy részének feldolgozását.
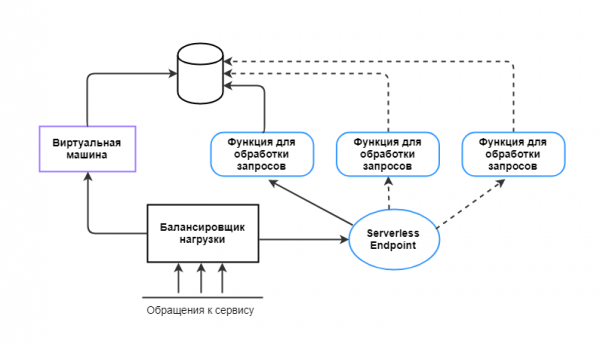
Így a Serverless ott használható, ahol ritkán, de intenzíven kell nagy számú kérdést kezelni. Ebben az esetben a funkciók 15 percre való indítása gazdaságosabb, mint folyamatosan egy virtuális gépet vagy szervert fenntartani.
Minden előnye ellenére a serverless számítási megoldások bevezetése előtt először érdemes felmérni az alkalmazás logikáját és megérteni, hogy mely feladatokat tud a Serverless megoldani a konkrét esetben.
Serverless és Selectel
A Selectelnél már a vezérlőpultunkon keresztül. Most saját FaaS-platformot építünk. Azt szeretnénk, hogy a fejlesztők saját feladataik megoldására használhassák a Serverlesst egy kényelmes, rugalmas felületen.
Ha van ötlete arról, hogy milyen legyen az ideális FaaS-platform, és hogyan szeretné használni a Serverlesst a projektjeiben, ossza meg velünk a megjegyzésekben. Figyelembe vesszük az Ön kívánságait a platform fejlesztésénél.
A cikkben felhasznált anyagok:
Forrás: habr.com
